pypdf로 PDF를 읽는 것은 10분이면 되는 작업입니다. 문제는 같은 스크립트에 첫 페이지에서 요약 표를 추출하고, 부록을 삭제하고, 편집 가능한 Word 복사본을 반환하고, 암호로 아카이브를 잠그는 작업을 요청할 때 시작됩니다. 각 요청에는 좋은 Python 답이 있지만, 같은 패키지에서 나오는 경우는 드뭅니다.
이 가이드는 하나의 테스트 파일 세트에서 여섯 가지 옵션을 비교합니다: pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab 및 Python용 Spire.PDF. 공개: Spire.PDF는 이 기사의 발행자인 E-iceblue의 상용 제품이며, E-iceblue가 테스트를 실행했습니다. 픽스처, 버전 및 타이밍 방법은 "테스트 방법" 섹션에 나열되어 있으므로 모든 결과를 재현할 수 있습니다. 아래의 모든 라이브러리는 해당 라이브러리가 만들어진 작업에 대한 합리적인 선택입니다.
어떤 Python PDF 라이브러리를 선택해야 할까요?
작업이 하나의 작업이라면, 그 작업에 특화된 라이브러리를 선택하세요. 이 비교에 포함된 오픈 소스 라이브러리는 각자의 작업에 강합니다. Spire.PDF는 다른 경우를 겨냥합니다: 하나의 문서가 추출, 편집, 변환 및 암호화를 거치는 파이프라인에서 세 개의 라이브러리보다 하나의 SDK를 유지 관리하려는 경우입니다.
| 라이브러리 | 최적 용도 | 주요 고려 사항 | 라이선스 |
|---|---|---|---|
| pypdf | 순수 Python에서 페이지 병합, 분할, 회전 및 암호화 | AES 암호화에는 pypdf[crypto] 추가 기능이 필요합니다 |
BSD-3 |
| pdfplumber | 레이아웃 분석, 표 추출, 시각적 디버깅 | 페이지 수정이 아닌 읽기용으로 제작됨 | MIT |
| PyMuPDF | 빠른 텍스트 추출 및 페이지 렌더링 | AGPL-3.0 또는 상용; 배포 방식에 따라 평가하세요 | AGPL-3.0 또는 상용 |
| pikepdf | 저수준 구조 작업, 선형화, 암호화 | 텍스트 추출 API 없음 | MPL-2.0 |
| reportlab | 코드에서 PDF 생성 | 생성만 가능 | BSD |
| Spire.PDF | 하나의 SDK에서 혼합 작업(추출, 편집, 변환, 암호화) | 상용 라이선스; 무료, 평가 및 임시 라이선스 옵션 | 상용 |
표는 이름이 아니라 작업별로 읽으세요. 파이프라인에 라이브러리의 첫 번째 열에 있는 작업만 필요하다면, 세 번째 열만 고려하면 됩니다. 라이선스 조건과 설치 무게가 비슷한 후보 중에서 결정하는 경우가 많으며, 아래 섹션에서 두 가지 모두에 대한 수치를 제공합니다.
범위 참고: 이는 선택된 다섯 개의 오픈 소스 라이브러리와 하나의 상용 SDK입니다. Python 생태계의 모든 전문 PDF 도구를 다루지는 않습니다.
선택된 오픈 소스 Python PDF 라이브러리가 가장 잘하는 것
Python PDF 파서 라이브러리 또는 Python PDF 리더 라이브러리를 검색하는 사람들은 보통 두 가지 중 하나를 의미합니다: 기존 파일에서 텍스트와 표를 추출하거나, 파일 자체를 재구성하는 것입니다. 아래 다섯 라이브러리는 그 경계를 따라 나뉩니다. pdfplumber와 PyMuPDF는 읽기 측면에서 가장 강하고, pypdf와 pikepdf는 페이지 구조 측면에서, reportlab은 문서를 처음부터 생성하는 측면에서 강합니다. 각 항목은 라이브러리의 초점, 측정한 내용 및 범위가 끝나는 지점을 설명합니다.
pypdf
pypdf는 페이지 수준 작업을 위한 순수 Python 라이브러리이며, 깨끗한 환경에서 설치 공간은 1.8MB입니다. 테스트 실행에서 10페이지 텍스트 문서를 43.1ms에 추출하고, 페이지를 9.2ms에 회전하고, 페이지를 8.6ms에 삭제하고, 두 파일을 14.7ms에 병합하고, 세 페이지를 10.2ms에 분할하고, AES-256 암호화를 19.6ms에 적용했습니다. AES에는 pypdf[crypto] 추가 기능이 필요하며, 설치 크기가 13.2MB로 증가합니다. 페이지를 재구성하고 컴파일된 종속성을 원하지 않을 때 자연스러운 첫 번째 선택입니다; AES 보호는 위에서 언급한 crypto 추가 기능을 가져옵니다.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
이 스크립트는 두 파일을 병합하고, 첫 페이지를 회전하고, AES-256으로 보호된 복사본을 작성합니다.
pdfplumber
pdfplumber는 페이지가 어떻게 배치되어 있는지 확인해야 할 때 사용하는 도구입니다. 문자, 선 및 사각형 위치를 노출하여 표 추출 및 시각적 디버깅을 실용적으로 만듭니다. 픽스처의 테두리 있는 21 × 4 표는 44.6ms에 나왔고, 10페이지에 걸친 일반 텍스트 추출은 320.4ms로 텍스트 중심 리더보다 느렸지만, 이 라이브러리는 레이아웃 분석과 표 작업이 의존하는 위치 세부 정보도 노출합니다. 단일 페이지 중국어 인보이스는 7.7ms에 읽혔고 예상 구문 "发票编号"을 반환했습니다. PDF를 읽기만 하고 수정하지 않으므로 일반적으로 두 번째 라이브러리와 함께 사용됩니다.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
이 호출은 첫 페이지의 첫 번째 표를 행 목록으로 반환합니다.
PyMuPDF
PyMuPDF는 컴파일된 엔진 위에서 텍스트 처리와 렌더링을 결합합니다. 테스트에서 가장 낮은 텍스트 추출 시간을 기록했으며, 10페이지에 7.2ms, 페이지 삭제에 3.0ms, 150 DPI로 페이지 렌더링에 48.8ms가 걸렸습니다. 기본 설치는 종속성을 포함하여 201.3MB(--no-deps 사용 시 104.5MB)이므로 여기서 가장 무거운 옵션이며, 라이선스는 AGPL-3.0 또는 상용입니다. 서비스에서 썸네일을 렌더링하거나 많은 페이지를 텍스트 추출로 처리하는 경우, 이 수치가 인기를 설명합니다.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
이 스니펫은 첫 페이지의 텍스트를 읽고 150 DPI PNG로 저장합니다.
pikepdf
pikepdf는 QPDF 라이브러리를 래핑하고 PDF 객체 구조 자체에서 작동합니다. 이는 페이지 회전 또는 삭제(6.4ms 및 5.8ms), 페이지 재정렬(6.5ms), 리비전 6 핸들러로 AES-256 암호화 적용(32.0ms), 웹 전달을 위한 선형화된 파일 저장(7.8ms)과 같은 작업에 적합합니다. 텍스트 추출 API를 제공하지 않으므로 팀은 일반적으로 리더와 함께 사용합니다. 저수준 PDF 객체 조작, 페이지 재구성, 암호화 또는 선형화가 필요할 때 선택하세요.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
이 코드는 첫 페이지를 90도 회전으로 설정하고 결과를 저장합니다.
reportlab
reportlab은 PDF를 생성하기 위해 존재하며, 글꼴, 좌표 및 흐르는 레이아웃을 완전히 제어하여 이를 수행합니다. 테스트에서 Arial 10pt로 페이지당 40줄인 10페이지 문서를 14.1ms에 생성했습니다. 기존 파일을 읽거나 편집하는 작업은 없으며, 이는 격차라기보다 명확한 경계입니다: 인보이스, 라벨 및 생성된 보고서가 reportlab의 자리를 만들어 줍니다.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
이 루프는 페이지당 40줄인 10페이지 A4 파일을 생성합니다.
다중 라이브러리 PDF 워크플로가 유지 관리하기 어려워질 때
위의 내용 중 결함은 없습니다. 하나의 요구 사항이 이러한 라이브러리 여러 개를 순차적으로 필요로 할 때 마찰이 나타나며, 추가된 각 도구는 단일 벤치마크 행에 나타나지 않는 비용을 수반합니다:
- 변환에는 별도의 변환기가 필요합니다. PDF to Word는 위의 리더 및 페이지 편집기의 일부가 아니므로 하나를 추가해야 하며, 레이아웃 충실도를 파일별로 확인해야 합니다.
- 텍스트를 제자리에서 편집하는 것은 별개의 작업입니다. 페이지 작업은 전체 페이지를 이동하거나 제거합니다; 페이지 내부의 단어를 변경하려면 다른 도구가 필요합니다.
- 복잡한 양식은 별도의 주제입니다. 단순한 필드를 읽는 것과 양식을 작성하고 평면화하는 것은 다르며, 라이브러리마다 지원 범위가 다릅니다.
- 서명 및 PDF/A에는 추가 도구가 필요합니다. 아카이빙 및 서명 워크플로는 일반적으로 추가 패키지를 필요로 합니다.
- OCR은 설계상 외부에 있습니다. 스캔한 페이지는 이러한 라이브러리 외부의 엔진이 필요합니다.
구체적인 그림이 도움이 됩니다. 일반적인 글루 스크립트는 한 라이브러리에서 파일을 열고, 중간 파일을 작성하고, 두 번째 라이브러리에서 해당 파일을 다시 열고, 다시 저장한 다음, 결과를 세 번째로 파싱하는 변환기로 전달합니다. 모든 핸드오프는 글꼴, 페이지 상자 또는 암호화 플래그가 변경될 수 있는 지점이며, 각각 자체 테스트가 필요합니다. 작성하기 어려운 것은 없습니다; 요구 사항이 변경됨에 따라 계속 커지는 부분입니다.
다섯 가지 모두 밑에는 동일한 오버헤드가 있습니다: 배워야 할 또 다른 API, 또 다른 종속성 트리, 또 다른 호환성 매트릭스 및 또 다른 오류 처리 경로, 그리고 도구 간 파일 핸드오프입니다.
라이선싱은 별도의 언급이 필요합니다. 일반적인 변환기 pdf2docx는 MIT 라이선스이며, AGPL-3.0 또는 상용인 PyMuPDF에 의존합니다. 이는 두 가지 별개의 사실이며, 배포 제품은 둘 다 평가해야 합니다. 문제의 읽기 측면을 더 자세히 살펴보려면 Python에서 PDF 파싱 가이드를 참조하세요.
Python용 Spire.PDF가 PDF 워크플로에 추가하는 것
Python용 Spire.PDF는 하나의 패키지 내에서 읽기, 편집, 변환, 보안 및 생성을 처리하는 상용 SDK입니다. 비교에서 네 가지 영역이 중요합니다.
1. 공유 문서 모델 및 일관된 API
공유 문서 모델과 일관된 Python API를 통해 개발자는 하나의 SDK 내에서 여러 PDF 작업을 수행할 수 있습니다. PdfTableExtractor와 같은 특수 도우미 클래스는 로드된 PdfDocument와 함께 작동합니다. 동일한 로드된 PdfDocument를 여러 작업에 사용할 수 있으며, 별도의 라이브러리 간에 중간 PDF 파일을 전달할 필요가 없습니다. 또한 업그레이드할 때 추적해야 할 하나의 오류 처리 패턴과 하나의 버전 제약 조건 세트를 의미합니다.
2. 벤치마크의 표 추출 성능
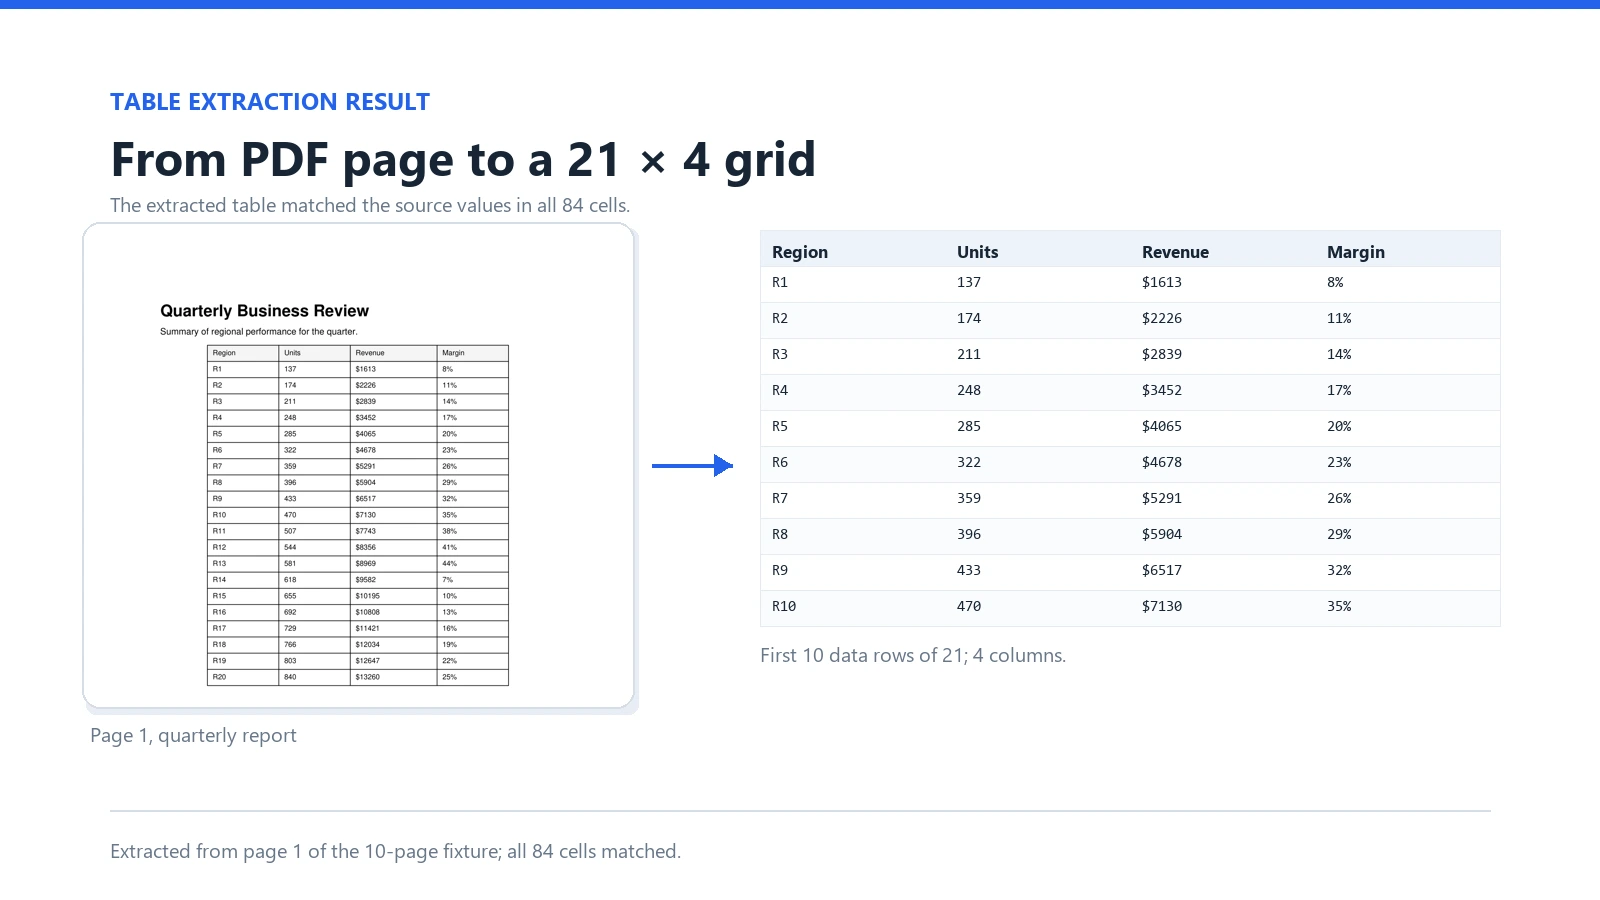
동일한 테두리 표를 세 라이브러리로 실행했습니다. 픽스처는 21행 × 4열이며, 테두리가 명확하게 그려져 있고 병합된 셀이 없습니다. 공식 문서에 따르면 표 추출은 명확하게 서식이 지정된 표에서 가장 잘 작동하므로, 이 결과는 그러한 종류의 표만 설명합니다.
| 라이브러리 | 중앙값 | 범위 | 결과 |
|---|---|---|---|
| Spire.PDF | 18.9 ms | 16.2 ~ 26.4 ms | 21 × 4, 84개 셀 모두 정확 |
| pdfplumber | 44.6 ms | 42.3 ~ 53.7 ms | 21 × 4, 84개 셀 모두 정확 |
| PyMuPDF | 363.4 ms | 341.6 ~ 385.7 ms | 21 × 4, 84개 셀 모두 정확 |
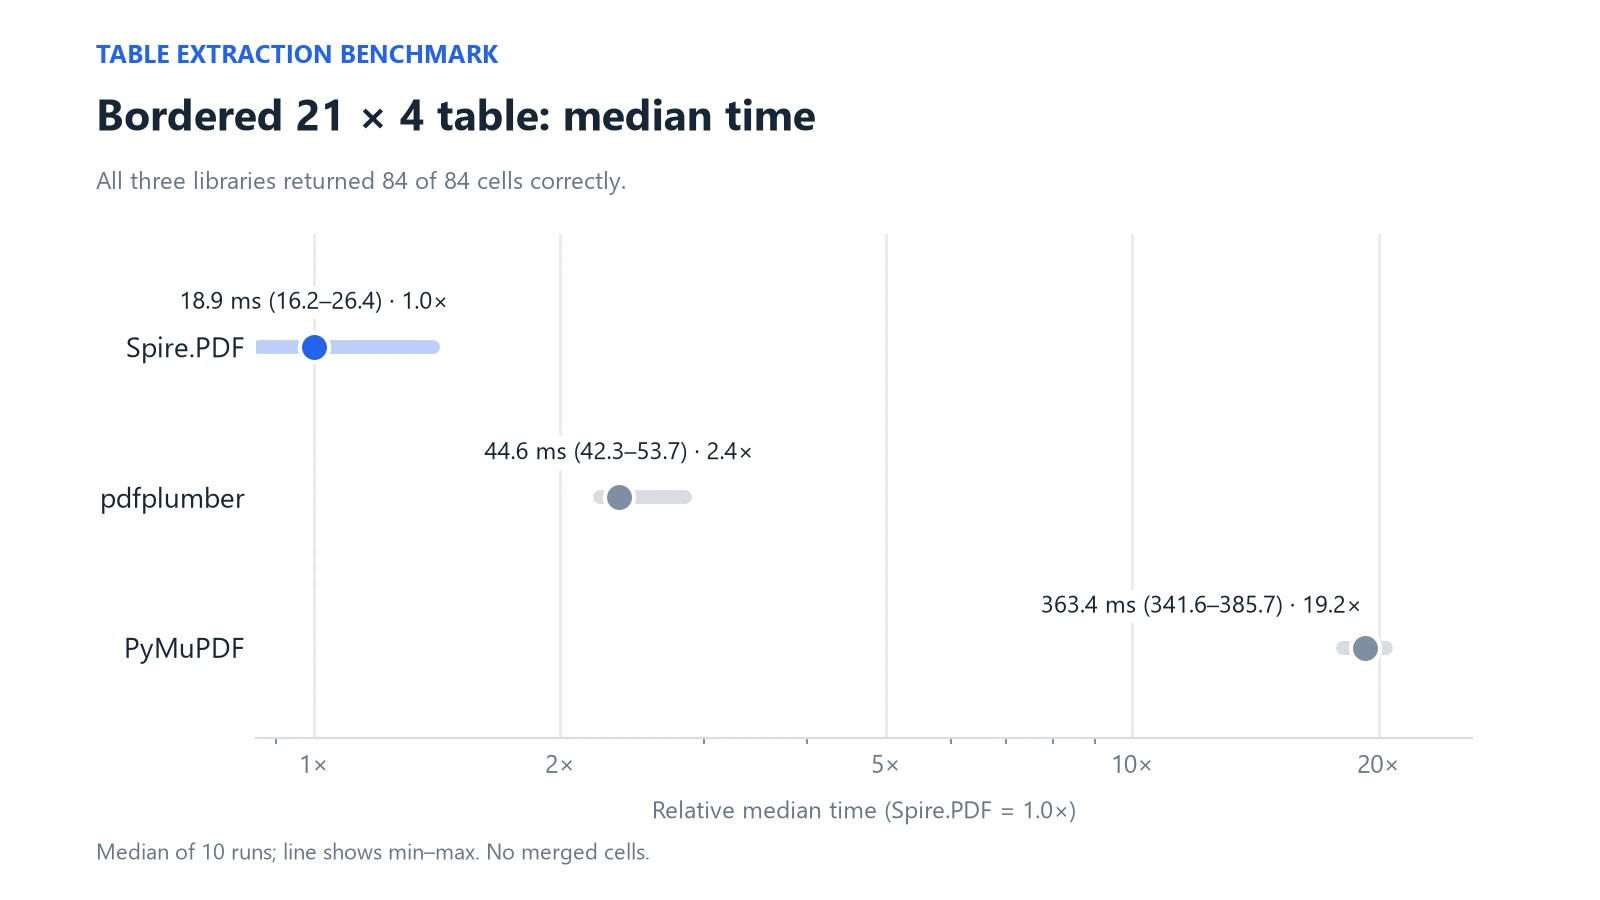
세 라이브러리 모두 동일한 셀 내용을 반환했으므로, 비교는 동일한 정확도에서 시간에 관한 것입니다. Spire.PDF는 이 테스트에서 가장 낮은 중앙값을 기록했습니다. 병합된 셀, 누락된 테두리 또는 스캔한 페이지가 있는 표는 측정되지 않았으며 순위가 다를 수 있습니다. 동일한 API의 단계별 연습은 Python에서 PDF에서 표 추출을 참조하세요.
3. 양식
Python용 Spire.PDF는 양식 필드를 생성하고 채우고, 이를 정적 콘텐츠로 평면화하는 API를 문서화합니다. 양식 처리는 성능 벤치마크에 포함되지 않았으므로, 이 섹션은 문서화된 기능만 설명합니다.
4. 다른 형식으로 내보내기
동일한 로드된 문서를 여러 형식으로 저장할 수 있습니다. 테스트 실행에서 아래 출력은 10페이지 보고서에서 생성되었습니다.
| 방향 | 검증 깊이 |
|---|---|
| PDF → DOCX, HTML, Markdown | 출력 생성됨; 텍스트 콘텐츠 확인됨 |
| PDF → XLSX | 출력 생성됨; 셀 콘텐츠 존재; 구조는 원본 레이아웃에 따라 다름 |
| PDF → PNG, XPS, SVG, PPTX | 출력 생성됨; 시각적 충실도는 원본 레이아웃에 따라 다름 |
| PDF → PDF/A-1a 및 PDF/A-1b | 변환 방법 사용 가능; 출력 생성 및 XMP 식별자 확인됨; 공식 PDF/A 적합성은 독립적으로 검증되지 않음 |
변환 출력은 원본 레이아웃에 따라 다릅니다; 프로덕션 사용 전에 대표 파일을 검증하세요. DOCX 경로에 대한 자세한 내용은 Python에서 PDF를 Word로 변환 튜토리얼을 참조하세요.
Python의 다단계 PDF 워크플로
유지 관리 주장을 코드로 확인하기 위해 현실적인 작업을 수행했습니다. 40페이지 분기 보고서의 요약 표를 추출하고 부록 페이지를 제거해야 합니다. 업데이트된 파일에서 두 가지 출력이 필요합니다: 편집 가능한 DOCX와 AES-256 암호화된 PDF 아카이브입니다.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
오픈 소스 구현은 표에 pdfplumber를, 페이지 삭제 및 암호화에 pypdf[crypto]를, Word 복사본에 pdf2docx를 사용합니다. 이는 PDF를 직접 다루는 세 개의 패키지입니다. 깨끗한 환경에서 함께 설치하면 29개 배포판과 388.9MB가 되며, 동일한 방식으로 측정한 Spire.PDF의 70.5MB와 대조됩니다.
Spire.PDF를 사용하면 전체 흐름이 하나의 문서 객체 내에 유지됩니다:
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
동등한 조건의 타이밍 비교를 위해 두 구현 모두 보고서의 10페이지 버전에서 실행되었습니다. 세 오픈 소스 패키지는 총 중앙값 1,346.2ms를 기록했고 Spire.PDF는 267.3ms를 기록했습니다. 둘 다 84개 표 셀을 모두 정확하게 추출했고, 둘 다 암호로 다시 열리는 9페이지 암호화 PDF를 생성했습니다. 두 아카이브 모두 암호 없이는 열리지 않았습니다. 40페이지 보고서에서 오픈 소스 스택은 3,241.4ms가 걸렸고 39페이지를 생성했습니다; Spire.PDF의 평가 빌드는 처음 10페이지만 처리하므로 해당 실행은 비교하지 않습니다(에디션 섹션 참조).
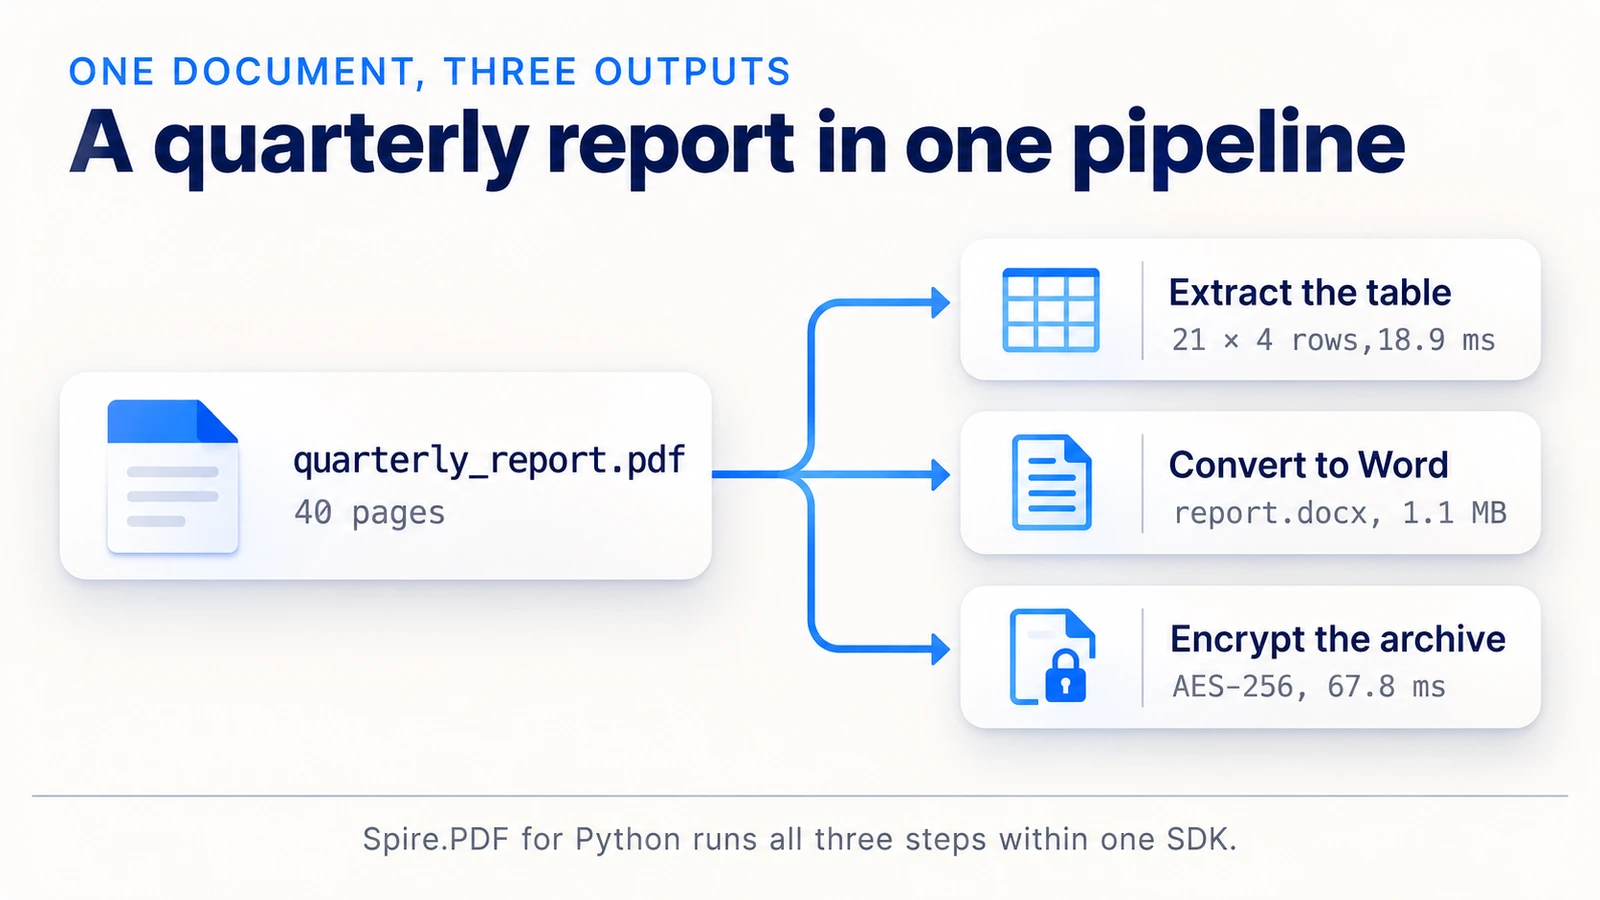
이 비교는 표 추출, 페이지 삭제, DOCX 및 PDF 생성, 암호화 및 경과 시간을 다룹니다; DOCX 레이아웃 충실도는 이 타이밍 비교에서 제외되며 자체 파일에서 검증해야 합니다. 대부분의 시간 차이는 DOCX 단계에 있으며, 오픈 소스 변환기는 약 1.3초를 소비했습니다. 이 연습의 핵심은 스톱워치보다 코드의 형태입니다: 하나의 import, 하나의 문서 객체, 패키지 간에 전달되는 파일 없음. 암호 처리에 대한 자세한 내용은 Python에서 PDF 문서 보호 또는 보호 해제를 참조하세요.
성능 및 설치 크기
아래의 모든 수치는 워밍업 실행 1회 후 10회의 시간 측정 실행의 중앙값이며, 밀리초 단위이고 괄호 안에 최소값과 최대값이 있습니다. 각 수치는 작업의 종단 간 시간입니다: 해당되는 경우 픽스처 열기와 출력 저장이 포함됩니다. "n/a"는 라이브러리에 해당 작업이 없음을 의미합니다.
| 작업 | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| 텍스트, 10페이지 | 43.1 (39.9–46.1) | 320.4 (295.5–573.8) | 7.2 (6.7–8.4) | n/a | n/a | 58.2 (53.8–64.6) |
| 표, 84개 셀 | n/a | 44.6 (42.3–53.7) | 363.4 (341.6–385.7) | n/a | n/a | 18.9 (16.2–26.4) |
| 페이지 하나 회전 | 9.2 (8.5–13.1) | n/a | 3.8 (2.7–11.0) | 6.4 (5.6–7.7) | n/a | 22.4 (20.6–29.9) |
| 페이지 하나 삭제 | 8.6 (8.2–14.7) | n/a | 3.0 (2.8–3.4) | 5.8 (5.5–6.9) | n/a | 23.3 (20.2–27.8) |
| 150 DPI로 렌더링 | n/a | n/a | 48.8 (47.2–52.3) | n/a | n/a | 161.4 (153.8–180.3) |
| AES-256 암호화 | 19.6 (17.2–24.6) | n/a | n/a | 32.0 (30.9–34.4) | n/a | 67.8 (62.1–72.2) |
| 10페이지 생성 | n/a | n/a | n/a | n/a | 14.1 (13.7–15.3) | 85.3 (79.4–106.9) |
단일 작업에서는 대부분의 행에서 전문 라이브러리가 앞서며: 텍스트, 회전, 삭제 및 렌더링에는 PyMuPDF, 순수 Python 페이지 편집에는 pypdf, 구조 작업에는 pikepdf, 암호화에는 둘 다, 생성에는 reportlab이 앞섭니다. Spire.PDF의 가장 낮은 중앙값은 표 테스트에 있었습니다. 생성은 각 40줄인 10페이지, A4, Arial 10pt를 비교했습니다. 렌더링 테스트에서 PyMuPDF와 Spire.PDF는 둘 다 150 DPI에서 1241 × 1754 픽셀 이미지를 생성했습니다. 하나의 SDK의 가치는 단일 행이 아니라 결합된 워크플로에서 나타납니다.
설치 환경은 깨끗한 가상 환경에서 측정되었으며, 인터프리터, pip, setuptools, wheel 및 __pycache__는 제외했습니다:
| 대상 | 설치 크기 | 패키지 수 | 새 프로세스에서 가져오기 |
|---|---|---|---|
| pypdf | 1.8 MB | 1 | 219.9 ms |
| pypdf[crypto] | 13.2 MB | 4 | 331.8 ms |
| pdfplumber | 43.9 MB | 8 | 246.5 ms |
| PyMuPDF (default) | 201.3 MB | 12 | 223.8 ms |
PyMuPDF (--no-deps) |
104.5 MB | 1 | 217.0 ms |
| pikepdf | 35.2 MB | 4 | 178.4 ms |
| reportlab | 20.4 MB | 3 | 9.0 ms |
| Spire.PDF | 70.5 MB | 2 | 640.6 ms |
| 세 패키지 워크플로 스택 | 388.9 MB | 29 | n/a |
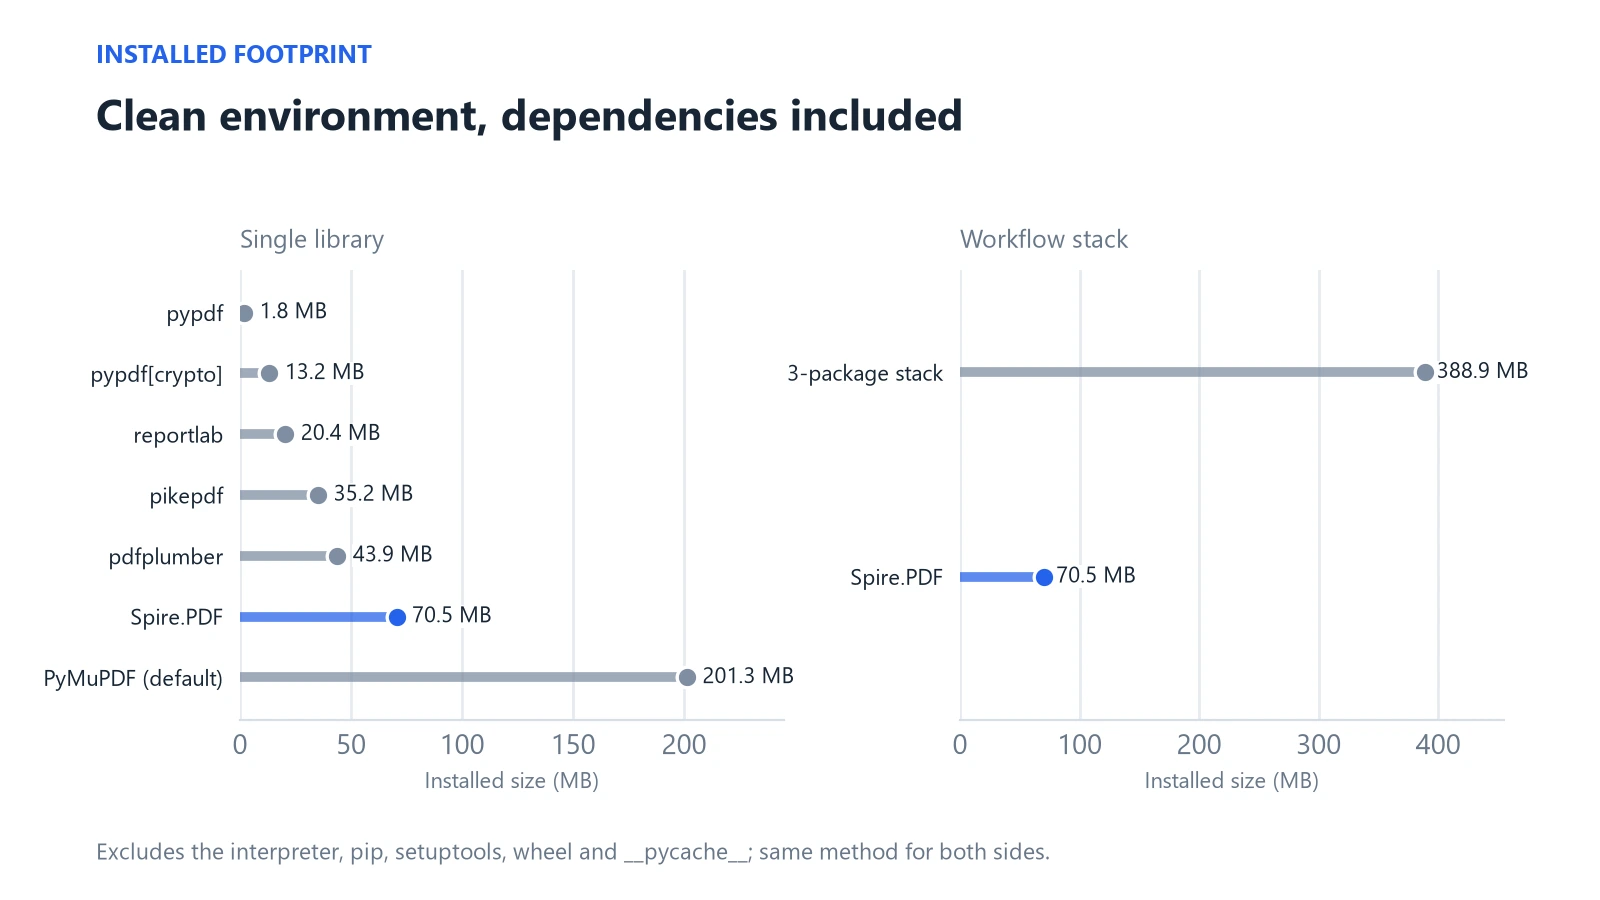
설치 표에서 두 가지 세부 사항을 읽을 가치가 있습니다. 가져오기 시간은 프로세스당 일회성 비용이므로, 장기 실행 서비스보다 단기 명령줄 작업 및 서버리스 함수에 더 중요합니다; Spire.PDF의 콜드 가져오기는 640.6ms로 측정되었으며 여전히 1초 미만이고, reportlab은 9.0ms로 가장 짧았습니다. 설치 크기는 컨테이너 이미지 및 데스크톱 패키징에 중요하며, PyMuPDF의 201.3MB 기본 및 388.9MB 세 패키지 스택이 두드러집니다.
각 라이선스를 한 줄로: pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 또는 상용, pikepdf MPL-2.0, reportlab BSD, Spire.PDF 상용. AGPL 조건은 소프트웨어 배포 방식에 따라 평가해야 합니다.
무료 에디션, 평가판, 임시 및 상용
Spire.PDF는 여러 에디션이 있는 상용 제품이며 동작이 다르므로, 벤치마킹 또는 배송 전에 어떤 에디션이 설치되어 있는지 확인하세요.
| 패키지 / 버전 | 상태 | 제한 |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | 무료 에디션 | 출력은 10페이지로 제한; 이미지, XPS, Word 및 HTML 변환은 처음 3페이지로 제한 |
| spire-pdf 12.10.0 (2026-10-12) | 평가판 | 평가 경고; 처음 10페이지 처리 |
| spire-pdf 12.10.0 | 임시 라이선스 (30일) | 평가 제한 제거됨 |
| spire-pdf 12.10.0 | 상용 | 위의 제한 없음 |
API 외에도 상용 라이선스는 유지 관리 관계이기도 합니다. 패키지는 Windows, Linux 및 macOS용 휠을 제공하며, 2026년 1월부터 10월 사이에 7개의 릴리스(12.1.3부터 12.10.0까지)를 기록했고, 상용 라이선스에는 공급업체 포럼 및 이메일을 통한 업데이트와 기술 지원이 포함되며, 응답 목표는 라이선스 등급에 따라 다릅니다.
페이지 상한은 쉽게 확인할 수 있습니다: 평가 빌드에서 40페이지 파일을 로드하면 10개의 처리된 페이지만 생성됩니다. 이는 평가 에디션의 속성이지 제품 기능의 속성이 아니며, 40페이지 워크플로 실행이 오픈 소스 스택에 대해서만 보고되는 이유입니다. 평가 빌드는 평가용이지 프로덕션용이 아닙니다. 제품을 처음 접하는 팀의 경우 합리적인 순서는 자체 파일에서 평가 빌드로 시작하고, 10페이지 이상을 테스트해야 할 때 임시 라이선스를 요청하고, 배송 전에 상용 라이선스로 전환하는 것입니다.
프로젝트에 적합한 PDF 라이브러리 선택
세 가지 프로필이 대부분의 팀을 커버합니다:
- 하나의 전문화된 작업. 대량 텍스트 추출, 페이지 렌더링, 파일 병합 또는 보고서 생성: PyMuPDF, pypdf 또는 reportlab과 같이 해당 작업을 위해 만들어진 라이브러리를 선택하세요. 재배포하는 경우 라이선스를 확인하세요.
- 레이아웃 인식 읽기. 표와 위치가 초점이라면 pdfplumber가 시작 도구이며, 페이지 편집에는 pypdf 또는 pikepdf를 사용하세요.
- 동일한 파일에 대한 연쇄 작업. 추출, 페이지 편집, 변환 및 암호화가 하나의 파이프라인에 속할 때 단일 SDK는 유지 관리하는 API 및 종속성 트리의 수를 줄입니다. Spire.PDF가 설계된 곳이 바로 여기입니다; 상용 라이선스는 업데이트와 지원을 포함합니다.
커밋하기 전에 빠른 테스트: 변환, 암호화 및 아카이빙을 포함하여 프로젝트가 내년에 필요한 모든 작업을 적고, 각 작업을 어떤 라이브러리가 커버하는지 표시하세요. 하나의 라이브러리가 전체 목록을 커버하면 완료입니다. 목록에 세 개가 필요하면 세 종속성 비용을 하나의 라이선스와 비교하세요.
기능이 아니라 작업을 세세요. 프로젝트에 필요한 작업을 한 문장으로 말할 수 있고 그것이 하나 또는 둘이라면 전문 라이브러리로 충분할 것입니다. 목록이 계속 늘어나면 자체 파일에서 Python용 Spire.PDF를 사용해 보세요.
테스트 방법
공개: Python용 Spire.PDF는 E-iceblue 제품이며, 이 벤치마크는 발행자가 실행했습니다. 따라서 픽스처, 버전 및 방법을 공개했으며, 오픈 소스 라이브러리는 정확히 동일한 파일에서 테스트되었습니다.
- 환경: Windows 11, Intel Core i3-10105 3.70 GHz (4코어, 8스레드), 8.4 GB RAM, Python 3.14.6.
- 버전: pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- 픽스처: 10페이지 텍스트 문서, 첫 페이지의 테두리 있는 21 × 4 표, 중국어 인보이스, 렌더링용 혼합 콘텐츠 페이지, 생성된 10페이지 및 40페이지 분기 보고서. 페이지 수, 크기 및 SHA-256 해시는 픽스처 매니페스트에 기록되어 있습니다.
- 타이밍: 테스트당 워밍업 1회 및 측정 실행 10회, 최소값과 최대값이 포함된 중앙값으로 보고됩니다. 열기, 작업 및 저장은 별도 단계로 시간이 측정되었습니다.
- 정확성: 텍스트는 고유 토큰 범위와 시퀀스 유사도로 비교(공백 규칙이 다르므로 원시 문자 수가 아님); 표는 셀별로 비교; 암호화된 파일은 암호로 다시 열고 암호 없이 액세스가 차단되는지 확인했습니다.
- 다루지 않은 항목: 단일 머신 및 단일 워크로드; 스캔 문서, OCR, 서명, 양식 처리, 병합 셀 표 및 임의의 손상된 파일은 측정되지 않았습니다. 타이밍은 하드웨어와 문서에 따라 다릅니다.
자주 묻는 질문
전체적으로 가장 좋은 Python PDF 라이브러리는 무엇인가요? 단일 우승자는 없습니다. PyMuPDF는 텍스트 및 렌더링 속도에서 앞서고, pypdf는 페이지 작업에 간단한 선택이며, pdfplumber는 표에, reportlab은 생성에 적합합니다. 여러 작업을 연쇄하는 파이프라인의 경우 Spire.PDF와 같은 단일 SDK가 직접 통합된 PDF 패키지 수를 줄일 수 있습니다.
pypdf vs PyMuPDF: 어느 것을 사용해야 하나요? BSD 라이선스의 작은 순수 Python 패키지에서 페이지 작업에는 pypdf를 선택하세요. 더 빠른 텍스트 추출 및 페이지 렌더링에는 PyMuPDF를 선택하고, 먼저 AGPL-3.0 또는 상용 조건을 확인하세요. 테스트에서 PyMuPDF는 텍스트에 7.2ms, pypdf는 43.1ms가 걸렸습니다.
Python에서 PDF에서 표를 추출하려면 어떻게 하나요?
테두리 있는 표의 경우 pdfplumber에서 extract_tables()를 호출하거나 PyMuPDF 또는 Spire.PDF의 표 추출기를 사용하세요. 21 × 4 픽스처에서 세 가지 모두 84개 셀 중 84개를 일치시켰습니다. 테두리가 없거나 병합된 셀이 있는 표는 별도 테스트가 필요합니다.
Python이 PDF를 Word로 변환할 수 있나요? 예. pdf2docx는 일반적인 오픈 소스 옵션이며, Spire.PDF는 로드된 문서를 DOCX로 저장할 수 있습니다. 변환 출력은 원본 레이아웃에 따라 다릅니다; 프로덕션 사용 전에 대표 파일을 검증하세요.
이 라이브러리들은 상업적 사용에 무료인가요? pypdf, pdfplumber, pikepdf 및 reportlab은 허용적 또는 약한 카피레프트 라이선스(BSD-3, MIT, MPL-2.0, BSD)를 사용합니다. PyMuPDF는 AGPL-3.0 또는 상용이므로 배포 방식에 따라 평가하세요. Spire.PDF는 프로덕션에 상용 라이선스가 필요합니다; 상용 라이선스에는 업데이트와 기술 지원이 포함되며, 무료 및 평가 에디션에는 페이지 제한이 있습니다.