Extrair dados de campos de formulário PDF: métodos sem código e automatizados
Índice
- Antes de começar: campos de formulário são diferentes do texto da página
- Método 1: Exportar dados de campos de formulário PDF com o Adobe Acrobat
- Método 2: Exportar dados de campos de formulário PDF com o Foxit PDF Editor
- Método 3: Extrair dados de campos de formulário PDF com C#
- Qual método você deve escolher?
- Perguntas frequentes
Formulários PDF preenchidos frequentemente contêm informações que precisam ser usadas em outro lugar: dados de contato de formulários de registro, respostas de questionários ou endereços de formulários de solicitação. Abrir cada PDF para consultar esses detalhes funciona ocasionalmente, mas exportar os dados facilita a revisão, a organização e o processamento.
Existem duas abordagens práticas. Um editor de PDF pode exportar dados de formulário por meio de sua interface, enquanto um programa em C# pode ler campos individuais e gravar um arquivo de texto em um formato que você controla. Este guia aborda o Adobe Acrobat, o Foxit PDF Editor e uma abordagem automatizada usando o Spire.PDF for .NET.
Os exemplos se concentram na saída em TXT e usam o mesmo formulário de exemplo preenchido para tornar os resultados comparáveis.
Antes de começar: campos de formulário são diferentes do texto da página
Um campo de formulário PDF é um objeto interativo que armazena um valor. Exemplos incluem um nome inserido em uma caixa de texto, um país selecionado em uma lista suspensa e o estado marcado de uma caixa de seleção de idioma.
Um documento que parece um formulário não necessariamente contém esses objetos. Um formulário de solicitação digitalizado pode ser apenas uma imagem, e um PDF nivelado pode mostrar respostas preenchidas como conteúdo estático da página. Nenhum dos dois fornece os campos interativos originais para os métodos demonstrados aqui lerem.
Este artigo se concentra em campos AcroForm interativos. Extrair respostas de digitalizações exige um fluxo de trabalho diferente, como OCR seguido da identificação das respostas relevantes. Extrair tabelas comuns de PDF também é uma tarefa separada.
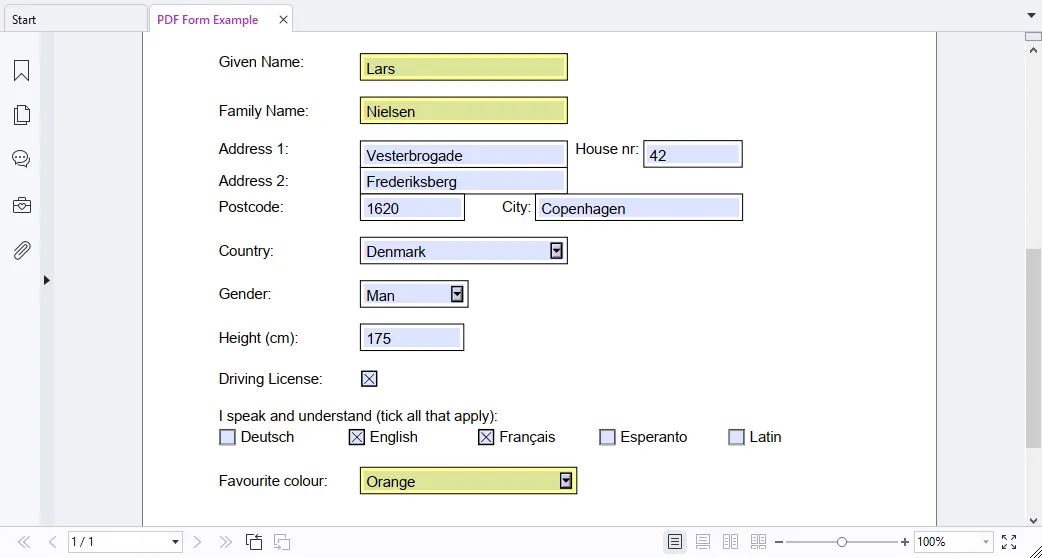
O formulário de exemplo contém informações pessoais, um endereço, caixas de seleção de idioma e uma seleção de cor. Alguns nomes internos incluem descrições de controle, como Given Name Text Box e Country Combo Box. Esses nomes ficarão visíveis nas exportações brutas.
Método 1: Exportar dados de campos de formulário PDF com o Adobe Acrobat
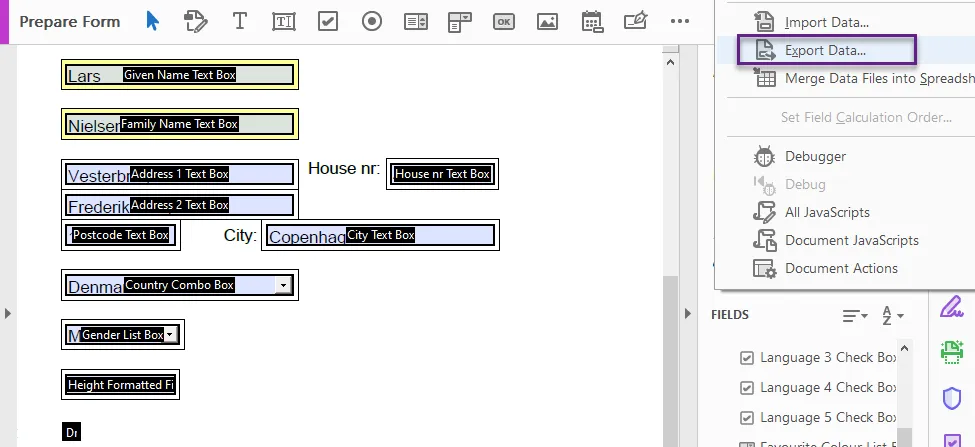
O Acrobat fornece um comando de exportação de dados de formulário que pode salvar os valores de um formulário preenchido sem copiá-los individualmente. Use o aplicativo para desktop com acesso à ferramenta Preparar um formulário; as instruções abaixo não são para o visualizador de PDF do navegador.
Exportar o formulário para TXT
- Abra o PDF preenchido no Adobe Acrobat.
- Selecione Todas as ferramentas → Preparar um formulário.
- No painel de formulário, abra Mais → Exportar dados.
- Selecione TXT na caixa de diálogo Salvar como.
- Escolha um nome de arquivo e destino e clique em Salvar.
O Acrobat também lista FDF, XFDF e XML para este fluxo de trabalho de exportação. Os formatos disponíveis podem depender de como o formulário foi criado. A posição dos menus pode variar entre versões da interface.
Entenda o texto exportado
No exemplo testado, o Acrobat produziu texto separado por tabulações: os nomes dos campos apareceram em uma longa linha, e seus valores apareceram na linha seguinte. Uma ilustração simplificada é:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Aqui, <TAB> representa um caractere de tabulação, e não texto literal no arquivo.
Quando aberto no Bloco de Notas com a Quebra Automática de Linha ativada, essas linhas longas são quebradas na borda da janela. Isso torna difícil acompanhar a relação entre nomes e valores. Desativar Formatar → Quebra Automática de Linha mantém as linhas lógicas intactas, embora a rolagem horizontal ainda seja necessária.
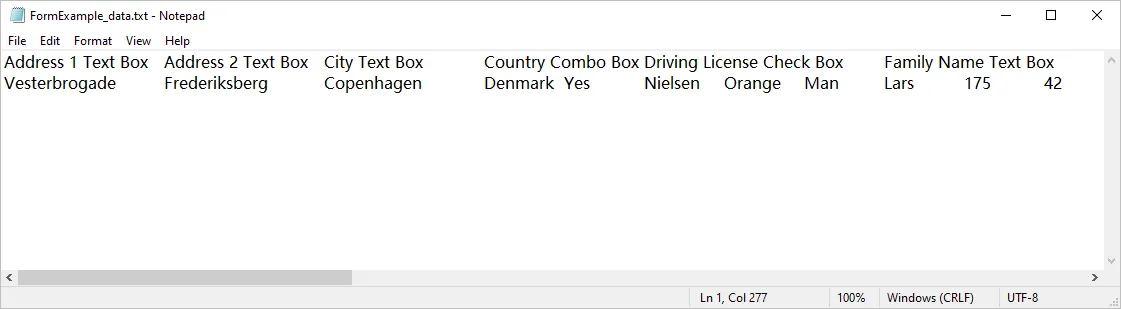
A exportação contém dados úteis, mas não é um relatório de texto organizado verticalmente. Para uma visualização tabular mais clara, importe o TXT para um aplicativo de planilha e selecione um delimitador de tabulação. Se o objetivo for uma lista legível no formato Campo: Valor, é necessário uma etapa adicional de formatação.
O Acrobat oferece separadamente Opções → Mesclar arquivos de dados em planilha para compilar dados de vários formulários. Portanto, a extração baseada em interface não precisa se limitar a um documento por vez.
Método 2: Exportar dados de campos de formulário PDF com o Foxit PDF Editor
O Foxit PDF Editor oferece um fluxo de trabalho de exportação semelhante:
- Abra o formulário PDF preenchido.
- Selecione Formulário → Exportar → Para arquivo.
- Escolha TXT como formato de saída.
- Defina o nome do arquivo e o destino e clique em Salvar.
O guia para Windows também lista CSV, XML, FDF e XFDF como formatos de exportação compatíveis. Os comandos de exportação de formulário se aplicam a formulários interativos, e não a PDFs estáticos comuns.
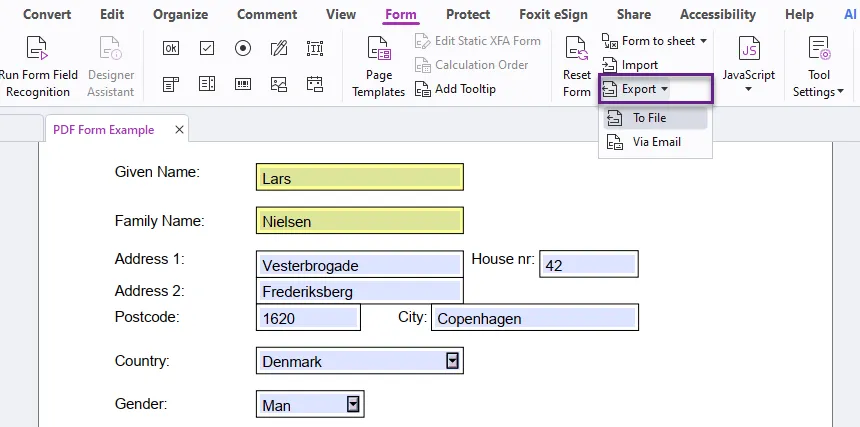
Como o resultado se compara ao do Acrobat?
Para o mesmo PDF de exemplo, a saída TXT do Foxit foi quase idêntica à do Acrobat: nomes internos dos campos na primeira linha, valores correspondentes na linha seguinte e tabulações entre as entradas. Desativar a Quebra Automática de Linha facilitou a inspeção da estrutura, mas não alterou o layout do arquivo.
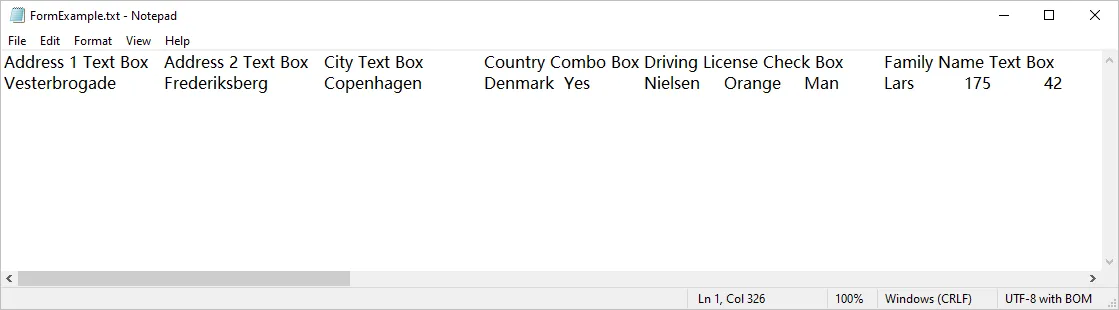
Essa observação se aplica ao exemplo testado. Não deve ser interpretada como indicação de que todo formulário, versão ou configuração de exportação produz arquivos idênticos nos dois aplicativos.
O Foxit é uma alternativa prática se ele já faz parte do seu fluxo de trabalho. Para este caso de uso de TXT, no entanto, trocar de editor não produziu um relatório campo a campo mais legível.
Método 3: Extrair dados de campos de formulário PDF com C#
Ler os campos no código oferece controle sobre o texto final. Em vez de manter o layout tabular da exportação, o exemplo a seguir grava um campo por linha, remove sufixos comuns de controle dos nomes e identifica explicitamente caixas marcadas e desmarcadas.
Ele usa o Spire.PDF for .NET e seu namespace Spire.Pdf.Interactive.Forms. Esse namespace foi introduzido na versão 12.10.7, portanto, use essa versão ou uma versão compatível mais recente. Exemplos mais antigos baseados em outras APIs de formulário podem usar classes diferentes.
Instalar a biblioteca
Crie um projeto de console em C# e instale o pacote NuGet:
dotnet add package Spire.PDF
Coloque o PDF de exemplo no caminho de entrada usado abaixo ou altere inputPath para o seu próprio arquivo. O exemplo grava GetAllValues.txt no diretório de trabalho atual do aplicativo e imprime seu caminho completo quando concluído.
Exemplo completo em C#
O código segue a lógica de extração fornecida, com importações explícitas de namespace, saída em UTF-8 e suporte para gravar todos os valores selecionados em uma caixa de listagem de seleção múltipla.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Como a extração funciona
O programa carrega o PDF, obtém seu contêiner de formulário e itera pelos campos disponíveis. A expressão switch escolhe o valor a ser lido com base no tipo do campo. Caixas de texto fornecem texto; controles de escolha fornecem seus valores de exportação selecionados; caixas de seleção fornecem um estado marcado e um valor de exportação do estado ativado.
CleanName remove sufixos reconhecidos no final de um nome. Por exemplo, Given Name Text Box se torna Given Name. Essa é uma convenção de nomenclatura usada no exemplo, não um método geral para recuperar o rótulo visível impresso ao lado de qualquer campo PDF.
As caixas de seleção precisam de um pouco mais de interpretação. Um valor de exportação como Yes pode ser perfeitamente válido, mas não explica se Language 2 significa inglês ou outro idioma. O dicionário fornece esse conhecimento para este modelo específico. Um formulário diferente exige um mapeamento correspondente, a menos que seus próprios valores de exportação já forneçam rótulos significativos.
É importante notar que um OnValue de Yes não prova que o autor do formulário omitiu um valor personalizado. O código simplesmente o trata como um valor genérico para os campos de idioma mapeados.
Exemplo de saída
Para o exemplo preenchido, o texto resultante pode ser lido diretamente:
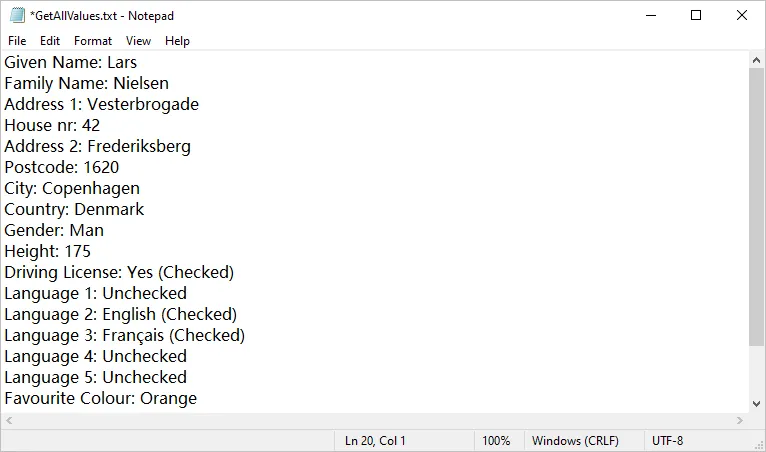
Este exemplo mantém a ordem retornada por form.Fields. Ele não classifica os campos na ordem de leitura da página. Outros PDFs podem retornar uma sequência diferente; use uma configuração explícita de ordem de campos se uma ordem de relatório consistente for necessária.
Limites e ajustes para outros formulários
Este exemplo demonstra a extração de campos de valor AcroForm comuns. Ele não implementa a extração de campos XFA nem o processamento de detalhes de assinatura. O Spire.PDF fornece APIs separadas para acessar campos XFA, que exigem um fluxo de trabalho de extração diferente.
Os controles de escolha podem armazenar valores de exportação diferentes de seus rótulos de opção visíveis. Se um rótulo legível por humanos for necessário, inspecione as definições das opções e adicione a conversão apropriada. Campos de texto multilinha também podem conter quebras de linha, portanto, um único campo pode ocupar mais de uma linha física na saída.
Para vários PDFs, a mesma lógica de extração pode ser chamada a partir de um loop de arquivos. Decida se deve criar um TXT separado para cada documento ou combiná-los com títulos de arquivo claros. O processamento em lote é uma extensão deste exemplo, e não algo que o programa de arquivo único já realize.
Você também pode gostar: Criar, preencher ou remover formulários preenchíveis em PDF em C#
Qual método você deve escolher?
| Requisito | Acrobat | Foxit PDF Editor | Exemplo em C# |
|---|---|---|---|
| Exportar por meio de uma interface gráfica | Sim | Sim | Requer um programa |
| Layout TXT testado | Nomes e valores separados por tabulações | Semelhante ao Acrobat | Entradas de campo e valor |
| Simplificar nomes internos | Processamento adicional necessário | Processamento adicional necessário | Incluído para sufixos reconhecidos |
| Adicionar rótulos de idioma específicos do modelo | Processamento adicional necessário | Processamento adicional necessário | Incluído por meio de um mapeamento |
| Personalizar regras de saída | Limitado pelo fluxo de trabalho de exportação | Limitado pelo fluxo de trabalho de exportação | Controlado no código |
| Repetir dentro de um fluxo de trabalho maior | Depende das ferramentas de aplicativo disponíveis | Depende das ferramentas de aplicativo disponíveis | Pode ser estendido para execuções em lote e integração |
Use o Acrobat ou o Foxit quando precisar de uma exportação rápida e puder trabalhar com os dados tabulares resultantes. Use a abordagem em C# quando o próprio TXT for o entregável, ou quando a nomenclatura dos campos, a interpretação das caixas de seleção e a formatação repetível forem importantes.
Perguntas frequentes
Por que o TXT exportado parece desorganizado no Bloco de Notas?
Nas exportações do Acrobat e do Foxit testadas, nomes e valores ocupam linhas longas separadas com delimitadores de tabulação. A Quebra Automática de Linha quebra essas linhas visualmente, dificultando o acompanhamento de sua correspondência. Desativá-la ajuda na inspeção; importar o arquivo com um delimitador de tabulação fornece uma tabela mais clara.
Esses métodos podem extrair respostas de um formulário digitalizado?
Não por meio de seus campos de formulário originais, se o PDF contiver apenas uma imagem digitalizada. Isso exige OCR e um processo separado para associar respostas reconhecidas a rótulos.
Por que uma caixa marcada retorna Yes em vez de seu rótulo visível?
O valor de exportação do estado ativado armazenado pode ser simplesmente Yes, enquanto o rótulo da opção é um texto separado na página. Um mapeamento específico do modelo pode associar esse campo a um rótulo significativo, como demonstrado para as caixas de seleção de idioma.
O código em C# altera o PDF original?
Ele não salva alterações no PDF. Ele carrega o arquivo, lê os campos e grava um arquivo TXT separado.
Os mesmos dados podem ser gravados em CSV ou JSON?
Sim. Mantenha a lógica de leitura dos campos e substitua a etapa de gravação do TXT por um serializador adequado. Para CSV, use o escape adequado para vírgulas, aspas e quebras de linha. Para JSON, use um serializador em vez de montar strings JSON manualmente.
Veja também
PDF 양식 필드 데이터 추출: 노코드 및 자동화 방법
작성 완료된 PDF 양식에는 종종 다른 곳에서 사용해야 하는 정보가 포함되어 있습니다. 등록 양식의 연락처 세부 정보, 설문지 응답, 신청서의 주소 등이 그 예입니다. 각 PDF를 열어 해당 세부 정보를 찾는 방법은 가끔은 통하지만, 데이터를 내보내면 검토, 정리, 처리하기가 더 쉽습니다.
실용적인 접근 방식은 두 가지입니다. PDF 편집기는 인터페이스를 통해 양식 데이터를 내보낼 수 있고, C# 프로그램은 개별 필드를 읽고 원하는 형식으로 텍스트 파일을 작성할 수 있습니다. 이 가이드에서는 Adobe Acrobat, Foxit PDF Editor, 그리고 Spire.PDF for .NET을 사용하는 자동화 접근 방식을 다룹니다.
예제는 TXT 출력에 중점을 두며, 결과를 비교할 수 있도록 동일한 작성 완료 샘플 양식을 사용합니다.
시작하기 전: 양식 필드는 페이지 텍스트와 다릅니다
PDF 양식 필드는 값을 저장하는 대화형 개체입니다. 예를 들어 텍스트 상자에 입력한 이름, 드롭다운 목록에서 선택한 국가, 언어 확인란의 선택 상태 등이 있습니다.
양식처럼 보이는 문서라도 반드시 이러한 개체를 포함하는 것은 아닙니다. 스캔한 신청서는 이미지일 뿐일 수 있고, 평탄화된 PDF는 작성 완료된 답변을 정적 페이지 콘텐츠로 표시할 수 있습니다. 두 경우 모두 여기에서 설명하는 방법으로 읽을 수 있는 원래의 대화형 필드를 제공하지 않습니다.
이 문서는 대화형 AcroForm 필드에 중점을 둡니다. 스캔본에서 답변을 추출하려면 OCR을 수행한 다음 관련 답변을 식별하는 등 다른 워크플로가 필요합니다. 일반 PDF 표를 추출하는 것도 별도의 작업입니다.
샘플 양식에는 개인 정보, 주소, 언어 확인란, 색상 선택이 포함되어 있습니다. 일부 내부 이름에는 Given Name Text Box 및 Country Combo Box와 같은 컨트롤 설명이 포함되어 있습니다. 이러한 이름은 원시 내보내기에서 표시됩니다.
방법 1: Adobe Acrobat으로 PDF 양식 필드 데이터 내보내기
Acrobat은 완성된 양식의 값을 개별적으로 복사하지 않고도 저장할 수 있는 양식 데이터 내보내기 명령을 제공합니다. Prepare a form 도구에 액세스할 수 있는 데스크톱 애플리케이션을 사용하세요. 아래 지침은 브라우저 PDF 뷰어용이 아닙니다.
양식을 TXT로 내보내기
- Adobe Acrobat에서 작성 완료된 PDF를 엽니다.
- 모든 도구 → Prepare a form을 선택합니다.
- 양식 패널에서 추가 → 데이터 내보내기를 엽니다.
- 다른 이름으로 저장 대화 상자에서 TXT를 선택합니다.
- 파일 이름과 저장 위치를 선택한 다음 저장을 클릭합니다.
Acrobat은 이 내보내기 워크플로에 대해 FDF, XFDF, XML도 나열합니다. 사용 가능한 형식은 양식이 만들어진 방식에 따라 달라질 수 있습니다. 메뉴 위치는 인터페이스 버전에 따라 다를 수 있습니다.
내보낸 텍스트 이해하기
테스트한 샘플에서 Acrobat은 탭으로 구분된 텍스트를 생성했습니다. 필드 이름은 하나의 긴 줄에 나타나고 값은 다음 줄에 나타났습니다. 단순화된 예는 다음과 같습니다.
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
여기서 <TAB>는 파일의 실제 텍스트가 아니라 탭 문자를 나타냅니다.
메모장에서 자동 줄 바꿈을 켜고 열면 이러한 긴 줄이 창 가장자리에서 줄 바꿈됩니다. 그러면 이름과 값의 관계를 따라가기 어렵습니다. 서식 → 자동 줄 바꿈을 끄면 논리적 줄이 그대로 유지되지만 가로 스크롤은 여전히 필요합니다.
내보내기에는 유용한 데이터가 포함되어 있지만 세로로 정렬된 텍스트 보고서는 아닙니다. 더 명확한 표 보기를 원하면 TXT를 스프레드시트 애플리케이션으로 가져와 탭 구분자를 선택하세요. 읽기 쉬운 Field: Value 목록이 목표라면 추가 서식 지정 단계가 필요합니다.
Acrobat은 여러 양식의 데이터를 취합하기 위해 옵션 → 데이터 파일을 스프레드시트로 병합을 별도로 제공합니다. 따라서 인터페이스 기반 추출이 한 번에 하나의 문서로 제한될 필요는 없습니다.
방법 2: Foxit PDF Editor로 PDF 양식 필드 데이터 내보내기
Foxit PDF Editor는 유사한 내보내기 워크플로를 제공합니다.
- 작성 완료된 PDF 양식을 엽니다.
- 양식 → 내보내기 → 파일로를 선택합니다.
- 출력 형식으로 TXT를 선택합니다.
- 파일 이름과 저장 위치를 설정한 다음 저장을 클릭합니다.
Windows 가이드에는 지원되는 내보내기 형식으로 CSV, XML, FDF, XFDF도 나열되어 있습니다. 양식 내보내기 명령은 일반 정적 PDF가 아니라 대화형 양식에 적용됩니다.
Acrobat과 비교하면 결과가 어떻습니까?
동일한 샘플 PDF에서 Foxit의 TXT 출력은 Acrobat의 출력과 거의 동일했습니다. 첫 줄에는 내부 필드 이름, 다음 줄에는 해당 값, 항목 사이에는 탭이 있었습니다. 자동 줄 바꿈을 비활성화하면 구조를 더 쉽게 검사할 수 있었지만 파일의 레이아웃은 바뀌지 않았습니다.
이 관찰은 테스트한 샘플에 적용됩니다. 모든 양식, 버전 또는 내보내기 설정이 두 애플리케이션에서 동일한 파일을 생성한다는 의미로 받아들여서는 안 됩니다.
Foxit이 이미 워크플로의 일부라면 실용적인 대안입니다. 그러나 이 TXT 사용 사례에서는 편집기를 전환해도 필드별 보고서가 더 읽기 쉬워지지는 않았습니다.
방법 3: C#으로 PDF 양식 필드 데이터 추출
코드에서 필드를 읽으면 최종 텍스트를 제어할 수 있습니다. 다음 예제는 표 형식의 내보내기 레이아웃을 유지하는 대신 한 줄에 하나의 필드를 작성하고, 이름에서 일반적인 컨트롤 접미사를 제거하며, 선택 및 선택 해제된 상자를 명시적으로 식별합니다.
Spire.PDF for .NET과 해당 Spire.Pdf.Interactive.Forms 네임스페이스를 사용합니다. 이 네임스페이스는 버전 12.10.7에서 도입되었으므로 해당 릴리스 이상의 호환 버전을 사용하세요. 다른 양식 API를 기반으로 한 이전 샘플은 다른 클래스를 사용할 수 있습니다.
라이브러리 설치
C# 콘솔 프로젝트를 만들고 NuGet 패키지를 설치합니다.
dotnet add package Spire.PDF
샘플 PDF를 아래에 사용된 입력 경로에 두거나 inputPath를 자신의 파일로 변경하세요. 예제는 GetAllValues.txt를 애플리케이션의 현재 작업 디렉터리에 쓰고 완료되면 전체 경로를 출력합니다.
전체 C# 예제
이 코드는 제공된 추출 로직을 따르며, 명시적 네임스페이스 가져오기, UTF-8 출력, 다중 선택 목록 상자에서 선택한 모든 값을 쓰는 기능을 지원합니다.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
추출 작동 방식
프로그램은 PDF를 로드하고 양식 컨테이너를 가져온 다음 사용 가능한 필드를 반복합니다. switch 식은 필드 유형에 따라 읽을 값을 선택합니다. 텍스트 상자는 텍스트를 제공하고, 선택 컨트롤은 선택된 내보내기 값을 제공하며, 확인란은 선택 상태와 켜짐 상태 내보내기 값을 제공합니다.
CleanName은 이름 끝에서 인식된 접미사를 제거합니다. 예를 들어 Given Name Text Box는 Given Name이 됩니다. 이는 샘플에서 사용된 명명 규칙이며, 모든 PDF 필드 옆에 인쇄된 표시 라벨을 복구하는 일반적인 방법은 아닙니다.
확인란은 해석이 조금 더 필요합니다. Yes와 같은 내보내기 값은 완전히 유효할 수 있지만, Language 2가 영어를 의미하는지 다른 언어를 의미하는지 설명하지는 않습니다. 사전은 이 특정 템플릿에 대한 정보를 제공합니다. 다른 양식은 자체 내보내기 값이 이미 의미 있는 라벨을 제공하지 않는 한 해당 매핑이 필요합니다.
중요한 점은 OnValue가 Yes라고 해서 양식 작성자가 사용자 지정 값을 생략했다는 증거는 아닙니다. 코드는 단순히 이를 매핑된 언어 필드의 일반 값으로 처리합니다.
예제 출력
작성 완료된 샘플의 경우 결과 텍스트를 바로 읽을 수 있습니다.
이 예제는 form.Fields에서 반환된 순서를 유지합니다. 필드를 페이지 읽기 순서로 정렬하지는 않습니다. 다른 PDF는 다른 순서를 반환할 수 있습니다. 일관된 보고서 순서가 필요하면 명시적 필드 순서 구성을 사용하세요.
다른 양식에 대한 제한 및 조정
이 예제는 일반적인 AcroForm 값 필드에서 추출하는 방법을 보여줍니다. XFA 필드 추출이나 서명 세부 정보 처리는 구현하지 않습니다. Spire.PDF는 XFA 필드에 액세스하기 위한 별도의 API를 제공하며, 이 경우 다른 추출 워크플로가 필요합니다.
선택 컨트롤은 표시되는 옵션 라벨과 다른 내보내기 값을 저장할 수 있습니다. 사람이 읽을 수 있는 라벨이 필요하면 옵션 정의를 검사하고 적절한 변환을 추가하세요. 여러 줄 텍스트 필드에는 줄 바꿈이 포함될 수도 있으므로 단일 필드가 출력에서 여러 실제 줄을 차지할 수 있습니다.
여러 PDF의 경우 파일 루프에서 동일한 추출 로직을 호출할 수 있습니다. 각 문서에 대해 별도의 TXT를 만들지, 아니면 명확한 파일 이름 제목과 함께 결합할지 결정하세요. 일괄 처리는 이 예제의 확장이며, 단일 파일 프로그램이 이미 수행하는 작업은 아닙니다.
함께 보면 좋은 항목: C#에서 PDF의 채울 수 있는 양식 생성, 작성 또는 제거
어떤 방법을 선택해야 할까요?
| 요구 사항 | Acrobat | Foxit PDF Editor | C# 예제 |
|---|---|---|---|
| 그래픽 인터페이스를 통해 내보내기 | 예 | 예 | 프로그램 필요 |
| 테스트한 TXT 레이아웃 | 탭으로 구분된 이름 및 값 | Acrobat과 유사 | 필드 및 값 항목 |
| 내부 이름 단순화 | 추가 처리 필요 | 추가 처리 필요 | 인식된 접미사에 대해 포함됨 |
| 템플릿별 언어 라벨 추가 | 추가 처리 필요 | 추가 처리 필요 | 매핑을 통해 포함됨 |
| 출력 규칙 사용자 지정 | 내보내기 워크플로에 의해 제한됨 | 내보내기 워크플로에 의해 제한됨 | 코드에서 제어됨 |
| 더 큰 워크플로 내에서 반복 | 사용 가능한 애플리케이션 도구에 따라 다름 | 사용 가능한 애플리케이션 도구에 따라 다름 | 일괄 실행 및 통합을 위해 확장 가능 |
빠른 내보내기가 필요하고 결과 표 형식 데이터로 작업할 수 있으면 Acrobat 또는 Foxit을 사용하세요. TXT 자체가 결과물이거나 필드 이름 지정, 확인란 해석 및 반복 가능한 서식이 중요한 경우 C# 접근 방식을 사용하세요.
자주 묻는 질문
내보낸 TXT가 메모장에서 왜 정리되지 않은 것처럼 보이나요?
테스트한 Acrobat 및 Foxit 내보내기에서 이름과 값은 탭 구분 기호가 있는 별도의 긴 줄을 차지합니다. 자동 줄 바꿈은 이러한 줄을 시각적으로 나누어 대응 관계를 따라가기 어렵게 만듭니다. 이를 끄면 검사에 도움이 되고, 탭 구분 기호로 파일을 가져오면 더 명확한 표를 얻을 수 있습니다.
이러한 방법으로 스캔한 양식에서 답변을 추출할 수 있나요?
PDF에 스캔한 이미지만 포함된 경우 원래 양식 필드를 통해 추출할 수 없습니다. 이를 위해서는 OCR과 인식된 답변을 라벨과 연결하는 별도의 프로세스가 필요합니다.
선택된 확인란이 표시 라벨 대신 Yes를 반환하는 이유는 무엇인가요?
저장된 켜짐 상태 내보내기 값이 단순히 Yes일 수 있으며, 옵션 라벨은 별도의 페이지 텍스트입니다. 템플릿별 매핑을 사용하면 언어 확인란에서 보여준 것처럼 해당 필드를 의미 있는 라벨과 연결할 수 있습니다.
C# 코드가 원본 PDF를 변경하나요?
PDF에 변경 사항을 저장하지 않습니다. 파일을 로드하고 필드를 읽은 다음 별도의 TXT 파일을 작성합니다.
동일한 데이터를 CSV 또는 JSON으로 작성할 수 있나요?
예. 필드 읽기 로직을 유지하고 TXT 작성 단계를 적절한 직렬 변환기로 교체하세요. CSV의 경우 쉼표, 따옴표, 줄 바꿈에 적절한 이스케이프를 사용하세요. JSON의 경우 JSON 문자열을 수동으로 조합하지 말고 직렬 변환기를 사용하세요.
참고 항목
Estrarre i dati dai campi modulo PDF: metodi no-code e automatizzati
Indice
I moduli PDF compilati contengono spesso informazioni che devono essere utilizzate altrove: dati di contatto da moduli di registrazione, risposte a questionari o indirizzi da moduli di richiesta. Aprire ciascun PDF per cercare quei dettagli funziona occasionalmente, ma esportare i dati rende più semplice rivederli, organizzarli ed elaborarli.
Esistono due approcci pratici. Un editor PDF può esportare i dati del modulo tramite la propria interfaccia, mentre un programma C# può leggere i singoli campi e scrivere un file di testo in un formato che puoi controllare. Questa guida illustra Adobe Acrobat, Foxit PDF Editor e un approccio automatizzato tramite Spire.PDF for .NET.
Gli esempi si concentrano sull'output TXT e utilizzano lo stesso modulo di esempio compilato per rendere i risultati confrontabili.
Prima di iniziare: i campi modulo sono diversi dal testo della pagina
Un campo modulo PDF è un oggetto interattivo che memorizza un valore. Ne sono esempi un nome inserito in una casella di testo, un paese selezionato da un elenco a discesa e lo stato selezionato di una casella di controllo per la lingua.
Un documento che sembra un modulo non necessariamente contiene questi oggetti. Un modulo di richiesta scansionato può essere solo un'immagine, e un PDF appiattito può mostrare le risposte compilate come contenuto statico della pagina. In nessuno dei due casi sono disponibili i campi interattivi originali che i metodi qui illustrati devono leggere.
Questo articolo si concentra sui campi AcroForm interattivi. L'estrazione delle risposte dalle scansioni richiede un flusso di lavoro diverso, ad esempio OCR seguito dall'identificazione delle risposte pertinenti. Anche l'estrazione di normali tabelle PDF è un'attività separata.
Il modulo di esempio contiene informazioni personali, un indirizzo, caselle di controllo per le lingue e una selezione di colore. Alcuni nomi interni includono descrizioni di controllo, come Given Name Text Box e Country Combo Box. Tali nomi saranno visibili nelle esportazioni non elaborate.
Metodo 1: esportare i dati dei campi modulo PDF con Adobe Acrobat
Acrobat fornisce un comando di esportazione dei dati del modulo che può salvare i valori di un modulo compilato senza copiarli singolarmente. Utilizza l'applicazione desktop con accesso allo strumento Prepara un modulo; le istruzioni seguenti non sono per il visualizzatore PDF del browser.
Esportare il modulo in TXT
- Apri il PDF compilato in Adobe Acrobat.
- Seleziona Tutti gli strumenti → Prepara un modulo.
- Nel pannello del modulo, apri Altro → Esporta dati.
- Seleziona TXT nella finestra di dialogo Salva con nome.
- Scegli un nome file e una destinazione, quindi fai clic su Salva.
Acrobat elenca anche FDF, XFDF e XML per questo flusso di esportazione. I formati disponibili possono dipendere da come è stato creato il modulo. La posizione dei menu può variare tra le versioni dell'interfaccia.
Comprendere il testo esportato
Nel campione testato, Acrobat ha prodotto testo separato da tabulazioni: i nomi dei campi sono comparsi su una lunga riga e i relativi valori sulla riga successiva. Un'illustrazione semplificata è:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Qui, <TAB> rappresenta un carattere di tabulazione, non il testo letterale nel file.
Se aperte nel Blocco note con l'opzione A capo automatico attiva, queste righe lunghe vengono mandate a capo al bordo della finestra. Ciò rende difficile seguire la relazione tra nomi e valori. Disattivando Formato → A capo automatico le righe logiche restano intatte, anche se è comunque necessario lo scorrimento orizzontale.
L'esportazione contiene dati utili, ma non è un report testuale disposto verticalmente. Per una visualizzazione tabellare più chiara, importa il TXT in un'applicazione per fogli di calcolo e seleziona un delimitatore di tabulazione. Se l'obiettivo è un elenco leggibile Campo: Valore, è necessario un ulteriore passaggio di formattazione.
Acrobat offre separatamente Opzioni → Unisci file di dati in un foglio di calcolo per raccogliere dati da più moduli. L'estrazione tramite interfaccia non deve quindi essere limitata a un documento alla volta.
Metodo 2: esportare i dati dei campi modulo PDF con Foxit PDF Editor
Foxit PDF Editor fornisce un flusso di esportazione simile:
- Apri il modulo PDF compilato.
- Seleziona Modulo → Esporta → Su file.
- Scegli TXT come formato di output.
- Imposta il nome file e la destinazione, quindi fai clic su Salva.
La guida per Windows elenca inoltre CSV, XML, FDF e XFDF come formati di esportazione supportati. I comandi di esportazione del modulo si applicano ai moduli interattivi, non ai normali PDF statici.
Come si confronta il risultato con Acrobat?
Per lo stesso PDF di esempio, l'output TXT di Foxit è stato quasi identico a quello di Acrobat: nomi interni dei campi sulla prima riga, valori corrispondenti sulla riga successiva e tabulazioni tra le voci. Disattivare A capo automatico ha reso più facile esaminare la struttura, ma non ha cambiato il layout del file.
Questa osservazione si applica al campione testato. Non deve essere interpretata come indicazione che ogni modulo, versione o impostazione di esportazione produca file identici in entrambe le applicazioni.
Foxit è un'alternativa pratica se fa già parte del tuo flusso di lavoro. Per questo caso d'uso TXT, tuttavia, cambiare editor non ha prodotto un report campo per campo più leggibile.
Metodo 3: estrarre i dati dei campi modulo PDF con C#
Leggere i campi nel codice offre il controllo sul testo finale. Invece di mantenere il layout tabellare dell'esportazione, l'esempio seguente scrive un campo per riga, rimuove i suffissi di controllo comuni dai nomi e identifica esplicitamente le caselle selezionate e non selezionate.
Utilizza Spire.PDF for .NET e il relativo namespace Spire.Pdf.Interactive.Forms. Questo namespace è stato introdotto nella versione 12.10.7, quindi usa quella release o una versione compatibile più recente. Esempi precedenti basati su altre API per i moduli potrebbero usare classi diverse.
Installare la libreria
Crea un progetto console C# e installa il pacchetto NuGet:
dotnet add package Spire.PDF
Posiziona il PDF di esempio nel percorso di input usato di seguito oppure modifica inputPath con il tuo file. L'esempio scrive GetAllValues.txt nella directory di lavoro corrente dell'applicazione e ne stampa il percorso completo al termine.
Esempio C# completo
Il codice segue la logica di estrazione fornita, con importazioni esplicite dei namespace, output UTF-8 e supporto per la scrittura di tutti i valori selezionati in una casella di riepilogo a selezione multipla.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Come funziona l'estrazione
Il programma carica il PDF, ottiene il contenitore del modulo e scorre i campi disponibili. L'espressione switch sceglie il valore da leggere in base al tipo del campo. Le caselle di testo forniscono il testo; i controlli di scelta forniscono i valori di esportazione selezionati; le caselle di controllo forniscono uno stato selezionato e un valore di esportazione dello stato attivo.
CleanName rimuove i suffissi riconosciuti alla fine di un nome. Ad esempio, Given Name Text Box diventa Given Name. Questa è una convenzione di denominazione usata nel campione, non un metodo generale per recuperare l'etichetta visibile stampata accanto a qualsiasi campo PDF.
Le caselle di controllo richiedono un'interpretazione leggermente maggiore. Un valore di esportazione come Yes può essere perfettamente valido, ma non spiega se Language 2 significhi inglese o un'altra lingua. Il dizionario fornisce tale conoscenza per questo particolare modello. Un modulo diverso richiede una mappatura corrispondente, a meno che i suoi stessi valori di esportazione non forniscano già etichette significative.
È importante notare che un OnValue pari a Yes non dimostra che l'autore del modulo abbia omesso un valore personalizzato. Il codice lo considera semplicemente come un valore generico per i campi lingua mappati.
Output di esempio
Per il campione compilato, il testo risultante può essere letto direttamente:
Questo esempio mantiene l'ordine restituito da form.Fields. Non ordina i campi secondo l'ordine di lettura della pagina. Altri PDF possono restituire una sequenza diversa; usa una configurazione esplicita dell'ordine dei campi se è richiesto un ordine costante nel report.
Limiti e adattamenti per altri moduli
Questo esempio mostra l'estrazione dai comuni campi valore AcroForm. Non implementa l'estrazione dei campi XFA né l'elaborazione dei dettagli delle firme. Spire.PDF fornisce API separate per accedere ai campi XFA, che richiedono un flusso di estrazione diverso.
I controlli di scelta possono memorizzare valori di esportazione diversi dalle etichette visibili delle opzioni. Se è richiesta un'etichetta leggibile, esamina le definizioni delle opzioni e aggiungi la conversione appropriata. Anche i campi di testo multilinea possono contenere interruzioni di riga, quindi un singolo campo può occupare più di una riga fisica nell'output.
Per più PDF, la stessa logica di estrazione può essere chiamata da un ciclo sui file. Decidi se creare un TXT separato per ogni documento o combinarli con intestazioni chiare basate sul nome file. L'elaborazione in batch è un'estensione di questo esempio, non qualcosa che il programma per singolo file esegua già.
Potrebbe interessarti anche: Creare, compilare o rimuovere moduli compilabili nei PDF in C#
Quale metodo scegliere?
| Requisito | Acrobat | Foxit PDF Editor | Esempio C# |
|---|---|---|---|
| Esportare tramite un'interfaccia grafica | Sì | Sì | Richiede un programma |
| Layout TXT testato | Nomi e valori separati da tabulazioni | Simile ad Acrobat | Voci campo e valore |
| Semplificare i nomi interni | Elaborazione aggiuntiva necessaria | Elaborazione aggiuntiva necessaria | Inclusa per i suffissi riconosciuti |
| Aggiungere etichette lingua specifiche del modello | Elaborazione aggiuntiva necessaria | Elaborazione aggiuntiva necessaria | Inclusa tramite una mappatura |
| Personalizzare le regole di output | Limitato dal flusso di esportazione | Limitato dal flusso di esportazione | Controllato nel codice |
| Ripetere all'interno di un flusso di lavoro più ampio | Dipende dagli strumenti applicativi disponibili | Dipende dagli strumenti applicativi disponibili | Può essere esteso per esecuzioni in batch e integrazione |
Usa Acrobat o Foxit quando hai bisogno di un'esportazione rapida e puoi lavorare con i dati tabellari risultanti. Usa l'approccio C# quando il TXT stesso è il deliverable, oppure quando contano la denominazione dei campi, l'interpretazione delle caselle di controllo e una formattazione ripetibile.
Domande frequenti
Perché il TXT esportato sembra disorganizzato nel Blocco note?
Nelle esportazioni Acrobat e Foxit testate, nomi e valori occupano righe lunghe separate con delimitatori di tabulazione. A capo automatico spezza visivamente tali righe, rendendo difficile seguirne la corrispondenza. Disattivarlo aiuta l'ispezione; importare il file con un delimitatore di tabulazione offre una tabella più chiara.
Questi metodi possono estrarre risposte da un modulo scansionato?
Non tramite i suoi campi modulo originali se il PDF contiene solo un'immagine scansionata. Ciò richiede OCR e un processo separato per associare le risposte riconosciute alle etichette.
Perché una casella selezionata restituisce Yes invece della sua etichetta visibile?
Il valore di esportazione dello stato attivo memorizzato può essere semplicemente Yes, mentre l'etichetta dell'opzione è testo separato della pagina. Una mappatura specifica del modello può associare quel campo a un'etichetta significativa, come dimostrato per le caselle di controllo delle lingue.
Il codice C# modifica il PDF originale?
Non salva modifiche nel PDF. Carica il file, legge i campi e scrive un file TXT separato.
Gli stessi dati possono essere scritti in CSV o JSON?
Sì. Mantieni la logica di lettura dei campi e sostituisci il passaggio di scrittura TXT con un serializzatore adeguato. Per CSV, usa un'appropriata escape per virgole, virgolette e interruzioni di riga. Per JSON, usa un serializzatore invece di assemblare manualmente stringhe JSON.
Vedi anche
Extraire les données des champs de formulaire PDF : méthodes sans code et automatisées
Table des matières
- Avant de commencer : les champs de formulaire diffèrent du texte de la page
- Méthode 1 : Exporter les données des champs de formulaire PDF avec Adobe Acrobat
- Méthode 2 : Exporter les données des champs de formulaire PDF avec Foxit PDF Editor
- Méthode 3 : Extraire les données des champs de formulaire PDF avec C#
- Quelle méthode choisir ?
- Questions fréquentes
Les formulaires PDF remplis contiennent souvent des informations qui doivent être utilisées ailleurs : coordonnées issues de formulaires d'inscription, réponses à des questionnaires ou adresses provenant de formulaires de demande. Ouvrir chaque PDF pour rechercher ces détails fonctionne occasionnellement, mais exporter les données facilite leur examen, leur organisation et leur traitement.
Deux approches pratiques existent. Un éditeur PDF peut exporter les données du formulaire via son interface, tandis qu'un programme C# peut lire les champs individuels et écrire un fichier texte dans un format que vous contrôlez. Ce guide couvre Adobe Acrobat, Foxit PDF Editor et une approche automatisée utilisant Spire.PDF for .NET.
Les exemples se concentrent sur la sortie TXT et utilisent le même formulaire d'exemple rempli afin que les résultats soient comparables.
Avant de commencer : les champs de formulaire diffèrent du texte de la page
Un champ de formulaire PDF est un objet interactif qui stocke une valeur. Citons par exemple un nom saisi dans une zone de texte, un pays sélectionné dans une liste déroulante et l'état coché d'une case à cocher de langue.
Un document qui ressemble à un formulaire ne contient pas nécessairement ces objets. Un formulaire de demande numérisé peut n'être qu'une image, et un PDF aplati peut afficher les réponses remplies comme du contenu statique de page. Aucun des deux ne fournit les champs interactifs d'origine que les méthodes présentées ici doivent lire.
Cet article se concentre sur les champs AcroForm interactifs. L'extraction des réponses à partir de scans nécessite un autre processus, comme l'OCR suivi de l'identification des réponses pertinentes. L'extraction de tableaux PDF ordinaires est également une tâche distincte.
Le formulaire d'exemple contient des informations personnelles, une adresse, des cases à cocher de langue et une sélection de couleur. Certains noms internes incluent des descriptions de contrôle, comme Given Name Text Box et Country Combo Box. Ces noms seront visibles dans les exportations brutes.
Méthode 1 : Exporter les données des champs de formulaire PDF avec Adobe Acrobat
Acrobat fournit une commande d'exportation des données de formulaire qui permet d'enregistrer les valeurs d'un formulaire rempli sans les copier individuellement. Utilisez l'application de bureau avec accès à l'outil Préparer un formulaire ; les instructions ci-dessous ne concernent pas la visionneuse PDF du navigateur.
Exporter le formulaire vers TXT
- Ouvrez le PDF rempli dans Adobe Acrobat.
- Sélectionnez Tous les outils → Préparer un formulaire.
- Dans le panneau de formulaire, ouvrez Plus → Exporter les données.
- Sélectionnez TXT dans la boîte de dialogue Enregistrer sous.
- Choisissez un nom de fichier et un emplacement, puis cliquez sur Enregistrer.
Acrobat propose également les formats FDF, XFDF et XML pour ce processus d'exportation. Les formats disponibles peuvent dépendre de la manière dont le formulaire a été créé. L'emplacement des menus peut varier selon les versions de l'interface.
Comprendre le texte exporté
Dans l'échantillon testé, Acrobat a produit un texte séparé par des tabulations : les noms des champs apparaissaient sur une longue ligne, et leurs valeurs sur la ligne suivante. Voici une illustration simplifiée :
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Ici, <TAB> représente un caractère de tabulation, et non un texte littéral dans le fichier.
Lorsqu'elles sont ouvertes dans le Bloc-notes avec le retour à la ligne activé, ces longues lignes s'enroulent au bord de la fenêtre. Cela rend difficile le suivi de la relation entre les noms et les valeurs. Désactiver Format → Retour à la ligne préserve les lignes logiques intactes, bien qu'un défilement horizontal reste nécessaire.
L'exportation contient des données utiles, mais il ne s'agit pas d'un rapport texte disposé verticalement. Pour une vue tabulaire plus claire, importez le TXT dans une application de tableur et sélectionnez un délimiteur de tabulation. Si l'objectif est une liste lisible au format Champ : Valeur, une étape de mise en forme supplémentaire est nécessaire.
Acrobat propose séparément Options → Fusionner les fichiers de données dans un tableur pour compiler les données de plusieurs formulaires. L'extraction via l'interface n'est donc pas nécessairement limitée à un seul document à la fois.
Méthode 2 : Exporter les données des champs de formulaire PDF avec Foxit PDF Editor
Foxit PDF Editor propose un processus d'exportation similaire :
- Ouvrez le formulaire PDF rempli.
- Sélectionnez Formulaire → Exporter → Vers un fichier.
- Choisissez TXT comme format de sortie.
- Définissez le nom du fichier et l'emplacement, puis cliquez sur Enregistrer.
Le guide Windows répertorie également CSV, XML, FDF et XFDF comme formats d'exportation pris en charge. Les commandes d'exportation de formulaire s'appliquent aux formulaires interactifs plutôt qu'aux PDF statiques ordinaires.
Comment le résultat se compare-t-il à Acrobat ?
Pour le même PDF d'exemple, la sortie TXT de Foxit était presque identique à celle d'Acrobat : noms de champs internes sur la première ligne, valeurs correspondantes sur la ligne suivante et tabulations entre les entrées. La désactivation du retour à la ligne a facilité l'inspection de la structure, mais n'a pas modifié la disposition du fichier.
Cette observation s'applique à l'échantillon testé. Elle ne doit pas être interprétée comme signifiant que chaque formulaire, version ou paramètre d'exportation produit des fichiers identiques dans les deux applications.
Foxit est une alternative pratique s'il fait déjà partie de votre flux de travail. Pour ce cas d'utilisation TXT, cependant, changer d'éditeur n'a pas produit un rapport champ par champ plus lisible.
Méthode 3 : Extraire les données des champs de formulaire PDF avec C#
La lecture des champs dans le code vous donne le contrôle sur le texte final. Au lieu de conserver la disposition tabulaire de l'exportation, l'exemple suivant écrit un champ par ligne, supprime les suffixes de contrôle courants des noms et identifie explicitement les cases cochées et décochées.
Il utilise Spire.PDF for .NET et son espace de noms Spire.Pdf.Interactive.Forms. Cet espace de noms a été introduit dans la version 12.10.7 ; utilisez donc cette version ou une version compatible plus récente. Les anciens exemples basés sur d'autres API de formulaire peuvent utiliser des classes différentes.
Installer la bibliothèque
Créez un projet console C# et installez le package NuGet :
dotnet add package Spire.PDF
Placez le PDF d'exemple au chemin d'entrée utilisé ci-dessous, ou modifiez inputPath pour votre propre fichier. L'exemple écrit GetAllValues.txt dans le répertoire de travail actuel de l'application et affiche son chemin complet une fois terminé.
Exemple C# complet
Le code suit la logique d'extraction fournie, avec des importations d'espaces de noms explicites, une sortie UTF-8 et la prise en charge de l'écriture de toutes les valeurs sélectionnées dans une liste à sélection multiple.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Comment fonctionne l'extraction
Le programme charge le PDF, obtient son conteneur de formulaire et parcourt les champs disponibles. L'expression switch choisit la valeur à lire en fonction du type du champ. Les zones de texte fournissent du texte ; les contrôles de choix fournissent leurs valeurs d'exportation sélectionnées ; les cases à cocher fournissent un état coché et une valeur d'exportation à l'état activé.
CleanName supprime les suffixes reconnus à la fin d'un nom. Par exemple, Given Name Text Box devient Given Name. Il s'agit d'une convention de nommage utilisée dans l'échantillon, et non d'une méthode générale permettant de récupérer l'étiquette visible imprimée à côté de n'importe quel champ PDF.
Les cases à cocher nécessitent un peu plus d'interprétation. Une valeur d'exportation telle que Yes peut être parfaitement valide, mais elle n'explique pas si Language 2 signifie l'anglais ou une autre langue. Le dictionnaire fournit cette connaissance pour ce modèle particulier. Un formulaire différent nécessite un mappage correspondant, sauf si ses propres valeurs d'exportation fournissent déjà des étiquettes significatives.
Il est important de noter qu'une valeur OnValue de Yes ne prouve pas que l'auteur du formulaire a omis une valeur personnalisée. Le code la traite simplement comme une valeur générique pour les champs de langue mappés.
Exemple de sortie
Pour l'échantillon rempli, le texte résultant peut être lu directement :
Cet exemple conserve l'ordre renvoyé par form.Fields. Il ne trie pas les champs selon l'ordre de lecture des pages. D'autres PDF peuvent renvoyer une séquence différente ; utilisez une configuration explicite de l'ordre des champs si un ordre de rapport cohérent est requis.
Limites et ajustements pour d'autres formulaires
Cet exemple illustre l'extraction à partir des champs de valeur AcroForm courants. Il n'implémente pas l'extraction des champs XFA ni le traitement des détails de signature. Spire.PDF fournit des API distinctes pour accéder aux champs XFA, qui nécessitent un processus d'extraction différent.
Les contrôles de choix peuvent stocker des valeurs d'exportation différentes de leurs étiquettes d'option visibles. Si une étiquette lisible par l'homme est requise, inspectez les définitions des options et ajoutez la conversion appropriée. Les champs de texte multiligne peuvent également contenir des sauts de ligne, de sorte qu'un seul champ peut occuper plusieurs lignes physiques dans la sortie.
Pour plusieurs PDF, la même logique d'extraction peut être appelée depuis une boucle de fichiers. Décidez s'il faut créer un TXT distinct pour chaque document ou les combiner avec des en-têtes de nom de fichier clairs. Le traitement par lots est une extension de cet exemple, et non quelque chose que le programme monoposte effectue déjà.
Vous aimerez peut-être aussi : Créer, remplir ou supprimer des formulaires remplissables dans un PDF en C#
Quelle méthode choisir ?
| Exigence | Acrobat | Foxit PDF Editor | Exemple C# |
|---|---|---|---|
| Exporter via une interface graphique | Oui | Oui | Nécessite un programme |
| Disposition TXT testée | Noms et valeurs séparés par des tabulations | Similaire à Acrobat | Entrées champ-valeur |
| Simplifier les noms internes | Traitement supplémentaire nécessaire | Traitement supplémentaire nécessaire | Inclus pour les suffixes reconnus |
| Ajouter des étiquettes de langue spécifiques au modèle | Traitement supplémentaire nécessaire | Traitement supplémentaire nécessaire | Inclus via un mappage |
| Personnaliser les règles de sortie | Limité par le processus d'exportation | Limité par le processus d'exportation | Contrôlé dans le code |
| Répéter dans un flux de travail plus large | Dépend des outils d'application disponibles | Dépend des outils d'application disponibles | Peut être étendu pour des exécutions par lots et une intégration |
Utilisez Acrobat ou Foxit lorsque vous avez besoin d'une exportation rapide et que vous pouvez travailler avec les données tabulaires obtenues. Utilisez l'approche C# lorsque le TXT lui-même constitue le livrable, ou lorsque le nommage des champs, l'interprétation des cases à cocher et une mise en forme reproductible importent.
Questions fréquentes
Pourquoi le TXT exporté semble-t-il désorganisé dans le Bloc-notes ?
Dans les exportations Acrobat et Foxit testées, les noms et les valeurs occupent des lignes longues distinctes avec des délimiteurs de tabulation. Le retour à la ligne coupe visuellement ces lignes, ce qui rend difficile le suivi de leur correspondance. Le désactiver facilite l'inspection ; importer le fichier avec un délimiteur de tabulation donne un tableau plus clair.
Ces méthodes peuvent-elles extraire les réponses d'un formulaire numérisé ?
Pas via ses champs de formulaire d'origine si le PDF ne contient qu'une image numérisée. Cela nécessite l'OCR et un processus distinct pour associer les réponses reconnues aux étiquettes.
Pourquoi une case cochée renvoie-t-elle Yes au lieu de son étiquette visible ?
La valeur d'exportation de l'état activé stockée peut simplement être Yes, tandis que l'étiquette de l'option est un texte de page distinct. Un mappage spécifique au modèle peut associer ce champ à une étiquette significative, comme démontré pour les cases à cocher de langue.
Le code C# modifie-t-il le PDF d'origine ?
Il n'enregistre aucune modification dans le PDF. Il charge le fichier, lit les champs et écrit un fichier TXT distinct.
Les mêmes données peuvent-elles être écrites au format CSV ou JSON ?
Oui. Conservez la logique de lecture des champs et remplacez l'étape d'écriture TXT par un sérialiseur approprié. Pour CSV, utilisez un échappement correct pour les virgules, les guillemets et les sauts de ligne. Pour JSON, utilisez un sérialiseur plutôt que d'assembler manuellement des chaînes JSON.
Voir aussi
Extraer datos de campos de formularios PDF: métodos sin código y automatizados
Tabla de contenidos
- Antes de empezar: los campos de formulario son diferentes del texto de la página
- Método 1: Exportar datos de campos de formulario PDF con Adobe Acrobat
- Método 2: Exportar datos de campos de formulario PDF con Foxit PDF Editor
- Método 3: Extraer datos de campos de formulario PDF con C#
- ¿Qué método debería elegir?
- Preguntas frecuentes
Los formularios PDF completados a menudo contienen información que debe utilizarse en otro lugar: datos de contacto de formularios de registro, respuestas de cuestionarios o direcciones de formularios de solicitud. Abrir cada PDF para buscar esos datos funciona en ocasiones, pero exportar los datos facilita su revisión, organización y procesamiento.
Existen dos enfoques prácticos. Un editor de PDF puede exportar los datos del formulario a través de su interfaz, mientras que un programa en C# puede leer campos individuales y escribir un archivo de texto en un formato que usted controla. Esta guía cubre Adobe Acrobat, Foxit PDF Editor y un enfoque automatizado utilizando Spire.PDF para .NET.
Los ejemplos se centran en la salida TXT y utilizan el mismo formulario de muestra completado para que los resultados sean comparables.
Antes de empezar: los campos de formulario son diferentes del texto de la página
Un campo de formulario PDF es un objeto interactivo que almacena un valor. Los ejemplos incluyen un nombre introducido en un cuadro de texto, un país seleccionado de una lista desplegable y el estado marcado de una casilla de verificación de idioma.
Un documento que parece un formulario no necesariamente contiene estos objetos. Un formulario de solicitud escaneado puede ser solo una imagen, y un PDF aplanado puede mostrar las respuestas completadas como contenido estático de la página. Ninguno de los dos proporciona los campos interactivos originales para que los lean los métodos que se demuestran aquí.
Este artículo se centra en los campos AcroForm interactivos. Extraer respuestas de escaneos requiere un flujo de trabajo diferente, como OCR seguido de la identificación de las respuestas relevantes. Extraer tablas PDF ordinarias también es una tarea separada.
El formulario de muestra contiene información personal, una dirección, casillas de verificación de idioma y una selección de color. Algunos nombres internos incluyen descripciones de controles, como Given Name Text Box y Country Combo Box. Esos nombres serán visibles en las exportaciones sin procesar.
Método 1: Exportar datos de campos de formulario PDF con Adobe Acrobat
Acrobat proporciona un comando de exportación de datos de formulario que puede guardar los valores de un formulario completado sin copiarlos individualmente. Utilice la aplicación de escritorio con acceso a la herramienta Preparar un formulario; las instrucciones a continuación no son para el visor de PDF del navegador.
Exportar el formulario a TXT
- Abra el PDF completado en Adobe Acrobat.
- Seleccione Todas las herramientas → Preparar un formulario.
- En el panel del formulario, abra Más → Exportar datos.
- Seleccione TXT en el cuadro de diálogo Guardar como.
- Elija un nombre de archivo y un destino, y luego haga clic en Guardar.
Acrobat también incluye FDF, XFDF y XML para este flujo de trabajo de exportación. Los formatos disponibles pueden depender de cómo se creó el formulario. La ubicación del menú puede variar entre versiones de la interfaz.
Entender el texto exportado
En la muestra probada, Acrobat produjo texto separado por tabulaciones: los nombres de los campos aparecieron en una línea larga y sus valores aparecieron en la línea siguiente. Una ilustración simplificada es:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Aquí, <TAB> representa un carácter de tabulación, en lugar de texto literal en el archivo.
Cuando se abre en Notepad con el ajuste de línea habilitado, estas líneas largas se ajustan en el borde de la ventana. Eso hace que la relación entre nombres y valores sea difícil de seguir. Desactivar Formato → Ajuste de línea mantiene las líneas lógicas intactas, aunque el desplazamiento horizontal sigue siendo necesario.
La exportación contiene datos útiles, pero no es un informe de texto organizado verticalmente. Para una vista tabular más clara, importe el TXT en una aplicación de hoja de cálculo y seleccione un delimitador de tabulación. Si el objetivo es una lista legible con formato Campo: Valor, se necesita un paso de formato adicional.
Acrobat ofrece por separado Opciones → Combinar archivos de datos en una hoja de cálculo para recopilar datos de varios formularios. Por lo tanto, la extracción basada en la interfaz no tiene que limitarse a un documento a la vez.
Método 2: Exportar datos de campos de formulario PDF con Foxit PDF Editor
Foxit PDF Editor proporciona un flujo de trabajo de exportación similar:
- Abra el formulario PDF completado.
- Seleccione Formulario → Exportar → A archivo.
- Elija TXT como formato de salida.
- Establezca el nombre de archivo y el destino, y luego haga clic en Guardar.
La guía de Windows también incluye CSV, XML, FDF y XFDF como formatos de exportación compatibles. Los comandos de exportación de formularios se aplican a formularios interactivos en lugar de PDF estáticos ordinarios.
¿Cómo se compara el resultado con Acrobat?
Para el mismo PDF de muestra, la salida TXT de Foxit fue casi idéntica a la de Acrobat: nombres internos de campos en la primera línea, valores correspondientes en la línea siguiente y tabulaciones entre entradas. Desactivar el ajuste de línea facilitó la inspección de la estructura, pero no cambió el diseño del archivo.
Esta observación se aplica a la muestra probada. No debe interpretarse como que cada formulario, versión o configuración de exportación produce archivos idénticos en ambas aplicaciones.
Foxit es una alternativa práctica si ya forma parte de su flujo de trabajo. Sin embargo, para este caso de uso de TXT, cambiar de editor no produjo un informe campo por campo más legible.
Método 3: Extraer datos de campos de formulario PDF con C#
Leer los campos en código le da control sobre el texto final. En lugar de mantener el diseño de exportación tabular, el siguiente ejemplo escribe un campo por línea, elimina los sufijos de control comunes de los nombres e identifica explícitamente las casillas marcadas y no marcadas.
Utiliza Spire.PDF para .NET y su espacio de nombres Spire.Pdf.Interactive.Forms. Este espacio de nombres se introdujo en la versión 12.10.7, así que utilice esa versión o una versión compatible más reciente. Las muestras anteriores basadas en otras API de formularios pueden usar clases diferentes.
Instalar la biblioteca
Cree un proyecto de consola en C# e instale el paquete NuGet:
dotnet add package Spire.PDF
Coloque el PDF de muestra en la ruta de entrada utilizada a continuación, o cambie inputPath a su propio archivo. El ejemplo escribe GetAllValues.txt en el directorio de trabajo actual de la aplicación e imprime su ruta completa al finalizar.
Ejemplo completo en C#
El código sigue la lógica de extracción proporcionada, con importaciones explícitas de espacios de nombres, salida en UTF-8 y soporte para escribir todos los valores seleccionados en un cuadro de lista de selección múltiple.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Cómo funciona la extracción
El programa carga el PDF, obtiene su contenedor de formulario e itera a través de los campos disponibles. La expresión switch elige el valor a leer según el tipo de campo. Los cuadros de texto suministran texto; los controles de elección suministran sus valores de exportación seleccionados; las casillas de verificación suministran un estado marcado y un valor de exportación de estado activo.
CleanName elimina los sufijos reconocidos al final de un nombre. Por ejemplo, Given Name Text Box se convierte en Given Name. Esta es una convención de nomenclatura utilizada en la muestra, no un método general para recuperar la etiqueta visible impresa junto a cualquier campo PDF.
Las casillas de verificación necesitan un poco más de interpretación. Un valor de exportación como Yes puede ser perfectamente válido, pero no explica si Language 2 significa inglés u otro idioma. El diccionario proporciona ese conocimiento para esta plantilla en particular. Un formulario diferente requiere una asignación correspondiente, a menos que sus propios valores de exportación ya proporcionen etiquetas significativas.
Es importante destacar que un OnValue de Yes no demuestra que el autor del formulario haya omitido un valor personalizado. El código simplemente lo trata como un valor genérico para los campos de idioma asignados.
Salida de ejemplo
Para la muestra completada, el texto resultante se puede leer directamente:
Este ejemplo mantiene el orden devuelto por form.Fields. No ordena los campos en el orden de lectura de la página. Otros PDF pueden devolver una secuencia diferente; utilice una configuración explícita de orden de campos si se requiere un orden de informe consistente.
Límites y ajustes para otros formularios
Este ejemplo demuestra la extracción de campos de valor AcroForm comunes. No implementa la extracción de campos XFA ni el procesamiento de detalles de firma. Spire.PDF proporciona API separadas para acceder a campos XFA, que requieren un flujo de trabajo de extracción diferente.
Los controles de elección pueden almacenar valores de exportación que difieren de sus etiquetas de opción visibles. Si se requiere una etiqueta legible por humanos, inspeccione las definiciones de opciones y añada la conversión adecuada. Los campos de texto de varias líneas también pueden contener saltos de línea, por lo que un solo campo puede ocupar más de una línea física en la salida.
Para varios PDF, la misma lógica de extracción se puede llamar desde un bucle de archivos. Decida si crear un TXT separado para cada documento o combinarlos con encabezados de nombre de archivo claros. El procesamiento por lotes es una extensión de este ejemplo, en lugar de algo que el programa de archivo único ya realice.
También le puede interesar: Crear, rellenar o eliminar formularios rellenables en PDF en C#
¿Qué método debería elegir?
| Requisito | Acrobat | Foxit PDF Editor | Ejemplo en C# |
|---|---|---|---|
| Exportar a través de una interfaz gráfica | Sí | Sí | Requiere un programa |
| Diseño TXT probado | Nombres y valores separados por tabulaciones | Similar a Acrobat | Entradas de campo y valor |
| Simplificar nombres internos | Se necesita procesamiento adicional | Se necesita procesamiento adicional | Incluido para sufijos reconocidos |
| Añadir etiquetas de idioma específicas de la plantilla | Se necesita procesamiento adicional | Se necesita procesamiento adicional | Incluido mediante una asignación |
| Personalizar reglas de salida | Limitado por el flujo de trabajo de exportación | Limitado por el flujo de trabajo de exportación | Controlado en código |
| Repetir dentro de un flujo de trabajo más amplio | Depende de las herramientas de aplicación disponibles | Depende de las herramientas de aplicación disponibles | Se puede extender para ejecuciones por lotes e integración |
Utilice Acrobat o Foxit cuando necesite una exportación rápida y pueda trabajar con los datos tabulares resultantes. Utilice el enfoque en C# cuando el TXT en sí sea el entregable, o cuando importen la nomenclatura de campos, la interpretación de casillas de verificación y el formato repetible.
Preguntas frecuentes
¿Por qué el TXT exportado se ve desorganizado en Notepad?
En las exportaciones de Acrobat y Foxit probadas, los nombres y valores ocupan líneas largas separadas con delimitadores de tabulación. El ajuste de línea rompe visualmente esas líneas, dificultando el seguimiento de su correspondencia. Desactivarlo ayuda a la inspección; importar el archivo con un delimitador de tabulación proporciona una tabla más clara.
¿Pueden estos métodos extraer respuestas de un formulario escaneado?
No a través de sus campos de formulario originales si el PDF contiene solo una imagen escaneada. Eso requiere OCR y un proceso separado para asociar las respuestas reconocidas con las etiquetas.
¿Por qué una casilla marcada devuelve Yes en lugar de su etiqueta visible?
El valor de exportación de estado activo almacenado puede ser simplemente Yes, mientras que la etiqueta de la opción es texto de página separado. Una asignación específica de la plantilla puede asociar ese campo con una etiqueta significativa, como se demuestra para las casillas de verificación de idioma.
¿El código en C# modifica el PDF original?
No guarda cambios en el PDF. Carga el archivo, lee los campos y escribe un archivo TXT separado.
¿Se pueden escribir los mismos datos en CSV o JSON?
Sí. Mantenga la lógica de lectura de campos y reemplace el paso de escritura de TXT con un serializador adecuado. Para CSV, utilice el escape adecuado para comas, comillas y saltos de línea. Para JSON, utilice un serializador en lugar de ensamblar cadenas JSON manualmente.
Ver también
PDF-Formularfelddaten extrahieren: No-Code- und automatisierte Methoden
Inhaltsverzeichnis
- Bevor Sie beginnen: Formularfelder unterscheiden sich vom Seitentext
- Methode 1: PDF-Formularfelddaten mit Adobe Acrobat exportieren
- Methode 2: PDF-Formularfelddaten mit Foxit PDF Editor exportieren
- Methode 3: PDF-Formularfelddaten mit C# extrahieren
- Welche Methode sollten Sie wählen?
- Häufig gestellte Fragen
Ausgefüllte PDF-Formulare enthalten oft Informationen, die an anderer Stelle benötigt werden: Kontaktdaten aus Anmeldeformularen, Antworten aus Fragebögen oder Adressen aus Antragsformularen. Jedes PDF zu öffnen, um diese Angaben nachzuschlagen, funktioniert gelegentlich, aber der Export der Daten erleichtert das Prüfen, Organisieren und Verarbeiten.
Es gibt zwei praktische Ansätze. Ein PDF-Editor kann Formulardaten über seine Benutzeroberfläche exportieren, während ein C#-Programm einzelne Felder lesen und eine Textdatei in einem von Ihnen kontrollierten Format schreiben kann. Diese Anleitung behandelt Adobe Acrobat, Foxit PDF Editor und einen automatisierten Ansatz mit Spire.PDF for .NET.
Die Beispiele konzentrieren sich auf die TXT-Ausgabe und verwenden dasselbe ausgefüllte Beispielformular, damit die Ergebnisse vergleichbar sind.
Bevor Sie beginnen: Formularfelder unterscheiden sich vom Seitentext
Ein PDF-Formularfeld ist ein interaktives Objekt, das einen Wert speichert. Beispiele sind ein in ein Textfeld eingegebener Name, ein aus einer Dropdown-Liste ausgewähltes Land und der aktivierte Zustand eines Sprachkontrollkästchens.
Ein Dokument, das wie ein Formular aussieht, enthält nicht unbedingt diese Objekte. Ein gescanntes Antragsformular kann nur ein Bild sein, und ein abgeflachtes PDF kann ausgefüllte Antworten als statischen Seiteninhalt anzeigen. Keines von beiden stellt die ursprünglichen interaktiven Felder bereit, die die hier vorgestellten Methoden lesen können.
Dieser Artikel konzentriert sich auf interaktive AcroForm-Felder. Das Extrahieren von Antworten aus Scans erfordert einen anderen Arbeitsablauf, z. B. OCR gefolgt vom Identifizieren der relevanten Antworten. Das Extrahieren gewöhnlicher PDF-Tabellen ist ebenfalls eine separate Aufgabe.
Das Beispielformular enthält persönliche Informationen, eine Adresse, Sprachkontrollkästchen und eine Farbauswahl. Einige interne Namen enthalten Steuerungsbeschreibungen wie Given Name Text Box und Country Combo Box. Diese Namen sind in den Rohausgaben sichtbar.
Methode 1: PDF-Formularfelddaten mit Adobe Acrobat exportieren
Acrobat bietet einen Befehl zum Exportieren von Formulardaten, mit dem die Werte eines ausgefüllten Formulars gespeichert werden können, ohne sie einzeln zu kopieren. Verwenden Sie die Desktop-Anwendung mit Zugriff auf das Werkzeug „Formular vorbereiten“. Die folgenden Anweisungen gelten nicht für den PDF-Viewer im Browser.
Das Formular als TXT exportieren
- Öffnen Sie das ausgefüllte PDF in Adobe Acrobat.
- Wählen Sie Alle Werkzeuge → Formular vorbereiten.
- Öffnen Sie im Formularbereich Mehr → Daten exportieren.
- Wählen Sie im Dialogfeld „Speichern unter“ TXT.
- Wählen Sie einen Dateinamen und einen Zielort und klicken Sie dann auf Speichern.
Acrobat listet für diesen Exportvorgang auch FDF, XFDF und XML auf. Die verfügbaren Formate können davon abhängen, wie das Formular erstellt wurde. Die Menüplatzierung kann zwischen Oberflächenversionen abweichen.
Den exportierten Text verstehen
Im getesteten Beispiel erzeugte Acrobat tabulatorgetrennten Text: Die Feldnamen erschienen in einer langen Zeile und ihre Werte in der folgenden Zeile. Eine vereinfachte Darstellung ist:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Hier steht <TAB> für ein Tabulatorzeichen und nicht für wörtlichen Text in der Datei.
Beim Öffnen in Notepad mit aktiviertem Zeilenumbruch werden diese langen Zeilen am Fensterrand umbrochen. Dadurch ist der Zusammenhang zwischen Namen und Werten schwer nachzuvollziehen. Wenn Sie Format → Zeilenumbruch deaktivieren, bleiben die logischen Zeilen intakt, obwohl weiterhin horizontal gescrollt werden muss.
Der Export enthält nützliche Daten, ist aber kein vertikal angeordneter Textbericht. Für eine übersichtlichere tabellarische Ansicht importieren Sie die TXT-Datei in eine Tabellenkalkulationsanwendung und wählen ein Tabulator-Trennzeichen. Wenn das Ziel eine lesbare Liste im Format Feld: Wert ist, ist ein zusätzlicher Formatierungsschritt erforderlich.
Acrobat bietet separat Optionen → Daten aus Dateien in Tabellenkalkulation zusammenführen zum Zusammenstellen von Daten aus mehreren Formularen. Die Extraktion über die Oberfläche muss daher nicht auf ein Dokument gleichzeitig beschränkt sein.
Methode 2: PDF-Formularfelddaten mit Foxit PDF Editor exportieren
Foxit PDF Editor bietet einen ähnlichen Exportvorgang:
- Öffnen Sie das ausgefüllte PDF-Formular.
- Wählen Sie Formular → Exportieren → In Datei.
- Wählen Sie TXT als Ausgabeformat.
- Legen Sie Dateinamen und Zielort fest und klicken Sie dann auf Speichern.
Die Windows-Anleitung listet außerdem CSV, XML, FDF und XFDF als unterstützte Exportformate auf. Die Formularexportbefehle gelten für interaktive Formulare und nicht für gewöhnliche statische PDFs.
Wie unterscheidet sich das Ergebnis von Acrobat?
Für dasselbe Beispiel-PDF war die TXT-Ausgabe von Foxit nahezu identisch mit der von Acrobat: interne Feldnamen in der ersten Zeile, entsprechende Werte in der nächsten Zeile und Tabulatoren zwischen den Einträgen. Das Deaktivieren des Zeilenumbruchs erleichterte die Prüfung der Struktur, änderte aber nicht das Layout der Datei.
Diese Beobachtung gilt für das getestete Beispiel. Sie sollte nicht so verstanden werden, dass jedes Formular, jede Version oder jede Exporteinstellung in beiden Anwendungen identische Dateien erzeugt.
Foxit ist eine praktische Alternative, wenn es bereits Teil Ihres Arbeitsablaufs ist. Für diesen TXT-Anwendungsfall führte der Wechsel des Editors jedoch nicht zu einem besser lesbaren Bericht Feld für Feld.
Methode 3: PDF-Formularfelddaten mit C# extrahieren
Das Lesen der Felder im Code gibt Ihnen Kontrolle über den endgültigen Text. Anstatt das tabellarische Exportlayout beizubehalten, schreibt das folgende Beispiel ein Feld pro Zeile, entfernt gängige Steuerungssuffixe aus Namen und kennzeichnet aktivierte und deaktivierte Kontrollkästchen ausdrücklich.
Es verwendet Spire.PDF for .NET und dessen Namespace Spire.Pdf.Interactive.Forms. Dieser Namespace wurde in Version 12.10.7 eingeführt. Verwenden Sie daher diese Version oder eine neuere kompatible Version. Ältere Beispiele, die auf anderen Formular-APIs basieren, verwenden möglicherweise andere Klassen.
Die Bibliothek installieren
Erstellen Sie ein C#-Konsolenprojekt und installieren Sie das NuGet-Paket:
dotnet add package Spire.PDF
Legen Sie das Beispiel-PDF am unten verwendeten Eingabepfad ab oder ändern Sie inputPath in Ihre eigene Datei. Das Beispiel schreibt GetAllValues.txt in das aktuelle Arbeitsverzeichnis der Anwendung und gibt nach Abschluss den vollständigen Pfad aus.
Vollständiges C#-Beispiel
Der Code folgt der bereitgestellten Extraktionslogik mit expliziten Namespace-Importen, UTF-8-Ausgabe und Unterstützung für das Schreiben aller ausgewählten Werte in einem Mehrfachauswahl-Listenfeld.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Wie die Extraktion funktioniert
Das Programm lädt das PDF, ruft dessen Formularcontainer ab und durchläuft die verfügbaren Felder. Der switch-Ausdruck wählt den zu lesenden Wert basierend auf dem Feldtyp aus. Textfelder liefern Text; Auswahlsteuerelemente liefern ihre ausgewählten Exportwerte; Kontrollkästchen liefern einen aktivierten Zustand und einen Exportwert für den Ein-Zustand.
CleanName entfernt erkannte Suffixe am Ende eines Namens. Beispielsweise wird aus Given Name Text Box der Wert Given Name. Dies ist eine im Beispiel verwendete Namenskonvention und keine allgemeine Methode zum Wiederherstellen der sichtbaren Beschriftung, die neben einem beliebigen PDF-Feld gedruckt wird.
Kontrollkästchen erfordern etwas mehr Interpretation. Ein Exportwert wie Yes kann durchaus gültig sein, erklärt aber nicht, ob Language 2 Englisch oder eine andere Sprache bedeutet. Das Wörterbuch liefert dieses Wissen für diese bestimmte Vorlage. Ein anderes Formular erfordert eine entsprechende Zuordnung, es sei denn, seine eigenen Exportwerte liefern bereits aussagekräftige Beschriftungen.
Wichtig ist, dass ein OnValue von Yes nicht beweist, dass der Formularautor einen benutzerdefinierten Wert weggelassen hat. Der Code behandelt ihn einfach als generischen Wert für die zugeordneten Sprachfelder.
Beispielausgabe
Für das ausgefüllte Beispiel kann der resultierende Text direkt gelesen werden:
Dieses Beispiel behält die von form.Fields zurückgegebene Reihenfolge bei. Es sortiert die Felder nicht in die Lesereihenfolge der Seiten. Andere PDFs können eine andere Reihenfolge zurückgeben. Verwenden Sie eine explizite Feldreihenfolge-Konfiguration, wenn eine konsistente Berichtsreihenfolge erforderlich ist.
Grenzen und Anpassungen für andere Formulare
Dieses Beispiel demonstriert die Extraktion aus gängigen AcroForm-Wertfeldern. Es implementiert weder die XFA-Feldextraktion noch die Verarbeitung von Signaturdetails. Spire.PDF bietet separate APIs für den Zugriff auf XFA-Felder, die einen anderen Extraktionsablauf erfordern.
Auswahlsteuerelemente können Exportwerte speichern, die von ihren sichtbaren Optionsbezeichnungen abweichen. Wenn eine für Menschen lesbare Bezeichnung erforderlich ist, prüfen Sie die Optionsdefinitionen und fügen Sie die entsprechende Konvertierung hinzu. Mehrzeilige Textfelder können außerdem Zeilenumbrüche enthalten, sodass ein einzelnes Feld in der Ausgabe mehr als eine physische Zeile belegen kann.
Für mehrere PDFs kann dieselbe Extraktionslogik aus einer Dateischleife aufgerufen werden. Entscheiden Sie, ob für jedes Dokument eine separate TXT-Datei erstellt oder diese mit klaren Dateinamenüberschriften kombiniert werden sollen. Die Stapelverarbeitung ist eine Erweiterung dieses Beispiels und nicht etwas, das das Einzeldateiprogramm bereits ausführt.
Das könnte Sie auch interessieren: Ausfüllbare Formulare in PDF mit C# erstellen, ausfüllen oder entfernen
Welche Methode sollten Sie wählen?
| Anforderung | Acrobat | Foxit PDF Editor | C#-Beispiel |
|---|---|---|---|
| Export über eine grafische Oberfläche | Ja | Ja | Erfordert ein Programm |
| Getestetes TXT-Layout | Tabulatorgetrennte Namen und Werte | Ähnlich wie Acrobat | Feld-Wert-Einträge |
| Interne Namen vereinfachen | Zusätzliche Verarbeitung erforderlich | Zusätzliche Verarbeitung erforderlich | Für erkannte Suffixe enthalten |
| Vorlagenspezifische Sprachbezeichnungen hinzufügen | Zusätzliche Verarbeitung erforderlich | Zusätzliche Verarbeitung erforderlich | Über eine Zuordnung enthalten |
| Ausgaberegeln anpassen | Durch den Exportvorgang eingeschränkt | Durch den Exportvorgang eingeschränkt | Im Code gesteuert |
| Innerhalb eines größeren Arbeitsablaufs wiederholen | Abhängig von den verfügbaren Anwendungswerkzeugen | Abhängig von den verfügbaren Anwendungswerkzeugen | Für Stapelläufe und Integration erweiterbar |
Verwenden Sie Acrobat oder Foxit, wenn Sie einen schnellen Export benötigen und mit den resultierenden tabellarischen Daten arbeiten können. Verwenden Sie den C#-Ansatz, wenn die TXT-Datei selbst das Ergebnis ist oder wenn Feldbenennung, Kontrollkästcheninterpretation und wiederholbare Formatierung wichtig sind.
Häufig gestellte Fragen
Warum sieht exportierter TXT-Text in Notepad unübersichtlich aus?
In den getesteten Exporten von Acrobat und Foxit belegen Namen und Werte separate lange Zeilen mit Tabulatortrennzeichen. Der Zeilenumbruch bricht diese Zeilen visuell um, wodurch ihre Zuordnung schwer nachzuvollziehen ist. Das Deaktivieren hilft bei der Prüfung; der Import der Datei mit einem Tabulator-Trennzeichen ergibt eine übersichtlichere Tabelle.
Können diese Methoden Antworten aus einem gescannten Formular extrahieren?
Nicht über seine ursprünglichen Formularfelder, wenn das PDF nur ein gescanntes Bild enthält. Das erfordert OCR und einen separaten Prozess, um erkannte Antworten Beschriftungen zuzuordnen.
Warum gibt ein aktiviertes Kontrollkästchen Yes statt seiner sichtbaren Beschriftung zurück?
Der gespeicherte Exportwert für den Ein-Zustand kann einfach Yes sein, während die Optionsbezeichnung separater Seitentext ist. Eine vorlagenspezifische Zuordnung kann dieses Feld einer aussagekräftigen Beschriftung zuordnen, wie für die Sprachkontrollkästchen gezeigt.
Ändert der C#-Code das ursprüngliche PDF?
Er speichert keine Änderungen am PDF. Er lädt die Datei, liest die Felder und schreibt eine separate TXT-Datei.
Können dieselben Daten als CSV oder JSON geschrieben werden?
Ja. Behalten Sie die Logik zum Lesen der Felder bei und ersetzen Sie den Schritt zum Schreiben der TXT-Datei durch einen geeigneten Serializer. Verwenden Sie für CSV eine korrekte Maskierung von Kommas, Anführungszeichen und Zeilenumbrüchen. Verwenden Sie für JSON einen Serializer, anstatt JSON-Zeichenfolgen manuell zusammenzusetzen.
Siehe auch
Извлечение данных из полей PDF-форм: методы без кода и автоматизированные способы
Содержание
Заполненные PDF-формы часто содержат информацию, которую нужно использовать в другом месте: контактные данные из регистрационных форм, ответы из анкет или адреса из заявлений. Открывать каждый PDF, чтобы посмотреть эти сведения, иногда работает, но экспорт данных упрощает просмотр, организацию и обработку.
Есть два практических подхода. Редактор PDF может экспортировать данные формы через свой интерфейс, а программа на C# может читать отдельные поля и записывать текстовый файл в формате, который вы контролируете. В этом руководстве рассматриваются Adobe Acrobat, Foxit PDF Editor и автоматизированный подход с использованием Spire.PDF for .NET.
Примеры сосредоточены на выводе в TXT и используют одну и ту же заполненную образцовую форму, чтобы результаты можно было сравнить.
Перед началом: поля формы отличаются от текста страницы
Поле формы PDF — это интерактивный объект, который хранит значение. Примеры включают имя, введённое в текстовое поле, страну, выбранную из раскрывающегося списка, и состояние отметки языкового флажка.
Документ, который выглядит как форма, не обязательно содержит эти объекты. Отсканированная форма заявления может быть только изображением, а сплющенный PDF может показывать заполненные ответы как статическое содержимое страницы. Ни то, ни другое не предоставляет исходные интерактивные поля для чтения методами, продемонстрированными здесь.
Эта статья посвящена интерактивным полям AcroForm. Извлечение ответов из сканов требует другого процесса, например OCR с последующим определением соответствующих ответов. Извлечение обычных таблиц PDF также является отдельной задачей.
Образец формы содержит личную информацию, адрес, языковые флажки и выбор цвета. Некоторые внутренние имена включают описания элементов управления, например Given Name Text Box и Country Combo Box. Эти имена будут видны в необработанных экспортах.
Метод 1: экспорт данных полей формы PDF с помощью Adobe Acrobat
Acrobat предоставляет команду экспорта данных формы, которая позволяет сохранять значения заполненной формы без их индивидуального копирования. Используйте настольное приложение с доступом к инструменту «Подготовить форму»; приведённые ниже инструкции не относятся к браузерной программе просмотра PDF.
Экспорт формы в TXT
- Откройте заполненный PDF в Adobe Acrobat.
- Выберите Все инструменты → Подготовить форму.
- На панели формы откройте Дополнительно → Экспорт данных.
- В диалоговом окне «Сохранить как» выберите TXT.
- Выберите имя файла и место сохранения, затем нажмите Сохранить.
Acrobat также перечисляет FDF, XFDF и XML для этого процесса экспорта. Доступные форматы могут зависеть от того, как была создана форма. Расположение меню может отличаться в разных версиях интерфейса.
Разбор экспортированного текста
В протестированном образце Acrobat создал текст с разделением табуляцией: имена полей отображались в одной длинной строке, а их значения — в следующей строке. Упрощённый пример:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Здесь <TAB> обозначает символ табуляции, а не буквальный текст в файле.
При открытии в Notepad с включённым переносом по словам эти длинные строки переносятся по краю окна. Из-за этого сложно отследить соответствие между именами и значениями. Отключение Формат → Перенос по словам сохраняет логические строки целыми, хотя горизонтальная прокрутка всё равно потребуется.
Экспорт содержит полезные данные, но это не текстовый отчёт с вертикальным расположением. Для более наглядного табличного представления импортируйте TXT в приложение для работы с электронными таблицами и выберите разделитель — табуляцию. Если цель — читаемый список Field: Value, потребуется дополнительный этап форматирования.
Acrobat отдельно предлагает Параметры → Объединить файлы данных в электронную таблицу для сбора данных из нескольких форм. Таким образом, извлечение через интерфейс не обязательно ограничивается одним документом за раз.
Метод 2: экспорт данных полей формы PDF с помощью Foxit PDF Editor
Foxit PDF Editor предлагает аналогичный процесс экспорта:
- Откройте заполненную PDF-форму.
- Выберите Форма → Экспорт → В файл.
- Выберите TXT в качестве формата вывода.
- Укажите имя файла и место сохранения, затем нажмите Сохранить.
В руководстве для Windows также перечислены CSV, XML, FDF и XFDF как поддерживаемые форматы экспорта. Команды экспорта форм применяются к интерактивным формам, а не к обычным статическим PDF.
Как результат сравнивается с Acrobat?
Для того же образца PDF вывод Foxit в формате TXT был почти идентичен выводу Acrobat: внутренние имена полей в первой строке, соответствующие значения в следующей строке и табуляция между записями. Отключение переноса по словам упростило просмотр структуры, но не изменило компоновку файла.
Это наблюдение относится к протестированному образцу. Его не следует воспринимать как утверждение, что любая форма, версия или настройка экспорта создаёт идентичные файлы в обоих приложениях.
Foxit — практичная альтернатива, если он уже входит в ваш рабочий процесс. Однако для этого сценария с TXT смена редактора не дала более читаемого отчёта по каждому полю.
Метод 3: извлечение данных полей формы PDF с помощью C#
Чтение полей в коде даёт контроль над итоговым текстом. Вместо сохранения табличной компоновки экспорта следующий пример записывает по одному полю в строке, удаляет распространённые суффиксы элементов управления из имён и явно определяет отмеченные и неотмеченные флажки.
В нём используется Spire.PDF for .NET и его пространство имён Spire.Pdf.Interactive.Forms. Это пространство имён появилось в версии 12.10.7, поэтому используйте эту версию или более новую совместимую. Более старые примеры, основанные на других API форм, могут использовать другие классы.
Установите библиотеку
Создайте консольный проект C# и установите пакет NuGet:
dotnet add package Spire.PDF
Поместите образец PDF по указанному ниже входному пути или измените inputPath на свой файл. Пример записывает GetAllValues.txt в текущий рабочий каталог приложения и по завершении выводит полный путь к нему.
Полный пример на C#
Код следует предоставленной логике извлечения с явным импортом пространств имён, выводом в UTF-8 и поддержкой записи всех выбранных значений в списке с множественным выбором.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
Как работает извлечение
Программа загружает PDF, получает контейнер формы и перебирает доступные поля. Выражение switch выбирает значение для чтения в зависимости от типа поля. Текстовые поля предоставляют текст; элементы выбора — выбранные экспортные значения; флажки — состояние отметки и экспортное значение включённого состояния.
CleanName удаляет распознанные суффиксы в конце имени. Например, Given Name Text Box превращается в Given Name. Это соглашение об именовании, использованное в образце, а не универсальный метод восстановления видимой подписи, напечатанной рядом с любым полем PDF.
Флажки требуют чуть больше интерпретации. Экспортное значение, например Yes, может быть вполне допустимым, но оно не объясняет, означает ли Language 2 английский или другой язык. Словарь предоставляет эту информацию для данного конкретного шаблона. Другая форма требует соответствующего сопоставления, если только её собственные экспортные значения уже не дают осмысленных подписей.
Важно, что OnValue со значением Yes не доказывает, что автор формы не указал пользовательское значение. Код просто рассматривает его как общее значение для сопоставленных языковых полей.
Пример вывода
Для заполненного образца полученный текст можно читать напрямую:
В этом примере сохраняется порядок, возвращаемый form.Fields. Поля не сортируются в порядке чтения страницы. Другие PDF могут возвращать другую последовательность; используйте явную настройку порядка полей, если требуется единообразный порядок в отчёте.
Ограничения и настройки для других форм
Этот пример демонстрирует извлечение из распространённых полей значений AcroForm. Он не реализует извлечение полей XFA или обработку сведений о подписи. Spire.PDF предоставляет отдельные API для доступа к полям XFA, которые требуют другого процесса извлечения.
Элементы выбора могут хранить экспортные значения, отличающиеся от видимых подписей параметров. Если требуется удобочитаемая подпись, проверьте определения параметров и добавьте соответствующее преобразование. Многострочные текстовые поля также могут содержать разрывы строк, поэтому одно поле может занимать в выводе более одной физической строки.
Для нескольких PDF ту же логику извлечения можно вызывать в цикле по файлам. Решите, создавать ли отдельный TXT для каждого документа или объединять их с чёткими заголовками имён файлов. Пакетная обработка — это расширение данного примера, а не то, что уже выполняет программа для одного файла.
Вам также может понравиться: Создание, заполнение и удаление заполняемых форм в PDF на C#
Какой метод выбрать?
| Требование | Acrobat | Foxit PDF Editor | Пример на C# |
|---|---|---|---|
| Экспорт через графический интерфейс | Да | Да | Требуется программа |
| Протестированная компоновка TXT | Имена и значения, разделённые табуляцией | Аналогично Acrobat | Записи «поле — значение» |
| Упрощение внутренних имён | Требуется дополнительная обработка | Требуется дополнительная обработка | Включено для распознанных суффиксов |
| Добавление языковых подписей для конкретного шаблона | Требуется дополнительная обработка | Требуется дополнительная обработка | Включено через сопоставление |
| Настройка правил вывода | Ограничено процессом экспорта | Ограничено процессом экспорта | Управляется в коде |
| Повторение в более крупном рабочем процессе | Зависит от доступных инструментов приложения | Зависит от доступных инструментов приложения | Можно расширить для пакетных запусков и интеграции |
Используйте Acrobat или Foxit, когда нужен быстрый экспорт и можно работать с полученными табличными данными. Используйте подход на C#, когда сам TXT является результатом или когда важны именование полей, интерпретация флажков и воспроизводимое форматирование.
Часто задаваемые вопросы
Почему экспортированный TXT выглядит неупорядоченным в Notepad?
В протестированных экспортах Acrobat и Foxit имена и значения занимают отдельные длинные строки с разделителями-табуляциями. Перенос по словам визуально разрывает эти строки, из-за чего сложно отследить их соответствие. Его отключение помогает просмотру; импорт файла с разделителем-табуляцией даёт более понятную таблицу.
Могут ли эти методы извлекать ответы из отсканированной формы?
Нет, через исходные поля формы, если PDF содержит только отсканированное изображение. Для этого требуется OCR и отдельный процесс сопоставления распознанных ответов с подписями.
Почему отмеченный флажок возвращает Yes вместо видимой подписи?
Сохранённое экспортное значение включённого состояния может быть просто Yes, тогда как подпись параметра — отдельный текст на странице. Сопоставление для конкретного шаблона может связать это поле с осмысленной подписью, как показано для языковых флажков.
Изменяет ли код на C# исходный PDF?
Он не сохраняет изменения в PDF. Он загружает файл, читает поля и записывает отдельный TXT-файл.
Можно ли записать те же данные в CSV или JSON?
Да. Сохраните логику чтения полей и замените этап записи TXT подходящим сериализатором. Для CSV используйте корректное экранирование запятых, кавычек и разрывов строк. Для JSON используйте сериализатор, а не собирайте строки JSON вручную.
См. также
Extract PDF Form Field Data: No-Code & Automated Methods
Table of Contents
Completed PDF forms often contain information that needs to be used elsewhere: contact details from registration forms, responses from questionnaires, or addresses from application forms. Opening each PDF to look up those details works occasionally, but exporting the data makes it easier to review, organize, and process.
There are two practical approaches. A PDF editor can export form data through its interface, while a C# program can read individual fields and write a text file in a format you control. This guide covers Adobe Acrobat, Foxit PDF Editor, and an automated approach using Spire.PDF for .NET.
The examples focus on TXT output and use the same completed sample form to make the results comparable.
Before You Start: Form Fields Are Different from Page Text
A PDF form field is an interactive object that stores a value. Examples include a name entered in a text box, a country selected from a drop-down list, and the checked state of a language checkbox.
A document that looks like a form does not necessarily contain these objects. A scanned application form may be only an image, and a flattened PDF may show completed answers as static page content. Neither provides the original interactive fields for the methods demonstrated here to read.
This article focuses on interactive AcroForm fields. Extracting answers from scans requires a different workflow, such as OCR followed by identifying the relevant answers. Extracting ordinary PDF tables is also a separate task.
The sample form contains personal information, an address, language checkboxes, and a colour selection. Some internal names include control descriptions, such as Given Name Text Box and Country Combo Box. Those names will be visible in the raw exports.
Method 1: Export PDF Form Field Data with Adobe Acrobat
Acrobat provides a form-data export command that can save a completed form's values without copying them individually. Use the desktop application with access to the Prepare a form tool; the instructions below are not for the browser PDF viewer.
Export the form to TXT
- Open the completed PDF in Adobe Acrobat.
- Select All tools → Prepare a form.
- In the form panel, open More → Export data.
- Select TXT in the Save As dialog.
- Choose a filename and destination, then click Save.
Acrobat also lists FDF, XFDF, and XML for this export workflow. Available formats can depend on how the form was created. Menu placement may differ between interface versions.
Understand the exported text
In the tested sample, Acrobat produced tab-separated text: the field names appeared on one long line, and their values appeared on the following line. A simplified illustration is:
Given Name Text Box<TAB>Family Name Text Box<TAB>City Text Box
Lars<TAB>Nielsen<TAB>Copenhagen
Here, <TAB> represents a tab character, rather than literal text in the file.
When opened in Notepad with Word Wrap enabled, these long lines wrap at the window edge. That makes the relationship between names and values difficult to follow. Turning off Format → Word Wrap keeps the logical lines intact, although horizontal scrolling is still necessary.
The export contains useful data, but it is not a vertically arranged text report. For a clearer tabular view, import the TXT into a spreadsheet application and select a tab delimiter. If the goal is a readable Field: Value list, an additional formatting step is needed.
Acrobat separately offers Options → Merge data files into spreadsheet for compiling data from multiple forms. Interface-based extraction therefore does not have to be limited to one document at a time.
Method 2: Export PDF Form Field Data with Foxit PDF Editor
Foxit PDF Editor provides a similar export workflow:
- Open the completed PDF form.
- Select Form → Export → To File.
- Choose TXT as the output format.
- Set the filename and destination, then click Save.
The Windows guide also lists CSV, XML, FDF, and XFDF as supported export formats. The form export commands apply to interactive forms rather than ordinary static PDFs.
How does the result compare with Acrobat?
For the same sample PDF, Foxit's TXT output was almost identical to Acrobat's: internal field names on the first line, corresponding values on the next line, and tabs between entries. Disabling Word Wrap made the structure easier to inspect, but did not change the file's layout.
This observation applies to the tested sample. It should not be taken to mean that every form, version, or export setting produces identical files in both applications.
Foxit is a practical alternative if it is already part of your workflow. For this TXT use case, however, switching editors did not produce a more readable field-by-field report.
Method 3: Extract PDF Form Field Data with C#
Reading the fields in code gives you control over the final text. Instead of keeping the tabular export layout, the following example writes one field per line, removes common control suffixes from names, and explicitly identifies checked and unchecked boxes.
It uses Spire.PDF for .NET and its Spire.Pdf.Interactive.Forms namespace. This namespace was introduced in version 12.10.7, so use that release or a newer compatible version. Older samples based on other form APIs may use different classes.
Install the library
Create a C# console project and install the NuGet package:
dotnet add package Spire.PDF
Place the sample PDF at the input path used below, or change inputPath to your own file. The example writes GetAllValues.txt to the application's current working directory and prints its full path when complete.
Complete C# example
The code follows the supplied extraction logic, with explicit namespace imports, UTF-8 output, and support for writing all selected values in a multi-select list box.
using System;
using System.Collections.Generic;
using System.IO;
using System.Text;
using System.Text.RegularExpressions;
using Spire.Pdf;
using Spire.Pdf.Interactive.Forms;

namespace ExtractFormFieldValues
{
    internal class Program
    {
        static readonly Regex SuffixRegex = new Regex(
            @"\s*(Text\s*Box|Combo\s*Box|Check\s*Box|Formatted\s*Field|List\s*Box)\s*$",
            RegexOptions.IgnoreCase);

        // Labels for the language checkboxes in this specific sample form.
        static readonly Dictionary<string, string> LanguageMap = new()
        {
            ["Language 1"] = "Deutsch",
            ["Language 2"] = "English",
            ["Language 3"] = "Français",
            ["Language 4"] = "Esperanto",
            ["Language 5"] = "Latin",
        };

        static string CleanName(string name)
        {
            if (string.IsNullOrWhiteSpace(name)) return "";
            return SuffixRegex.Replace(name, "").Trim();
        }

        static string GetCheckBoxValue(PdfCheckBoxField chk, string cleanName)
        {
            if (!chk.IsChecked) return "Unchecked";

            // For this template, replace a generic "Yes" export value
            // with the known language label when a mapping exists.
            if (chk.OnValue == "Yes" &&
                LanguageMap.TryGetValue(cleanName, out var language))
            {
                return $"{language} (Checked)";
            }

            return $"{chk.OnValue} (Checked)";
        }

        static void Main(string[] args)
        {
            string inputPath = "FormExample.pdf";
            string outputPath = Path.GetFullPath("GetAllValues.txt");

            using var doc = new PdfDocument();
            doc.LoadFromFile(inputPath);

            var form = PdfForm.Create(doc);
            if (form == null || form.Fields.Count == 0)
            {
                Console.WriteLine("No form fields were detected.");
                return;
            }

            var sb = new StringBuilder();

            foreach (PdfField field in form.Fields)
            {
                string name = CleanName(field.Name);
                string value = field switch
                {
                    PdfTextField tb => tb.Text,
                    PdfComboBoxField cb => cb.SelectedValue,
                    PdfListBoxField lb => string.Join(", ", lb.SelectedValues),
                    PdfRadioButtonField rb => rb.SelectedValue,
                    PdfCheckBoxField chk => GetCheckBoxValue(chk, name),
                    _ => ""
                };

                sb.AppendLine($"{name}: {value}");
            }

            File.WriteAllText(outputPath, sb.ToString(), new UTF8Encoding(false));
            Console.WriteLine($"Extraction complete: {outputPath}");
        }
    }
}
How the extraction works
The program loads the PDF, obtains its form container, and iterates through the available fields. The switch expression chooses the value to read based on the field's type. Text boxes supply text; choice controls supply their selected export values; checkboxes supply a checked state and an on-state export value.
CleanName removes recognized suffixes at the end of a name. For example, Given Name Text Box becomes Given Name. This is a naming convention used in the sample, not a general method for recovering the visible label printed next to any PDF field.
Checkboxes need a little more interpretation. An export value such as Yes may be perfectly valid, but it does not explain whether Language 2 means English or another language. The dictionary supplies that knowledge for this particular template. A different form requires a corresponding mapping, unless its own export values already provide meaningful labels.
Importantly, an OnValue of Yes does not prove that the form author omitted a custom value. The code simply treats it as a generic value for the mapped language fields.
Example output
For the completed sample, the resulting text can be read directly:
This example keeps the order returned by form.Fields. It does not sort fields into page reading order. Other PDFs may return a different sequence; use an explicit field-order configuration if a consistent report order is required.
Limits and adjustments for other forms
This example demonstrates extraction from common AcroForm value fields. It does not implement XFAfield extraction or signature-detail processing. Spire.PDF provides separate APIs for accessing XFA fields, which require a different extraction workflow.
Choice controls may store export values that differ from their visible option labels. If a human-readable label is required, inspect the option definitions and add the appropriate conversion. Multiline text fields can also contain line breaks, so a single field may occupy more than one physical line in the output.
For multiple PDFs, the same extraction logic can be called from a file loop. Decide whether to create a separate TXT for each document or combine them with clear filename headings. Batch processing is an extension of this example, rather than something the single-file program already performs.
You May Also Like: Create, Fill, or Remove Fillable Forms in PDF in C#
Which Method Should You Choose?
| Requirement | Acrobat | Foxit PDF Editor | C# example |
|---|---|---|---|
| Export through a graphical interface | Yes | Yes | Requires a program |
| Tested TXT layout | Tab-separated names and values | Similar to Acrobat | Field-and-value entries |
| Simplify internal names | Additional processing needed | Additional processing needed | Included for recognized suffixes |
| Add template-specific language labels | Additional processing needed | Additional processing needed | Included through a mapping |
| Customize output rules | Limited by export workflow | Limited by export workflow | Controlled in code |
| Repeat within a larger workflow | Depends on available application tools | Depends on available application tools | Can be extended for batch runs and integration |
Use Acrobat or Foxit when you need a quick export and can work with the resulting tabular data. Use the C# approach when the TXT itself is the deliverable, or when field naming, checkbox interpretation, and repeatable formatting matter.
Frequently Asked Questions
Why does exported TXT look disorganized in Notepad?
In the tested Acrobat and Foxit exports, names and values occupy separate long lines with tab delimiters. Word Wrap breaks those lines visually, making their correspondence hard to follow. Turning it off helps inspection; importing the file with a tab delimiter gives a clearer table.
Can these methods extract answers from a scanned form?
Not through its original form fields if the PDF contains only a scanned image. That requires OCR and a separate process for associating recognized answers with labels.
Why does a checked box return Yes instead of its visible label?
The stored on-state export value may simply be Yes, while the option label is separate page text. A template-specific mapping can associate that field with a meaningful label, as demonstrated for the language checkboxes.
Does the C# code change the original PDF?
It does not save changes to the PDF. It loads the file, reads the fields, and writes a separate TXT file.
Can the same data be written to CSV or JSON?
Yes. Keep the field-reading logic and replace the TXT-writing step with a suitable serializer. For CSV, use proper escaping for commas, quotes, and line breaks. For JSON, use a serializer rather than assembling JSON strings manually.
See Also
Como inverter a ordem das páginas de um documento PDF: 4 métodos fáceis
Índice
Um PDF digitalizado às vezes começa com a última página e termina com a primeira. Isso pode acontecer quando uma pilha de papel é alimentada em um scanner na ordem errada. Em vez de digitalizar tudo novamente, você pode inverter as páginas no PDF existente.
Inverter a ordem das páginas altera a sequência no documento salvo. Por exemplo, um PDF de quatro páginas muda de 1, 2, 3, 4 para 4, 3, 2, 1 , enquanto o conteúdo de cada página permanece no lugar.
Este guia explica quatro maneiras de inverter a ordem das páginas de PDF: manualmente no Adobe Acrobat, manualmente no Preview no Mac, online com o PDF24 e automaticamente usando Python.
Nesta página:
- Inverter a ordem das páginas de PDF usando o Adobe Acrobat
- Inverter a ordem das páginas de PDF no Mac usando o Preview
- Inverter a ordem das páginas de PDF online com o PDF24
- Inverter a ordem das páginas de PDF usando Python
- Qual método você deve escolher?
- Perguntas frequentes
- Conclusão
1. Inverter a ordem das páginas de PDF usando o Adobe Acrobat
Se você já usa o Adobe Acrobat para editar PDFs, pode reorganizar as páginas por meio da ferramenta Organizar páginas. Ela exibe o documento como miniaturas de páginas que você pode arrastar para uma nova sequência. Para PDFs curtos, oferece uma maneira simples de inverter a ordem visualmente.
O fluxo de trabalho abaixo usa a reorganização manual. Você precisará ter acesso aos recursos de organização de páginas do Acrobat; o Acrobat Reader gratuito para desktop não é suficiente para este método.
Etapas
- Abra seu PDF no Adobe Acrobat.
- Abra Todas as ferramentas e selecione Organizar páginas. Em interfaces mais antigas, procure em Ferramentas > Organizar páginas.
- Ajuste o tamanho das miniaturas para identificar cada página.
- Arraste a última página para antes da primeira página.
- Mova a penúltima página original imediatamente para depois dela.
- Continue até que a primeira página original fique no final.
- Salve o resultado com um novo nome de arquivo para manter o original disponível.
Para um documento de quatro páginas, mova a página original 4 para o início, coloque a página original 3 depois dela e faça o mesmo com as páginas 2 e 1. A sequência final deve ser 4, 3, 2, 1 .
Ao verificar o resultado, observe o conteúdo de cada página. Os números de posição das miniaturas podem ser atualizados conforme as páginas se movem, portanto, eles não identificam necessariamente a posição original da página.
A reorganização manual funciona bem para um documento curto, mas mover dezenas de páginas individualmente pode se tornar demorado. Para arquivos mais longos, considere um método automático abaixo.
2. Inverter a ordem das páginas de PDF no Mac usando o Preview
Usuários de Mac podem reorganizar páginas de PDF no Preview , o visualizador incluído no macOS. Sua barra lateral de miniaturas permite mover páginas dentro de um documento sem instalar um editor de PDF separado.
Assim como no fluxo de trabalho do Acrobat acima, este método inverte o documento por meio de movimentos manuais das páginas.
Etapas
- Faça uma cópia do PDF no Finder e abra a cópia no Preview. Trabalhar em uma cópia protege o original do salvamento automático.
- Escolha Visualizar > Miniaturas para exibir as páginas na barra lateral.
- Arraste a miniatura da última página para acima da primeira página.
- Arraste a penúltima página original diretamente para abaixo da página que você acabou de mover.
- Continue até que todas as páginas estejam em ordem inversa.
- Escolha Arquivo > Salvar , depois reabra o arquivo para confirmar a sequência.
Para o mesmo exemplo de quatro páginas, a barra lateral deve mostrar as páginas originais na ordem 4, 3, 2, 1 .
O Preview é uma opção conveniente para edições ocasionais em um Mac. No entanto, como este fluxo de trabalho envolve mover páginas individualmente, ele é mais adequado para documentos com relativamente poucas páginas.
3. Inverter a ordem das páginas de PDF online com o PDF24
Se você deseja inverter um documento inteiro sem arrastar cada página, uma ferramenta online pode simplificar o processo. A ferramenta de reorganização de páginas do PDF24 permite inverter todas as páginas de trás para frente por meio de um navegador web.
Etapas
- Abra a ferramenta PDF24 Rearrange PDF Pages.
- Selecione seu PDF ou arraste-o para a área de upload.
- Aguarde o upload do documento e o aparecimento das miniaturas das páginas.
- Abra a lista suspensa Selecionar método de classificação e escolha De trás para frente .
- Verifique as miniaturas para confirmar que a última página original agora aparece primeiro.
- Aplique as alterações e baixe o PDF resultante.
- Abra o arquivo baixado para verificar a ordem das páginas.
Diferentemente dos dois métodos manuais acima, esta abordagem inverte toda a sequência em uma única operação.
Este fluxo de trabalho exige o upload do documento para um serviço online. Se o arquivo precisar permanecer no seu computador, use um método para desktop ou o fluxo de trabalho local com Python descrito a seguir.
4. Inverter a ordem das páginas de PDF usando Python
Para tarefas repetidas, um script Python elimina a necessidade de mover miniaturas ou fazer upload de documentos manualmente. Ele pode ler a contagem de páginas, gerar uma lista invertida de índices de páginas e aplicar a nova sequência automaticamente.
O exemplo a seguir usa o Spire.PDF for Python, uma biblioteca de processamento de PDF que permite reorganizar páginas por meio de seu método ReArrange(). O script processa um PDF, e a mesma lógica pode posteriormente ser incorporada a um fluxo de trabalho de processamento de pastas.
Instalar o Spire.PDF for Python
Instale o pacote no seu ambiente Python:
pip install Spire.PDF
Entender os índices de páginas invertidos
A coleção de páginas usa índices baseados em zero. Isso significa que a primeira página tem índice 0, a segunda tem índice 1, e assim por diante.
Para um PDF de cinco páginas, os índices originais são:
[0, 1, 2, 3, 4]
Para inverter o documento, a sequência necessária é:
[4, 3, 2, 1, 0]
O script gera esta lista dinamicamente usando:
reverse_order = list(range(page_count - 1, -1, -1))
Os três argumentos passados para range() determinam a sequência:
| Argumento | Finalidade |
|---|---|
page_count - 1 |
Começa no índice da última página. |
-1 |
Define o ponto de parada exclusivo, permitindo que o índice0seja incluído. |
-1 |
Avança para trás um índice por vez. |
Como a lista é baseada na contagem de páginas do documento, você não precisa alterá-la para PDFs com diferentes quantidades de páginas.
Reorganizar as páginas e salvar o PDF
Coloque Input.pdf no diretório de trabalho do script ou substitua os nomes de arquivo por caminhos completos. Em seguida, execute o código a seguir:
from spire.pdf import *

# Load the source PDF
pdf = PdfDocument()
pdf.LoadFromFile("Input.pdf")

# Build the page indices in reverse order
page_count = pdf.Pages.Count
reverse_order = list(range(page_count - 1, -1, -1))

# Apply the reversed page sequence
pdf.Pages.ReArrange(reverse_order)

# Save the result as a separate PDF
pdf.SaveToFile("Reversed.pdf", FileFormat.PDF)
pdf.Close()
O script executa quatro operações principais:
- Carregar o documento:
LoadFromFile()abre o PDF de origem. - Gerar a sequência invertida:
Pages.Countfornece a contagem de páginas, erange()cria os índices da última para a primeira. - Aplicar a nova ordem:
ReArrange(reverse_order)reorganiza as páginas. - Salvar e fechar:
SaveToFile()grava a saída, eClose()libera os recursos do documento.
O arquivo original permanece disponível porque a saída usa um nome de arquivo diferente. Abra Reversed.pdf e compare sua primeira e última páginas com as do documento de origem.
Qual método você deve escolher?
A principal escolha é se você deseja mover páginas manualmente ou inverter o documento inteiro automaticamente.
| Método | Como inverte as páginas | Manipulação do arquivo | Mais indicado |
|---|---|---|---|
| Adobe Acrobat | Reorganização manual das miniaturas | Fluxo de trabalho local no desktop | PDFs curtos quando você já usa o Acrobat |
| Preview no Mac | Reorganização manual das miniaturas | Fluxo de trabalho local no desktop | Edições ocasionais em um Mac |
| PDF24 online | Inversão automática por meio de um controle de ordem das páginas | Upload e download | Tarefas pontuais sem instalar software |
| Python com Spire.PDF | Inversão automática por meio de código | Processamento local após a configuração | Tarefas repetidas e integração em scripts |
Para um documento curto, mover miniaturas pode ser suficiente. Para um documento longo, o PDF24 ou o Python evita o trabalho repetitivo de mover cada página individualmente.
Escolha Python quando a operação precisar fazer parte de um processo repetível, como lidar com documentos digitalizados recebidos ou processar vários arquivos.
Perguntas frequentes
Inverter a ordem das páginas de PDF é o mesmo que imprimir em ordem inversa?
Não. Inverter a ordem das páginas do PDF altera a sequência no documento salvo.
A configuração de ordem inversa da impressora altera a ordem em que as páginas são impressas, enquanto o PDF de origem mantém sua sequência existente. Se a ordem invertida precisar aparecer quando alguém abrir o arquivo, reorganize as páginas e salve o PDF.
Inverter as páginas mudará os números de página impressos nelas?
Não. Os números de página que fazem parte do conteúdo da página se movem com suas páginas. Uma página que exibe “5” continuará exibindo “5” depois de se tornar a primeira página do documento.
Se você precisar de novos números de página sequenciais, trate isso como uma etapa de edição separada. Lembre-se também de que a posição da página no visualizador pode ser diferente do número impresso na página.
Posso inverter a ordem das páginas de um PDF digitalizado?
Sim. A reordenação opera nas páginas do PDF, portanto, não exige texto selecionável. Você pode inverter um PDF digitalizado sem executar o OCR primeiro.
No entanto, inverter todas as páginas corrige apenas uma sequência totalmente invertida. Se as frentes e os versos das folhas digitalizadas estiverem intercalados incorretamente, você precisará de uma organização de páginas diferente.
Como posso inverter vários arquivos PDF usando Python?
Coloque as operações de carregar, inverter, salvar e fechar dentro de um loop sobre os arquivos de entrada. Crie um novo PdfDocument para cada arquivo e salve cada resultado em uma pasta de saída separada.
A operação central permanece a mesma: obter a contagem de páginas do documento, gerar sua lista de índices invertida e passar essa lista para ReArrange().
Conclusão
Inverter um PDF é simples depois que você escolhe um método adequado ao documento. O Acrobat e o Preview oferecem controle visual para arquivos curtos, enquanto o PDF24 oferece uma opção online automática. O Python é a escolha mais útil quando a inversão de páginas precisa ser executada repetidamente ou se encaixar em um fluxo de trabalho de processamento de documentos existente.
Qualquer que seja o método usado, salve um arquivo de saída separado e verifique sua primeira página, última página e contagem total de páginas antes de compartilhá-lo.
Veja também
PDF 문서 페이지 순서를 반대로 바꾸는 방법: 쉬운 4가지 방법
스캔한 PDF가 마지막 페이지로 시작해서 첫 페이지로 끝나는 경우가 있습니다. 이는 용지 더미가 잘못된 순서로 스캐너에 공급될 때 발생할 수 있습니다. 모든 것을 다시 스캔하는 대신 기존 PDF에서 페이지 순서를 뒤집을 수 있습니다.
페이지 순서를 뒤집으면 저장된 문서의 순서가 변경됩니다. 예를 들어 4페이지 PDF는 1, 2, 3, 4에서 4, 3, 2, 1 로 바뀌지만 각 페이지의 내용은 그대로 유지됩니다.
이 가이드에서는 PDF 페이지 순서를 뒤집는 네 가지 방법을 설명합니다. Adobe Acrobat에서 수동으로, Mac의 Preview에서 수동으로, PDF24를 사용해 온라인에서, 그리고 Python을 사용해 자동으로 수행하는 방법입니다.
이 페이지의 내용:
- Adobe Acrobat으로 PDF 페이지 순서 뒤집기
- Mac의 Preview로 PDF 페이지 순서 뒤집기
- PDF24로 온라인에서 PDF 페이지 순서 뒤집기
- Python으로 PDF 페이지 순서 뒤집기
- 어떤 방법을 선택해야 할까요?
- 자주 묻는 질문
- 결론
1. Adobe Acrobat으로 PDF 페이지 순서 뒤집기
PDF 편집에 Adobe Acrobat을 이미 사용하고 있다면 페이지 구성 도구를 통해 페이지를 재배열할 수 있습니다. 이 도구는 문서를 페이지 썸네일로 표시하며, 썸네일을 새 순서로 드래그할 수 있습니다. 짧은 PDF의 경우 시각적으로 순서를 뒤집는 간단한 방법을 제공합니다.
아래 워크플로는 수동 재배열을 사용합니다. Acrobat의 페이지 구성 기능에 액세스할 수 있어야 하며, 무료 데스크톱 Acrobat Reader로는 이 방법을 사용할 수 없습니다.
단계
- Adobe Acrobat에서 PDF를 엽니다.
- 모든 도구를 열고 페이지 구성을 선택합니다. 이전 인터페이스에서는 도구 > 페이지 구성에서 찾을 수 있습니다.
- 각 페이지를 식별할 수 있도록 썸네일 크기를 조정합니다.
- 마지막 페이지를 첫 페이지 앞으로 드래그합니다.
- 원래의 마지막에서 두 번째 페이지를 바로 그 뒤로 이동합니다.
- 원래의 첫 페이지가 맨 끝에 올 때까지 계속합니다.
- 원본을 사용할 수 있도록 결과를 새 파일 이름으로 저장합니다.
4페이지 문서의 경우 원래 4페이지를 맨 앞으로 이동하고 그 뒤에 원래 3페이지를 배치한 다음, 2페이지와 1페이지에도 같은 작업을 수행합니다. 최종 순서는 4, 3, 2, 1 이어야 합니다.
결과를 확인할 때 각 페이지의 내용을 살펴보세요. 페이지가 이동하면서 썸네일 위치 번호가 업데이트될 수 있으므로, 해당 번호가 페이지의 원래 위치를 반드시 나타내지는 않습니다.
수동 재배열은 짧은 문서에는 잘 작동하지만, 수십 페이지를 하나씩 이동하는 것은 시간이 많이 걸릴 수 있습니다. 더 긴 파일의 경우 아래의 자동 방법을 고려하세요.
2. Mac의 Preview로 PDF 페이지 순서 뒤집기
Mac 사용자는 macOS에 포함된 뷰어인 Preview 에서 PDF 페이지를 재배열할 수 있습니다. 썸네일 사이드바를 사용하면 별도의 PDF 편집기를 설치하지 않고도 문서 내에서 페이지를 이동할 수 있습니다.
위의 Acrobat 워크플로와 마찬가지로, 이 방법은 수동 페이지 이동을 통해 문서 순서를 뒤집습니다.
단계
- Finder에서 PDF의 복사본을 만들고 Preview에서 복사본을 엽니다. 복사본에서 작업하면 원본이 자동 저장으로부터 보호됩니다.
- 보기 > 썸네일을 선택하여 사이드바에 페이지를 표시합니다.
- 마지막 페이지 썸네일을 첫 페이지 위로 드래그합니다.
- 원래의 마지막에서 두 번째 페이지를 방금 이동한 페이지 바로 아래로 드래그합니다.
- 모든 페이지가 역순이 될 때까지 계속합니다.
- 파일 > 저장을 선택한 다음 파일을 다시 열어 순서를 확인합니다.
같은 4페이지 예시에서 사이드바에는 원래 페이지가 4, 3, 2, 1 순서로 표시되어야 합니다.
Preview는 Mac에서 가끔 편집할 때 편리한 옵션입니다. 그러나 이 워크플로는 페이지를 하나씩 이동해야 하므로 페이지 수가 비교적 적은 문서에 가장 적합합니다.
3. PDF24로 온라인에서 PDF 페이지 순서 뒤집기
모든 페이지를 하나씩 드래그하지 않고 전체 문서의 순서를 뒤집고 싶다면 온라인 도구가 과정을 간소화할 수 있습니다. PDF24의 페이지 재배열 도구는 웹 브라우저를 통해 모든 페이지를 뒤에서 앞으로 뒤집는 기능을 지원합니다.
단계
- PDF24 PDF 페이지 재배열 도구를 엽니다.
- PDF를 선택하거나 업로드 영역으로 드래그합니다.
- 문서가 업로드되고 페이지 썸네일이 나타날 때까지 기다립니다.
- 정렬 방법 선택 드롭다운을 열고 뒤에서 앞으로 를 선택합니다.
- 썸네일을 확인하여 원래의 마지막 페이지가 이제 첫 번째로 표시되는지 검사합니다.
- 변경 사항을 적용하고 결과 PDF를 다운로드합니다.
- 다운로드한 파일을 열어 페이지 순서를 확인합니다.
위의 두 수동 방법과 달리, 이 접근 방식은 한 번의 작업으로 전체 순서를 뒤집습니다.
이 워크플로를 사용하려면 문서를 온라인 서비스에 업로드해야 합니다. 파일을 컴퓨터에 보관해야 하는 경우 데스크톱 방법이나 다음에 설명하는 로컬 Python 워크플로를 사용하세요.
4. Python으로 PDF 페이지 순서 뒤집기
반복 작업의 경우 Python 스크립트를 사용하면 썸네일을 수동으로 이동하거나 문서를 업로드할 필요가 없습니다. 페이지 수를 읽고, 반전된 페이지 인덱스 목록을 생성하고, 새 순서를 자동으로 적용할 수 있습니다.
다음 예제에서는 ReArrange() 메서드를 통해 페이지 재배열을 지원하는 PDF 처리 라이브러리인 Spire.PDF for Python을 사용합니다. 이 스크립트는 PDF 하나를 처리하며, 동일한 로직을 나중에 폴더 처리 워크플로에 통합할 수 있습니다.
Spire.PDF for Python 설치
Python 환경에 패키지를 설치합니다:
pip install Spire.PDF
반전된 페이지 인덱스 이해
페이지 컬렉션은 0부터 시작하는 인덱스를 사용합니다. 즉, 첫 페이지의 인덱스는 0, 두 번째 페이지의 인덱스는 1입니다.
5페이지 PDF의 경우 원래 인덱스는 다음과 같습니다:
[0, 1, 2, 3, 4]
문서 순서를 뒤집으려면 필요한 순서는 다음과 같습니다:
[4, 3, 2, 1, 0]
스크립트는 다음을 사용하여 이 목록을 동적으로 생성합니다:
reverse_order = list(range(page_count - 1, -1, -1))
range()에 전달되는 세 가지 인수는 순서를 결정합니다:
| 인수 | 목적 |
|---|---|
page_count - 1 |
마지막 페이지 인덱스에서 시작합니다. |
-1 |
제외되는 중지 지점을 설정하여 인덱스0이 포함될 수 있도록 합니다. |
-1 |
한 번에 하나의 인덱스씩 뒤로 이동합니다. |
목록은 문서의 페이지 수를 기반으로 하므로 PDF 길이가 달라도 변경할 필요가 없습니다.
페이지 재배열 및 PDF 저장
Input.pdf를 스크립트의 작업 디렉터리에 두거나 파일 이름을 전체 경로로 바꿉니다. 그런 다음 다음 코드를 실행합니다:
from spire.pdf import *

# Load the source PDF
pdf = PdfDocument()
pdf.LoadFromFile("Input.pdf")

# Build the page indices in reverse order
page_count = pdf.Pages.Count
reverse_order = list(range(page_count - 1, -1, -1))

# Apply the reversed page sequence
pdf.Pages.ReArrange(reverse_order)

# Save the result as a separate PDF
pdf.SaveToFile("Reversed.pdf", FileFormat.PDF)
pdf.Close()
스크립트는 네 가지 주요 작업을 수행합니다:
- 문서 로드:
LoadFromFile()이 원본 PDF를 엽니다. - 반전된 순서 생성:
Pages.Count가 페이지 수를 제공하고,range()가 마지막에서 첫 번째까지 인덱스를 생성합니다. - 새 순서 적용:
ReArrange(reverse_order)가 페이지를 재배열합니다. - 저장 및 닫기:
SaveToFile()이 출력을 쓰고,Close()가 문서의 리소스를 해제합니다.
출력에 다른 파일 이름을 사용하므로 원본 파일은 그대로 유지됩니다. Reversed.pdf를 열고 첫 페이지와 마지막 페이지를 원본 문서와 비교하세요.
어떤 방법을 선택해야 할까요?
주요 선택은 페이지를 수동으로 이동할지, 아니면 전체 문서 순서를 자동으로 뒤집을지입니다.
| 방법 | 페이지를 뒤집는 방식 | 파일 처리 | 적합한 경우 |
|---|---|---|---|
| Adobe Acrobat | 수동 썸네일 재배열 | 로컬 데스크톱 워크플로 | Acrobat을 이미 사용하는 경우의 짧은 PDF |
| Mac의 Preview | 수동 썸네일 재배열 | 로컬 데스크톱 워크플로 | Mac에서 가끔 하는 편집 |
| PDF24 온라인 | 페이지 순서 제어를 통한 자동 반전 | 업로드 및 다운로드 | 소프트웨어 설치 없이 일회성 작업 |
| Spire.PDF를 사용하는 Python | 코드를 통한 자동 반전 | 설정 후 로컬 처리 | 반복 작업 및 스크립트 통합 |
짧은 문서의 경우 썸네일을 이동하는 것으로 충분할 수 있습니다. 긴 문서의 경우 PDF24 또는 Python을 사용하면 모든 페이지를 하나씩 이동하는 반복 작업을 피할 수 있습니다.
들어오는 스캔 문서를 처리하거나 여러 파일을 처리하는 것처럼 작업이 반복 가능한 프로세스의 일부가 되어야 하는 경우 Python을 선택하세요.
자주 묻는 질문
PDF 페이지 순서를 뒤집는 것은 역순 인쇄와 같은 것인가요?
아니요. PDF의 페이지 순서를 뒤집으면 저장된 문서의 순서가 변경됩니다.
프린터의 역순 설정은 페이지가 인쇄되는 순서를 변경하지만, 원본 PDF는 기존 순서를 유지합니다. 누군가 파일을 열 때 뒤집힌 순서가 나타나야 한다면 페이지를 재배열하고 PDF를 저장하세요.
페이지 순서를 뒤집으면 페이지에 인쇄된 페이지 번호가 바뀌나요?
아니요. 페이지 내용의 일부인 페이지 번호는 해당 페이지와 함께 이동합니다. “5”가 표시된 페이지는 문서의 첫 페이지가 된 후에도 여전히 “5”를 표시합니다.
새로운 연속 페이지 번호가 필요하다면 이를 별도의 편집 단계로 처리하세요. 또한 뷰어의 페이지 위치가 페이지에 인쇄된 번호와 다를 수 있다는 점을 기억하세요.
스캔한 PDF의 페이지 순서를 뒤집을 수 있나요?
예. 페이지 재정렬은 PDF 페이지에서 작동하므로 선택 가능한 텍스트가 필요하지 않습니다. OCR을 먼저 실행하지 않고도 스캔한 PDF의 순서를 뒤집을 수 있습니다.
그러나 모든 페이지를 뒤집는 것은 완전히 거꾸로 된 순서만 바로잡습니다. 스캔한 용지의 앞면과 뒷면이 잘못 교차된 경우에는 다른 페이지 배열이 필요합니다.
Python을 사용하여 여러 PDF 파일의 페이지 순서를 뒤집으려면 어떻게 해야 하나요?
로드, 뒤집기, 저장 및 닫기 작업을 입력 파일에 대한 루프 안에 배치합니다. 각 파일에 대해 새 PdfDocument를 만들고 각 결과를 별도의 출력 폴더에 저장합니다.
핵심 작업은 동일합니다. 문서의 페이지 수를 가져오고, 반전된 인덱스 목록을 생성하고, 해당 목록을 ReArrange()에 전달합니다.
결론
문서에 적합한 방법을 선택하면 PDF 페이지 순서를 뒤집는 것은 간단합니다. Acrobat과 Preview는 짧은 파일에 시각적 제어를 제공하며, PDF24는 자동 온라인 옵션을 제공합니다. 페이지 반전을 반복적으로 실행해야 하거나 기존 문서 처리 워크플로에 맞춰야 하는 경우 Python이 가장 유용한 선택입니다.
어떤 방법을 사용하든 별도의 출력 파일로 저장하고 공유하기 전에 첫 페이지, 마지막 페이지 및 전체 페이지 수를 확인하세요.