Documentos usados em atendimento ao cliente, finanças, recursos humanos e fluxos de trabalho jurídicos frequentemente contêm nomes, endereços de e-mail, números de telefone, endereços residenciais, números de contas e outras informações sensíveis. Antes que esses arquivos possam ser compartilhados, arquivados ou usados para análise, o conteúdo identificador pode precisar ser removido ou substituído.
Programas tradicionais de redação dependem de regras de pesquisa predefinidas e lógica de processamento separada para cada formato de documento. Um SDK de Agente de IA oferece outra abordagem: os desenvolvedores podem descrever o requisito de redação em linguagem natural, permitindo que o agente identifique informações sensíveis e modifique os elementos correspondentes do documento do Office. Este artigo demonstra como redigir arquivos do Word, Excel e PowerPoint em C# preservando sua estrutura e formatação originais.
O que é Redação de Documentos?
A redação de documentos é o processo de remover ou substituir informações que não devem ser divulgadas. Alvos comuns de redação incluem:
- Nomes pessoais
- Endereços de e-mail
- Números de telefone e fax
- Endereços residenciais ou de correspondência
- Datas de nascimento
- Identificadores de clientes e funcionários
- Números bancários e de contas
- Outras informações confidenciais ou de identificação pessoal
Para arquivos editáveis do Office, a redação envolve mais do que alterar texto simples. Conteúdo sensível pode aparecer em parágrafos e tabelas do Word, células do Excel, formas do PowerPoint, cabeçalhos, rodapés ou outros elementos do documento. Um fluxo de trabalho de redação útil deve remover o valor detectado sem alterar desnecessariamente o layout, os estilos, as imagens, os gráficos ou a estrutura do documento ao redor.
Três Maneiras de Redigir Documentos do Office em C#
Existem três abordagens gerais de implementação: APIs tradicionais de documentos, uma integração direta com LLM e um SDK de Agente de IA.
Redação Tradicional Baseada em API
Uma implementação tradicional normalmente começa com substituição exata de texto ou expressões regulares. Por exemplo, o Spire.Doc for .NET fornece APIs para localizar e substituir texto em documentos do Word.
O pseudocódigo simplificado a seguir ilustra um fluxo de trabalho de redação baseado em regras. Ele é intencionalmente incompleto e mostra apenas as principais responsabilidades que a aplicação precisaria tratar.
Document document = new Document();
document.LoadFromFile("Input.docx");

// Patterns must be defined and maintained by the developer.
Regex emailPattern = new Regex("...");
Regex phonePattern = new Regex("...");
Regex accountPattern = new Regex("...");

document.Replace(emailPattern, "[REDACTED]");
document.Replace(phonePattern, "[REDACTED]");
document.Replace(accountPattern, "[REDACTED]");

// Additional logic may still be required for different content containers.
foreach (Section section in document.Sections)
{
    ProcessParagraphs(section);
    ProcessTables(section.Tables);
    ProcessHeadersAndFooters(section.HeadersFooters);
    ProcessTextBoxes(section);
}

document.SaveToFile("Redacted.docx", FileFormat.Docx);
Esta abordagem funciona bem quando os valores sensíveis seguem padrões previsíveis. Endereços de e-mail, números de telefone e números de identificação padronizados geralmente podem ser encontrados com expressões regulares.
A dificuldade aumenta quando a informação depende do contexto. Um programa pode precisar determinar se uma palavra é o nome de uma pessoa, se um número é um número de conta ou um número de fatura, e se um local é um endereço privado ou um endereço público de empresa. Os desenvolvedores também devem adicionar lógica diferente de travessia e substituição para Word, Excel e PowerPoint.
Integração Direta com LLM
Um modelo de linguagem de grande porte pode compreender o contexto de forma mais eficaz do que uma coleção de expressões regulares. Por exemplo, ele pode reconhecer o nome de uma pessoa em uma frase mesmo quando o nome não segue um padrão previsível.
No entanto, um LLM não fornece automaticamente o processamento completo de documentos do Office. Uma integração direta geralmente exige que a aplicação:
- Extraia texto de cada elemento relevante do documento.
- Divida o conteúdo em solicitações adequadas.
- Envie o texto extraído para o modelo.
- Mapeie os resultados do modelo de volta para os parágrafos, células ou formas originais.
- Substitua o conteúdo sensível sem perder sua formatação.
- Salve o arquivo modificado em seu formato original.
Se o documento for convertido em texto simples antes de ser enviado ao modelo, informações sobre tabelas, intervalos de texto, fontes, alinhamento e outras propriedades de layout podem ser perdidas. O desenvolvedor, portanto, permanece responsável por conectar os resultados semânticos do modelo ao modelo de objetos do documento do Office.
SDK de Agente de IA
Um SDK de Agente de IA combina compreensão de linguagem natural com recursos de processamento de documentos. Em vez de definir cada regra de detecção e coordenar manualmente cada etapa de substituição, o desenvolvedor fornece o documento e descreve o resultado pretendido.
O Spire.Agent.Office usa os recursos subjacentes do Spire.Office for .NET para trabalhar com objetos do Word, Excel e PowerPoint. Em um documento do Word, por exemplo, a camada de processamento pode acessar seções, parágrafos, intervalos de texto, tabelas, células, cabeçalhos, rodapés, imagens, hiperlinks e sua formatação. O modelo identifica o conteúdo sensível, enquanto as APIs de documento modificam os elementos correspondentes.
Esse processamento em nível de objeto é o que torna possível substituir texto mantendo a estrutura e os estilos ao redor do documento.
API Tradicional vs. LLM vs. SDK de Agente de IA
| Abordagem | Detecção contextual | Preservação de formato | Implementação multiformato | Esforço de desenvolvimento | Mais adequado para |
|---|---|---|---|---|---|
| API tradicional e expressões regulares | Limitada, a menos que lógica adicional de NLP seja adicionada | Forte e controlável | Normalmente é necessária lógica separada | Alto | Padrões fixos e regras altamente determinísticas |
| API do Office com chamadas diretas a LLM | Forte | Deve ser implementada pelo desenvolvedor | É necessária lógica de extração e gravação de volta para cada formato | Muito alto | Pipelines de IA totalmente personalizados |
| SDK de Agente de IA | Forte | Tratada por meio de processamento ciente do documento | Uma instrução comum pode ser aplicada a vários formatos do Office | Menor | Redação sensível ao contexto com menos código de orquestração |
A abordagem tradicional continua útil quando cada alvo de redação segue um padrão conhecido e a aplicação exige comportamento estritamente determinístico. A abordagem do SDK de Agente torna-se mais atraente quando os documentos contêm informações variadas e contextuais ou quando o mesmo fluxo de trabalho deve suportar vários formatos do Office.
Configurar o Projeto C#
Crie um aplicativo de console em C# e adicione o Spire.Agent.Office e suas dependências necessárias ao projeto. Você também precisará de um SpireToken válido para processamento de IA.
O exemplo abaixo oferece suporte aos seguintes formatos:
- Word: DOC e DOCX
- Excel: XLS e XLSX
- PowerPoint: PPT e PPTX
PDF não está incluído neste exemplo.
Redigir Documentos do Word, Excel e PowerPoint com um Agente de IA
O código a seguir determina o formato de origem a partir de sua extensão, carrega o objeto de documento do Office apropriado e passa a mesma instrução de redação ao processador de IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Presentation;
using Spire.Doc;
using Spire.Xls;

string inputPath = @"E:\Documents\Input.docx";
string outputPath = @"E:\Documents\Redacted.docx";
string spireToken = "your spireToken";

string instruction = """
Find personal information such as names, email addresses, phone numbers, addresses,
account numbers, and other sensitive information. Replace the detected content with
“[REDACTED]” while preserving the original document structure and formatting.
""";

// Configure the AI processing options
AIOptions options = new AIOptions();
options.SpireToken = spireToken;

// Select the appropriate document object according to the file extension
string extension = Path.GetExtension(inputPath).ToLower();

if (extension == ".doc" || extension == ".docx")
{
    using (Document document = new Document())
    {
        document.LoadFromFile(inputPath);
        AIDocumentProcessor processor = document.AI(options);
        processor.ExecuteInstruction(
            document,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".xls" || extension == ".xlsx")
{
    using (Workbook workbook = new Workbook())
    {
        workbook.LoadFromFile(inputPath);
        AIDocumentProcessor processor = workbook.AI(options);
        processor.ExecuteInstruction(
            workbook,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".ppt" || extension == ".pptx")
{
    using (Presentation presentation = new Presentation())
    {
        presentation.LoadFromFile(inputPath);
        AIDocumentProcessor processor = presentation.AI(options);
        processor.ExecuteInstruction(
            presentation,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
Se os usings globais implícitos estiverem desabilitados em seu projeto, adicione também using System; e using System.IO; para Array e Path.
Definir a Entrada, a Saída e a Instrução
inputPath especifica o documento de origem, enquanto outputPath especifica onde o arquivo redigido será salvo. As extensões de entrada e saída devem corresponder para que o resultado permaneça no formato original.
A instrução em linguagem natural define tanto o escopo de detecção quanto a modificação necessária. Neste exemplo, o agente procura tipos comuns de informações pessoais e os substitui por [REDACTED].
Você pode ajustar a instrução para um fluxo de trabalho mais restrito. Por exemplo:
Find email addresses, phone numbers, and customer account numbers. Replace each detected value with “[REDACTED]”. Do not redact company names, product names, invoice numbers, or dates. Preserve the original layout and formatting.
Adicionar exclusões explícitas pode reduzir falsos positivos quando um documento contém identificadores comerciais que se assemelham a números de contas pessoais.
Configurar o Processamento de IA
AIOptions armazena o SpireToken usado pelo serviço de processamento de IA:
AIOptions options = new AIOptions();
options.SpireToken = spireToken;
O mesmo objeto de opções pode ser usado com a instância de documento do Word, Excel ou PowerPoint.
Selecionar o Tipo de Documento Apropriado
O programa lê a extensão do arquivo e cria o objeto correspondente:
-
Documentpara arquivos do Word -
Workbookpara arquivos do Excel -
Presentationpara arquivos do PowerPoint
Cada objeto expõe o método de extensão AI(). Isso retorna um AIDocumentProcessor, que executa a instrução em linguagem natural no documento carregado.
A matriz de anexos vazia indica que a instrução não requer nenhum arquivo de suporte:
processor.ExecuteInstruction(
    document,
    instruction,
    outputPath,
    Array.Empty<string>());
Resultado da Redação
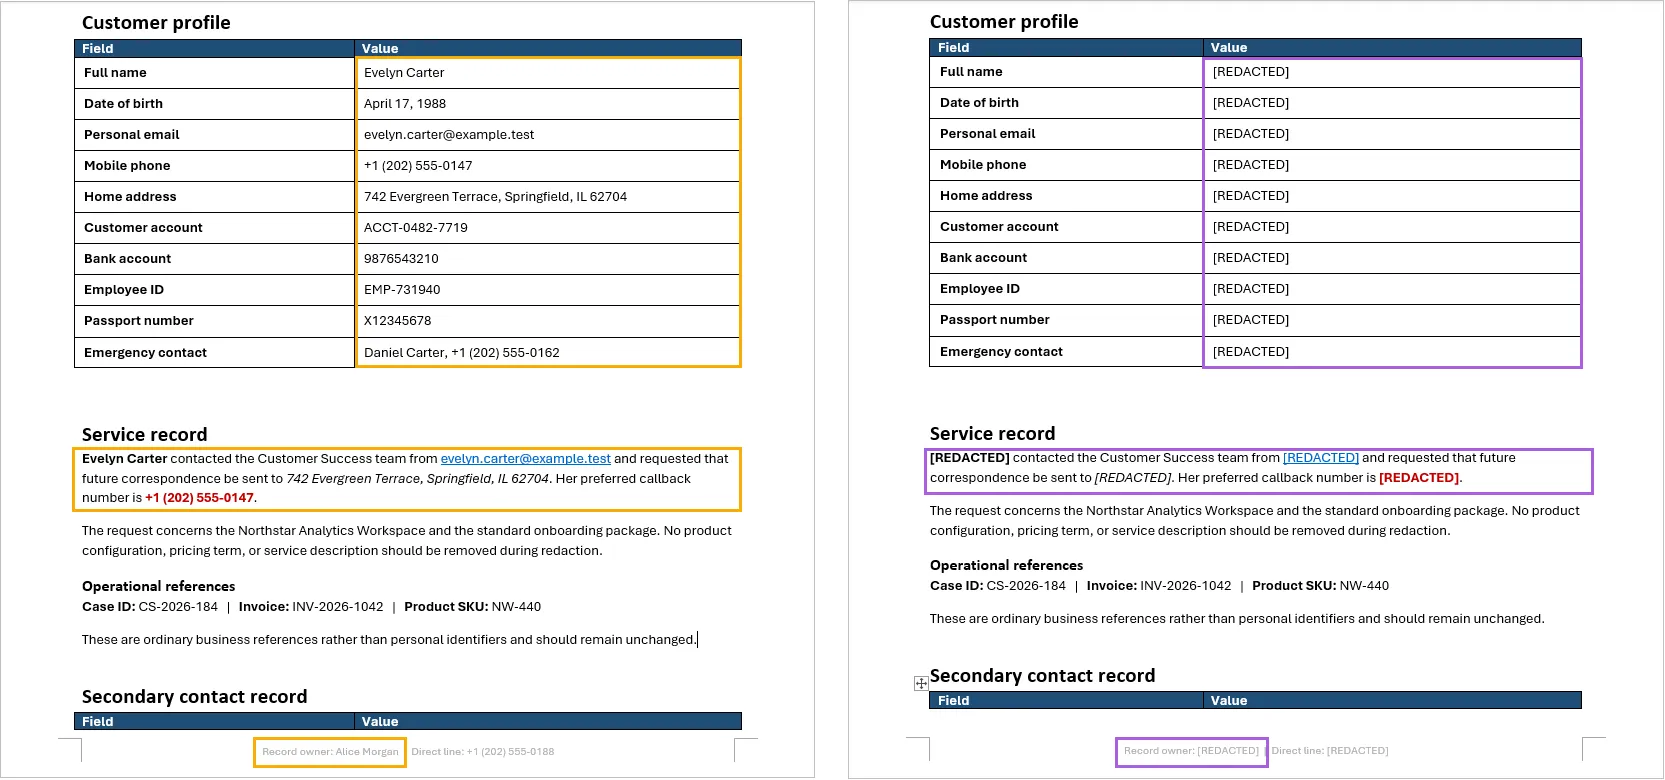
No documento de teste do Word, informações sensíveis apareceram em parágrafos normais, em uma tabela de informações do cliente e no rodapé da página. Após o processamento, os nomes, endereços de e-mail, números de telefone, endereços e informações de conta foram substituídos por [REDACTED].
A estrutura da tabela, a formatação dos parágrafos, os títulos, as cores e o layout do rodapé permaneceram no lugar. Esse resultado é importante porque demonstra que o fluxo de trabalho não simplesmente extrai o documento como texto simples e o reconstrói do zero. Ele modifica os elementos relevantes do documento enquanto mantém sua estrutura ao redor.
Considerações Importantes para Redação com IA
Revise o Resultado Antes de Compartilhar
A redação com IA não é perfeitamente determinística. Um modelo pode deixar passar um identificador incomum ou classificar incorretamente conteúdo comum como sensível. Documentos destinados à distribuição externa devem ser revisados após o processamento, especialmente em fluxos de trabalho jurídicos, financeiros, de saúde ou sensíveis à conformidade.
Torne a Instrução Específica
A instrução deve descrever tanto o que deve ser removido quanto o que deve permanecer. Se números de fatura, nomes de empresas, códigos de produtos ou endereços públicos de escritórios não devem ser redigidos, declare essas exclusões explicitamente.
A Substituição Visível Nem Sempre é uma Sanitização Completa
Substituir o texto visível não remove necessariamente todas as cópias da informação do arquivo. Dados sensíveis também podem aparecer em:
- Comentários e alterações controladas
- Propriedades do documento e metadados
- Planilhas ocultas ou slides ocultos
- Notas do orador do PowerPoint
- Arquivos e objetos incorporados
- Imagens contendo texto
- Versões anteriores ou cópias de backup
Para fluxos de trabalho de alta segurança, esses locais devem ser inspecionados separadamente. Se um documento contiver páginas digitalizadas ou capturas de tela, pode ser necessário OCR antes que o texto dentro das imagens possa ser avaliado.
Preserve o Arquivo Original
Salve o resultado redigido em um novo caminho em vez de sobrescrever o documento de origem. Manter os arquivos separados facilita comparar a saída, investigar conteúdo não detectado e repetir o processo com uma instrução aprimorada.
Conclusão
A redação tradicional baseada em API oferece controle preciso, mas os desenvolvedores devem definir regras de detecção e manter lógica de travessia separada para diferentes formatos de documento e contêineres de conteúdo. A integração direta com LLM melhora o reconhecimento contextual, mas ainda exige uma camada substancial de extração, mapeamento e gravação de volta para preservar a formatação do Office.
Um SDK de Agente de IA reúne essas capacidades. Com uma única instrução em linguagem natural e uma pequena quantidade de código C#, o mesmo fluxo de trabalho pode processar arquivos do Word, Excel e PowerPoint, identificar informações sensíveis contextuais e substituí-las dentro da estrutura do documento original. O resultado ainda deve ser revisado, mas a implementação é consideravelmente mais simples do que construir manualmente todo o pipeline de detecção e orquestração de documentos.
Perguntas Frequentes
O mesmo código pode redigir arquivos do Word, Excel e PowerPoint?
Sim. O exemplo seleciona Document, Workbook ou Presentation de acordo com a extensão do arquivo de entrada e aplica a mesma instrução em linguagem natural a cada formato.
O Agente de IA preserva a formatação original?
O agente trabalha com os objetos subjacentes do documento do Office, permitindo que o texto sensível seja substituído em parágrafos, células, tabelas e formas, mantendo a estrutura e a formatação ao redor. A saída final ainda deve ser verificada, pois layouts extraordinariamente complexos podem exigir verificação adicional.
Posso usar um rótulo de redação diferente?
Sim. Altere [REDACTED] na instrução para outro rótulo, como [PRIVATE], [REMOVED] ou um valor específico de categoria como [EMAIL REDACTED].
Quando uma API tradicional é melhor que a redação com IA?
Uma API tradicional pode ser preferível quando cada valor sensível segue um padrão fixo, as regras raramente mudam e o resultado deve ser completamente determinístico. A substituição por expressões regulares geralmente é suficiente para endereços de e-mail padronizados, números de telefone ou números de identificação.
A substituição de texto garante que o documento é seguro para publicação?
Não. A substituição de texto visível não remove automaticamente comentários, alterações controladas, metadados, conteúdo oculto, objetos incorporados, texto dentro de imagens ou versões anteriores do arquivo. Documentos sensíveis à segurança exigem inspeção e validação adicionais antes da publicação.