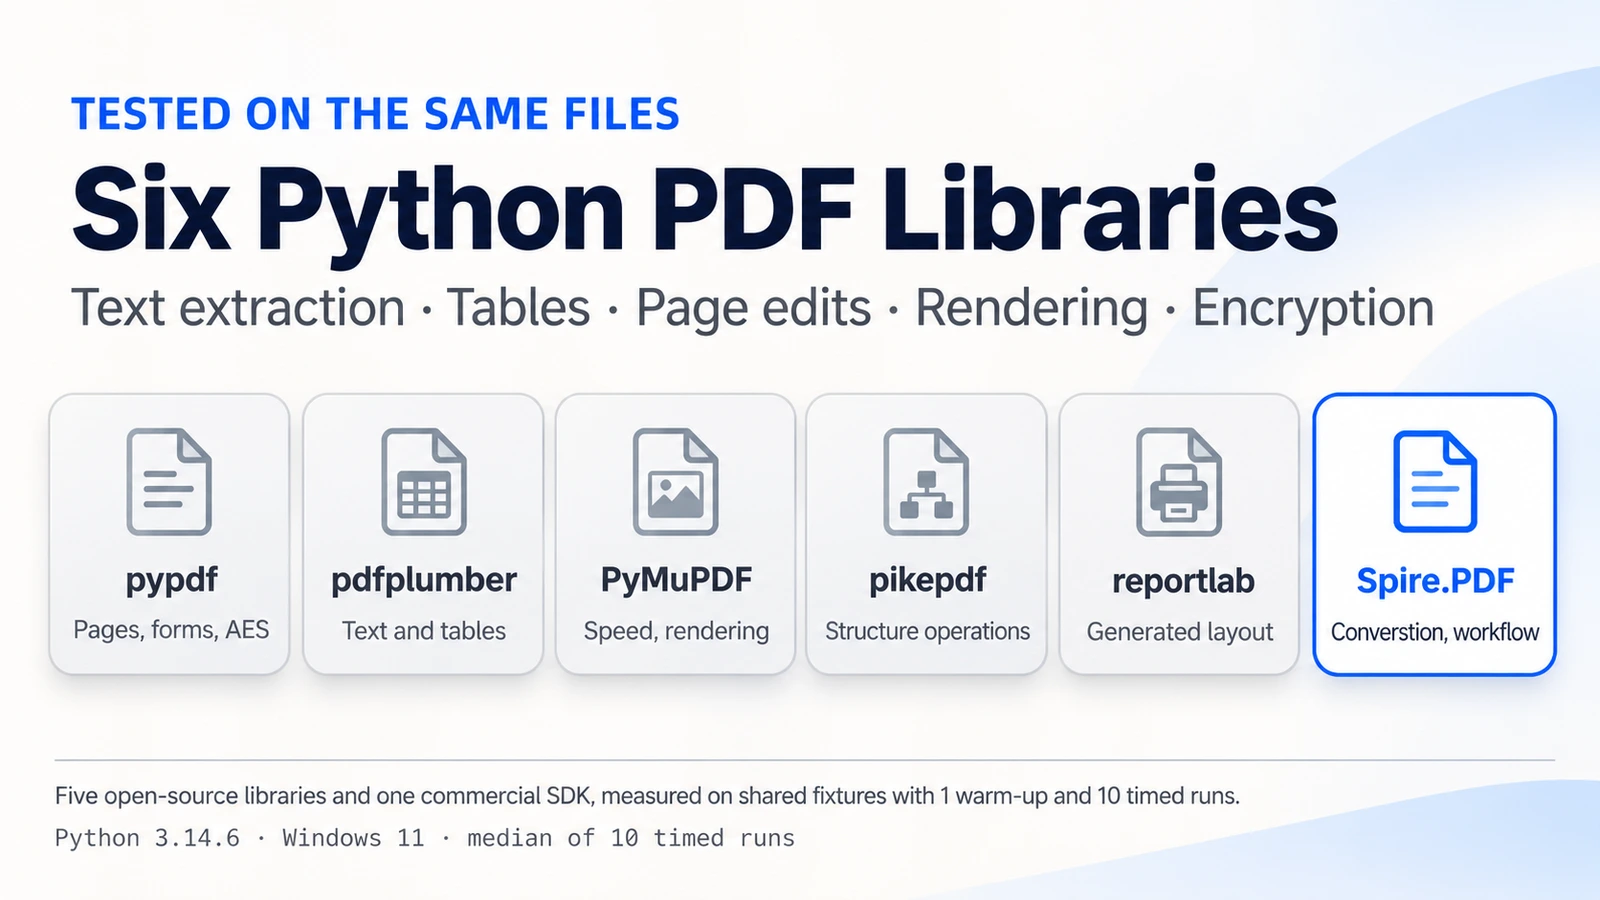
Leggere un PDF con pypdf richiede dieci minuti. Il problema inizia quando allo stesso script viene chiesto di estrarre una tabella riepilogativa dalla prima pagina, eliminare l'appendice, restituire una copia Word modificabile e proteggere l'archivio con una password. Ogni richiesta ha una buona soluzione Python, ma raramente provengono dallo stesso pacchetto.
Questa guida confronta sei opzioni su un unico set di file di test: pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab e Spire.PDF per Python. Dichiarazione: Spire.PDF è un prodotto commerciale di E-iceblue, l'editore di questo articolo, ed E-iceblue ha eseguito i test. I file di test, le versioni e il metodo di misurazione dei tempi sono elencati nella sezione "Come abbiamo testato" così puoi ripetere qualsiasi risultato. Ogni libreria di seguito è una scelta ragionevole per il lavoro per cui è stata creata.
Quale libreria PDF per Python dovresti scegliere?
Se il tuo lavoro consiste in una sola operazione, scegli lo specialista per quella operazione. Le librerie open source in questo confronto sono forti nei rispettivi compiti. Spire.PDF è pensato per l'altro caso: una pipeline in cui un documento passa attraverso estrazione, modifica, conversione e crittografia, e preferisci mantenere un solo SDK anziché tre librerie.
| Libreria | Ideale per | Considerazione chiave | Licenza |
|---|---|---|---|
| pypdf | Unione, divisione, rotazione e crittografia delle pagine in Python puro | La crittografia AES richiede l'extra pypdf[crypto]
|
BSD-3 |
| pdfplumber | Analisi del layout, estrazione di tabelle, debug visivo | Progettata per la lettura, non per modificare le pagine | MIT |
| PyMuPDF | Estrazione rapida del testo e rendering delle pagine | AGPL-3.0 o commerciale; valuta rispetto a come distribuisci | AGPL-3.0 o commerciale |
| pikepdf | Lavoro sulla struttura di basso livello, linearizzazione, crittografia | Nessuna API di estrazione del testo | MPL-2.0 |
| reportlab | Generazione di PDF da codice | Solo generazione | BSD |
| Spire.PDF | Lavori misti (estrai, modifica, converti, crittografa) in un unico SDK | Licenza commerciale; opzioni di licenza gratuita, di valutazione e temporanea | Commerciale |
Leggi la tabella in base al lavoro, non al nome. Se la tua pipeline necessita solo dell'operazione indicata nella prima colonna di una libreria, la terza colonna è l'unica cosa rimasta da valutare. I termini della licenza e il peso dell'installazione tendono a decidere tra candidati vicini, e le sezioni seguenti forniscono numeri su entrambi.
Nota sull'ambito: si tratta di cinque librerie open source selezionate e un SDK commerciale. Non copre ogni strumento PDF specialistico nell'ecosistema Python.
Cosa fanno meglio le librerie PDF open source per Python selezionate
Chi cerca una libreria Python per analizzare PDF o una libreria Python per leggere PDF di solito intende una delle due cose: estrarre testo e tabelle da file esistenti, oppure ristrutturare i file stessi. Le cinque librerie seguenti si dividono lungo questa linea. pdfplumber e PyMuPDF sono più forti sul versante della lettura, pypdf e pikepdf su quello della struttura delle pagine, e reportlab sulla creazione di documenti da zero. Ogni voce indica l'attenzione della libreria, cosa abbiamo misurato e dove finisce il suo ambito.
pypdf
pypdf è una libreria Python pura per il lavoro a livello di pagina, con un'occupazione installata di 1,8 MB nel nostro ambiente pulito. Nelle nostre esecuzioni ha estratto un documento di testo di 10 pagine in 43,1 ms, ruotato una pagina in 9,2 ms, eliminata una in 8,6 ms, unito due file in 14,7 ms, separato tre pagine in 10,2 ms e applicato la crittografia AES-256 in 19,6 ms. AES richiede l'extra pypdf[crypto], che porta l'installazione a 13,2 MB. È una prima scelta naturale quando riorganizzi le pagine e non vuoi dipendenze compilate; la protezione AES introduce l'extra crypto sopra indicato.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
Lo script unisce due file, ruota la prima pagina e scrive una copia protetta con AES-256.
pdfplumber
pdfplumber è lo strumento da scegliere quando devi capire come è impaginata una pagina. Espone le posizioni di caratteri, linee e rettangoli, il che rende pratica l'estrazione di tabelle e il debug visivo. La tabella con bordi 21 × 4 nel nostro file di test è stata restituita in 44,6 ms, e l'estrazione di testo semplice su dieci pagine ha richiesto 320,4 ms, più a lungo dei lettori focalizzati sul testo, mentre la libreria espone anche i dettagli posizionali su cui si basano l'analisi del layout e il lavoro sulle tabelle. Una fattura cinese di una pagina è stata letta in 7,7 ms e ha restituito la frase attesa "发票编号". Legge i PDF e non li modifica, quindi di solito affianca una seconda libreria.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
La chiamata restituisce la prima tabella a pagina uno come elenco di righe.
PyMuPDF
PyMuPDF combina elaborazione del testo e rendering sopra un motore compilato. Ha avuto il tempo di estrazione del testo più basso nel test, 7,2 ms per dieci pagine, ha eliminato una pagina in 3,0 ms e renderizzato una pagina a 150 DPI in 48,8 ms. L'installazione predefinita è di 201,3 MB con le sue dipendenze (104,5 MB con --no-deps), quindi è l'opzione più pesante qui, e la licenza è AGPL-3.0 o commerciale. Se il tuo servizio renderizza miniature o fa passare molte pagine attraverso l'estrazione del testo, i numeri spiegano la sua popolarità.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
Il frammento legge il testo della prima pagina e ne salva un PNG a 150 DPI.
pikepdf
pikepdf avvolge la libreria QPDF e lavora sulla struttura stessa degli oggetti PDF. Questo si adatta a lavori come ruotare o eliminare pagine (6,4 ms e 5,8 ms), riordinarle (6,5 ms), applicare la crittografia AES-256 con un gestore di revisione 6 (32,0 ms) e salvare un file linearizzato per la distribuzione web (7,8 ms). Non offre un'API di estrazione del testo, quindi i team di solito lo abbinano a un lettore. Scegliilo quando hai bisogno di manipolazione di oggetti PDF di basso livello, ristrutturazione delle pagine, crittografia o linearizzazione.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
Il codice imposta la prima pagina a una rotazione di 90 gradi e salva il risultato.
reportlab
reportlab esiste per creare PDF, e lo fa con pieno controllo su font, coordinate e layout fluenti. Nel test ha generato un documento di 10 pagine, 40 righe per pagina in Arial 10 pt, in 14,1 ms. Non ha alcun compito di lettura o modifica di file esistenti, il che è un confine chiaro più che una lacuna: fatture, etichette e report generati sono il suo ambito ideale.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
Il ciclo produce un file A4 di 10 pagine con 40 righe per pagina.
Quando un flusso di lavoro PDF multi-libreria diventa difficile da mantenere
Niente di quanto sopra è un difetto. L'attrito emerge quando un singolo requisito richiede più di queste librerie in sequenza, e ogni strumento aggiunto comporta costi che non compaiono in una singola riga di benchmark:
- La conversione richiede un convertitore separato. PDF in Word non fa parte dei lettori e degli editor di pagine sopra, quindi ne aggiungi uno, e la fedeltà del layout deve essere verificata file per file.
- La modifica del testo sul posto è un'attività a sé. Le operazioni sulle pagine spostano o rimuovono intere pagine; cambiare parole dentro una pagina richiede qualcos'altro.
- I moduli complessi sono un argomento separato. Leggere campi semplici è una cosa, creare e appiattire moduli è un'altra, e le librerie differiscono per quanto si spingono oltre.
- Le firme e PDF/A richiedono strumenti aggiuntivi. I flussi di lavoro di archiviazione e firma di solito introducono pacchetti aggiuntivi.
- L'OCR è esterno per progettazione. Le pagine scansionate richiedono un motore esterno a tutte queste librerie.
Un quadro concreto aiuta. Un tipico script di collegamento apre il file in una libreria, scrive un file intermedio, riapre quel file in una seconda libreria, salva di nuovo, quindi passa il risultato a un convertitore che lo analizza una terza volta. Ogni passaggio è un punto in cui font, riquadri di pagina o flag di crittografia possono cambiare, e ognuno richiede un test proprio. Niente di tutto questo è difficile da scrivere; è la parte che continua a crescere man mano che i requisiti cambiano.
Sotto tutte e cinque c'è lo stesso sovraccarico: un'altra API da imparare, un altro albero di dipendenze, un'altra matrice di compatibilità e un altro percorso di gestione degli errori, oltre a un passaggio di file tra strumenti.
Le licenze meritano una riga a parte. Il convertitore comune pdf2docx è con licenza MIT e dipende da PyMuPDF, che è AGPL-3.0 o commerciale. Questi sono due fatti separati, e un prodotto distribuito dovrebbe valutare entrambi. Per uno sguardo più approfondito al versante della lettura del problema, consulta la nostra guida su analizzare PDF in Python.
Cosa aggiunge Spire.PDF per Python ai flussi di lavoro PDF
Spire.PDF per Python è un SDK commerciale che gestisce lettura, modifica, conversione, sicurezza e generazione all'interno di un unico pacchetto. Quattro aree sono importanti per il confronto.
1. Un modello di documento condiviso e un'API coerente
Un modello di documento condiviso e un'API Python coerente consentono agli sviluppatori di eseguire più operazioni PDF all'interno di un unico SDK. Classi helper specializzate, come PdfTableExtractor, funzionano con il PdfDocument caricato. Lo stesso PdfDocument caricato può essere usato per più operazioni, senza passare file PDF intermedi tra librerie separate. Significa anche un unico schema di gestione degli errori e un unico insieme di vincoli di versione da tenere traccia quando aggiorni.
2. Prestazioni di estrazione delle tabelle nel nostro benchmark
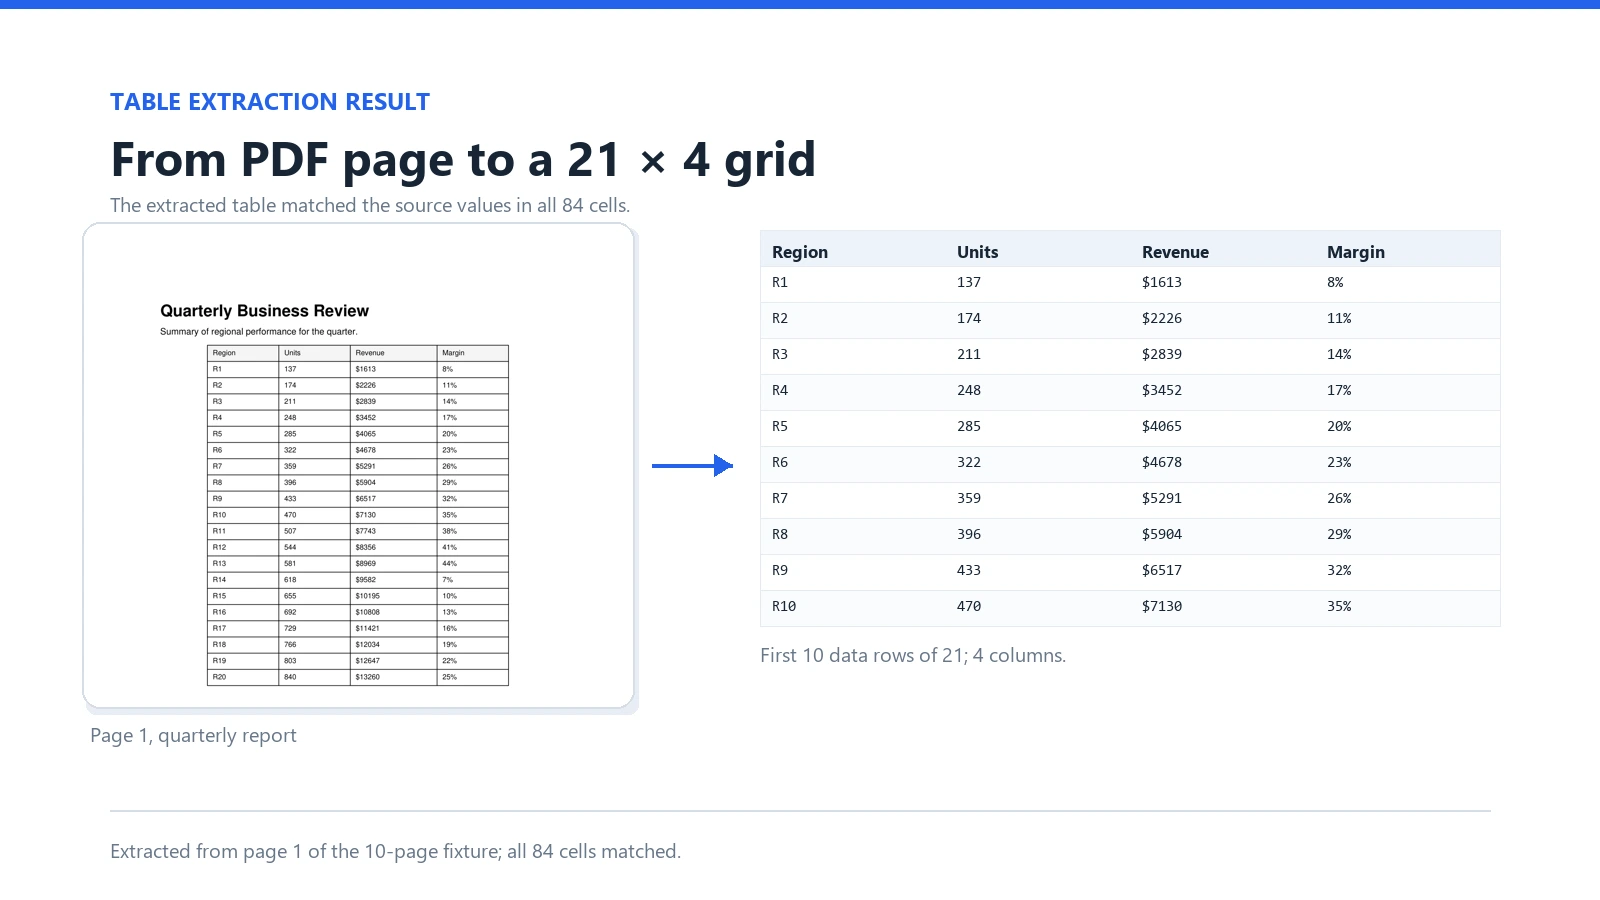
Abbiamo eseguito la stessa tabella con bordi attraverso tre librerie. Il file di test è di 21 righe per 4 colonne, ha bordi chiaramente tracciati e nessuna cella unita. La documentazione ufficiale afferma che l'estrazione di tabelle funziona meglio con tabelle chiaramente formattate, quindi questi risultati descrivono solo quel tipo di tabella.
| Libreria | Mediana | Intervallo | Risultato |
|---|---|---|---|
| Spire.PDF | 18,9 ms | da 16,2 a 26,4 ms | 21 × 4, tutte le 84 celle corrette |
| pdfplumber | 44,6 ms | da 42,3 a 53,7 ms | 21 × 4, tutte le 84 celle corrette |
| PyMuPDF | 363,4 ms | da 341,6 a 385,7 ms | 21 × 4, tutte le 84 celle corrette |
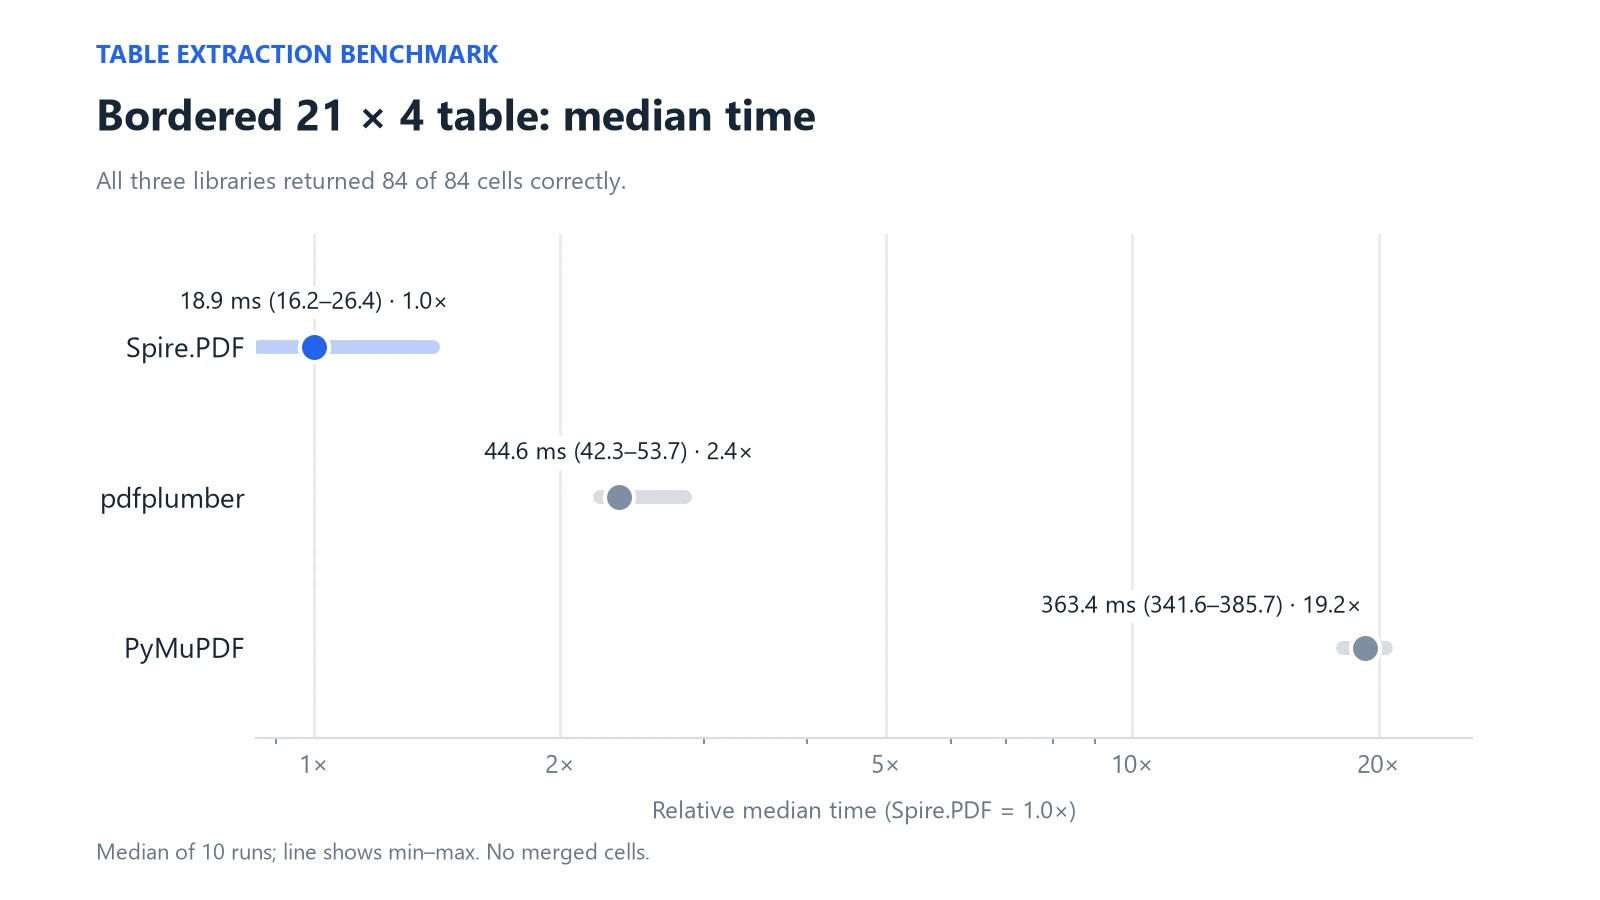
Tutte e tre hanno restituito contenuti delle celle identici, quindi il confronto riguarda il tempo a parità di correttezza. Spire.PDF ha registrato la mediana più bassa in questo test. Le tabelle con celle unite, bordi mancanti o pagine scansionate non sono state misurate e potrebbero classificarsi diversamente. Per una procedura dettagliata della stessa API, vedi estrarre tabelle da PDF in Python.
3. Moduli
Spire.PDF per Python documenta API per creare e compilare campi modulo e per appiattirli in contenuto statico. La gestione dei moduli non è stata inclusa nel nostro benchmark delle prestazioni, quindi questa sezione descrive solo capacità documentate.
4. Esportazione in altri formati
Lo stesso documento caricato può essere salvato in diversi formati. Nelle nostre esecuzioni, gli output seguenti sono stati prodotti da un report di 10 pagine.
| Direzione | Profondità di verifica |
|---|---|
| PDF in DOCX, HTML, Markdown | Output generato; contenuto testuale verificato |
| PDF in XLSX | Output generato; contenuto delle celle presente; la struttura dipende dal layout di origine |
| PDF in PNG, XPS, SVG, PPTX | Output generato; la fedeltà visiva dipende dal layout di origine |
| PDF in PDF/A-1a e PDF/A-1b | Metodi di conversione disponibili; output generato e identificatori XMP verificati; conformità formale a PDF/A non convalidata in modo indipendente |
L'output della conversione dipende dal layout di origine; convalida file rappresentativi prima dell'uso in produzione. Per il percorso DOCX in dettaglio, vedi il tutorial su convertire PDF in Word in Python.
Un flusso di lavoro PDF in più passaggi in Python
Per vedere l'argomento della manutenzione nel codice, abbiamo preso un lavoro realistico. Un report trimestrale di 40 pagine richiede l'estrazione della sua tabella riepilogativa e la rimozione delle pagine di appendice. Dal file aggiornato sono richiesti due output: un DOCX modificabile e un archivio PDF crittografato con AES-256.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
L'implementazione open source usa pdfplumber per la tabella, pypdf[crypto] per l'eliminazione delle pagine e la crittografia, e pdf2docx per la copia Word. Sono tre pacchetti che toccano direttamente i PDF. Installati insieme in un ambiente pulito arrivano a 29 distribuzioni e 388,9 MB, contro 70,5 MB per Spire.PDF misurato allo stesso modo.
Con Spire.PDF l'intero flusso resta all'interno di un unico oggetto documento:
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
Per un confronto dei tempi a parità di condizioni, entrambe le implementazioni sono state eseguite sulla versione di 10 pagine del report. I tre pacchetti open source hanno impiegato una mediana di 1.346,2 ms in totale e Spire.PDF 267,3 ms. Entrambi hanno estratto correttamente tutte le 84 celle della tabella, ed entrambi hanno prodotto un PDF crittografato di 9 pagine che si è riaperto con la password. Entrambi gli archivi hanno rifiutato di aprirsi senza la password. Sul report di 40 pagine lo stack open source ha impiegato 3.241,4 ms e prodotto 39 pagine; la build di valutazione di Spire.PDF gestisce solo le prime 10 pagine, quindi non confrontiamo quell'esecuzione (vedi la sezione sulle edizioni).
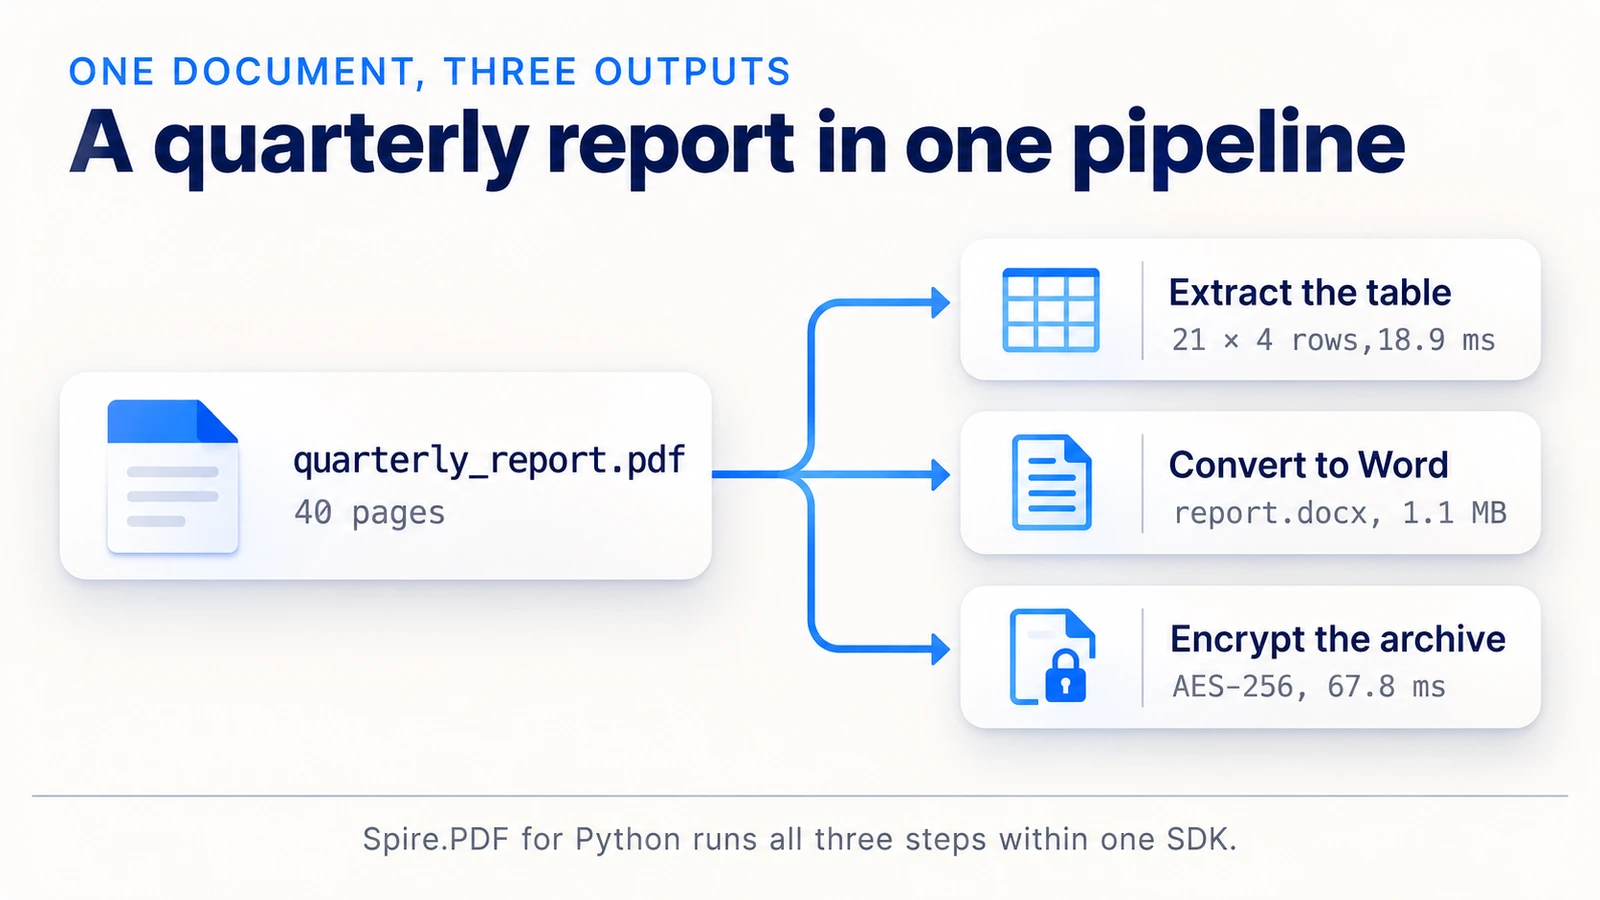
Questo confronto copre estrazione di tabelle, eliminazione di pagine, generazione DOCX e PDF, crittografia e tempo trascorso; la fedeltà del layout DOCX è fuori da questo confronto sui tempi e dovrebbe essere convalidata sui tuoi file. La maggior parte della differenza di tempo risiede nel passaggio DOCX, dove il convertitore open source ha impiegato circa 1,3 s. Il punto dell'esercizio è meno il cronometro e più la forma del codice: un'importazione, un oggetto documento, nessun file passato tra pacchetti. Per maggiori dettagli sulla gestione delle password, vedi proteggere o rimuovere la protezione dei documenti PDF in Python.
Prestazioni e dimensione dell'installazione
Ogni numero sotto è una mediana di 10 esecuzioni cronometrate dopo un'esecuzione di warm-up, in millisecondi, con il minimo e il massimo tra parentesi. Ogni cifra è un tempo end-to-end per l'operazione: l'apertura del file di test e il salvataggio dell'output sono inclusi dove applicabile. "n/d" significa che la libreria non ha tale operazione.
| Attività | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| Testo, 10 pagine | 43,1 (39,9–46,1) | 320,4 (295,5–573,8) | 7,2 (6,7–8,4) | n/d | n/d | 58,2 (53,8–64,6) |
| Tabella, 84 celle | n/d | 44,6 (42,3–53,7) | 363,4 (341,6–385,7) | n/d | n/d | 18,9 (16,2–26,4) |
| Ruota una pagina | 9,2 (8,5–13,1) | n/d | 3,8 (2,7–11,0) | 6,4 (5,6–7,7) | n/d | 22,4 (20,6–29,9) |
| Elimina una pagina | 8,6 (8,2–14,7) | n/d | 3,0 (2,8–3,4) | 5,8 (5,5–6,9) | n/d | 23,3 (20,2–27,8) |
| Rendering a 150 DPI | n/d | n/d | 48,8 (47,2–52,3) | n/d | n/d | 161,4 (153,8–180,3) |
| Crittografia AES-256 | 19,6 (17,2–24,6) | n/d | n/d | 32,0 (30,9–34,4) | n/d | 67,8 (62,1–72,2) |
| Genera 10 pagine | n/d | n/d | n/d | n/d | 14,1 (13,7–15,3) | 85,3 (79,4–106,9) |
Sulle singole operazioni gli specialisti sono in testa nella maggior parte delle righe: PyMuPDF per testo, rotazione, eliminazione e rendering, pypdf per le modifiche alle pagine in Python puro, pikepdf per il lavoro strutturale, ed entrambi per la crittografia, con reportlab per la generazione. La mediana più bassa di Spire.PDF è stata nel test delle tabelle. La generazione ha confrontato 10 pagine da 40 righe ciascuna, A4, Arial 10 pt. Nel test di rendering, PyMuPDF e Spire.PDF hanno prodotto entrambi immagini da 1241 × 1754 pixel a 150 DPI. Il valore di un unico SDK emerge nei flussi di lavoro combinati, non in una singola riga.
Installazione, misurata in un ambiente virtuale pulito ed escludendo interprete, pip, setuptools, wheel e __pycache__:
| Destinazione | Dimensione installata | Pacchetti | Importazione in un nuovo processo |
|---|---|---|---|
| pypdf | 1,8 MB | 1 | 219,9 ms |
| pypdf[crypto] | 13,2 MB | 4 | 331,8 ms |
| pdfplumber | 43,9 MB | 8 | 246,5 ms |
| PyMuPDF (predefinito) | 201,3 MB | 12 | 223,8 ms |
PyMuPDF (--no-deps) |
104,5 MB | 1 | 217,0 ms |
| pikepdf | 35,2 MB | 4 | 178,4 ms |
| reportlab | 20,4 MB | 3 | 9,0 ms |
| Spire.PDF | 70,5 MB | 2 | 640,6 ms |
| Stack del flusso di lavoro con tre pacchetti | 388,9 MB | 29 | n/d |
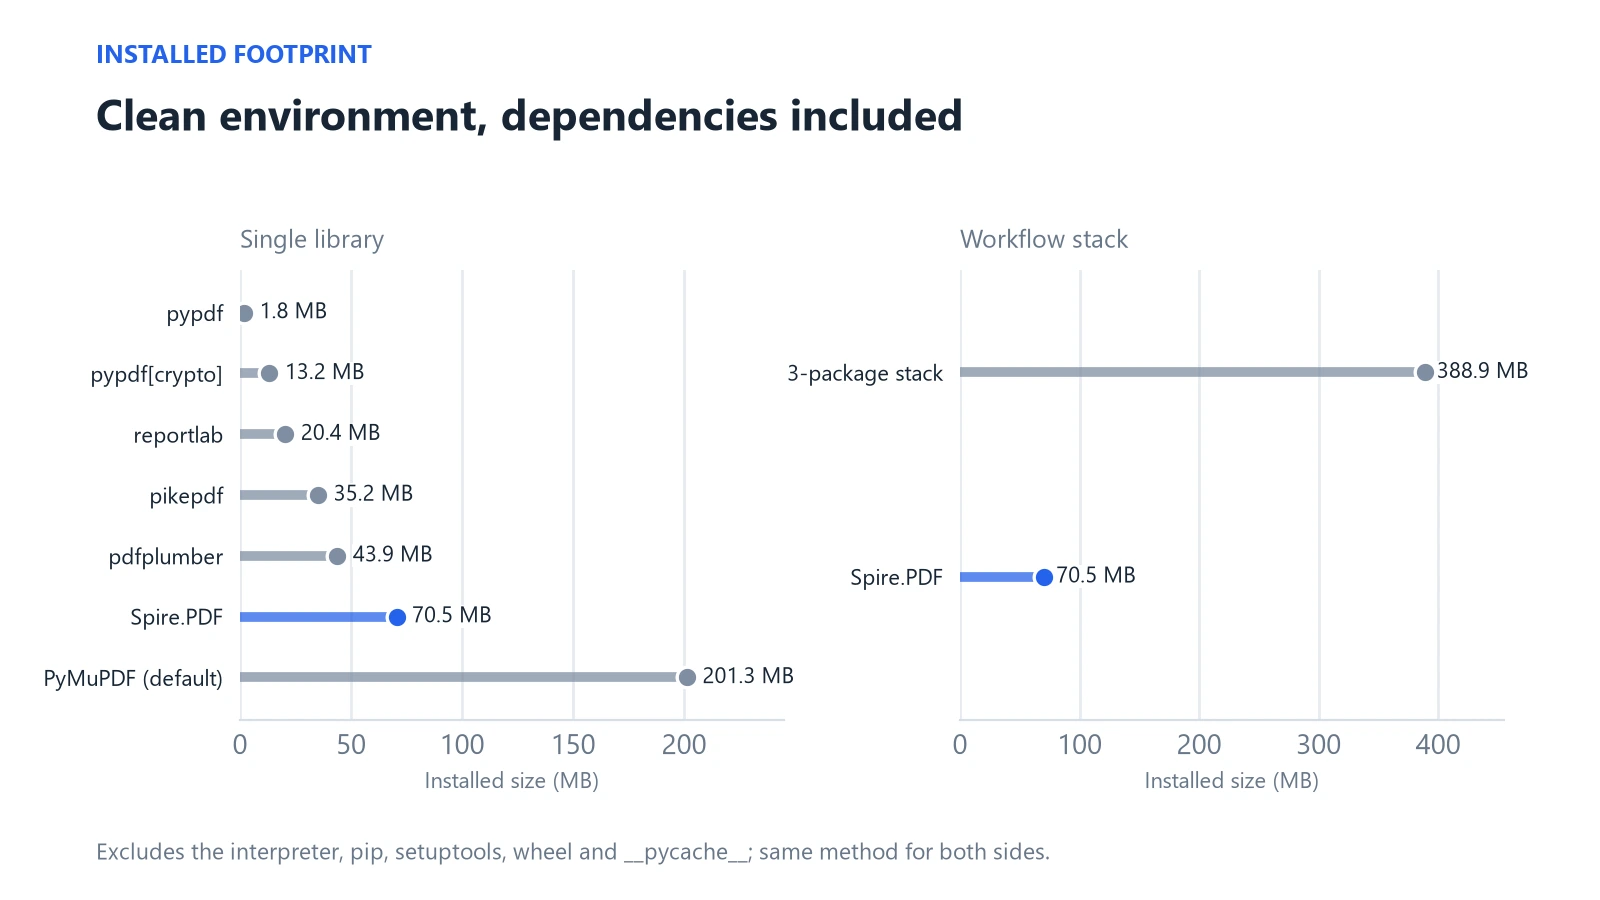
Due dettagli meritano attenzione nella tabella delle installazioni. Il tempo di importazione è un costo una tantum per processo, quindi conta per lavori da riga di comando di breve durata e funzioni serverless più che per servizi di lunga durata; l'importazione a freddo di Spire.PDF ha misurato 640,6 ms, comunque sotto un secondo, mentre quella di reportlab è stata la più breve a 9,0 ms. La dimensione dell'installazione conta per immagini container e pacchettizzazione desktop, dove i 201,3 MB predefiniti di PyMuPDF e lo stack da 388,9 MB con tre pacchetti si distinguono.
Licenze in una riga ciascuna: pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 o commerciale, pikepdf MPL-2.0, reportlab BSD, Spire.PDF commerciale. I termini AGPL dovrebbero essere valutati rispetto a come distribuisci il tuo software.
Edizione gratuita, valutazione, temporanea e commerciale
Spire.PDF è un prodotto commerciale con diverse edizioni, e si comportano diversamente, quindi controlla quale hai installato prima di eseguire benchmark o distribuire.
| Pacchetto / versione | Stato | Limiti |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | Edizione gratuita | Output limitato a 10 pagine; conversione in immagine, XPS, Word e HTML limitata alle prime 3 pagine |
| spire-pdf 12.10.0 (2026-10-12) | Valutazione | Avviso di valutazione; prime 10 pagine elaborate |
| spire-pdf 12.10.0 | Licenza temporanea (30 giorni) | Limiti di valutazione rimossi |
| spire-pdf 12.10.0 | Commerciale | Nessuno dei limiti sopra indicati |
Oltre all'API, una licenza commerciale è anche un rapporto di manutenzione. Il pacchetto fornisce wheel per Windows, Linux e macOS, ha registrato sette rilasci tra gennaio e ottobre 2026 (da 12.1.3 a 12.10.0), e le licenze commerciali includono aggiornamenti e supporto tecnico tramite forum ed email del fornitore, con obiettivi di risposta che dipendono dal livello di licenza.
Il limite di pagine è facile da verificare: un file di 40 pagine caricato nella build di valutazione produce solo 10 pagine elaborate. Questa è una proprietà dell'edizione di valutazione, non della capacità del prodotto, ed è il motivo per cui la nostra esecuzione del flusso di lavoro su 40 pagine è riportata solo per lo stack open source. Le build di valutazione servono per la valutazione, non per la produzione. Per i team nuovi al prodotto, una sequenza sensata è iniziare con la build di valutazione sui propri file, richiedere una licenza temporanea quando serve testare oltre 10 pagine e passare a una licenza commerciale prima del rilascio.
Scegliere la libreria PDF giusta per il tuo progetto
Tre profili coprono la maggior parte dei team:
- Un lavoro specializzato. Estrarre testo in grandi volumi, renderizzare pagine, unire file o generare report: scegli la libreria creata per quell'operazione, come PyMuPDF, pypdf o reportlab. Controlla la licenza se ridistribuisci.
- Lettura consapevole del layout. Se tabelle e posizioni sono il focus, pdfplumber è lo strumento da cui partire, con pypdf o pikepdf per eventuali modifiche alle pagine.
- Lavori concatenati sullo stesso file. Quando estrazione, modifiche alle pagine, conversione e crittografia appartengono a un'unica pipeline, un singolo SDK riduce il numero di API e alberi di dipendenze da mantenere. È qui che Spire.PDF è progettato per inserirsi; una licenza commerciale copre aggiornamenti e supporto.
Un rapido test prima di impegnarti: annota ogni operazione di cui il progetto avrà bisogno nel prossimo anno, incluse conversione, crittografia e archiviazione, e segna quale libreria copre ciascuna. Se una libreria copre l'intero elenco, hai finito. Se l'elenco ne richiede tre, confronta il costo di tre dipendenze con quello di una licenza.
Conta i lavori, non le funzionalità. Se riesci a nominare in una frase le operazioni di cui il tuo progetto ha bisogno e sono una o due, uno specialista probabilmente basta. Se l'elenco continua a crescere, prova Spire.PDF per Python sui tuoi file.
Come abbiamo testato
Dichiarazione: Spire.PDF per Python è un prodotto E-iceblue, e questo benchmark è stato eseguito dall'editore. Abbiamo quindi pubblicato file di test, versioni e metodo, e le librerie open source sono state testate esattamente sugli stessi file.
- Ambiente: Windows 11, Intel Core i3-10105 a 3,70 GHz (4 core, 8 thread), 8,4 GB di RAM, Python 3.14.6.
- Versioni: pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- File di test: un documento di testo di 10 pagine, una tabella con bordi 21 × 4 a pagina uno, una fattura in lingua cinese, una pagina a contenuto misto per il rendering e report trimestrali generati da 10 e 40 pagine. Conteggi di pagine, dimensioni e hash SHA-256 sono registrati in un manifest dei file di test.
- Misurazione dei tempi: un warm-up e 10 esecuzioni misurate per test, riportate come mediane con minimo e massimo. Apertura, operazione e salvataggio sono stati cronometrati in fasi separate.
- Correttezza: testo confrontato per copertura di token unici e similarità di sequenza (non conteggi grezzi di caratteri, poiché le convenzioni sugli spazi differiscono); tabelle confrontate cella per cella; file crittografati riaperti con la password e verificati per l'accesso bloccato senza di essa.
- Non coperto: una macchina e un carico di lavoro; documenti scansionati, OCR, firme, gestione dei moduli, tabelle con celle unite e file danneggiati arbitrari non sono stati misurati. I tempi varieranno sul tuo hardware e sui tuoi documenti.
Domande frequenti
Qual è la migliore libreria PDF per Python nel complesso? Non c'è un unico vincitore. PyMuPDF è in testa per velocità di testo e rendering, pypdf è la scelta semplice per le operazioni sulle pagine, pdfplumber per le tabelle, reportlab per la generazione. Per pipeline che concatenano più lavori, un singolo SDK come Spire.PDF può ridurre il numero di pacchetti PDF integrati direttamente.
pypdf vs PyMuPDF: quale dovrei usare? Scegli pypdf per operazioni sulle pagine in un pacchetto piccolo e Python puro con licenza BSD. Scegli PyMuPDF per un'estrazione del testo e un rendering delle pagine più rapidi, e controlla prima i suoi termini AGPL-3.0 o commerciali. Nel nostro test PyMuPDF ha impiegato 7,2 ms per il testo contro 43,1 ms.
Come estrarre una tabella da un PDF in Python?
Per tabelle con bordi, chiama extract_tables() in pdfplumber, oppure usa un estrattore di tabelle in PyMuPDF o Spire.PDF. Sul nostro file di test 21 × 4 tutti e tre hanno corrisposto 84 celle su 84. Le tabelle senza bordi o con celle unite richiedono test separati.
Python può convertire un PDF in Word? Sì. pdf2docx è un'opzione open source comune, e Spire.PDF può salvare un documento caricato come DOCX. L'output della conversione dipende dal layout di origine; convalida file rappresentativi prima dell'uso in produzione.
Queste librerie sono gratuite per uso commerciale? pypdf, pdfplumber, pikepdf e reportlab usano licenze permissive o con copyleft debole (BSD-3, MIT, MPL-2.0, BSD). PyMuPDF è AGPL-3.0 o commerciale, quindi valutalo rispetto a come distribuisci. Spire.PDF richiede una licenza commerciale per la produzione; le licenze commerciali includono aggiornamenti e supporto tecnico, mentre le edizioni gratuite e di valutazione hanno limiti di pagine.
Fonti
- Documentazione di pypdf
- Repository di pdfplumber
- Documentazione di PyMuPDF
- Documentazione di pikepdf
- Documentazione di ReportLab
- Documentazione di pdf2docx
- Guida programmatica di Spire.PDF per Python