I documenti utilizzati nei flussi di lavoro dell'assistenza clienti, della finanza, delle risorse umane e del settore legale contengono spesso nomi, indirizzi email, numeri di telefono, indirizzi di casa, numeri di conto e altre informazioni sensibili. Prima che questi file possano essere condivisi, archiviati o utilizzati per l'analisi, potrebbe essere necessario rimuovere o sostituire i contenuti identificativi.
I programmi di oscuramento tradizionali si basano su regole di ricerca predefinite e su una logica di elaborazione separata per ogni formato di documento. Un AI Agent SDK offre un approccio diverso: gli sviluppatori possono descrivere il requisito di oscuramento in linguaggio naturale, consentendo all'agente di identificare le informazioni sensibili e modificare i corrispondenti elementi del documento Office. Questo articolo mostra come oscurare file Word, Excel e PowerPoint in C# preservandone la struttura e la formattazione originali.
Che cos'è l'oscuramento dei documenti?
L'oscuramento dei documenti è il processo di rimozione o sostituzione delle informazioni che non devono essere divulgate. Tra gli obiettivi di oscuramento più comuni vi sono:
- Nomi di persona
- Indirizzi email
- Numeri di telefono e fax
- Indirizzi di casa o postali
- Date di nascita
- Identificativi di clienti e dipendenti
- Numeri bancari e di conto
- Altre informazioni riservate o di identificazione personale
Per i file Office modificabili, l'oscuramento comporta più che la semplice modifica del testo normale. I contenuti sensibili possono comparire in paragrafi e tabelle di Word, celle di Excel, forme di PowerPoint, intestazioni, piè di pagina o altri elementi del documento. Un flusso di lavoro di oscuramento utile dovrebbe rimuovere il valore rilevato senza modificare inutilmente il layout circostante, gli stili, le immagini, i grafici o la struttura del documento.
Tre modi per oscurare documenti Office in C#
Esistono tre approcci generali di implementazione: le API tradizionali per i documenti, un'integrazione diretta con un LLM e un AI Agent SDK.
Oscuramento tradizionale basato su API
Un'implementazione tradizionale inizia normalmente con la sostituzione esatta del testo o con espressioni regolari. Ad esempio, Spire.Doc for .NET fornisce API per trovare e sostituire testo nei documenti Word.
Il seguente pseudocodice semplificato illustra un flusso di lavoro di oscuramento basato su regole. È volutamente incompleto e mostra solo le responsabilità principali che l'applicazione dovrebbe gestire.
Document document = new Document();
document.LoadFromFile("Input.docx");

// Patterns must be defined and maintained by the developer.
Regex emailPattern = new Regex("...");
Regex phonePattern = new Regex("...");
Regex accountPattern = new Regex("...");

document.Replace(emailPattern, "[REDACTED]");
document.Replace(phonePattern, "[REDACTED]");
document.Replace(accountPattern, "[REDACTED]");

// Additional logic may still be required for different content containers.
foreach (Section section in document.Sections)
{
    ProcessParagraphs(section);
    ProcessTables(section.Tables);
    ProcessHeadersAndFooters(section.HeadersFooters);
    ProcessTextBoxes(section);
}

document.SaveToFile("Redacted.docx", FileFormat.Docx);
Questo approccio funziona bene quando i valori sensibili seguono schemi prevedibili. Gli indirizzi email, i numeri di telefono e i numeri di identificazione standardizzati possono spesso essere individuati con espressioni regolari.
La difficoltà aumenta quando le informazioni dipendono dal contesto. Un programma potrebbe dover determinare se una parola è il nome di una persona, se un numero è un numero di conto o un numero di fattura e se una località è un indirizzo privato o l'indirizzo pubblico di un'azienda. Gli sviluppatori devono inoltre aggiungere logiche di scansione e sostituzione diverse per Word, Excel e PowerPoint.
Integrazione diretta con un LLM
Un modello linguistico di grandi dimensioni può comprendere il contesto in modo più efficace di un insieme di espressioni regolari. Ad esempio, può riconoscere il nome di una persona in una frase anche quando il nome non segue uno schema prevedibile.
Tuttavia, un LLM non fornisce automaticamente un'elaborazione completa dei documenti Office. Un'integrazione diretta richiede di solito che l'applicazione:
- Estragga il testo da ogni elemento rilevante del documento.
- Divida il contenuto in richieste adeguate.
- Invii il testo estratto al modello.
- Riporti i risultati del modello ai paragrafi, alle celle o alle forme originali.
- Sostituisca il contenuto sensibile senza perdere la sua formattazione.
- Salvi il file modificato nel suo formato originale.
Se il documento viene convertito in testo normale prima di essere inviato al modello, le informazioni su tabelle, intervalli di testo, caratteri, allineamento e altre proprietà di layout potrebbero andare perse. Lo sviluppatore rimane quindi responsabile di collegare i risultati semantici del modello al modello a oggetti del documento Office.
AI Agent SDK
Un AI Agent SDK combina la comprensione del linguaggio naturale con le capacità di elaborazione dei documenti. Invece di definire ogni regola di rilevamento e coordinare manualmente ogni fase di sostituzione, lo sviluppatore fornisce il documento e descrive il risultato desiderato.
Spire.Agent.Office utilizza le capacità di base di Spire.Office for .NET per lavorare con oggetti Word, Excel e PowerPoint. In un documento Word, ad esempio, il livello di elaborazione può accedere a sezioni, paragrafi, intervalli di testo, tabelle, celle, intestazioni, piè di pagina, immagini, collegamenti ipertestuali e alla loro formattazione. Il modello identifica il contenuto sensibile, mentre le API dei documenti modificano gli elementi corrispondenti.
Questa elaborazione a livello di oggetto è ciò che rende possibile sostituire il testo mantenendo la struttura e gli stili circostanti del documento.
API tradizionale vs. LLM vs. AI Agent SDK
| Approccio | Rilevamento contestuale | Conservazione del formato | Implementazione multi-formato | Impegno di sviluppo | Ideale per |
|---|---|---|---|---|---|
| API tradizionale ed espressioni regolari | Limitato a meno che non venga aggiunta una logica NLP aggiuntiva | Solida e controllabile | Di norma è richiesta una logica separata | Elevato | Schemi fissi e regole altamente deterministiche |
| API Office con chiamate dirette a LLM | Elevato | Deve essere implementata dallo sviluppatore | Sono necessarie logiche di estrazione e riscrittura per ogni formato | Molto elevato | Pipeline AI completamente personalizzate |
| AI Agent SDK | Elevato | Gestita tramite un'elaborazione consapevole del documento | Un'istruzione comune può essere applicata a più formati Office | Inferiore | Oscuramento sensibile al contesto con meno codice di orchestrazione |
L'approccio tradizionale rimane utile quando ogni obiettivo di oscuramento segue uno schema noto e l'applicazione richiede un comportamento strettamente deterministico. L'approccio con Agent SDK diventa più interessante quando i documenti contengono informazioni varie e contestuali o quando lo stesso flusso di lavoro deve supportare diversi formati Office.
Configurare il progetto C#
Create un'applicazione console C# e aggiungete al progetto Spire.Agent.Office e le sue dipendenze richieste. Avrete anche bisogno di un SpireToken valido per l'elaborazione AI.
L'esempio seguente supporta i seguenti formati:
- Word: DOC e DOCX
- Excel: XLS e XLSX
- PowerPoint: PPT e PPTX
Il PDF non è incluso in questo esempio.
Oscurare documenti Word, Excel e PowerPoint con un AI Agent
Il codice seguente determina il formato di origine dall'estensione, carica l'oggetto documento Office appropriato e passa la stessa istruzione di oscuramento al processore AI.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Presentation;
using Spire.Doc;
using Spire.Xls;

string inputPath = @"E:\Documents\Input.docx";
string outputPath = @"E:\Documents\Redacted.docx";
string spireToken = "your spireToken";

string instruction = """
Find personal information such as names, email addresses, phone numbers, addresses,
account numbers, and other sensitive information. Replace the detected content with
“[REDACTED]” while preserving the original document structure and formatting.
""";

// Configure the AI processing options
AIOptions options = new AIOptions();
options.SpireToken = spireToken;

// Select the appropriate document object according to the file extension
string extension = Path.GetExtension(inputPath).ToLower();

if (extension == ".doc" || extension == ".docx")
{
    using (Document document = new Document())
    {
        document.LoadFromFile(inputPath);
        AIDocumentProcessor processor = document.AI(options);
        processor.ExecuteInstruction(
            document,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".xls" || extension == ".xlsx")
{
    using (Workbook workbook = new Workbook())
    {
        workbook.LoadFromFile(inputPath);
        AIDocumentProcessor processor = workbook.AI(options);
        processor.ExecuteInstruction(
            workbook,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".ppt" || extension == ".pptx")
{
    using (Presentation presentation = new Presentation())
    {
        presentation.LoadFromFile(inputPath);
        AIDocumentProcessor processor = presentation.AI(options);
        processor.ExecuteInstruction(
            presentation,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
Se nel vostro progetto gli using globali impliciti sono disabilitati, aggiungete anche using System; e using System.IO; per Array e Path.
Definire input, output e istruzione
inputPath specifica il documento di origine, mentre outputPath specifica dove verrà salvato il file oscurato. Le estensioni di input e output dovrebbero corrispondere, in modo che il risultato rimanga nel formato originale.
L'istruzione in linguaggio naturale definisce sia l'ambito di rilevamento sia la modifica richiesta. In questo esempio, l'agente cerca i tipi più comuni di informazioni personali e li sostituisce con [REDACTED].
Potete adattare l'istruzione per un flusso di lavoro più ristretto. Ad esempio:
Find email addresses, phone numbers, and customer account numbers. Replace each detected value with “[REDACTED]”. Do not redact company names, product names, invoice numbers, or dates. Preserve the original layout and formatting.
Aggiungere esclusioni esplicite può ridurre i falsi positivi quando un documento contiene identificatori aziendali che assomigliano a numeri di conto personali.
Configurare l'elaborazione AI
AIOptions memorizza lo SpireToken utilizzato dal servizio di elaborazione AI:
AIOptions options = new AIOptions();
options.SpireToken = spireToken;
Lo stesso oggetto options può essere utilizzato con l'istanza di documento Word, Excel o PowerPoint.
Selezionare il tipo di documento appropriato
Il programma legge l'estensione del file e crea l'oggetto corrispondente:
-
Documentper i file Word -
Workbookper i file Excel -
Presentationper i file PowerPoint
Ogni oggetto espone il metodo di estensione AI(). Questo restituisce un AIDocumentProcessor, che esegue l'istruzione in linguaggio naturale sul documento caricato.
L'array di allegati vuoto indica che l'istruzione non richiede alcun file di supporto:
processor.ExecuteInstruction(
    document,
    instruction,
    outputPath,
    Array.Empty<string>());
Risultato dell'oscuramento
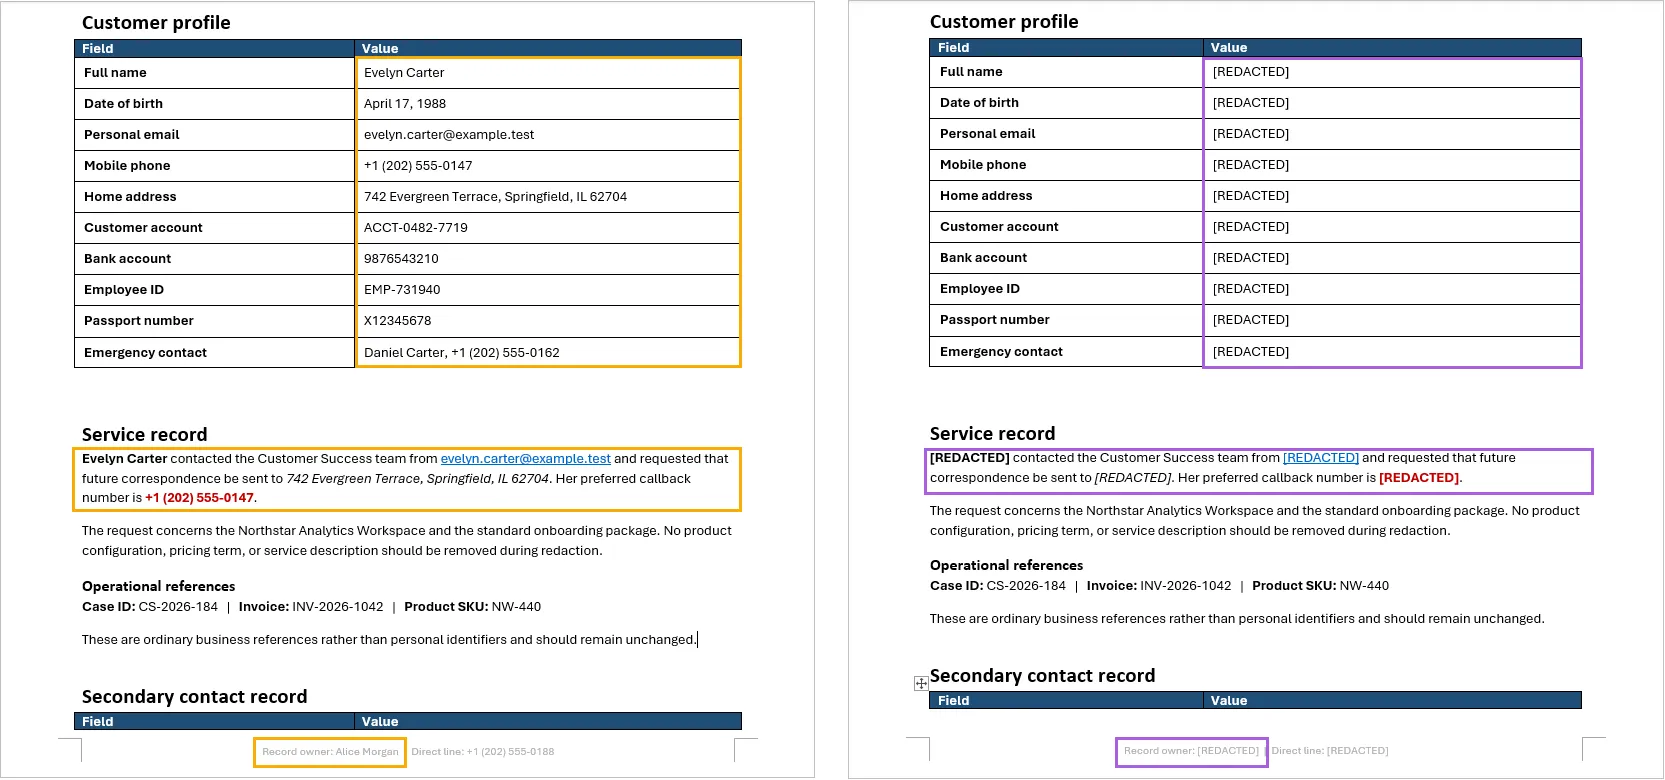
Nel documento Word di test, le informazioni sensibili comparivano in paragrafi normali, in una tabella di informazioni sul cliente e nel piè di pagina. Dopo l'elaborazione, i nomi, gli indirizzi email, i numeri di telefono, gli indirizzi e le informazioni sul conto sono stati sostituiti con [REDACTED].
La struttura della tabella, la formattazione dei paragrafi, i titoli, i colori e il layout del piè di pagina sono rimasti invariati. Questo risultato è importante perché dimostra che il flusso di lavoro non si limita a estrarre il documento come testo normale e a ricostruirlo da zero. Modifica gli elementi rilevanti del documento mantenendone la struttura circostante.
Considerazioni importanti sull'oscuramento tramite AI
Esaminate il risultato prima di condividerlo
L'oscuramento tramite AI non è perfettamente deterministico. Un modello può tralasciare un identificatore insolito o classificare erroneamente contenuti ordinari come sensibili. I documenti destinati alla distribuzione esterna dovrebbero essere esaminati dopo l'elaborazione, soprattutto nei flussi di lavoro legali, finanziari, sanitari o sensibili alla conformità.
Rendete l'istruzione specifica
L'istruzione dovrebbe descrivere sia ciò che deve essere rimosso sia ciò che deve rimanere. Se i numeri di fattura, i nomi delle aziende, i codici prodotto o gli indirizzi di uffici pubblici non devono essere oscurati, indicate esplicitamente tali esclusioni.
La sostituzione visibile non è sempre una sanificazione completa
Sostituire il testo visibile non rimuove necessariamente ogni copia dell'informazione dal file. I dati sensibili possono comparire anche in:
- Commenti e modifiche tracciate
- Proprietà e metadati del documento
- Fogli di lavoro nascosti o diapositive nascoste
- Note del relatore di PowerPoint
- File e oggetti incorporati
- Immagini contenenti testo
- Versioni precedenti o copie di backup
Per i flussi di lavoro ad alta sicurezza, queste posizioni dovrebbero essere ispezionate separatamente. Se un documento contiene pagine scansionate o screenshot, potrebbe essere necessario l'OCR prima che il testo all'interno delle immagini possa essere valutato.
Preservate il file originale
Salvate il risultato oscurato in un nuovo percorso invece di sovrascrivere il documento di origine. Mantenere i file separati facilita il confronto dell'output, l'indagine sui contenuti mancanti e la ripetizione del processo con un'istruzione migliorata.
Conclusione
L'oscuramento tradizionale basato su API offre un controllo preciso, ma gli sviluppatori devono definire regole di rilevamento e mantenere logiche di scansione separate per i diversi formati di documento e contenitori di contenuto. L'integrazione diretta con un LLM migliora il riconoscimento contestuale, ma richiede comunque un livello sostanziale di estrazione, mappatura e riscrittura per preservare la formattazione di Office.
Un AI Agent SDK riunisce queste capacità. Con una singola istruzione in linguaggio naturale e una piccola quantità di codice C#, lo stesso flusso di lavoro può elaborare file Word, Excel e PowerPoint, identificare informazioni sensibili contestuali e sostituirle all'interno della struttura originale del documento. Il risultato dovrebbe comunque essere esaminato, ma l'implementazione è notevolmente più semplice rispetto alla costruzione manuale dell'intera pipeline di rilevamento e orchestrazione dei documenti.
Domande frequenti
Lo stesso codice può oscurare file Word, Excel e PowerPoint?
Sì. L'esempio seleziona Document, Workbook o Presentation in base all'estensione del file di input e applica la stessa istruzione in linguaggio naturale a ciascun formato.
L'AI Agent preserva la formattazione originale?
L'agente lavora con gli oggetti sottostanti del documento Office, consentendo di sostituire il testo sensibile all'interno di paragrafi, celle, tabelle e forme mantenendo la struttura e la formattazione circostanti. Il risultato finale dovrebbe comunque essere verificato, poiché layout particolarmente complessi potrebbero richiedere una verifica aggiuntiva.
Posso usare un'etichetta di oscuramento diversa?
Sì. Cambiate [REDACTED] nell'istruzione con un'altra etichetta, ad esempio [PRIVATE], [REMOVED] o un valore specifico per categoria come [EMAIL REDACTED].
Quando un'API tradizionale è preferibile all'oscuramento tramite AI?
Un'API tradizionale può essere preferibile quando ogni valore sensibile segue uno schema fisso, le regole cambiano raramente e il risultato deve essere completamente deterministico. La sostituzione con espressioni regolari è spesso sufficiente per indirizzi email, numeri di telefono o numeri di identificazione standardizzati.
La sostituzione del testo garantisce che il documento sia sicuro da pubblicare?
No. La sostituzione del testo visibile non rimuove automaticamente commenti, modifiche tracciate, metadati, contenuti nascosti, oggetti incorporati, testo all'interno di immagini o versioni precedenti del file. I documenti sensibili alla sicurezza richiedono ispezioni e convalide aggiuntive prima della pubblicazione.