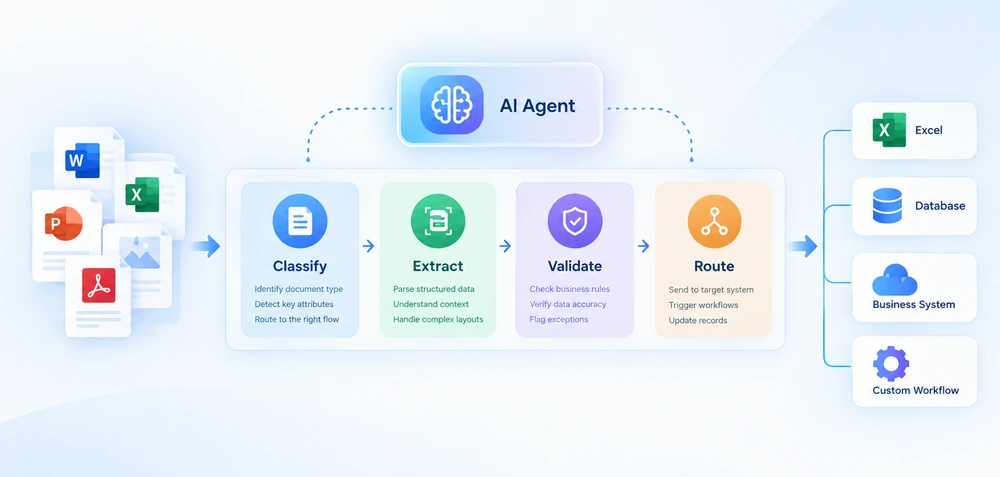
Le traitement intelligent des documents (IDP) combine la compréhension de documents par IA avec l'extraction, la validation et le traitement en aval automatisés. Pour les développeurs .NET, mettre en œuvre l'IDP signifie généralement relier la compréhension de documents par IA à du code déterministe qui gère les fichiers, les règles métier et l'intégration système.
Ce guide se concentre sur les workflows IDP pour les documents Office et PDF en .NET. Il couvre l'architecture du pipeline en quatre étapes, présente des modèles d'implémentation en C# et fournit un cadre de décision pour choisir entre un développement interne et l'adoption d'une plateforme tierce.
Navigation rapide
- Le pipeline IDP en quatre étapes
- Créer un pipeline IDP en .NET
- Traitement par lots et de documents multiples
- L'IDP en pratique
- Construire ou acheter : choisir une approche IDP
1. Qu'est-ce que le traitement intelligent des documents ?
Le traitement intelligent des documents est une approche d'automatisation qui utilise l'IA pour classer les documents, en extraire des données structurées, valider les résultats par rapport à des règles métier et acheminer la sortie vers les systèmes en aval. Contrairement à l'OCR traditionnel, qui convertit principalement le contenu visuel en texte lisible par machine, l'IDP ajoute la classification de documents, l'extraction sémantique, la validation et l'automatisation des workflows. Il peut gérer des mises en page variées sans dépendre entièrement de modèles fixes.
Un pipeline IDP pratique peut être organisé en quatre étapes : classer, extraire, valider et acheminer. Chaque étape a des entrées, des sorties et des modes de défaillance distincts. L'agent IA gère la classification et l'extraction grâce à la compréhension du langage naturel, tandis que la validation et l'acheminement restent du code déterministe qui applique les règles métier et s'intègre aux systèmes en aval.
IDP vs OCR, traitement de documents et intelligence documentaire
Ces termes sont souvent utilisés de manière interchangeable, mais ils décrivent des capacités différentes :
| Technologie | Rôle principal |
|---|---|
| OCR | Convertir le contenu visuel en texte |
| Traitement de documents | Lire, manipuler, convertir ou générer des fichiers |
| Intelligence documentaire | Comprendre le contenu d'un document et en extraire le sens |
| IDP | Combiner la compréhension des documents avec des workflows automatisés |
En pratique, ces capacités se chevauchent souvent. Un pipeline IDP peut recourir à l'OCR pour les documents numérisés, à l'IA pour la compréhension sémantique et à des API de traitement de documents pour les opérations déterministes sur les fichiers. La distinction importe pour l'architecture : savoir quelle couche assume quelle responsabilité détermine la façon dont vous construisez et maintenez le système.
L'IDP ne signifie pas remplacer l'intégralité du workflow par de l'IA. L'IA gère la compréhension et l'extraction ; le code déterministe gère la validation, l'acheminement, la manipulation des fichiers et l'intégration système. C'est cette séparation qui rend l'IDP maintenable en production — les règles métier changent plus souvent que les formats de documents, et vous voulez ces règles dans du code que vous contrôlez, pas dans un prompt de modèle.
2. Le pipeline IDP en quatre étapes
Un pipeline IDP n'est pas un simple appel d'API. C'est une séquence d'étapes, chacune ayant des entrées, des sorties et des modes de défaillance distincts. Comprendre cette architecture fait toute la différence entre construire un pipeline capable de gérer la diversité réelle des documents et écrire un script qui casse à la première entrée inattendue.
Un pipeline IDP pratique peut être organisé en quatre étapes :
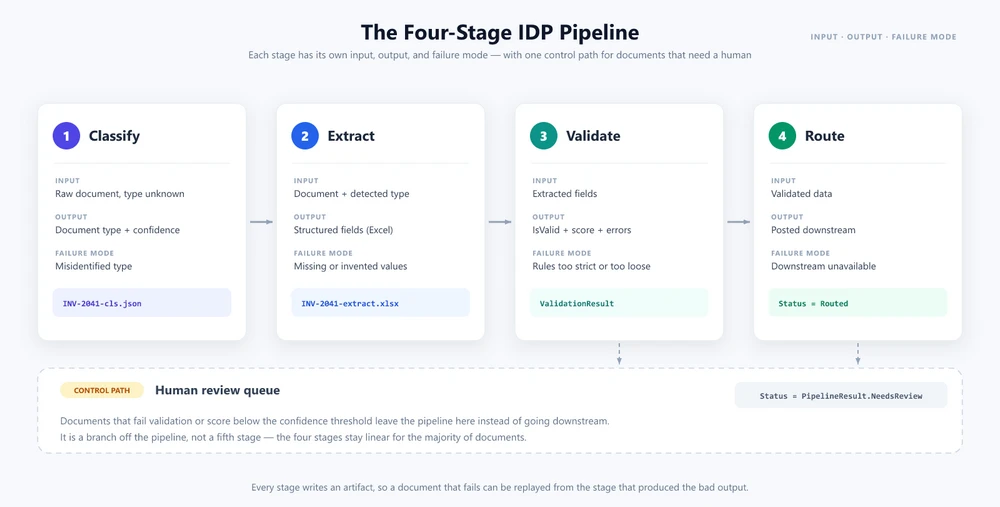
Étape 1 — Classification
Le pipeline reçoit un document de type inconnu. La classification détermine ce qu'est le document — une facture, un contrat, un bon de commande, un reçu, un relevé bancaire — et attache des métadonnées qui pilotent le comportement en aval. Dans un système traditionnel, la classification repose sur les conventions de nommage des fichiers, les chemins de dossiers ou la correspondance de modèles. Dans un pipeline piloté par l'IA, la classification utilise l'analyse en langage naturel : l'agent lit le contenu du document et détermine son type à partir d'une compréhension sémantique.
Étape 2 — Extraction
Une fois le type de document connu, l'extraction récupère les données structurées du document. Pour une facture, cela signifie le nom du fournisseur, le numéro de facture, les lignes d'articles, les totaux, les montants de taxe, les conditions de paiement. Pour un contrat, cela signifie les parties, les dates d'entrée en vigueur, les clauses de résiliation, les obligations financières. L'étape d'extraction transforme le contenu non structuré ou semi-structuré du document en un format structuré (JSON, XML, enregistrements de base de données) que les systèmes en aval peuvent exploiter.
Étape 3 — Validation
Les données extraites sont vérifiées par rapport aux règles métier. Le total de la facture correspond-il à la somme des lignes d'articles ? Le fournisseur figure-t-il dans la liste des fournisseurs approuvés ? Le contrat est-il signé par un signataire autorisé ? La validation détecte les erreurs d'extraction, signale les anomalies et produit un score de confiance qui détermine si le document peut être acheminé automatiquement ou nécessite une révision humaine.
Étape 4 — Acheminement
Les données validées sont envoyées au système en aval approprié : un ERP pour les données de facture, une plateforme de gestion des contrats pour les données de contrat, une archive documentaire pour tout le reste. L'acheminement peut également déclencher des workflows en aval — chaînes d'approbation, traitement des paiements, contrôles de conformité.
La révision humaine est un chemin de contrôle plutôt qu'une étape obligatoire : les documents qui échouent à la validation ou qui passent sous un seuil de confiance peuvent être acheminés vers une révision manuelle. Cela maintient le pipeline en quatre étapes linéaire pour la majorité des documents tout en offrant un repli contrôlé pour les cas limites.
Pourquoi l'IDP nécessite plus qu'un appel d'API IA
Chaque étape a des modes de défaillance indépendants. La classification peut mal identifier un type de document. L'extraction peut manquer des champs ou halluciner des valeurs. La validation peut rejeter des données valides à cause de règles trop strictes. L'acheminement peut échouer en raison de l'indisponibilité d'un système en aval. Un pipeline IDP robuste gère chaque mode de défaillance indépendamment, avec une logique de nouvelle tentative, un comportement de repli et une journalisation d'audit à chaque étape.
3. Créer un pipeline IDP en .NET
Une façon de mettre en œuvre cette architecture en .NET consiste à utiliser Spire.Agent.Office, un SDK d'agent IA qui traite les documents Word, Excel, PowerPoint et PDF via des instructions en langage naturel. Le SDK fournit la méthode d'extension AI() sur les objets document (Document, PdfDocument, Workbook, Presentation), qui accepte une configuration AIOptions et renvoie un AIDocumentProcessor. L'appel de ExecuteInstruction sur le processeur exécute l'instruction et écrit la sortie dans un fichier, en renvoyant un AIResult avec les propriétés Success et ErrorMessage.
Prérequis
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Les exemples ci-dessous se concentrent sur l'architecture du pipeline et l'intégration de Spire.Agent.Office. Les méthodes auxiliaires telles que l'analyse des résultats et l'acheminement en aval sont omises par souci de concision.
3.1 Définir le modèle du pipeline
Le pipeline a besoin de structures de données pour transporter les résultats entre les étapes, et d'une configuration partagée pour l'agent IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken sert à authentifier Spire.Agent.Office. Le SDK gère la connexion au service d'IA via AIOptions, de sorte que l'application n'a pas besoin d'implémenter directement l'intégration de l'API du modèle sous-jacent. WorkDir désigne l'emplacement où l'agent stocke les fichiers intermédiaires pendant le traitement.
3.2 Classer et extraire des documents avec un agent IA
La classification charge le document, demande à l'agent d'identifier son type et écrit le résultat dans un fichier JSON. Le même schéma LoadFromFile → AI(options) → ExecuteInstruction fonctionne pour chaque format de document — seule la classe de document change, et c'est à vous d'écrire cette répartition. AI() se lie à un type de document concret : un PDF doit être chargé en tant que PdfDocument, un classeur en tant que Workbook, une présentation en tant que Presentation, et un fichier Word en tant que Document. Transmettre un fichier à la mauvaise classe ne bascule pas vers un lecteur générique ; cela lève une exception, donc choisissez la classe à partir de l'extension du fichier avant d'appeler AI().
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
L'extraction utilise des instructions propres à chaque type pour récupérer des champs structurés depuis le document :
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
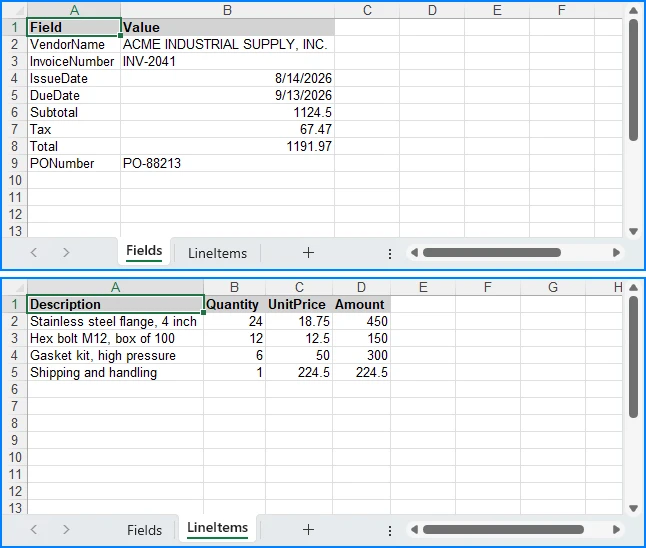
Chaque type de document reçoit une instruction dédiée qui indique à l'agent quels champs rechercher et quel format de sortie produire. L'agent lit le document source et écrit un classeur Excel structuré dans extractPath. C'est l'instruction qui fixe la forme de ce classeur — nommer les feuilles, les en-têtes et les noms de champs exacts est ce qui rend la sortie exploitable en aval. Une instruction qui se contente de dire « extraire les champs de la facture » peut revenir avec un nom de feuille différent, une ligne d'en-tête différente ou une orthographe différente pour le même champ à chaque exécution, car c'est l'agent qui décide de la mise en page. GetField, dans la section suivante, couvre les variations qui passent malgré tout.
Cette séparation entre le jugement de l'agent et le code déterministe est approfondie dans AI Agent for Document Processing.
3.3 Valider les données extraites avec C#
La validation est une pure logique C# — aucun appel d'IA n'est nécessaire. L'agent a déjà produit des données structurées ; la validation vérifie ces données par rapport aux règles métier.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
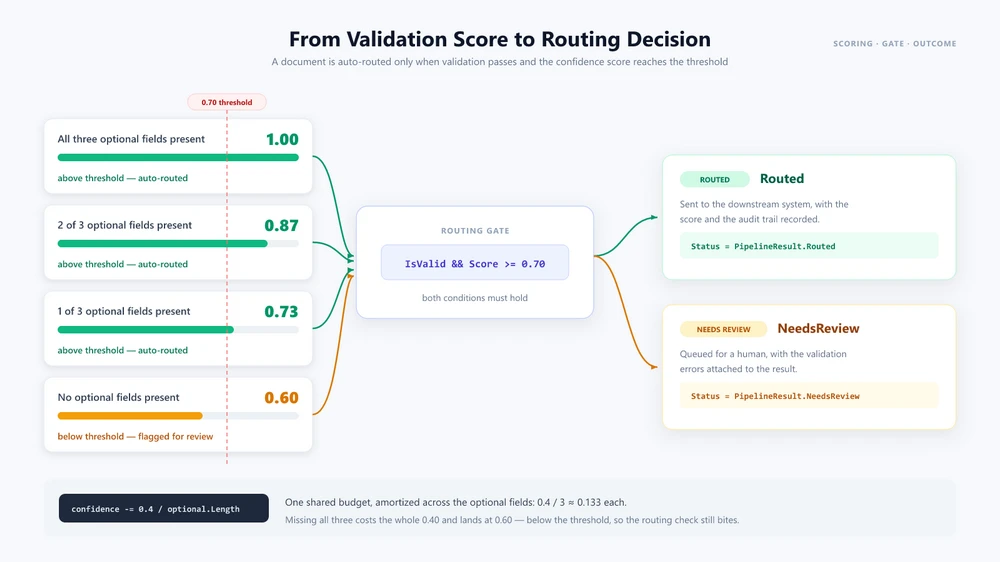
La validation distingue les échecs bloquants des avertissements de qualité. Un champ obligatoire manquant, un total qui ne se réconcilie pas avec les lignes d'articles ou un type de document sans règles génère une entrée dans Errors, et le document est considéré comme non valide. Un champ facultatif qui n'a pas pu être extrait ne fait que baisser ValidationScore, de sorte qu'un document par ailleurs correct est tout de même acheminé. La déduction est un budget fixe partagé entre les champs facultatifs plutôt qu'une pénalité forfaitaire par champ : avec trois champs facultatifs et le budget de 0,4 du code ci-dessus, un champ manquant laisse le score à 0,87 et deux le laissent à 0,73 — encore au-dessus du seuil d'acheminement automatique de 0,7 — si bien que seule la perte des trois le fait tomber à 0,60 et envoie le document en révision. C'est en gardant ces deux signaux séparés que l'on réserve la révision humaine aux documents qui en ont réellement besoin.
3.4 Orchestrer le pipeline
La méthode d'orchestration relie les étapes entre elles et prend les décisions d'acheminement en fonction de la confiance de la validation :
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Chaque étape est testable indépendamment, dispose de sa propre gestion des erreurs et produit une sortie d'audit. Le PipelineResult renvoyé consigne également le résultat de l'étape 4 dans Status, ce qui permet au rapport par lots de la section suivante de compter les documents par résultat au lieu de le redériver à partir de la charge utile de validation. Dans cet exemple, l'agent IA gère la classification et l'extraction via des instructions en langage naturel, tandis que la validation et l'acheminement restent une logique C# déterministe.
4. Traitement par lots et de documents multiples
Un pipeline mono-document n'est qu'un point de départ. Les systèmes IDP de production traitent des centaines ou des milliers de documents par jour, avec des types, des priorités et des destinations en aval variés.
Traitement par lots en parallèle
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
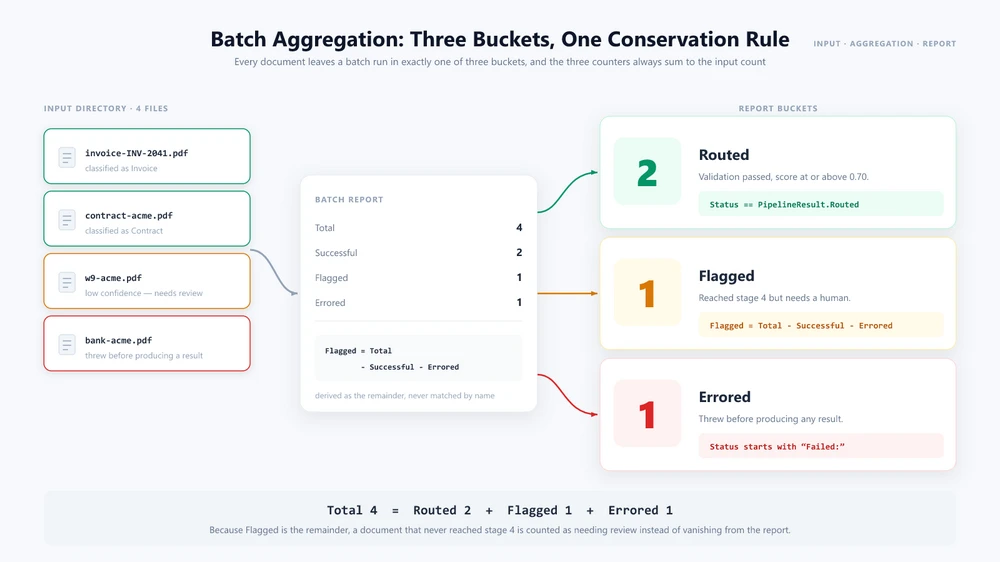
Le SemaphoreSlim limite la concurrence afin de ne pas submerger le service d'IA ou les systèmes en aval. Chaque document est traité indépendamment à travers les quatre étapes. Le rapport par lots classe les résultats selon les trois façons dont un document peut sortir du pipeline : Routed (validé et envoyé en aval), Flagged (arrivé à l'étape 4 mais nécessitant une révision) et Errored (a levé une exception avant de produire un résultat). Flagged est calculé comme le reste plutôt qu'en faisant correspondre une chaîne de statut, de sorte que les trois compteurs totalisent toujours Total — un document qui échoue de manière inattendue est signalé comme nécessitant une révision au lieu de disparaître du rapport. La limite de concurrence appropriée dépend des limites de débit du service d'IA, de la taille des documents et des ressources de l'application.
Workflows multi-documents
Certains processus métier exigent que plusieurs documents soient traités ensemble. Un workflow d'intégration de fournisseur américain, par exemple, pourrait traiter un formulaire fiscal, un contrat et un relevé bancaire comme une seule unité — en extrayant les données de chacun, en les recoupant et en produisant une sortie combinée.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
Le paramètre attachments transmet plusieurs chemins de documents à l'agent en un seul appel. L'agent lit tous les fichiers joints, raisonne à leur sujet et produit une sortie combinée. Cela va au-delà du rôle de reconnaissance de texte de l'OCR traditionnel en permettant à un modèle d'IA de raisonner sur plusieurs entrées documentaires.
Nouvelles tentatives et révision humaine
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
Les documents qui échouent à la validation ou qui passent sous le seuil de confiance sont signalés pour révision humaine plutôt que d'échouer silencieusement. La stratégie de nouvelle tentative utilise un backoff exponentiel pour les erreurs transitoires et retente les cas limites au cas où une seconde passe les classerait ou les extrairait différemment.
5. L'IDP en pratique
Cette section montre comment le pipeline gère des scénarios métier réels impliquant plusieurs types de documents dans un même workflow.
Automatisation des comptes fournisseurs
Un service comptable reçoit des factures dans des formats mixtes — PDF, Excel, Word, images numérisées. Chaque facture doit être classée, extraite, validée par rapport à un bon de commande et acheminée vers le système ERP.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
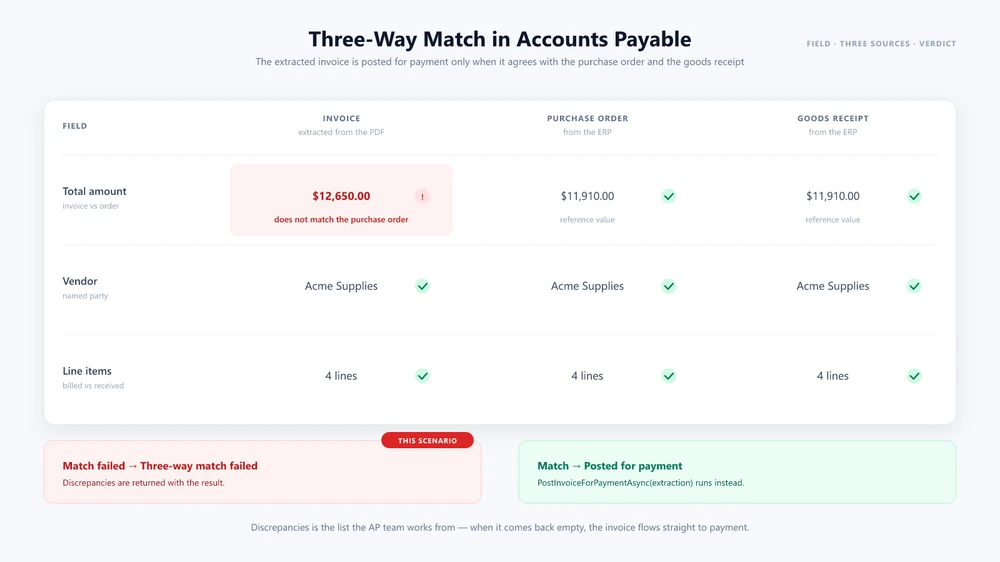
Le tutoriel de traitement des factures couvre ce scénario de bout en bout : l'instruction d'extraction, la comparaison avec le bon de commande et le rapport que consomme le système financier.
Analyse de contrats
Un service juridique reçoit des contrats de parties externes. Chaque contrat doit être analysé, ses clauses clés extraites, comparé au modèle standard de l'entreprise et acheminé pour révision si des clauses non standard sont détectées. L'agent traite le contrat entrant avec le modèle standard joint comme document de référence.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Ce workflow combine extraction, comparaison multi-documents et génération de documents dans un seul processus, illustrant comment un agent IA peut étendre un pipeline IDP traditionnel au-delà de l'extraction de champs structurés. Les schémas propres aux contrats — révision, extraction et génération à partir d'un modèle — sont couverts dans le guide de révision de contrats par IA.
6. Construire ou acheter : choisir une approche IDP
Le marché de l'IDP est dominé par les plateformes SaaS. Cette section aide les développeurs à décider quand construire un pipeline en .NET est le bon choix et quand adopter une plateforme tierce est plus pratique.
Construisez lorsque vous avez besoin d'une intégration étroite avec une application .NET existante, de règles de validation personnalisées, ou de génération et de transformation de documents en complément de l'extraction. Construire la couche d'orchestration en .NET vous donne un meilleur contrôle sur l'emplacement de stockage des documents et sur la façon dont ils sont traités. La localisation réelle des données dépend du modèle d'IA et de la configuration du service.
Achetez lorsque les charges de travail à forte composante OCR, les modèles d'extraction prêts à l'emploi, l'infrastructure gérée ou un déploiement rapide sont prioritaires. Si votre équipe ne possède pas l'expertise .NET ou se concentre sur d'autres priorités, une plateforme gérée supprime la charge de mise en œuvre.
Cadre de décision :
| Facteur | Construire (.NET + agent IA) | Acheter (IDP SaaS) |
|---|---|---|
| Intégration | En cours de processus, natif .NET | Appel d'API externe |
| Localisation des données | Dépend de la configuration du modèle | Cloud du fournisseur |
| Opérations documentaires | Extraire + générer + transformer + convertir | Dépend de la plateforme |
| Validation personnalisée | Contrôle total du code | Configuration de la plateforme |
| Workflow personnalisé | Contrôle total du code | Dépend de la plateforme |
| Délai de mise en production | Semaines à mois | Jours à semaines |
| Modèle de coût | Coût d'API fixe + licence SDK | Tarification par document |
Le bon choix dépend des exigences de votre application, des compétences de votre équipe et des types de documents que vous traitez. De nombreuses équipes adoptent une approche hybride : une plateforme tierce pour l'extraction à gros volume de formulaires standardisés, et un pipeline .NET personnalisé pour les workflows complexes qui nécessitent de la génération de documents, un raisonnement multi-documents ou une intégration système étroite.
7. Questions fréquentes
Qu'est-ce que le traitement intelligent des documents (IDP) ?
Le traitement intelligent des documents est une approche d'automatisation qui utilise l'IA et l'apprentissage automatique pour classer les documents, extraire des données structurées, valider les résultats par rapport à des règles métier et acheminer la sortie vers les systèmes en aval. Contrairement à l'OCR traditionnel, qui convertit principalement le contenu visuel en texte lisible par machine, l'IDP ajoute la classification de documents, l'extraction sémantique, la validation et l'automatisation des workflows. Il peut gérer des mises en page variées sans dépendre entièrement de modèles fixes.
En quoi un pipeline IDP diffère-t-il d'un simple appel d'API LLM ?
Un simple appel LLM traite du texte mais ne gère ni les formats de fichiers, ni l'exécution d'opérations documentaires, ni l'état du pipeline. Un pipeline IDP orchestre plusieurs étapes — classification, extraction, validation, acheminement — chacune avec une gestion des erreurs, une logique de nouvelle tentative et une journalisation d'audit indépendantes. Le pipeline fait également le lien entre le raisonnement de l'IA et la manipulation déterministe des fichiers, garantissant que la sortie conserve un formatage correct.
Puis-je construire un pipeline IDP sans plateforme tierce ?
Oui. En utilisant un SDK d'agent IA .NET comme Spire.Agent.Office, vous pouvez implémenter les quatre étapes du pipeline en C#. Le SDK fournit le traitement de documents en langage naturel pour les fichiers Word, Excel, PowerPoint et PDF, avec une sortie de fichiers déterministe. Cette approche donne un contrôle total sur la logique de validation et les règles d'acheminement.
Quels formats de documents un pipeline IDP gère-t-il ?
Avec Spire.Agent.Office, le pipeline gère les fichiers Word (.docx, .doc), Excel (.xlsx, .xls), PowerPoint (.pptx, .ppt) et PDF. Les documents numérisés peuvent nécessiter une étape OCR avant l'extraction par IA, selon le document et le workflow de traitement. Le pipeline peut également convertir entre formats dans le cadre de l'étape d'acheminement.
Comment l'agent IA se connecte-t-il au modèle de langage ?
Spire.Agent.Office utilise une propriété SpireToken dans AIOptions pour s'authentifier auprès du service d'IA. Le SDK gère la connexion au service d'IA via AIOptions, de sorte que l'application n'a pas besoin d'implémenter directement l'intégration de l'API du modèle sous-jacent. Cette conception sépare le traitement des documents de la configuration du modèle, de sorte que le code de votre pipeline reste identique quel que soit le modèle qui alimente l'agent.
Quelle est la précision de l'extraction de documents par IA ?
La précision de l'extraction dépend fortement de la qualité des documents, de la variabilité des mises en page, de la qualité de l'OCR, du comportement du modèle et des instructions d'extraction. Les systèmes de production doivent valider les valeurs extraites par rapport à des règles métier déterministes et acheminer les cas incertains vers une révision humaine. L'étape de validation aide à rendre l'extraction par IA plus fiable en production en vérifiant les valeurs extraites par rapport à des règles déterministes et en acheminant les résultats incertains vers une révision.
Quelle est la différence entre l'IDP et l'OCR ?
L'OCR (reconnaissance optique de caractères) convertit le contenu visuel d'un document en texte lisible par machine. L'IDP s'appuie sur cette capacité mais ajoute une compréhension pilotée par l'IA, la validation et l'automatisation des workflows. Un pipeline IDP peut utiliser l'OCR en interne pour les documents numérisés, mais l'OCR seul ne classe pas les documents, ne valide pas les données extraites et n'achemine pas les résultats vers les systèmes en aval.
Comment fonctionne le traitement par lots dans un pipeline IDP ?
Le traitement par lots exécute le pipeline simultanément sur plusieurs documents, avec des limites de concurrence configurables pour gérer l'utilisation des ressources. Chaque document est traité indépendamment à travers les quatre étapes, les résultats étant agrégés dans un rapport par lots. Les documents en échec sont signalés pour révision sans bloquer le reste du lot.
Prêt à construire un pipeline IDP ?
Si vous mettez en place un traitement intelligent des documents dans une application .NET, commencez par le guide de démarrage de Spire.Agent.Office, qui couvre l'installation du SDK et l'exécution de votre première instruction en .NET.
Pour aller plus loin
- AI Agent vs. Raw LLM API: Document Layer in .NET — ce qu'une couche documentaire apporte par rapport à un simple appel d'API LLM, et dans quels cas chaque approche convient
- Turn Documents into PowerPoint Presentations with AI in C# — le même schéma piloté par instructions appliqué à la production de diapositives