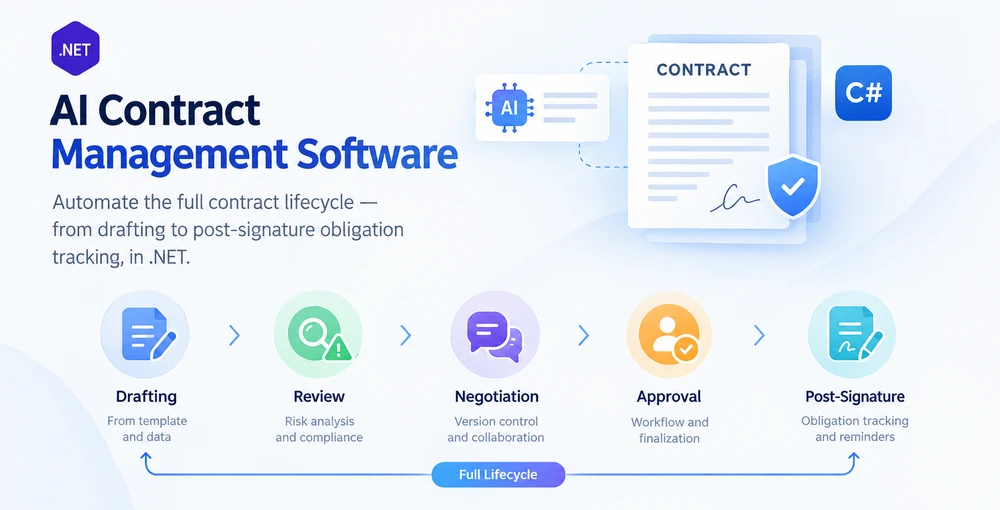
Logiciel de gestion des contrats par IA automatise l'ensemble du cycle de vie du contrat — de la rédaction à la révision, la négociation, l'approbation, la finalisation et le suivi des obligations post-signature — en combinant la compréhension du langage par l'IA avec un traitement déterministe des documents au sein d'une application .NET. La différence avec l'automatisation de tâches contractuelles isolées réside dans la portée du cycle de vie : un outil de révision de contrat signale les clauses à risque ; un système de gestion des contrats fait progresser un accord à travers chaque étape, maintient une piste d'audit à travers les versions et suit les obligations après la signature.
Spire.Agent.Office est un SDK d'agent IA documentaire qui fournit à la fois la compréhension du langage et la couche de traitement de documents. Cet article montre comment construire un système de gestion du cycle de vie des contrats en C# qui enchaîne cinq étapes en un seul pipeline, avec isolation des erreurs par étape, répartition des formats pour PDF et Word, et suivi approprié des statuts — des modèles que les exemples de tâches isolées n'abordent pas.
Cet article présente une implémentation de référence d'un pipeline de cycle de vie des contrats assisté par IA en .NET. Un système CLM de production nécessiterait en plus la persistance des flux de travail, le contrôle des identités et des accès, l'intégration de signature électronique, le stockage des documents et la rétention des versions, les notifications et l'infrastructure d'audit.
1. Le cycle de vie du contrat : cinq étapes où l'IA intervient
Le cycle de vie d'un contrat n'est pas une simple opération sur un document. C'est une séquence d'étapes, chacune avec des entrées, des sorties et des modes de défaillance distincts. Comprendre où l'IA apporte de la valeur à chaque étape — et où le code déterministe doit tenir bon — est la fondation d'un système qui tient en production.
| Étape | Ce qui se passe | Rôle de l'IA | Rôle du code déterministe |
|---|---|---|---|
| Rédaction | Générer un contrat à partir d'un modèle et de données structurées | Interpréter la demande, sélectionner et remplir les champs du modèle | Charger le modèle, préserver la mise en forme, enregistrer au format .docx ou .pdf
|
| Révision | Lire le contrat, signaler les clauses à risque, extraire les termes clés | Analyse sémantique du langage des clauses, notation des risques | Rédiger un rapport de révision structuré, appliquer la liste de contrôle de révision |
| Négociation | Comparer les versions, suivre les modifications, fusionner les changements | Résumer les écarts, signaler les changements de fond par rapport aux changements de forme | Activer/désactiver le suivi des modifications, comparer les documents, accepter/rejeter les révisions |
| Approbation | Acheminer vers les parties prenantes, recueillir les approbations | Suggérer des approbateurs en fonction du type et de la valeur du contrat | Appliquer les règles d'acheminement, enregistrer la piste d'audit, produire une copie finalisée |
| Post-signature | Suivre les obligations, les échéances, les renouvellements | Extraire les obligations et les dates clés du contrat finalisé | Stocker les métadonnées structurées, déclencher des rappels, générer des rapports |
Le cycle de vie n'est pas linéaire en pratique — la négociation revient à la révision, les avenants redémarrent la rédaction — mais l'architecture du pipeline gère cela par un routage d'étapes plutôt que par une séquence fixe.
Ce qui le distingue de la simple révision de contrat
L'automatisation de la révision de contrat — sujet de Révision de contrat par IA en C# — couvre une étape : lire un accord et signaler les problèmes. Un système de gestion des contrats doit :
- Enchaîner les étapes avec les données circulant de l'une à l'autre (la sortie de la rédaction devient l'entrée de la révision).
-
Gérer plusieurs formats de documents — les modèles arrivent en
.docx, les contreparties peuvent envoyer des.pdf, et les étapes avec répartition des formats gèrent les deux sans lever d'exception. - Maintenir l'état à travers les étapes — le statut de révision d'un contrat, le nombre de versions de négociation et la chaîne d'approbation doivent persister entre les exécutions du pipeline.
- Isoler les défaillances par contrat — un fichier corrompu dans un lot de 200 ne doit pas arrêter tout le pipeline.
Ces exigences façonnent l'architecture ci-dessous.
2. Architecture système pour l'automatisation du cycle de vie des contrats
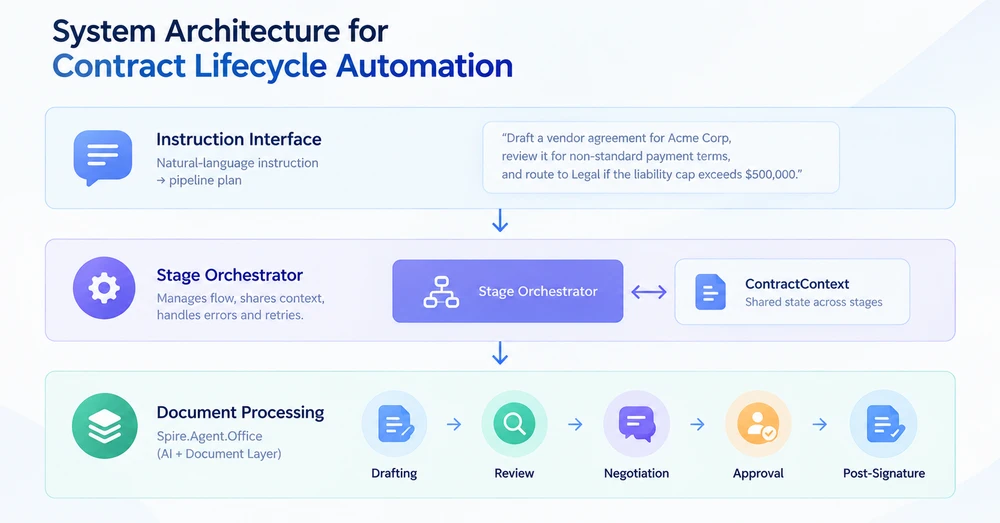
Un système de gestion du cycle de vie des contrats comporte trois couches. Chaque couche a une responsabilité spécifique, et les frontières entre elles sont là où les défaillances de production sont soit interceptées, soit passent inaperçues.
Couche 1 : Interface d'instruction
Le point d'entrée est une instruction en langage naturel qui décrit le résultat souhaité — pas les étapes mécaniques. "Rédige un contrat fournisseur pour Acme Corp en utilisant le modèle standard, révise-le pour les conditions de paiement non standard, et achemine-le vers le service juridique si le plafond de responsabilité dépasse 500 000 $." La couche d'instruction analyse cela en un plan de pipeline : quelles étapes exécuter, dans quel ordre, et quels paramètres chaque étape nécessite.
Couche 2 : Orchestrateur d'étapes
L'orchestrateur gère le flux entre les étapes. Il détient un objet partagé ContractContext qui transporte les métadonnées du contrat, le document courant et les résultats d'étape d'une étape à l'autre. Chaque étape reçoit le contexte, effectue son opération et renvoie un contexte mis à jour ainsi qu'un résultat d'étape. L'orchestrateur décide s'il faut continuer, réessayer ou acheminer vers un gestionnaire d'exceptions en fonction du résultat.
Couche 3 : Traitement des documents
Chaque étape appelle Spire.Agent.Office pour effectuer l'opération documentaire réelle. L'agent gère le raisonnement IA (compréhension de l'instruction, extraction d'informations) et la couche documentaire gère les opérations sur les fichiers (chargement, modification, enregistrement). La répartition des formats est appliquée aux étapes où plusieurs formats de documents sont attendus : une entrée .pdf utilise PdfDocument, tandis qu'une entrée .docx utilise Document.
Le contexte du contrat
L'objet d'état partagé qui traverse le pipeline :
/// <summary>
/// Shared state that flows through every lifecycle stage.
/// Each stage reads from and writes to this context.
/// </summary>
public class ContractContext
{
    // Identity
    public string ContractId { get; set; } = string.Empty;
    public string ContractType { get; set; } = string.Empty;  // "NDA", "MSA", "Vendor", etc.

    // Document state
    public string CurrentFilePath { get; set; } = string.Empty;
    public string WorkDir { get; set; } = string.Empty;
    public int VersionNumber { get; set; } = 1;

    // Stage results
    public DraftResult? Draft { get; set; }
    public ReviewResult? Review { get; set; }
    public NegotiationResult? Negotiation { get; set; }
    public ApprovalResult? Approval { get; set; }
    public ObligationResult? Obligations { get; set; }

    // Pipeline metadata
    public string Status { get; set; } = PipelineStages.Pending;
    public List<string> StageLog { get; set; } = new();
    public string? ErrorMessage { get; set; }
}

/// <summary>
/// Stage status constants. Using named constants instead of raw strings
/// prevents the "Status never set" bug where results fall through all
/// reporting buckets and silently disappear from batch summaries.
/// </summary>
public static class PipelineStages
{
    public const string Pending    = "Pending";
    public const string Drafted    = "Drafted";
    public const string Reviewed   = "Reviewed";
    public const string Negotiated = "Negotiated";
    public const string Approved   = "Approved";
    public const string Executed   = "Executed"; // In this sample: finalized post-approval PDF, not e-signature
    public const string Monitored  = "Monitored";
    public const string Failed     = "Failed";
    public const string NeedsReview = "NeedsReview";
}
Le champ Status utilise des constantes nommées plutôt que des chaînes brutes. Cela évite un mode de défaillance courant où le statut n'est jamais explicitement défini, ce qui fait que les documents tombent à travers tous les compartiments de rapport et disparaissent des résumés de lots.
3. Étape 1 : Rédaction à partir d'un modèle et de données
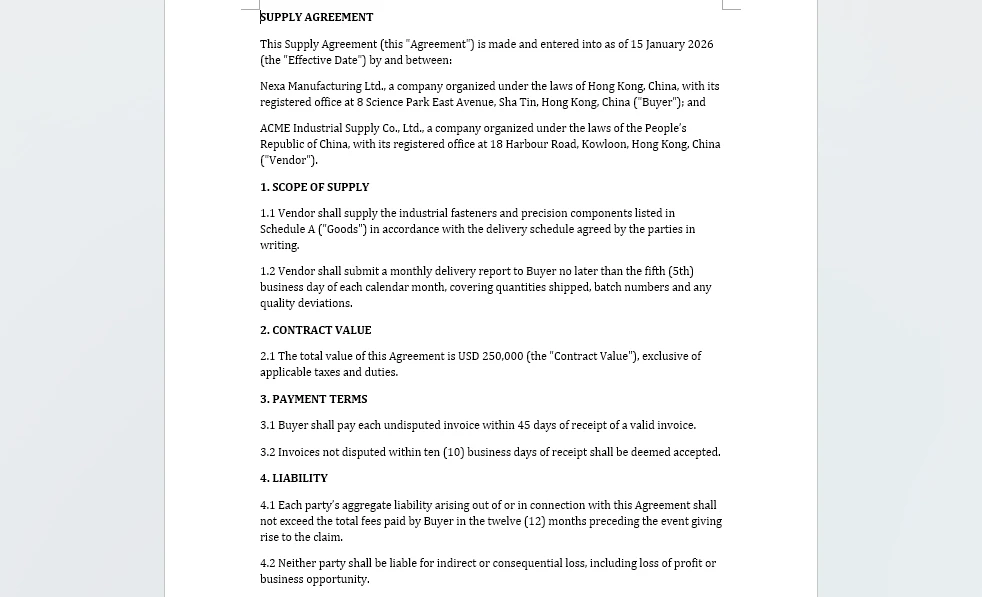
L'étape de rédaction prend un modèle (.docx avec des marqueurs {{Placeholder}}) et une source de données (feuille de calcul Excel ou entrée structurée), puis produit un contrat rempli. L'agent IA lit la structure du modèle et remplit les espaces réservés avec les données de la source — une seule instruction remplace le code de mappage de champs qu'un SDK traditionnel nécessite.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;

public class DraftResult
{
    public string OutputPath { get; set; } = string.Empty;
    public int ContractsGenerated { get; set; }
    public List<string> PlaceholdersFilled { get; set; } = new();
}

public class DraftingStage
{
    private readonly AIOptions _options;

    public DraftingStage(AIOptions options) => _options = options;

    public DraftResult Execute(ContractContext context, string templatePath, string dataSourcePath)
    {
        // Format dispatch: verify the template is .docx before loading
        if (!templatePath.EndsWith(".docx", StringComparison.OrdinalIgnoreCase))
            throw new NotSupportedException(
                $"Drafting requires a .docx template. Received: {templatePath}");

        string[] attachments = { dataSourcePath };

        using (Document template = new Document())
        {
            template.LoadFromFile(templatePath);

            string draftPath = Path.Combine(context.WorkDir, $"{context.ContractId}-v1-draft.docx");

            string draftInstruction =
                "Read the data source and fill every {{Placeholder}} field in this template " +
                "with the corresponding data. Preserve the template's layout, styling, and " +
                "clause numbering. Save the completed contract to: " +
                $"{draftPath}. Contract type: {context.ContractType}.";

            AIResult result = template.AI(_options).ExecuteInstruction(
                template, draftInstruction, draftPath, attachments);

            if (result == null || !result.Success)
                throw new InvalidOperationException(
                    $"Drafting failed: {result?.ErrorMessage ?? "Unknown error"}");

            // Collect the generated file: prefer the explicit output path,
            // fall back to AIResult.OutputFiles (unreliable for some product types).
            string? generated = File.Exists(draftPath)
                ? draftPath
                : result.OutputFiles?.FirstOrDefault(p => File.Exists(p));

            if (generated == null)
                throw new InvalidOperationException(
                    "Drafting completed but no output file was found (neither at the requested " +
                    $"path '{draftPath}' nor in AIResult.OutputFiles).");

            context.CurrentFilePath = generated;
            context.VersionNumber = 1;
            context.Status = PipelineStages.Drafted;
            context.StageLog.Add($"Draft: generated contract at {generated}");

            return new DraftResult
            {
                OutputPath = generated,
                ContractsGenerated = 1,
                PlaceholdersFilled = ExtractPlaceholderNames(templatePath)
            };
        }
    }

    private static List<string> ExtractPlaceholderNames(string templatePath)
    {
        // Quick scan of the template for {{...}} markers to report what was filled
        var placeholders = new List<string>();
        using (Document doc = new Document())
        {
            doc.LoadFromFile(templatePath);
            string text = doc.GetText();
            var matches = System.Text.RegularExpressions.Regex.Matches(
                text, @"\{\{(\w+)\}\}");
            foreach (System.Text.RegularExpressions.Match m in matches)
                if (!placeholders.Contains(m.Groups[1].Value))
                    placeholders.Add(m.Groups[1].Value);
        }
        return placeholders;
    }
}
Appels API clés
-
Document.LoadFromFile()— charge le modèle.docxavec les espaces réservés -
template.AI(_options)— attache le processeur de documents IA -
ExecuteInstruction(doc, instruction, outputPath, attachments)— remplit les espaces réservés à partir de la source de données ; passez un chemin absolu explicite pour que l'agent écrive le produit à un emplacement connu - Collecte du produit : vérifiez d'abord
File.Exists(outputPath);AIResult.OutputFilesn'est pas fiable pour certains types de produits et ne doit être utilisé qu'en dernier recours
Répartition des formats
L'étape valide le format d'entrée avant le traitement. Un modèle .pdf ou un format non pris en charge est rejeté explicitement avec un message clair, plutôt que d'échouer à l'intérieur de l'agent avec une exception opaque. Ce modèle évite un mode de défaillance courant où l'absence de répartition des formats provoque des exceptions non gérées pour les entrées PDF au plus profond du pipeline de traitement.
Rédiger un seul contrat est le cas simple. Lorsque le même modèle doit être rempli pour des dizaines d'enregistrements — nouvelles embauches, fournisseurs, renouvellements — le modèle d'instruction s'adapte à la sortie par lots sans changement ; Génération de contrats par lots avec Spire.Agent.Office couvre à la fois la fusion et la publication et la voie de remplacement des espaces réservés, et compare où chacune convient.
Note SDK : Lorsqu'un
outputPathexplicite est passé àExecuteInstruction, le SDK peut également écrire une copieoutput-<filename>dans le même répertoire. Ce doublon a un contenu identique et peut être supprimé en toute sécurité après le traitement. Toutes les étapes qui spécifient des chemins de sortie sont concernées.
Le produit de cette étape est le document rempli lui-même — le modèle de contrat fournisseur avec chaque espace réservé remplacé à partir du classeur principal des fournisseurs.
4. Étape 2 : Révision et analyse des risques
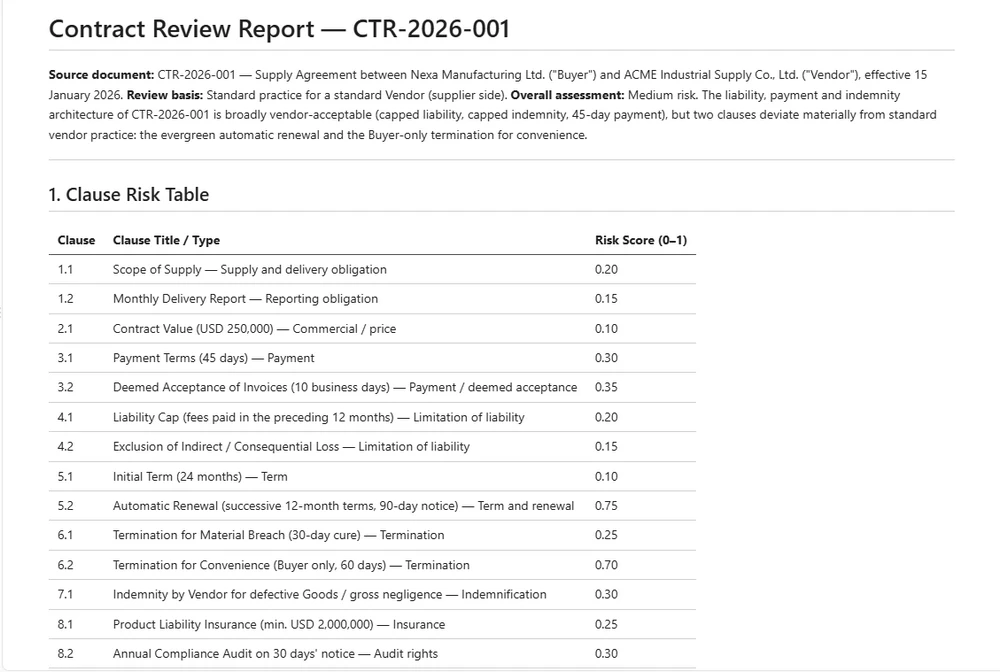
L'étape de révision lit le contrat rédigé, identifie les clauses risquées ou non standard, et produit un rapport de révision structuré. Contrairement à l'étape de rédaction, l'entrée peut être .docx (brouillon interne) ou .pdf (document de la contrepartie), de sorte que l'étape doit dispatcher vers le type de document correct.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;

public class ReviewResult
{
    public string ReportPath { get; set; } = string.Empty;
    public int ClausesAnalyzed { get; set; }
    public int RiskFlags { get; set; }
    public double RiskScore { get; set; }     // ratio of flagged clauses to total (0.0 = none flagged, 1.0 = all flagged)
    public List<string> FlaggedClauses { get; set; } = new();
}

public class ReviewStage
{
    private readonly AIOptions _options;

    // Risk threshold: contracts above this score require manual review.
    // Using a named constant prevents the "threshold always passes" bug
    // where a miscalculated score boundary lets everything auto-approve.
    public const double AutoApproveThreshold = 0.3;
    public const double ManualReviewThreshold = 0.6;

    public ReviewStage(AIOptions options) => _options = options;

    public ReviewResult Execute(ContractContext context)
    {
        string filePath = context.CurrentFilePath;
        string reportPath = Path.Combine(context.WorkDir, $"{context.ContractId}-review.md");

        string reviewInstruction =
            "Review this contract and write a Markdown report with two sections:\n" +
            "1. A table listing each major clause, its type, and a risk score (0-1).\n" +
            "2. A bullet list of clauses that deviate from standard practice for a " +
            $"standard {context.ContractType}. " +
            "Flag any of: uncapped liability, automatic renewal without notice, " +
            "broad indemnification, unilateral termination, or payment terms exceeding 60 days. " +
            "Prefix each flagged clause bullet with 'FLAG:' so the parser can identify it. " +
            $"Reference the source document as '{context.ContractId}', not as 'input.docx'.\n" +
            $"Save the report to: {reportPath}";

        AIResult result = DispatchByFormat(filePath, reviewInstruction, reportPath);

        if (result == null || !result.Success)
            throw new InvalidOperationException(
                $"Review failed: {result?.ErrorMessage ?? "Unknown error"}");

        // Parse the review report to extract structured data
        string reportContent = File.ReadAllText(reportPath);
        var review = ParseReviewReport(reportContent, reportPath);

        // Route based on risk score (three-tier classification)
        if (review.RiskScore >= ManualReviewThreshold)
            context.Status = PipelineStages.NeedsReview;
        else if (review.RiskScore >= AutoApproveThreshold)
        {
            // Middle zone: not clean enough to auto-approve, not risky enough to block
            context.Status = PipelineStages.Reviewed;
            context.StageLog.Add(
                $"Review: risk score {review.RiskScore:F2} in warning zone " +
                $"({AutoApproveThreshold}-{ManualReviewThreshold}); reviewed with warning");
        }
        else
            context.Status = PipelineStages.Reviewed;

        context.StageLog.Add(
            $"Review: {review.ClausesAnalyzed} clauses, {review.RiskFlags} flags, " +
            $"score {review.RiskScore:F2}, status={context.Status}");

        return review;
    }

    /// <summary>
    /// Dispatch to the correct document type based on file extension.
    /// This prevents the "PDF throws exception" bug where a stage
    /// only handles .docx and fails on counterparty PDFs.
    /// </summary>
    private AIResult DispatchByFormat(string filePath, string instruction, string outputPath)
    {
        string ext = Path.GetExtension(filePath).ToLowerInvariant();

        return ext switch
        {
            ".docx" or ".doc" => ProcessWord(filePath, instruction, outputPath),
            ".pdf"            => ProcessPdf(filePath, instruction, outputPath),
            _ => throw new NotSupportedException(
                $"Review stage does not support format: {ext}")
        };
    }

    private AIResult ProcessWord(string filePath, string instruction, string outputPath)
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            return doc.AI(_options).ExecuteInstruction(
                doc, instruction, outputPath, Array.Empty<string>());
        }
    }

    private AIResult ProcessPdf(string filePath, string instruction, string outputPath)
    {
        using (PdfDocument pdf = new PdfDocument())
        {
            pdf.LoadFromFile(filePath);
            return pdf.AI(_options).ExecuteInstruction(
                pdf, instruction, outputPath, Array.Empty<string>());
        }
    }

    private static ReviewResult ParseReviewReport(string markdown, string reportPath)
    {
        var result = new ReviewResult { ReportPath = reportPath };

        // Count table rows as clauses analyzed
        var tableLines = markdown.Split('\n')
            .Where(l => l.StartsWith("|") && !l.StartsWith("|---") && !l.StartsWith("| --"))
            .Skip(1); // skip header
        result.ClausesAnalyzed = tableLines.Count();

        // Count bullet points prefixed with "FLAG:" as risk flags
        var flagLines = markdown.Split('\n')
            .Select(l => l.TrimStart())
            .Where(l => l.StartsWith("-") || l.StartsWith("*"))
            .Where(l => l.Substring(1).TrimStart()
                .StartsWith("FLAG:", StringComparison.OrdinalIgnoreCase));
        result.FlaggedClauses = flagLines.Select(l => l.Trim()).ToList();
        result.RiskFlags = result.FlaggedClauses.Count;

        // Risk score: ratio of flagged clauses to total, clamped to [0, 1]
        result.RiskScore = result.ClausesAnalyzed > 0
            ? Math.Min(1.0, (double)result.RiskFlags / result.ClausesAnalyzed)
            : 0.0;

        return result;
    }
}
La méthode DispatchByFormat est l'ajout critique. Dans les implémentations précédentes du pipeline, une étape qui ne gérait que .docx levait une InvalidOperationException lorsqu'une contrepartie envoyait un .pdf. L'expression switch dispatche vers le type de document correct avant l'exécution de l'agent, de sorte que les deux formats sont des entrées de première classe.
Les seuils de risque (AutoApproveThreshold, ManualReviewThreshold) sont des constantes nommées avec une sémantique documentée. L'écart entre 0,3 et 0,6 crée une zone explicite "à réviser" — des contrats qui ne sont ni assez propres pour être approuvés automatiquement, ni assez risqués pour être bloqués. Cela évite le bogue de logique morte des seuils où chaque contrat passe la même vérification.
Les conclusions de révision sont conservées sous forme de rapport plutôt que renvoyées en mémoire, de sorte que l'audit au niveau des clauses survive indépendamment de l'exécution qui l'a produit.
5. Étape 3 : Négociation et contrôle des versions
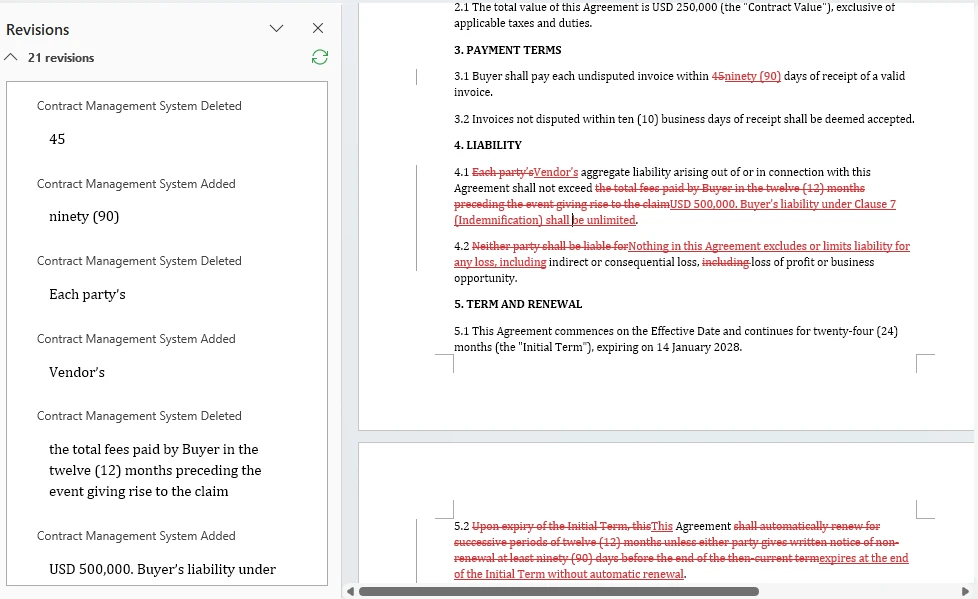
La négociation est le moment où les contrats changent de mains. La contrepartie annote le document — en modifiant les clauses, en ajustant les termes, en ajoutant des conditions. Le système doit comparer les versions, suivre les modifications et aider l'équipe à décider ce qu'il faut accepter.
Cette étape utilise deux capacités de la couche documentaire Spire.Doc qui vont au-delà de ExecuteInstruction de l'agent IA :
- Suivi des modifications — activer le suivi des révisions pour que chaque modification soit visible et attribuable
- Comparaison de documents — comparer deux versions et générer un document de différences
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Doc.Documents;
using System.Text.RegularExpressions;

public class NegotiationResult
{
    public string ComparisonPath { get; set; } = string.Empty;
    public int ChangesDetected { get; set; }
    public int SubstantiveChanges { get; set; }  // changes to clause text, not formatting
    public int FormattingChanges { get; set; }
    public string NegotiatedFilePath { get; set; } = string.Empty;
}

public class NegotiationStage
{
    private readonly AIOptions _options;

    public NegotiationStage(AIOptions options) => _options = options;

    /// <summary>
    /// Compare the current version with a counterparty's revised version.
    /// Produces a diff document with all changes marked.
    /// </summary>
    public NegotiationResult CompareVersions(
        ContractContext context, string counterpartyFilePath)
    {
        string comparisonPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-v{context.VersionNumber}-comparison.docx");

        // Load both versions
        using (Document ourVersion = new Document())
        using (Document theirVersion = new Document())
        {
            ourVersion.LoadFromFile(context.CurrentFilePath);
            theirVersion.LoadFromFile(counterpartyFilePath);

            // Compare: marks every difference in ourVersion as a tracked change
            ourVersion.Compare(theirVersion, "Contract Management System");

            // Save the comparison document
            ourVersion.SaveToFile(comparisonPath, FileFormat.Docx2013);
        }

        // Use the AI agent to analyze the comparison and categorize changes
        string analysisPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-negotiation-analysis.md");

        using (Document comparison = new Document())
        {
            comparison.LoadFromFile(comparisonPath);

            string analyzeInstruction =
                "Analyze this document comparison and write a Markdown report:\n" +
                "1. On the first line, write 'Total changes: <N>' where N is the total count " +
                "of categorized changes (substantive + formatting).\n" +
                "2. List each change as a bullet line prefixed with 'SUBSTANTIVE:' or 'FORMATTING:' " +
                "followed by the clause affected and the nature of the change.\n" +
                "3. SUBSTANTIVE changes: clause text, numbers, dates. " +
                "FORMATTING changes: style, spacing, font.\n" +
                $"Save to: {analysisPath}";

            AIResult result = comparison.AI(_options).ExecuteInstruction(
                comparison, analyzeInstruction, analysisPath, Array.Empty<string>());

            if (result == null || !result.Success)
                throw new InvalidOperationException(
                    $"Negotiation analysis failed: {result?.ErrorMessage}");
        }

        var negotiation = ParseNegotiationReport(analysisPath);
        negotiation.ComparisonPath = comparisonPath;
        negotiation.NegotiatedFilePath = counterpartyFilePath;

        context.VersionNumber++;
        context.CurrentFilePath = counterpartyFilePath;
        context.Status = PipelineStages.Negotiated;
        context.StageLog.Add(
            $"Negotiation: {negotiation.ChangesDetected} changes " +
            $"({negotiation.SubstantiveChanges} substantive, " +
            $"{negotiation.FormattingChanges} formatting), v{context.VersionNumber}");

        return negotiation;
    }

    /// <summary>
    /// Enable track changes on a contract before sending it for negotiation.
    /// This ensures every edit by the counterparty is visible and attributable.
    /// </summary>
    public string PrepareForRedlining(ContractContext context)
    {
        string redlineReadyPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-v{context.VersionNumber}-redline.docx");

        using (Document doc = new Document())
        {
            doc.LoadFromFile(context.CurrentFilePath);

            // Enable track changes so all edits are recorded as revisions
            doc.TrackChanges = true;

            doc.SaveToFile(redlineReadyPath, FileFormat.Docx2013);
        }

        context.StageLog.Add("Negotiation: track changes enabled for redlining");
        return redlineReadyPath;
    }

    /// <summary>
    /// Accept all tracked changes to produce a clean final version.
    /// Optional post-review operation: not automatically invoked by the pipeline
    /// because acceptance should occur only after human review of the changes.
    /// </summary>
    public string AcceptAllChanges(ContractContext context)
    {
        string cleanPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-v{context.VersionNumber}-final.docx");

        using (Document doc = new Document())
        {
            doc.LoadFromFile(context.CurrentFilePath);
            doc.AcceptChanges();
            doc.SaveToFile(cleanPath, FileFormat.Docx2013);
        }

        context.CurrentFilePath = cleanPath;
        context.StageLog.Add("Negotiation: all changes accepted, clean version produced");
        return cleanPath;
    }

    private static NegotiationResult ParseNegotiationReport(string reportPath)
    {
        string content = File.ReadAllText(reportPath);
        var result = new NegotiationResult();

        // Parse total changes from the report (try multiple patterns for robustness)
        var totalMatch = Regex.Match(content, @"Total changes:\s*(\d+)", RegexOptions.IgnoreCase);
        if (!totalMatch.Success)
            totalMatch = Regex.Match(content, @"(\d+)\s+(?:tracked\s+)?changes", RegexOptions.IgnoreCase);
        if (totalMatch.Success)
            result.ChangesDetected = int.Parse(totalMatch.Groups[1].Value);

        // Count changes by prefix: SUBSTANTIVE: or FORMATTING:
        result.SubstantiveChanges = CountByPrefix(content, "SUBSTANTIVE:");
        result.FormattingChanges = CountByPrefix(content, "FORMATTING:");

        return result;
    }

    private static int CountByPrefix(string content, string prefix)
    {
        return content.Split('\n')
            .Select(l => l.TrimStart())
            .Where(l => l.StartsWith("-") || l.StartsWith("*"))
            .Count(l => l.Substring(1).TrimStart()
                .StartsWith(prefix, StringComparison.OrdinalIgnoreCase));
    }
}
Appels API clés
-
Document.Compare(otherDoc, authorName)— génère un document de différences avec toutes les modifications marquées comme révisions suivies (d'après la démo de comparaison Spire.Doc) -
Document.TrackChanges = true— active le suivi des révisions pour que chaque modification soit visible et attribuable -
Document.AcceptChanges()— accepte toutes les modifications suivies pour produire une version finale propre -
doc.AI(_options).ExecuteInstruction(...)— analyse la comparaison et catégorise les changements
L'étape de négociation combine des opérations documentaires déterministes (comparer, suivre les modifications, accepter) avec une analyse IA (catégoriser les changements comme substantiels ou de mise en forme). Les opérations déterministes proviennent de la couche Spire.Doc — les mêmes API disponibles dans le répertoire de référence du code — tandis que l'agent IA gère la catégorisation sémantique qui nécessiterait autrement une révision manuelle.
L'exemple compare les versions et suit le chemin du fichier courant ; un système de production conserverait normalement chaque version séparément et enregistrerait explicitement quelle révision a été acceptée. AcceptAllChanges() est fourni comme opération de finalisation facultative après la négociation, mais il n'est pas automatiquement invoqué par le pipeline d'exemple car l'acceptation ne doit avoir lieu qu'après une révision humaine.
Ce que Document.Compare renvoie est un document, pas un résumé : les révisions suivies ci-dessous sont les modifications qu'un réviseur assemblerait autrement à la main.
6. Étape 4 : Approbation et finalisation
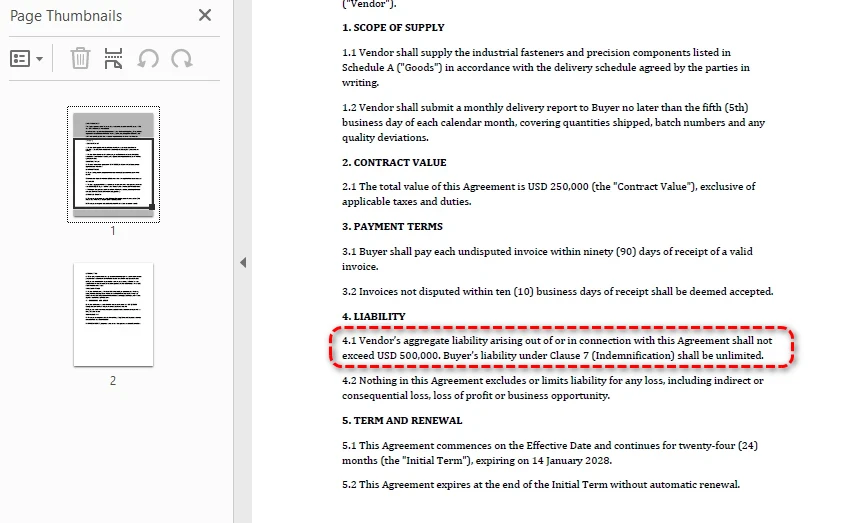
L'étape d'approbation achemine le contrat vers les bonnes parties prenantes en fonction du type et de la valeur du contrat, enregistre leurs approbations et produit une copie PDF finalisée après que toutes les approbations requises ont été enregistrées. La logique d'acheminement est déterministe — elle utilise des règles métier, pas l'IA — mais l'agent aide en suggérant des approbateurs et en générant le résumé d'approbation.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;

public class ApprovalResult
{
    public List<ApprovalRecord> Approvals { get; set; } = new();
    public bool AllApproved { get; set; }
    public string ExecutedFilePath { get; set; } = string.Empty; // Finalized PDF path, not a signed contract
    public DateTime? ExecutionDate { get; set; }                // Finalization timestamp, not a signing date
}

public class ApprovalRecord
{
    public string Approver { get; set; } = string.Empty;
    public string Role { get; set; } = string.Empty;
    public bool Approved { get; set; }
    public DateTime Timestamp { get; set; }
    public string? Comments { get; set; }
}

public class ApprovalStage
{
    private readonly AIOptions _options;

    public ApprovalStage(AIOptions options) => _options = options;

    /// <summary>
    /// Route the contract for approval based on type and value.
    /// Routing rules are deterministic business logic, not AI.
    /// </summary>
    public ApprovalResult Execute(
        ContractContext context, double contractValue,
        Dictionary<string, bool>? approvalDecisions = null)
    {
        var routingPlan = DetermineApprovers(context.ContractType, contractValue);
        var result = new ApprovalResult();

        // Generate an approval summary for each approver
        string summaryPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-approval-summary.md");

        using (Document doc = new Document())
        {
            doc.LoadFromFile(context.CurrentFilePath);

            string summaryInstruction =
                "Write a one-page approval summary for this contract: parties, value, " +
                "key terms, risk flags from review, and changes from negotiation. " +
                $"Save to: {summaryPath}";

            AIResult aiResult = doc.AI(_options).ExecuteInstruction(
                doc, summaryInstruction, summaryPath, Array.Empty<string>());

            if (aiResult == null || !aiResult.Success)
                throw new InvalidOperationException(
                    $"Approval summary generation failed: {aiResult?.ErrorMessage}");
        }

        // In a real system, this would integrate with an approval workflow API.
        // approvalDecisions maps approver name → approved/rejected. A missing key
        // means no decision was recorded — which is not the same as a rejection.
        int approvedCount = 0, rejectedCount = 0, pendingCount = 0;

        foreach (var approver in routingPlan)
        {
            bool decision = false;
            bool hasDecision = approvalDecisions != null
                && approvalDecisions.TryGetValue(approver.Name, out decision);
            bool approved = hasDecision && decision;

            // Three states, all distinguishable in the audit record
            string comment = !hasDecision ? "Pending approval"
                : approved ? "Approved by approver"
                : "Rejected by approver";

            if (!hasDecision) pendingCount++;
            else if (approved) approvedCount++;
            else rejectedCount++;

            result.Approvals.Add(new ApprovalRecord
            {
                Approver = approver.Name,
                Role = approver.Role,
                Approved = approved,
                Timestamp = DateTime.UtcNow,
                Comments = comment
            });
        }

        result.AllApproved = result.Approvals.All(a => a.Approved);

        if (result.AllApproved)
        {
            // Produce the finalized copy as PDF
            string executedPath = Path.Combine(
                context.WorkDir, $"{context.ContractId}-executed.pdf");

            using (Document doc = new Document())
            {
                doc.LoadFromFile(context.CurrentFilePath);
                doc.SaveToFile(executedPath, FileFormat.PDF);
                result.ExecutedFilePath = executedPath;
                result.ExecutionDate = DateTime.UtcNow;
            }

            context.CurrentFilePath = result.ExecutedFilePath;
            context.Status = PipelineStages.Executed;
        }
        else
        {
            context.Status = PipelineStages.NeedsReview;
        }

        context.StageLog.Add(
            $"Approval: {result.Approvals.Count} approvers, " +
            $"approved={approvedCount}, rejected={rejectedCount}, " +
            $"pending={pendingCount}, all approved={result.AllApproved}");

        return result;
    }

    /// <summary>
    /// Deterministic routing rules. These are business logic, not AI.
    /// </summary>
    private static List<(string Name, string Role)> DetermineApprovers(
        string contractType, double value)
    {
        var approvers = new List<(string, string)>();

        // All contracts need Legal sign-off (example business rule)
        approvers.Add(("Legal Team", "Legal Counsel"));

        // Contracts over $100K need VP approval (example business rule)
        if (value > 100_000)
            approvers.Add(("VP Operations", "VP"));

        // Contracts over $500K need CFO approval (example business rule)
        if (value > 500_000)
            approvers.Add(("CFO", "CFO"));

        // Vendor contracts need Procurement sign-off
        if (contractType.Equals("Vendor", StringComparison.OrdinalIgnoreCase))
            approvers.Add(("Procurement", "Procurement Manager"));

        return approvers;
    }
}
Les règles d'acheminement dans DetermineApprovers sont intentionnellement déterministes. L'IA suggère et résume ; elle ne décide pas qui signe un contrat. La chaîne d'approbation est une règle métier qui doit être auditable et cohérente — exactement le type de décision qui appartient au code, pas à un modèle de langage.
Note : Le statut
Executeddans cet exemple signifie le PDF final produit après approbation — pas un contrat signé. La signature électronique réelle — enveloppes de signature, vérification de l'identité du signataire, intégration des champs de signature — devrait être gérée par un flux de travail de signature électronique dédié, intégré séparément.
Une fois la décision de chaque approbateur enregistrée, l'étape écrit le contrat finalisé au format PDF — et c'est ce PDF, et non le brouillon source, que l'étape 5 consomme.
7. Étape 5 : Suivi post-signature
Dans un flux de travail de production, le suivi post-signature commence après que le contrat a été signé électroniquement ou formellement d'une autre manière. Dans cette implémentation de référence, le PDF finalisé produit par l'étape 4 est utilisé comme entrée de suivi. Le suivi post-signature extrait les obligations, les dates clés et les conditions de renouvellement du contrat, puis les stocke sous forme de métadonnées structurées que les systèmes en aval utilisent pour les rappels et les rapports.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;

public class ObligationResult
{
    public List<Obligation> Obligations { get; set; } = new();
    public List<KeyDate> KeyDates { get; set; } = new();
    public bool AutoRenewal { get; set; }
    public DateTime? RenewalDate { get; set; }
    public string MetadataPath { get; set; } = string.Empty;
}

public class Obligation
{
    public string Description { get; set; } = string.Empty;
    public string Party { get; set; } = string.Empty;  // who must fulfill
    public string Frequency { get; set; } = string.Empty;  // "monthly", "annual", "one-time"
    public DateTime? DueDate { get; set; }
    public string DueDateRaw { get; set; } = string.Empty;  // original deadline text from the contract
}

public class KeyDate
{
    public string Description { get; set; } = string.Empty;
    public DateTime Date { get; set; }
    public string Type { get; set; } = string.Empty;  // "renewal", "termination", "milestone"
}

public class MonitoringStage
{
    private readonly AIOptions _options;

    public MonitoringStage(AIOptions options) => _options = options;

    public ObligationResult Execute(ContractContext context)
    {
        string metadataPath = Path.Combine(
            context.WorkDir, $"{context.ContractId}-obligations.json");

        string extractInstruction =
            "Extract all post-signature obligations and key dates from this contract. " +
            "Write a JSON file with:\n" +
            "1. \"obligations\": array of {description, party, frequency, dueDate, dueDateRaw} " +
            "where dueDate is an ISO-8601 date (YYYY-MM-DD). If the obligation has a relative " +
            "deadline (e.g., 'Within 90 days of receipt'), convert it to an absolute date based " +
            "on the contract effective date. Use null only for ongoing obligations with no " +
            "fixed deadline. Always put the original deadline text in dueDateRaw.\n" +
            "2. \"keyDates\": array of {description, date, type} where date is ISO-8601 " +
            "(YYYY-MM-DD) and type is 'renewal', 'termination', or 'milestone'\n" +
            "3. \"autoRenewal\": boolean\n" +
            "4. \"renewalDate\": ISO-8601 date (YYYY-MM-DD) or null\n" +
            $"Save to: {metadataPath}";

        // Dispatch by format — executed contracts may be PDF or DOCX
        AIResult result = DispatchExtraction(
            context.CurrentFilePath, extractInstruction, metadataPath, _options);

        if (result == null || !result.Success)
            throw new InvalidOperationException(
                $"Obligation extraction failed: {result?.ErrorMessage}");

        var obligations = ParseObligationMetadata(metadataPath);
        obligations.MetadataPath = metadataPath;

        context.Obligations = obligations;
        context.Status = PipelineStages.Monitored;

        // Diagnostics: bucket every obligation by how its deadline came out, so that a
        // field the agent writes but the parser fails to read cannot pass unnoticed.
        int datesParsed = obligations.Obligations.Count(o => o.DueDate != null);
        int datesUnparsed = obligations.Obligations.Count(
            o => o.DueDate == null && !string.IsNullOrEmpty(o.DueDateRaw));
        int datesOngoing = obligations.Obligations.Count(
            o => o.DueDate == null && string.IsNullOrEmpty(o.DueDateRaw));
        int datesNoSourceText = obligations.Obligations.Count(
            o => o.DueDate != null && string.IsNullOrEmpty(o.DueDateRaw));
        context.StageLog.Add(
            $"Monitoring: {obligations.Obligations.Count} obligations, " +
            $"{obligations.KeyDates.Count} key dates, " +
            $"auto-renewal={obligations.AutoRenewal}, " +
            $"dates parsed={datesParsed}, unparsed={datesUnparsed}, ongoing={datesOngoing}, " +
            $"parsed-without-source-text={datesNoSourceText}");

        return obligations;
    }

    private static AIResult DispatchExtraction(
        string filePath, string instruction, string outputPath, AIOptions options)
    {
        string ext = Path.GetExtension(filePath).ToLowerInvariant();

        return ext switch
        {
            ".docx" or ".doc" => ProcessWordExtraction(filePath, instruction, outputPath, options),
            ".pdf"            => ProcessPdfExtraction(filePath, instruction, outputPath, options),
            _ => throw new NotSupportedException(
                $"Obligation extraction does not support format: {ext}")
        };
    }

    private static AIResult ProcessWordExtraction(
        string filePath, string instruction, string outputPath, AIOptions options)
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            return doc.AI(options).ExecuteInstruction(
                doc, instruction, outputPath, Array.Empty<string>());
        }
    }

    private static AIResult ProcessPdfExtraction(
        string filePath, string instruction, string outputPath, AIOptions options)
    {
        using (PdfDocument pdf = new PdfDocument())
        {
            pdf.LoadFromFile(filePath);
            return pdf.AI(options).ExecuteInstruction(
                pdf, instruction, outputPath, Array.Empty<string>());
        }
    }

    private static ObligationResult ParseObligationMetadata(string jsonPath)
    {
        string json = File.ReadAllText(jsonPath);
        using var doc = System.Text.Json.JsonDocument.Parse(json);
        var root = doc.RootElement;

        var result = new ObligationResult();

        if (TryGetPropertyIgnoreCase(root, "obligations", out var obs))
            foreach (var ob in obs.EnumerateArray())
            {
                string dueDateRaw = TryGetPropertyIgnoreCase(ob, "dueDateRaw", out var dr)
                    && dr.ValueKind == System.Text.Json.JsonValueKind.String
                    ? dr.GetString() ?? "" : "";

                result.Obligations.Add(new Obligation
                {
                    Description = TryGetPropertyIgnoreCase(ob, "description", out var d) ? d.GetString() ?? "" : "",
                    Party = TryGetPropertyIgnoreCase(ob, "party", out var p) ? p.GetString() ?? "" : "",
                    Frequency = TryGetPropertyIgnoreCase(ob, "frequency", out var f) ? f.GetString() ?? "" : "",
                    DueDate = TryGetDate(TryGetPropertyIgnoreCase(ob, "dueDate", out var dd2), dd2),
                    DueDateRaw = dueDateRaw
                });
            }

        if (TryGetPropertyIgnoreCase(root, "keyDates", out var kds))
            foreach (var kd in kds.EnumerateArray())
                result.KeyDates.Add(new KeyDate
                {
                    Description = TryGetPropertyIgnoreCase(kd, "description", out var d) ? d.GetString() ?? "" : "",
                    Date = TryGetDate(TryGetPropertyIgnoreCase(kd, "date", out var dt), dt) ?? default,
                    Type = TryGetPropertyIgnoreCase(kd, "type", out var t) ? t.GetString() ?? "" : ""
                });

        result.AutoRenewal = TryGetBool(TryGetPropertyIgnoreCase(root, "autoRenewal", out var ar), ar);
        result.RenewalDate = TryGetDate(TryGetPropertyIgnoreCase(root, "renewalDate", out var rd), rd);

        return result;
    }

    /// <summary>
    /// Case-insensitive property lookup. Prevents silent data loss when
    /// the AI agent outputs PascalCase or snake_case instead of camelCase.
    /// </summary>
    private static bool TryGetPropertyIgnoreCase(
        System.Text.Json.JsonElement element, string name,
        out System.Text.Json.JsonElement value)
    {
        foreach (var prop in element.EnumerateObject())
        {
            if (string.Equals(prop.Name, name, StringComparison.OrdinalIgnoreCase))
            {
                value = prop.Value;
                return true;
            }
        }
        value = default;
        return false;
    }

    /// <summary>
    /// Safe date parsing: handles null, non-string values, and invalid formats
    /// without throwing. Returns null on any parse failure.
    /// </summary>
    private static DateTime? TryGetDate(bool exists, System.Text.Json.JsonElement element)
    {
        if (!exists || element.ValueKind != System.Text.Json.JsonValueKind.String)
            return null;
        string? s = element.GetString();
        return DateTime.TryParse(s, out var date) ? date : null;
    }

    /// <summary>
    /// Safe boolean parsing: handles string "true"/"false" and actual booleans
    /// without throwing on type mismatch.
    /// </summary>
    private static bool TryGetBool(bool exists, System.Text.Json.JsonElement element)
    {
        if (!exists) return false;
        if (element.ValueKind == System.Text.Json.JsonValueKind.True) return true;
        if (element.ValueKind == System.Text.Json.JsonValueKind.False) return false;
        if (element.ValueKind == System.Text.Json.JsonValueKind.String)
            return bool.TryParse(element.GetString(), out var b) && b;
        return false;
    }
}
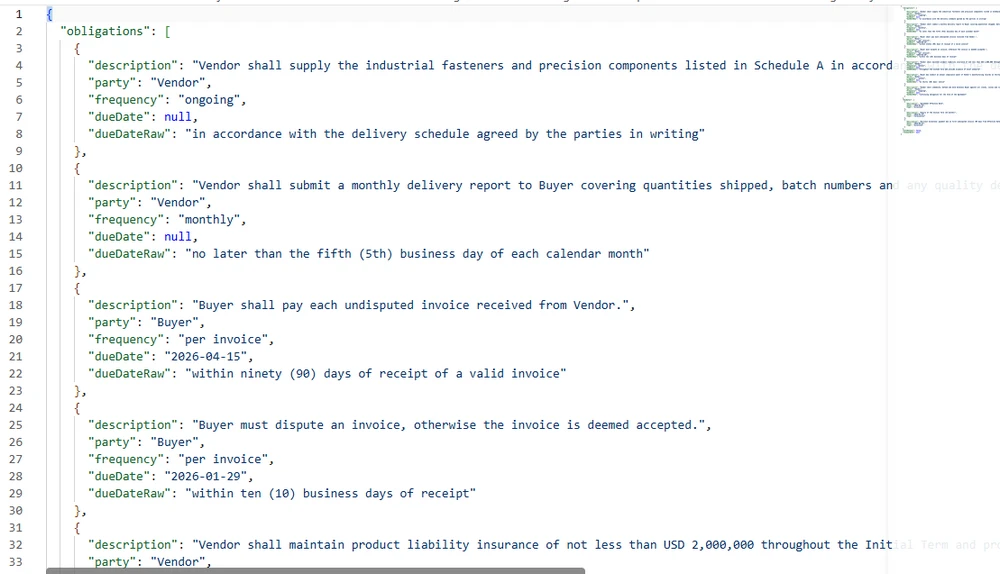
Les métadonnées d'obligation sont stockées en JSON, pas sous forme de document. Cela les rend interrogeables par les systèmes en aval — un tableau de bord de renouvellement peut scanner tous les contrats pour autoRenewal == true et renewalDate < DateTime.Now.AddDays(90) sans ouvrir un seul document. Les obligations avec des valeurs dueDate structurées peuvent être suivies automatiquement ; celles où l'échéance n'était pas convertible en date absolue conservent le texte original dans dueDateRaw pour une révision manuelle. L'agent IA extrait les informations ; la couche déterministe les stocke dans un format que les systèmes métier peuvent consommer.
Le modèle d'extraction est le même que celui utilisé pour les factures dans Automatiser le traitement des factures avec un agent IA en .NET : extraire des champs structurés d'un document entrant, les valider par rapport à des règles déterministes, et acheminer les valeurs incertaines pour révision. Les contrats diffèrent principalement par ce qui se passe ensuite — les obligations deviennent des enregistrements à longue durée de vie qui survivent à la transaction, tandis que les champs de facture sont consommés une fois.
Les données extraites sont stockées en JSON plutôt qu'en prose, de sorte que chaque obligation et date clé porte le libellé original du contrat à côté de la valeur que l'analyseur en a dérivée.
8. Orchestration du pipeline complet
L'orchestrateur enchaîne les étapes, en passant le ContractContext de l'une à l'autre. Ses deux responsabilités critiques sont l'isolation des erreurs par contrat (un contrat échoué ne doit pas arrêter le lot) et la conservation des statuts (chaque contrat doit se retrouver dans exactement un compartiment de rapport).
using Spire.Agent.Office.AI;

public class PipelineResult
{
    public string ContractId { get; set; } = string.Empty;
    public string Status { get; set; } = PipelineStages.Pending;
    public List<string> StageLog { get; set; } = new();
    public string? ErrorMessage { get; set; }
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }    // needs review
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

public class ContractLifecyclePipeline
{
    private readonly DraftingStage _drafting;
    private readonly ReviewStage _review;
    private readonly NegotiationStage _negotiation;
    private readonly ApprovalStage _approval;
    private readonly MonitoringStage _monitoring;

    public ContractLifecyclePipeline(AIOptions options)
    {
        _drafting = new DraftingStage(options);
        _review = new ReviewStage(options);
        _negotiation = new NegotiationStage(options);
        _approval = new ApprovalStage(options);
        _monitoring = new MonitoringStage(options);
    }

    /// <summary>
    /// Run a single contract through the full lifecycle.
    /// Each stage is wrapped in its own try-catch so that a failure
    /// in one stage produces a clear error without corrupting the
    /// context for subsequent contracts in the batch.
    /// </summary>
    public PipelineResult RunSingle(
        ContractContext context,
        string templatePath,
        string dataSourcePath,
        double contractValue,
        string? counterpartyFilePath = null,
        Dictionary<string, bool>? approvalDecisions = null)
    {
        try
        {
            // Stage 1: Drafting
            try
            {
                context.Draft = _drafting.Execute(context, templatePath, dataSourcePath);
            }
            catch (Exception ex)
            {
                return Fail(context, "Drafting", ex);
            }

            // Stage 2: Review
            try
            {
                context.Review = _review.Execute(context);
            }
            catch (Exception ex)
            {
                return Fail(context, "Review", ex);
            }

            // If review flagged for manual review, stop here
            if (context.Status == PipelineStages.NeedsReview)
                return Flag(context, "Review flagged for manual review");

            // Stage 3: Negotiation (only when a counterparty version exists)
            if (counterpartyFilePath != null)
            {
                try
                {
                    context.Negotiation = _negotiation.CompareVersions(context, counterpartyFilePath);
                }
                catch (Exception ex)
                {
                    return Fail(context, "Negotiation", ex);
                }
            }

            // Stage 4: Approval and Finalization
            try
            {
                context.Approval = _approval.Execute(context, contractValue, approvalDecisions);
            }
            catch (Exception ex)
            {
                return Fail(context, "Approval", ex);
            }

            if (context.Status == PipelineStages.NeedsReview)
                return Flag(context, "Approval incomplete");

            // Stage 5: Post-signature monitoring
            try
            {
                context.Obligations = _monitoring.Execute(context);
            }
            catch (Exception ex)
            {
                return Fail(context, "Monitoring", ex);
            }

            return new PipelineResult
            {
                ContractId = context.ContractId,
                Status = context.Status,
                StageLog = context.StageLog
            };
        }
        catch (Exception ex)
        {
            return Fail(context, "Pipeline", ex);
        }
    }

    /// <summary>
    /// Process a batch of contracts with per-file error isolation.
    /// One corrupt file does not halt the batch.
    /// Approval decisions are keyed by contract id; a contract with no
    /// entry keeps its approvers pending and stops at NeedsReview.
    /// </summary>
    public BatchResult RunBatch(
        List<(ContractContext context, string template, string data, double value)> contracts,
        Dictionary<string, Dictionary<string, bool>>? approvalDecisions = null)
    {
        var results = new List<PipelineResult>();

        foreach (var (context, template, data, value) in contracts)
        {
            // Per-contract try-catch: one failure does not stop the batch
            try
            {
                Dictionary<string, bool>? decisions = null;
                if (approvalDecisions != null &&
                    approvalDecisions.TryGetValue(context.ContractId, out var d))
                    decisions = d;

                results.Add(RunSingle(context, template, data, value, null, decisions));
            }
            catch (Exception ex)
            {
                results.Add(Fail(context, "Batch", ex));
            }
        }

        // Status conservation: every result must land in exactly one bucket.
        // Using the remainder method ensures that any result with an unexpected
        // status lands in "Flagged" (conservative) rather than vanishing.
        int successful = results.Count(r => r.Status == PipelineStages.Monitored
                                         || r.Status == PipelineStages.Executed);
        int errored = results.Count(r => r.Status == PipelineStages.Failed);

        return new BatchResult
        {
            Total = results.Count,
            Successful = successful,
            Flagged = results.Count - successful - errored,  // remainder → conservative
            Errored = errored,
            Results = results
        };
    }

    private static PipelineResult Fail(ContractContext context, string stage, Exception ex)
    {
        context.Status = PipelineStages.Failed;
        context.ErrorMessage = $"{stage}: {ex.Message}";
        context.StageLog.Add($"ERROR at {stage}: {ex.Message}");
        return new PipelineResult
        {
            ContractId = context.ContractId,
            Status = PipelineStages.Failed,
            StageLog = context.StageLog,
            ErrorMessage = context.ErrorMessage
        };
    }

    private static PipelineResult Flag(ContractContext context, string reason)
    {
        context.StageLog.Add($"FLAGGED: {reason}");
        return new PipelineResult
        {
            ContractId = context.ContractId,
            Status = context.Status,
            StageLog = context.StageLog
        };
    }
}
Isolation des erreurs par étape
Chaque étape est enveloppée dans son propre bloc try-catch. Si l'étape de révision échoue parce que l'agent IA ne peut pas analyser une clause particulièrement complexe, le pipeline enregistre l'échec et s'arrête — mais le ContractContext du contrat suivant dans le lot est intact. Cela évite un mode de défaillance courant où un seul fichier corrompu dans un lot de 200 arrête tout le pipeline sans résultats partiels.
Conservation des statuts
Le résumé du lot utilise la méthode du reste pour calculer le nombre de Flagged : Flagged = Total - Successful - Errored. C'est une propriété structurelle — tout résultat qui n'est pas explicitement réussi ou en erreur atterrit dans "flagged" (acheminement conservateur vers une révision manuelle). Cela évite le bogue où les résultats avec des valeurs de statut inattendues disparaissent silencieusement des trois compartiments de rapport.
Exécution du pipeline
// Configure the agent
AIOptions options = new AIOptions
{
    WorkDir = @"C:\contract-mgmt\work",
    SpireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")!
};

// Create the pipeline
var pipeline = new ContractLifecyclePipeline(options);

// Prepare a batch of contracts
var batch = new List<(ContractContext, string, string, double)>
{
    new(new ContractContext
    {
        ContractId = "CTR-2026-001",
        ContractType = "Vendor",
        WorkDir = @"C:\contract-mgmt\work\CTR-2026-001"
    },
    @"C:\templates\vendor-agreement.docx",
    @"C:\data\vendors-q1.xlsx",
    250_000)
};

// Run the batch. Approval decisions are supplied per contract id —
// a contract with no recorded decision stays in NeedsReview and
// never reaches Stage 5.
BatchResult result = pipeline.RunBatch(batch, new Dictionary<string, Dictionary<string, bool>>
{
    ["CTR-2026-001"] = new Dictionary<string, bool>
    {
        ["Legal Team"] = true,
        ["VP Operations"] = true,
        ["Procurement"] = true
    }
});

Console.WriteLine($"Total: {result.Total}");
Console.WriteLine($"Successful: {result.Successful}");
Console.WriteLine($"Flagged: {result.Flagged}");
Console.WriteLine($"Errored: {result.Errored}");

foreach (var r in result.Results)
{
    Console.WriteLine($"  {r.ContractId}: {r.Status}");
    foreach (var log in r.StageLog)
        Console.WriteLine($"    {log}");
}
Les décisions d'approbation sont fournies à l'appel du lot plutôt que déduites par le pipeline : un contrat sans décision enregistrée garde ses approbateurs en attente, atterrit dans Flagged et s'arrête avant l'étape 5 — le résultat attendu pour un accord que personne n'a encore approuvé.
Une exécution sur une poignée de contrats est le cas simple. Placez les mêmes étapes derrière une file d'attente de documents et les questions d'orchestration changent : limites de concurrence, isolation des erreurs par document, politique de nouvelle tentative et agrégation dans un rapport de lot. Traitement intelligent des documents en .NET : construire des pipelines IDP traite de ces aspects au niveau du pipeline, et la section sur les lots de cet article est une instance spécifique aux contrats du même modèle.
9. Où l'IA s'arrête et où la gouvernance commence
L'architecture ci-dessus attribue des responsabilités spécifiques à l'agent IA et des responsabilités spécifiques au code déterministe. La frontière n'est pas arbitraire — elle suit un principe : L'IA interprète et suggère ; le code déterministe décide et enregistre.
Les évaluations de risques générées par l'IA et les obligations extraites doivent être validées par des réviseurs qualifiés avant d'être utilisées pour des décisions juridiques ou commerciales.
| Responsabilité | Géré par | Pourquoi |
|---|---|---|
| Comprendre une instruction en langage naturel | Agent IA | Tout l'intérêt des modèles de langage |
| Extraire des informations à partir de texte non structuré | Agent IA | Compréhension sémantique requise |
| Catégoriser les changements comme substantiels ou de mise en forme | Agent IA | Nécessite un jugement sur le sens |
| Suggérer des approbateurs en fonction du type de contrat | Règles métier | Auditabilité et cohérence |
| Déterminer qui doit signer | Règles métier | Auditabilité et cohérence |
| Enregistrer la chaîne d'approbation | Code déterministe | La piste d'audit juridique doit être infalsifiable |
| Définir les seuils de risque | Règles métier | La politique de risque est une décision de gouvernance |
| Stocker les métadonnées d'obligation | Code déterministe | Les systèmes en aval ont besoin d'une structure fiable |
| Déclencher des rappels de renouvellement | Code déterministe | Doit se déclencher selon un calendrier, pas sur une inférence |
Les seuils de risque dans l'étape de révision (AutoApproveThreshold = 0.3, ManualReviewThreshold = 0.6) sont définis par l'entreprise, pas par l'IA. L'application dérive un ratio de révision à partir du nombre de clauses signalées ; l'entreprise définit les seuils. Cette séparation est ce qui rend le système défendable lors d'un audit — chaque décision automatisée remonte à une règle définie par l'homme, pas à une inférence de modèle.
Intégration avec les systèmes existants
Un système de cycle de vie des contrats n'existe pas isolément. Les métadonnées post-signature (obligations, dates clés, conditions de renouvellement) sont conçues pour être consommées par les systèmes en aval :
- ERP / Finance : jalons de paiement et rapprochement des factures
- CRM : alertes de renouvellement pour les gestionnaires de comptes
- Achats : suivi des performances des fournisseurs par rapport aux SLA contractuels
- Juridique : surveillance de la conformité et préparation d'audit
Le format de métadonnées JSON de l'étape 5 rend cette intégration simple — les systèmes en aval interrogent les données structurées sans avoir besoin d'analyser les documents contractuels.
10. FAQ
En quoi est-ce différent de la révision de contrat par IA ?
La révision de contrat est une étape du cycle de vie — lire un accord et signaler les clauses à risque. Un système de gestion des contrats couvre l'ensemble du cycle de vie : rédaction, révision, négociation, approbation, finalisation et suivi post-signature. L'article existant Révision de contrat par IA en C# couvre en profondeur l'étape de révision ; cet article couvre le pipeline complet dans lequel s'inscrit la révision.
Le pipeline peut-il gérer à la fois les entrées PDF et Word ?
Oui, aux étapes qui implémentent la répartition des formats. Les étapes de révision et de suivi incluent un switch sur l'extension de fichier qui achemine .docx vers Document et .pdf vers PdfDocument. L'étape de rédaction nécessite un modèle .docx, et l'étape de négociation opère sur des documents Word (la comparaison de documents utilise Spire.Doc.Document). Cela reflète un modèle du monde réel : la répartition des formats est appliquée là où des PDF de contrepartie sont attendus, pas uniformément à chaque étape.
Que se passe-t-il si un contrat échoue dans un lot ?
Le processeur de lot enveloppe chaque contrat dans son propre bloc try-catch. Une défaillance dans un contrat est enregistrée avec le message d'erreur et l'étape où elle s'est produite, et le lot continue avec le contrat suivant. Le résumé du lot utilise la méthode du reste pour la conservation des statuts : Flagged = Total - Successful - Errored, garantissant que chaque résultat atterrit dans exactement un compartiment de rapport.
L'agent IA décide-t-il qui approuve un contrat ?
Non. Les règles d'acheminement des approbations sont une logique métier déterministe — dans cet exemple, les contrats de plus de 100 000 $ nécessitent l'approbation du vice-président, ceux de plus de 500 000 $ nécessitent l'approbation du directeur financier, et les contrats fournisseurs nécessitent l'approbation des achats. L'agent IA génère le résumé d'approbation que lisent les approbateurs, mais l'acheminement lui-même est du code. Cela maintient la chaîne d'approbation auditable et cohérente.
Comment fonctionne l'étape de négociation ?
L'étape de négociation utilise deux capacités de la couche documentaire Spire.Doc : Document.Compare() pour générer un diff entre les versions, et Document.TrackChanges pour activer le suivi des révisions. L'agent IA analyse ensuite le document de comparaison et catégorise chaque changement comme substantiel (texte de clause, nombres, dates) ou de mise en forme (style, espacement). Cette combinaison — comparaison déterministe plus catégorisation IA — est ce qui rend l'étape de négociation utile pour les équipes juridiques.
Qu'est-ce que le suivi post-signature ?
Après qu'un contrat est finalisé (signé en production), le système extrait les obligations (qui doit faire quoi, quand), les dates clés (renouvellement, résiliation, jalons) et les conditions de renouvellement (renouvellement automatique, préavis) du document finalisé. Ces métadonnées sont stockées en JSON structuré que les systèmes en aval — ERP, CRM, achats — peuvent interroger sans ouvrir le document contractuel. C'est l'étape que la plupart des outils de révision de contrat n'abordent pas, et c'est là que la plus grande valeur est perdue dans les processus manuels : obligations oubliées, renouvellements manqués, échéances dépassées sans préavis.
Quelles dépendances .NET sont requises ?
Le package NuGet Spire.Agent.Office, qui apporte transitivement Spire.Doc, Spire.Pdf, Spire.XLS et Spire.Presentation. L'exemple cible .NET 6 ou version ultérieure ; vérifiez les frameworks cibles pris en charge par la version du package avant le déploiement. Un SpireToken (clé API) est requis pour que l'agent IA communique avec le service de modèle de langage.
Prêt à automatiser votre cycle de vie contractuel ?
Si votre application rédige, révise ou suit des accords, un agent IA documentaire transforme une instruction en langage naturel en un fichier réel et formaté au lieu d'un pipeline d'extraction et de reconstruction que vous devez maintenir. Suivez le guide de démarrage pour intégrer le SDK dans un projet .NET et exécuter votre première instruction, puis réutilisez les cinq modèles d'étapes ci-dessus pour vos propres types de contrats, règles d'approbation et suivi des obligations.
Lectures complémentaires
- Génération de contrats par lots avec Spire.Agent.Office -- l'étape de rédaction en profondeur : fusion et publication et remplacement des espaces réservés sur des dizaines de modèles à la fois
- Automatiser le traitement des factures avec un agent IA en .NET -- le même modèle extraire-valider-réviser appliqué aux factures, où chaque document est consommé une fois
- Traitement intelligent des documents en .NET : construire des pipelines IDP -- orchestration au niveau du pipeline : concurrence, isolation des erreurs par document et rapports par lots
- Présentation du produit Spire.Agent.Office -- SDK d'agents IA pour chaque format de document Office