Les documents utilisés dans les workflows du service client, de la finance, des ressources humaines et du juridique contiennent souvent des noms, des adresses e-mail, des numéros de téléphone, des adresses personnelles, des numéros de compte et d'autres informations sensibles. Avant que ces fichiers puissent être partagés, archivés ou utilisés pour analyse, le contenu identifiant peut devoir être supprimé ou remplacé.
Les programmes de caviardage traditionnels s'appuient sur des règles de recherche prédéfinies et une logique de traitement distincte pour chaque format de document. Un SDK d'agent IA offre une autre approche : les développeurs peuvent décrire l'exigence de caviardage en langage naturel, ce qui permet à l'agent d'identifier les informations sensibles et de modifier les éléments correspondants du document Office. Cet article montre comment caviarder des fichiers Word, Excel et PowerPoint en C# tout en préservant leur structure et leur mise en forme d'origine.
Qu'est-ce que le caviardage de documents ?
Le caviardage de documents est le processus consistant à supprimer ou remplacer des informations qui ne doivent pas être divulguées. Les cibles de caviardage courantes comprennent :
- Noms de personnes
- Adresses e-mail
- Numéros de téléphone et de fax
- Adresses personnelles ou postales
- Dates de naissance
- Identifiants de clients et d'employés
- Numéros bancaires et de compte
- Autres informations confidentielles ou personnellement identifiables
Pour les fichiers Office modifiables, le caviardage implique davantage qu'une simple modification du texte brut. Le contenu sensible peut apparaître dans les paragraphes et les tableaux Word, les cellules Excel, les formes PowerPoint, les en-têtes, les pieds de page ou d'autres éléments du document. Un flux de travail de caviardage utile doit supprimer la valeur détectée sans modifier inutilement la mise en page environnante, les styles, les images, les graphiques ou la structure du document.
Trois façons de caviarder des documents Office en C#
Il existe trois approches d'implémentation générales : les API documentaires traditionnelles, une intégration directe de LLM, et un SDK d'agent IA.
Caviardage traditionnel basé sur les API
Une implémentation traditionnelle commence normalement par un remplacement de texte exact ou par des expressions régulières. Par exemple, Spire.Doc for .NET fournit des API pour rechercher et remplacer du texte dans des documents Word.
Le pseudocode simplifié suivant illustre un flux de travail de caviardage basé sur des règles. Il est volontairement incomplet et ne montre que les principales responsabilités que l'application devrait gérer.
Document document = new Document();
document.LoadFromFile("Input.docx");

// Patterns must be defined and maintained by the developer.
Regex emailPattern = new Regex("...");
Regex phonePattern = new Regex("...");
Regex accountPattern = new Regex("...");

document.Replace(emailPattern, "[REDACTED]");
document.Replace(phonePattern, "[REDACTED]");
document.Replace(accountPattern, "[REDACTED]");

// Additional logic may still be required for different content containers.
foreach (Section section in document.Sections)
{
    ProcessParagraphs(section);
    ProcessTables(section.Tables);
    ProcessHeadersAndFooters(section.HeadersFooters);
    ProcessTextBoxes(section);
}

document.SaveToFile("Redacted.docx", FileFormat.Docx);
Cette approche fonctionne bien lorsque les valeurs sensibles suivent des motifs prévisibles. Les adresses e-mail, les numéros de téléphone et les numéros d'identification standardisés peuvent souvent être trouvés à l'aide d'expressions régulières.
La difficulté augmente lorsque l'information dépend du contexte. Un programme peut devoir déterminer si un mot est un nom de personne, si un numéro est un numéro de compte ou un numéro de facture, et si un emplacement est une adresse privée ou l'adresse publique d'une entreprise. Les développeurs doivent également ajouter une logique de parcours et de remplacement différente pour Word, Excel et PowerPoint.
Intégration directe d'un LLM
Un grand modèle de langage peut comprendre le contexte plus efficacement qu'un ensemble d'expressions régulières. Par exemple, il peut reconnaître le nom d'une personne dans une phrase même lorsque ce nom ne suit pas un schéma prévisible.
Cependant, un LLM ne fournit pas automatiquement un traitement complet des documents Office. Une intégration directe nécessite généralement que l'application :
- Extrait le texte de chaque élément de document pertinent.
- Divise le contenu en requêtes appropriées.
- Envoie le texte extrait au modèle.
- Fasse correspondre les résultats du modèle aux paragraphes, cellules ou formes d'origine.
- Remplace le contenu sensible sans perdre sa mise en forme.
- Enregistre le fichier modifié dans son format d'origine.
Si le document est converti en texte brut avant d'être envoyé au modèle, les informations sur les tableaux, les plages de texte, les polices, l'alignement et d'autres propriétés de mise en page peuvent être perdues. Le développeur reste donc responsable de la liaison entre les résultats sémantiques du modèle et le modèle objet du document Office.
SDK d'agent IA
Un SDK d'agent IA combine la compréhension du langage naturel avec des capacités de traitement de documents. Au lieu de définir chaque règle de détection et de coordonner manuellement chaque étape de remplacement, le développeur fournit le document et décrit le résultat souhaité.
Spire.Agent.Office s'appuie sur les capacités sous-jacentes de Spire.Office for .NET pour travailler avec les objets Word, Excel et PowerPoint. Dans un document Word, par exemple, la couche de traitement peut accéder aux sections, aux paragraphes, aux plages de texte, aux tableaux, aux cellules, aux en-têtes, aux pieds de page, aux images, aux hyperliens et à leur mise en forme. Le modèle identifie le contenu sensible, tandis que les API documentaires modifient les éléments correspondants.
C'est ce traitement au niveau des objets qui permet de remplacer du texte tout en conservant la structure et les styles environnants du document.
API traditionnelle vs LLM vs SDK d'agent IA
| Approche | Détection contextuelle | Préservation de la mise en forme | Implémentation multi-format | Effort de développement | Idéal pour |
|---|---|---|---|---|---|
| API traditionnelle et expressions régulières | Limitée, sauf si une logique NLP supplémentaire est ajoutée | Robuste et contrôlable | Une logique distincte est normalement requise | Élevé | Motifs fixes et règles hautement déterministes |
| API Office avec appels directs à un LLM | Forte | Doit être implémentée par le développeur | Une logique d'extraction et de réécriture est requise pour chaque format | Très élevé | Pipelines IA entièrement personnalisés |
| SDK d'agent IA | Forte | Gérée grâce à un traitement conscient du document | Une instruction commune peut être appliquée à plusieurs formats Office | Plus faible | Caviardage contextuel avec moins de code d'orchestration |
L'approche traditionnelle reste utile lorsque chaque cible de caviardage suit un motif connu et que l'application exige un comportement strictement déterministe. L'approche du SDK d'agent devient plus intéressante lorsque les documents contiennent des informations variées et contextuelles, ou lorsque le même flux de travail doit prendre en charge plusieurs formats Office.
Configurer le projet C#
Créez une application console C# et ajoutez Spire.Agent.Office ainsi que ses dépendances requises au projet. Vous aurez également besoin d'un SpireToken valide pour le traitement IA.
L'exemple ci-dessous prend en charge les formats suivants :
- Word : DOC et DOCX
- Excel : XLS et XLSX
- PowerPoint : PPT et PPTX
PDF n'est pas inclus dans cet exemple.
Caviarder des documents Word, Excel et PowerPoint avec un agent IA
Le code suivant détermine le format source à partir de son extension, charge l'objet de document Office approprié et transmet la même instruction de caviardage au processeur IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Presentation;
using Spire.Doc;
using Spire.Xls;

string inputPath = @"E:\Documents\Input.docx";
string outputPath = @"E:\Documents\Redacted.docx";
string spireToken = "your spireToken";

string instruction = """
Find personal information such as names, email addresses, phone numbers, addresses,
account numbers, and other sensitive information. Replace the detected content with
“[REDACTED]” while preserving the original document structure and formatting.
""";

// Configure the AI processing options
AIOptions options = new AIOptions();
options.SpireToken = spireToken;

// Select the appropriate document object according to the file extension
string extension = Path.GetExtension(inputPath).ToLower();

if (extension == ".doc" || extension == ".docx")
{
    using (Document document = new Document())
    {
        document.LoadFromFile(inputPath);
        AIDocumentProcessor processor = document.AI(options);
        processor.ExecuteInstruction(
            document,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".xls" || extension == ".xlsx")
{
    using (Workbook workbook = new Workbook())
    {
        workbook.LoadFromFile(inputPath);
        AIDocumentProcessor processor = workbook.AI(options);
        processor.ExecuteInstruction(
            workbook,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".ppt" || extension == ".pptx")
{
    using (Presentation presentation = new Presentation())
    {
        presentation.LoadFromFile(inputPath);
        AIDocumentProcessor processor = presentation.AI(options);
        processor.ExecuteInstruction(
            presentation,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
Si les using globaux implicites sont désactivés dans votre projet, ajoutez également using System; et using System.IO; pour Array et Path.
Définir l'entrée, la sortie et l'instruction
inputPath spécifie le document source, tandis que outputPath spécifie où le fichier caviardé sera enregistré. Les extensions d'entrée et de sortie doivent correspondre afin que le résultat reste dans le format d'origine.
L'instruction en langage naturel définit à la fois la portée de la détection et la modification requise. Dans cet exemple, l'agent recherche les types courants d'informations personnelles et les remplace par [REDACTED].
Vous pouvez ajuster l'instruction pour un flux de travail plus restreint. Par exemple :
Find email addresses, phone numbers, and customer account numbers. Replace each detected value with “[REDACTED]”. Do not redact company names, product names, invoice numbers, or dates. Preserve the original layout and formatting.
L'ajout d'exclusions explicites peut réduire les faux positifs lorsqu'un document contient des identifiants d'entreprise qui ressemblent à des numéros de compte personnels.
Configurer le traitement IA
AIOptions stocke le SpireToken utilisé par le service de traitement IA :
AIOptions options = new AIOptions();
options.SpireToken = spireToken;
Le même objet d'options peut être utilisé avec l'instance de document Word, Excel ou PowerPoint.
Sélectionner le type de document approprié
Le programme lit l'extension du fichier et crée l'objet correspondant :
-
Documentpour les fichiers Word -
Workbookpour les fichiers Excel -
Presentationpour les fichiers PowerPoint
Chaque objet expose la méthode d'extension AI(). Celle-ci renvoie un AIDocumentProcessor, qui exécute l'instruction en langage naturel sur le document chargé.
Le tableau de pièces jointes vide indique que l'instruction ne nécessite aucun fichier de support :
processor.ExecuteInstruction(
    document,
    instruction,
    outputPath,
    Array.Empty<string>());
Résultat du caviardage
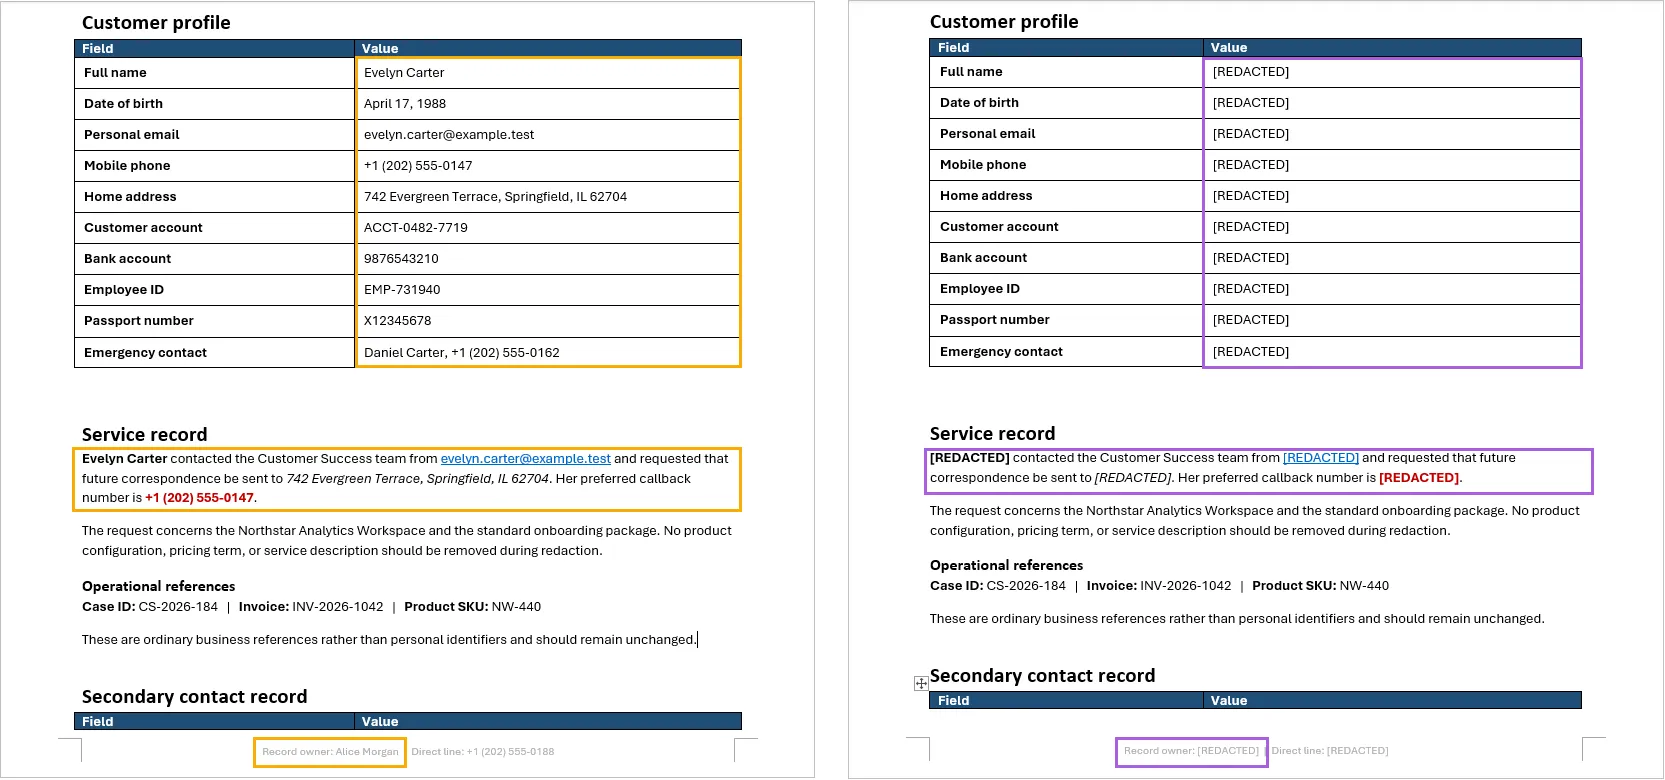
Dans le document Word de test, les informations sensibles apparaissaient dans des paragraphes normaux, dans un tableau d'informations client et dans le pied de page. Après traitement, les noms, adresses e-mail, numéros de téléphone, adresses et informations de compte ont été remplacés par [REDACTED].
La structure du tableau, la mise en forme des paragraphes, les titres, les couleurs et la mise en page du pied de page sont restés en place. Ce résultat est important car il démontre que le flux de travail n'extrait pas simplement le document sous forme de texte brut pour le reconstruire de zéro. Il modifie les éléments pertinents du document tout en conservant leur structure environnante.
Considérations importantes pour le caviardage par IA
Vérifier le résultat avant de le partager
Le caviardage par IA n'est pas parfaitement déterministe. Un modèle peut manquer un identifiant peu courant ou classer à tort un contenu ordinaire comme sensible. Les documents destinés à une diffusion externe doivent être vérifiés après traitement, en particulier dans les flux de travail juridiques, financiers, de santé ou sensibles à la conformité.
Rendre l'instruction précise
L'instruction doit décrire à la fois ce qui doit être supprimé et ce qui doit être conservé. Si les numéros de facture, les noms d'entreprise, les codes produit ou les adresses de bureaux publics ne doivent pas être caviardés, indiquez explicitement ces exclusions.
Le remplacement visible n'est pas toujours une anonymisation complète
Le remplacement du texte visible ne supprime pas nécessairement toutes les copies de l'information du fichier. Les données sensibles peuvent également apparaître dans :
- Les commentaires et les modifications suivies
- Les propriétés et métadonnées du document
- Les feuilles de calcul ou les diapositives masquées
- Les notes du présentateur PowerPoint
- Les fichiers et objets incorporés
- Les images contenant du texte
- Les versions antérieures ou les copies de sauvegarde
Pour les flux de travail à haute sécurité, ces emplacements doivent être inspectés séparément. Si un document contient des pages numérisées ou des captures d'écran, une OCR peut être nécessaire avant que le texte contenu dans les images puisse être évalué.
Préserver le fichier d'origine
Enregistrez le résultat caviardé dans un nouveau chemin au lieu d'écraser le document source. Le fait de conserver les fichiers séparés facilite la comparaison du résultat, l'examen du contenu manqué et la répétition du processus avec une instruction améliorée.
Conclusion
Le caviardage traditionnel basé sur les API offre un contrôle précis, mais les développeurs doivent définir des règles de détection et maintenir une logique de parcours distincte pour différents formats de documents et conteneurs de contenu. L'intégration directe d'un LLM améliore la reconnaissance contextuelle, mais nécessite toujours une couche substantielle d'extraction, de mise en correspondance et de réécriture pour préserver la mise en forme Office.
Un SDK d'agent IA réunit ces capacités. Avec une seule instruction en langage naturel et une petite quantité de code C#, le même flux de travail peut traiter des fichiers Word, Excel et PowerPoint, identifier des informations sensibles contextuelles et les remplacer au sein de la structure d'origine du document. Le résultat doit toujours être vérifié, mais l'implémentation est bien plus simple que la construction manuelle de l'ensemble du pipeline de détection et d'orchestration documentaire.
FAQ
Le même code peut-il caviarder des fichiers Word, Excel et PowerPoint ?
Oui. L'exemple sélectionne Document, Workbook ou Presentation en fonction de l'extension du fichier d'entrée et applique la même instruction en langage naturel à chaque format.
L'agent IA préserve-t-il la mise en forme d'origine ?
L'agent travaille avec les objets de document Office sous-jacents, ce qui permet de remplacer le texte sensible dans les paragraphes, les cellules, les tableaux et les formes tout en conservant la structure et la mise en forme environnantes. Le résultat final doit tout de même être vérifié, car les mises en page particulièrement complexes peuvent nécessiter une vérification supplémentaire.
Puis-je utiliser une autre étiquette de caviardage ?
Oui. Remplacez [REDACTED] dans l'instruction par une autre étiquette, telle que [PRIVATE], [REMOVED], ou une valeur spécifique à une catégorie comme [EMAIL REDACTED].
Quand une API traditionnelle est-elle préférable au caviardage par IA ?
Une API traditionnelle peut être préférable lorsque chaque valeur sensible suit un motif fixe, que les règles changent rarement et que le résultat doit être complètement déterministe. Le remplacement par expressions régulières est souvent suffisant pour les adresses e-mail, les numéros de téléphone ou les numéros d'identification standardisés.
Le remplacement du texte garantit-il que le document peut être publié en toute sécurité ?
Non. Le remplacement du texte visible ne supprime pas automatiquement les commentaires, les modifications suivies, les métadonnées, le contenu masqué, les objets incorporés, le texte présent dans les images ou les versions antérieures du fichier. Les documents sensibles sur le plan de la sécurité nécessitent une inspection et une validation supplémentaires avant leur publication.