Вы можете создать PDF-документ на C# из данных приложения, из HTML-страницы или путем заполнения уже существующего PDF. Каждая отправная точка ведет к отдельному рабочему процессу, а выбор зависит от контроля над макетом, разбиения на страницы при росте содержимого, зависимостей рендеринга, которые должна нести целевая машина, и от того, как вы проверяете результат.
Разделы ниже упорядочивают рабочие процессы Spire.PDF for .NET по исходному материалу и описывают, что каждый из них показал при тестировании, включая моменты, где что-то пошло не так. Тестирование выполнено с Spire.PDF for .NET 12.11.0 (ноябрь 2026 г., Windows 11 Pro, консольное приложение .NET 10).
Быстрая навигация
- Начните с того, что у вас уже есть
- Создание PDF из данных приложения
- Преобразование HTML и CSS в PDF
- Работа с существующими PDF-формами и шаблонами
- Развертывание и проверка выходных данных
- Частые вопросы
- Заключение
1. Начните с того, что у вас уже есть
Начните с материала, который программа содержит во время выполнения: записей из запроса, HTML-страницы или PDF, созданного кем-то другим. Таблица сопоставляет каждый входной тип с рабочим процессом.
| Класс | Входные данные во время выполнения | Рабочий процесс |
|---|---|---|
| Создание нового PDF | Данные приложения / структурированные данные | Координатная или нативная потоковая компоновка |
| Создание нового PDF | HTML/CSS-страница или шаблон | Рендеринг HTML в PDF |
| Существующий PDF | Заполняемая форма (AcroForm) | Заполнение полей формы |
| Существующий PDF | Заполняемая форма (XFA) | Обработка полей XFA |
| Существующий PDF | Фиксированный макет с текстом-заполнителем | Замена текста |
Первые две строки создают новый PDF, поэтому вы управляете макетом и должны решать, как разбиваются страницы. Последние три начинаются с существующего PDF, где файл фиксирует макет, а задача — поместить значения в предусмотренные для них места. Задача создать PDF-отчет на C# из результатов запроса, как ежемесячный отчет QA, используемый в этом руководстве, начинается с первой строки. HTML-шаблон счета, который поддерживает команда фронтенда, начинается со второй, а форма, полученная от поставщика, — с одной из последних трех.
Это руководство охватывает рабочие процессы, поддерживаемые Spire.PDF, а не исчерпывающую таксономию всех методов работы с PDF на C#.
2. Создание PDF из данных приложения
Координатная отрисовка размещает каждый текстовый блок, линию и изображение в указанных вами позициях. Она дает точный контроль над фиксированным дизайном и не требует движка рендеринга помимо библиотеки. Цена проявляется, когда длина содержимого меняется, поскольку разбиение на страницы становится задачей вашего кода: вы отслеживаете, где закончился последний элемент, сами добавляете страницы и пересчитываете позиции при изменении содержимого. Короткий фрагмент показывает этот подход.
var font = new PdfTrueTypeFont("Segoe UI", 11f, PdfFontStyle.Regular, true);
var layout = new PdfTextLayout { Layout = PdfLayoutType.Paginate };
PdfPageBase page = doc.Pages.Add();
float y = 40;

foreach (string text in summaryParagraphs)
{
    var r = new PdfTextWidget(text, font, PdfBrushes.Black)
        .Draw(page, new RectangleF(40, y, 500, 0), layout);
    page = r.Page;                  // the text may have flowed onto a new page
    y = r.Bounds.Bottom + 10;
    if (y > 760) { page = doc.Pages.Add(); y = 40; }   // you own the page breaks
}
Важный шаг — следовать за страницей, которую возвращает результат компоновки: продолжайте рисовать на странице, которую сообщает виджет, и добавляйте новую страницу, когда рамка достигает нижней границы. Отчеты, построенные из DataTable, рассматриваются в отдельном руководстве по преобразованию DataTable в PDF.
Нативная потоковая компоновка избавляет ваш код от разбиения на страницы. PdfContentBuilder, доступный начиная с Spire.PDF for .NET 12.9.18, передает содержимое в секции и разбивает его на страницы по мере роста. Он предлагает заголовки, абзацы, таблицы, построенные из string[][], изображения, списки, блоки кода, шесть типов диаграмм, разрывы страниц и оглавление. Он создает только новые документы, без точки входа для загрузки существующего файла.
Ежемесячный отчет QA ниже использует две секции и одну таблицу. summaryParagraphs, results (это string[][] с заголовком в первой строке) и closing поступают из вашего собственного кода.
using Spire.Pdf;
using Spire.Pdf.Layout;

PdfDocument doc = new PdfDocument();
PdfContentBuilder builder = new PdfContentBuilder(doc);

var s1 = builder.AddSection();
s1.AddHeading1("Monthly QA Report - October");
foreach (var p in summaryParagraphs) s1.AddParagraph(p);
s1.AddTable(results);            // string[][] rows; header row repeats on page breaks

var s2 = builder.AddSection();
s2.AddHeading1("Next Month Outlook");
s2.AddParagraph(closing);

builder.Build();
doc.SaveToFile("QA-Report.pdf");
doc.Dispose();
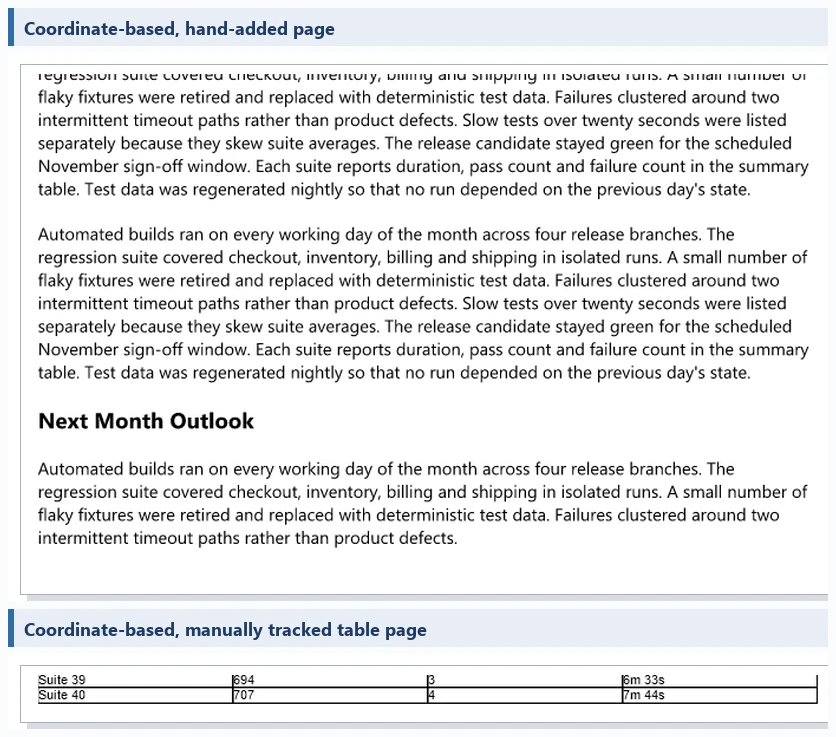
Объем содержимого отличает два подхода. Небольшой отчет (две секции, таблица из пяти строк) занял две страницы за 676 мс. Более крупный с восемью длинными абзацами и таблицей из 40 строк разбился на пять страниц за 1 369 мс (10,8 КБ). То же содержимое, нарисованное с координатами, дало три страницы за 510 мс (28,7 КБ). Эти замеры получены на одной машине с Windows и служат проверкой работоспособности для данной конфигурации. Сравните, как выглядит каждый файл, прежде чем сравнивать скорость его работы.
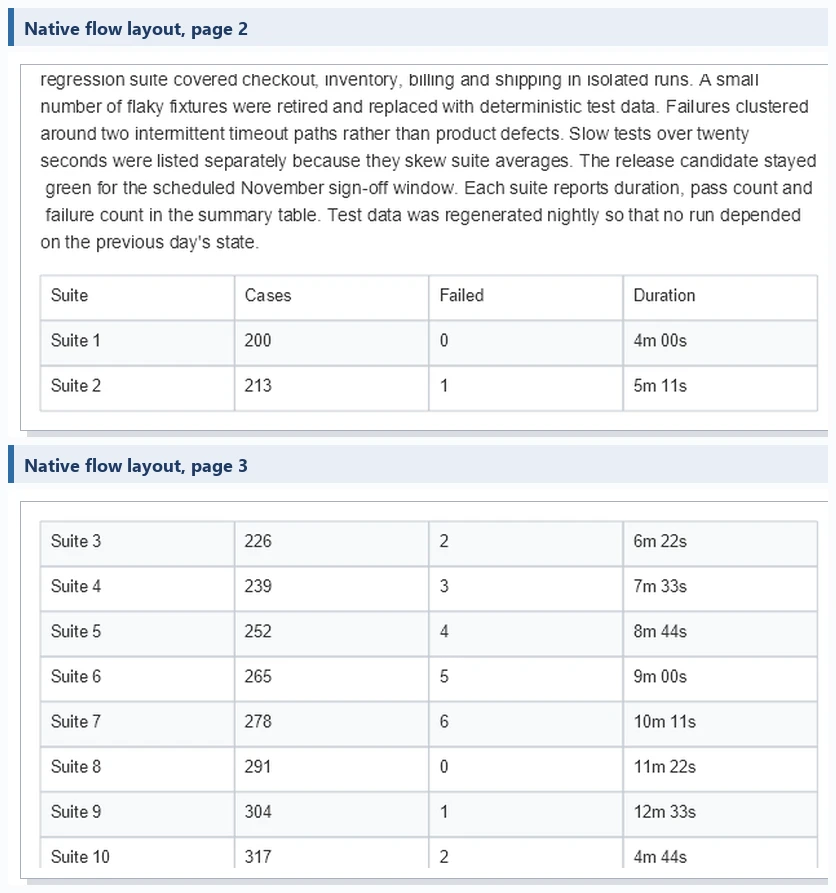
Координатная отрисовка подходит для страниц, структура которых не зависит от объема данных. Потоковая компоновка подходит для документов, длина которых следует за данными, например отчетов и списков. Разработчики, которым нужен более подробный путь ручного составления, могут начать с руководства по созданию PDF-документа на C#.
Нативная потоковая компоновка и рендеринг HTML — это отдельные механизмы. Построитель организует содержимое через собственный API и не читает CSS, тогда как HTML-рендерер разбирает разметку и таблицы стилей, поэтому параметры стилизации и требования к среде выполнения различаются. Таблица сравнивает все рабочие процессы из этого руководства.
| Рабочий процесс | Контроль макета | Динамическое содержимое | Внешние требования к среде выполнения | Основное ограничение |
|---|---|---|---|---|
| Координатный | Явные координаты, элемент за элементом | Вы сами управляете макетом и разбиением на страницы (PdfTextLayout.Paginate) |
Дополнительный движок рендеринга не нужен | Изменение объема содержимого требует переработки координат |
Нативная потоковая компоновка (PdfContentBuilder, 12.9.18+) |
Потоковая передача секций, заголовков и абзацев | Потоковое содержимое; автоматическое разбиение на страницы проверено при тестировании | Дополнительный движок рендеринга не нужен | Только создание; охват элементов соответствует возможностям API (таблицы, изображения, списки, блоки кода, диаграммы, оглавление) |
| HTML в PDF | CSS плюс движок рендеринга | Подходит для содержимого, управляемого HTML | Chromium (путь к Chrome или Edge) или плагин рендеринга Qt | Зависит от среды рендеринга; фоны CSS различаются в разных движках |
| Заполнение AcroForm | Исходный макет полей формы | Заполнение по имени поля | Дополнительный движок рендеринга не нужен | Ограничено определениями полей в файле |
| Замена статического текста | Исходный макет страницы | Замена фиксированного текста | Дополнительный движок рендеринга не нужен | Нет общего динамического перестроения макета |
3. Преобразование HTML и CSS в PDF
Чтобы создать PDF из HTML на C#, Spire.PDF передает страницу движку рендеринга и сохраняет результат печати. Доступны два движка. ChromeHtmlConverter управляет Chromium и принимает путь к исполняемому файлу Chrome или Edge. Вариант Qt, Spire.Additions.Qt.HtmlConverter, зависит от официального пакета плагинов, который содержит HTMLConverter.dll, среду выполнения Qt5 и Html2Pdf.exe. Папка плагинов размещается рядом с исполняемым файлом приложения. Если она отсутствует, вызов завершается с ошибкой Fail to load ...\plugins\HTMLConverter.dll : error 126.
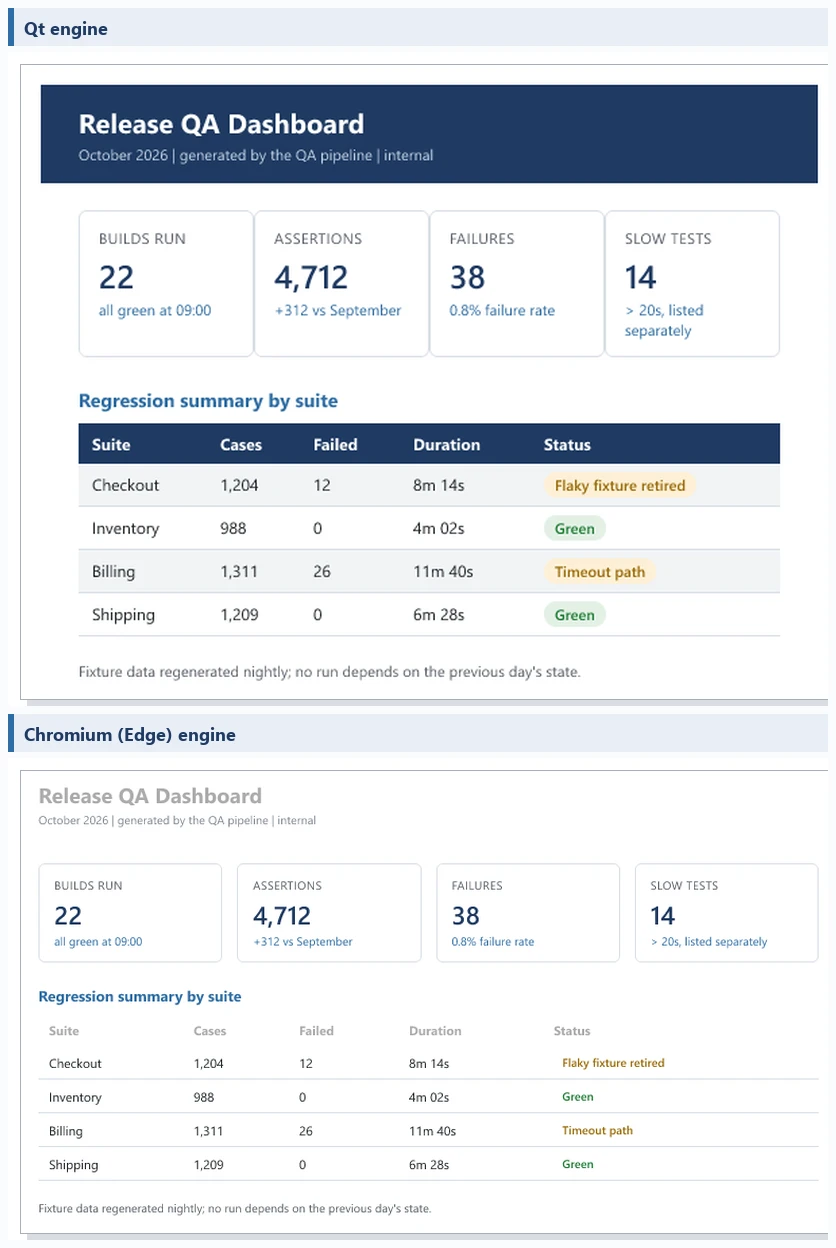
При тестировании один и тот же HTML был пропущен через оба движка. Оба создали две страницы и учли CSS page-break-before. Запуск с Qt занял 4 398 мс и записал файл размером 60,6 КБ с сохраненным темно-синим фоном заголовка таблицы. Запуск с Chromium использовал Edge 157.0.4341.42, бумагу A4 и поля 0,4 дюйма, повторно используя браузер, уже установленный на машине.
Два маршрута имеют разные компромиссы. Qt требует отдельной установки плагина, а Chromium повторно использует установку Chrome или Edge. У каждого движка свои правила печати фонов CSS, а таблица стилей определяет, что запрашивать, например с помощью print-color-adjust: exact. В веб-приложении запускайте преобразование как фоновую задачу, а не внутри запроса.
Несколько моментов не рассматривались: страницы, которые зависят от JavaScript для рендеринга, внешние ресурсы, пользовательские шрифты, одновременная нагрузка на сервере, а также Linux или Docker. Конвертер, который работает на машине разработчика, еще не доказал, что работает в производственном контейнере, и это руководство не проверяло Linux. Для страниц на основе шаблонов с полным пошаговым руководством см. создание PDF из HTML-шаблона на C#.
4. Работа с существующими PDF-формами и шаблонами
Создание PDF из шаблона на C# означает две разные вещи, когда шаблон уже является PDF. Заполняемая форма содержит именованные объекты полей AcroForm. Спроектированная страница может содержать только текст-заполнитель, который выглядит как пустое место. На экране они выглядят одинаково, но в коде ведут себя по-разному.
| Свойство | Поле AcroForm | Статический текст-заполнитель |
|---|---|---|
| Существует в файле как | Объект поля с собственным именем | Обычный текст страницы |
| Определяется по | Имени поля | Самому тексту |
| Интерактивность | Сохраняется до выравнивания | Никогда не интерактивен |
| После выравнивания | Значение становится текстом страницы | Не применимо |
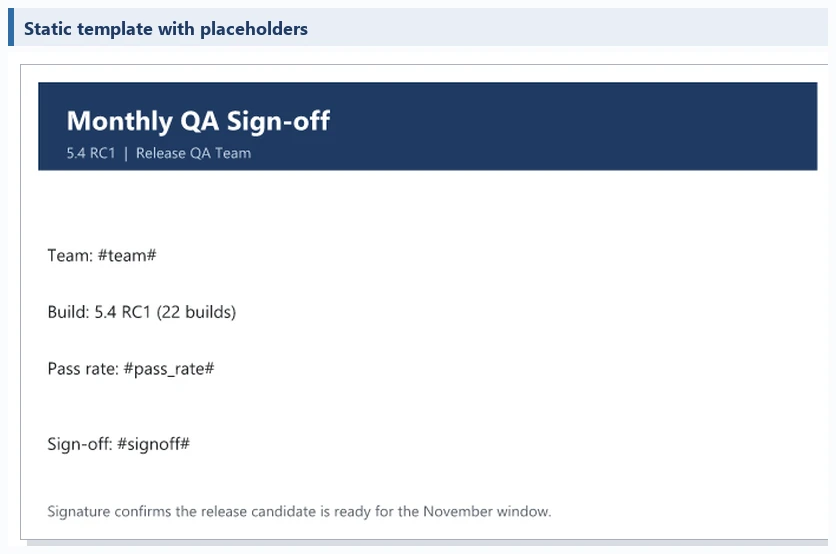
Настоящее поле определяется по имени, заполняется и при необходимости выравнивается. API AcroForm в пространстве имен Spire.Pdf.Interactive.Forms появился в 12.10.7 и был протестирован на 12.11.0.
using Spire.Pdf.Interactive.Forms;

PdfDocument doc = new PdfDocument();
doc.LoadFromFile("existing-form.pdf");
PdfForm form = PdfForm.Create(doc);
var field = form.GetField("team") as PdfTextField;
field.Text = "Release QA";
field.RefreshAppearances();     // without this the value is stored but renders invisible
form.Flatten();                 // after this the value sits in the page text layer
doc.SaveToFile("final.pdf");
При тестировании выявились три особенности поведения:
- Вызывайте
RefreshAppearances()после установкиText, чтобы значение было отрисовано во внешнем виде поля и отображалось сразу. - Значения в полях, которые все еще интерактивны, находятся в слое формы; после выравнивания количество полей уменьшилось с 4 до 0, а значения перешли в текст страницы, откуда их читает
PdfTextExtractor. -
AddWidgetпринимает координаты уровня страницы, тогда как позицииpage.Canvasотсчитываются относительно полей; не смешивайте две системы при размещении виджетов.
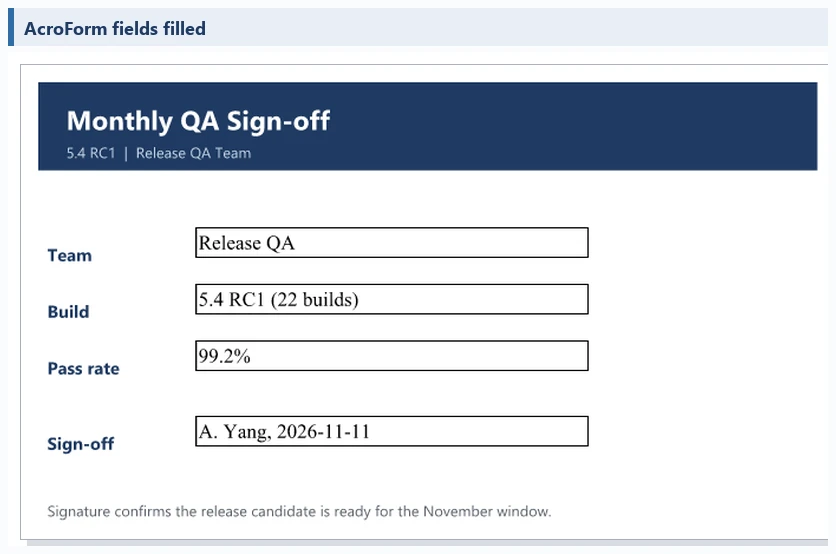
Данные формы также можно выгрузить из файла как XFDF с помощью form.ExportData(path, DataFormat.XFDF, ...), что при тестировании дало стандартный XFDF. Руководство по импорту и экспорту данных PDF-форм рассматривает это подробнее.
Фиксированный текст-заполнитель работает на готовой странице, когда вставляемые значения близки по размеру к заменяемым маркерам. Замена сохраняет исходный макет, поэтому проверьте, что каждое новое значение помещается в пространство, оставленное оригиналом.
XFA-формы — это отдельный тип форм. Документированная возможность — чтение и изменение поддерживаемых полей через объект XFA-формы; проверьте рабочий процесс на собственных образцах в рамках оценки.
5. Развертывание и проверка выходных данных
Все в этом руководстве выполнялось на машине разработчика с Windows. Linux, Docker и серверный хостинг в этом руководстве не проверялись. HTML-движкам требуется больше всего внимания в других средах: маршруту Chromium нужен исполняемый файл браузера на целевой машине, а маршруту Qt нужна папка плагинов рядом с приложением. Spire.PDF публикует официальные пакеты плагинов для Linux и macOS. Протестируйте их в собственном образе развертывания, прежде чем полагаться на них, и измерьте время преобразования на целевом хосте, поскольку приведенные выше замеры получены на машине разработчика.
Проблемы при создании PDF редко вызывают исключения: файл создается, а все, что пошло не так, проявляется только в самом выходном файле. Поэтому приведенные ниже проверки исследуют файл, а не полагаются на то, что код выполнился без ошибок.
| Проверка | Что выявляет | Как |
|---|---|---|
| Количество страниц | Разбиение на страницы, которое затянулось, остановилось раньше времени или не продвигалось | check.Pages.Count |
| Извлечение текста | Отсутствующие заголовки или данные, оставшиеся маркеры-заполнители |
PdfTextExtractor на каждой странице |
| Проверка формы | Значения, которые так и не попали в поле | Считывайте значения полей через API до выравнивания; после выравнивания снова откройте файл и проверьте видимое содержимое |
| Визуальный осмотр | Переполнение текста, неверные разрывы страниц, подставленные шрифты, отсутствующие изображения | Откройте PDF и просмотрите каждую страницу |
PdfDocument check = new PdfDocument();
check.LoadFromFile("QA-Report.pdf");
Console.WriteLine(check.Pages.Count);                        // expected page count

string text = new PdfTextExtractor(check.Pages[0])
    .ExtractText(new PdfTextExtractOptions());               // titles, data, leftovers
Console.WriteLine(text.Contains("#"));                       // a stray placeholder marker
Извлечение текста не заменяет просмотр страниц. Оно подтверждает, что символы существуют в файле, и ничего не говорит о переполнении, обрезке или фоне заголовка, который не напечатался. Сопоставляйте проверки с рабочим процессом: количество страниц и визуальный осмотр для координатного и потокового вывода, визуальный осмотр фонов для HTML-вывода и считывание через API до выравнивания для форм. Для задач создания отчетов выполняйте первые три проверки в тестовом конвейере и повторяйте визуальный осмотр при каждом изменении шаблона или макета. Сохраняйте один эталонный результат для каждого рабочего процесса и сравнивайте его после обновлений библиотеки, поскольку все результаты здесь привязаны к 12.11.0.
6. Частые вопросы
В чем разница между созданием и генерацией PDF на C#?
На уровне API разницы нет. Обе фразы описывают создание PDF-файла из кода. Важны входные данные: данные приложения, HTML-страница или существующий PDF с полями или текстом-заполнителем. Выбирайте рабочий процесс исходя из этих входных данных, как показывает таблица решений в этом руководстве.
Можно ли создать PDF на C# без библиотеки?
Технически да, поскольку PDF — это документированный формат файла, который код может записывать напрямую. На практике затраты ложатся на встраивание шрифтов, сжатие потоков, поддержку извлечения текста и согласованность рендеринга в разных программах просмотра. Для каждого из этих пунктов нужен собственный код и тестирование, а библиотека берет эту работу на себя.
Как выбрать между созданием в коде и рендерингом HTML?
Решайте по тому, кто владеет макетом. Если им владеют разработчики и данные определяют структуру, создавайте PDF в коде. Если дизайнеры уже поддерживают HTML и CSS, рендерьте эту страницу и примите зависимость от движка рендеринга. Выбирайте код, когда данные определяют страницу, и HTML, когда страница определяет выходные данные.
7. Заключение
Данные приложения указывают на координатную отрисовку или нативную потоковую компоновку, и потоковая компоновка при тестировании разбивала страницы автоматически. HTML-страница указывает на движок рендеринга, который при тестировании влиял на время преобразования, печать фонов и требования к целевой машине. Существующий PDF указывает на поля формы там, где они есть, и на замену текста там, где макет фиксирован. Проверяйте количество страниц, извлеченный текст и отрисованные страницы, прежде чем выпускать любой из этих файлов.
Если вам нужно протестировать Spire.PDF for .NET в реальной бизнес-среде, вы можете запросить временную лицензию.