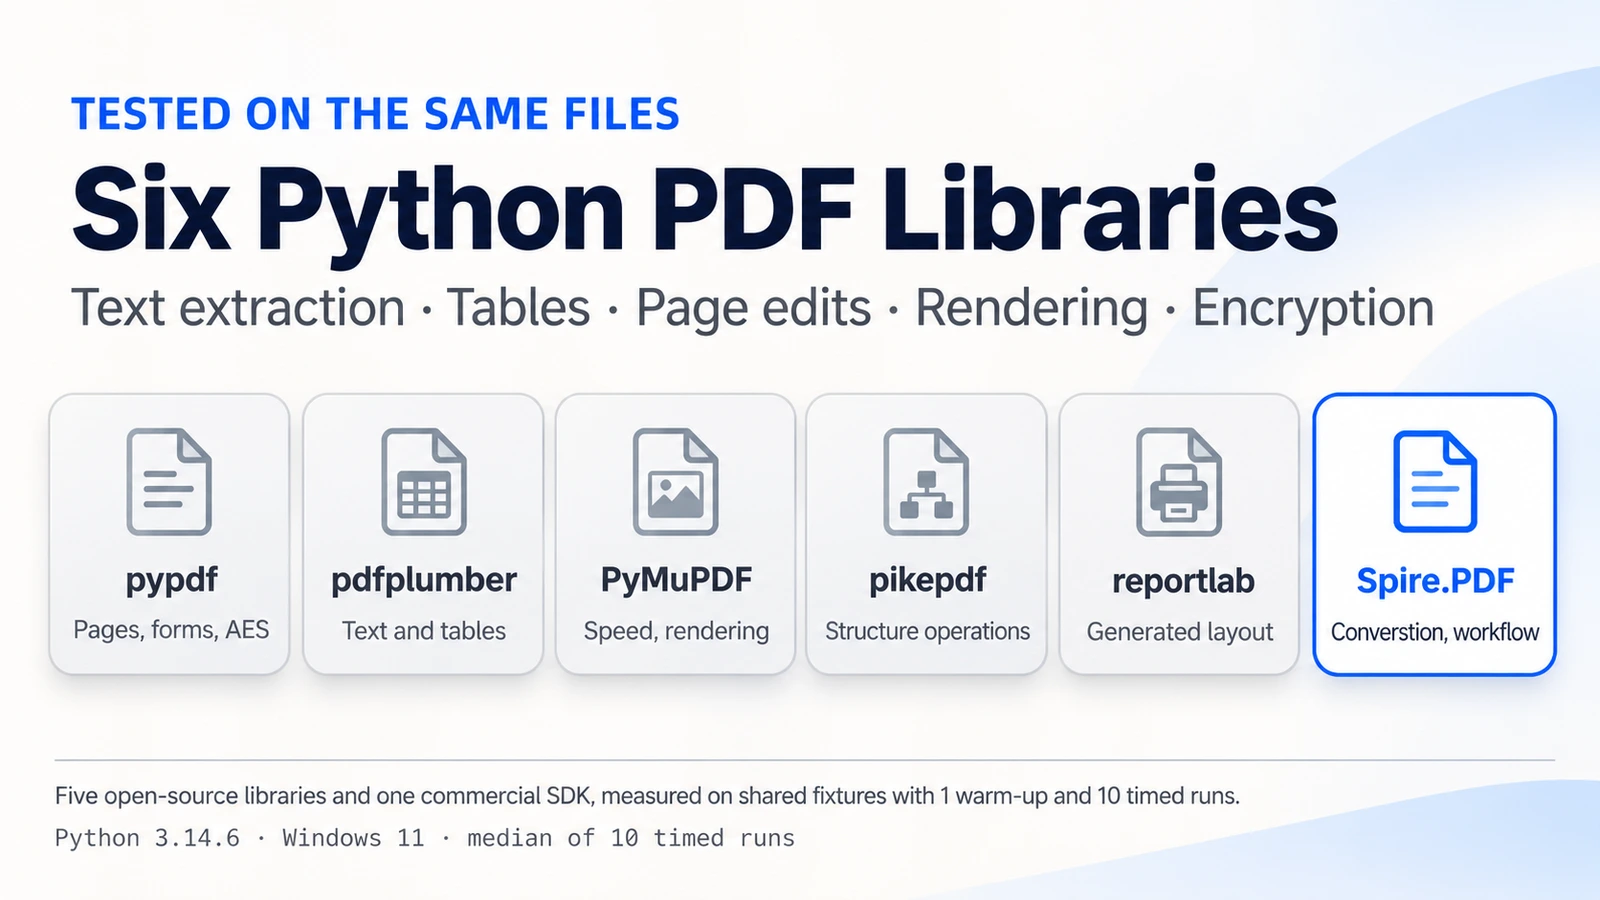
Прочитать PDF с помощью pypdf — задача на десять минут. Проблемы начинаются, когда тот же сценарий должен извлечь сводную таблицу с первой страницы, удалить приложение, вернуть редактируемую копию Word и защитить архив паролем. Для каждого запроса есть хорошее решение на Python, но они редко находятся в одном пакете.
Это руководство сравнивает шесть вариантов на одном наборе тестовых файлов: pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab и Spire.PDF for Python. Раскрытие информации: Spire.PDF — коммерческий продукт E-iceblue, издателя этой статьи, и E-iceblue проводила тесты. Тестовые наборы, версии и методика замера времени перечислены в разделе «Как мы тестировали», чтобы вы могли повторить любой результат. Каждая библиотека ниже — разумный выбор для задачи, для которой она создана.
Какую библиотеку Python для PDF выбрать?
Если ваша работа — одна операция, выберите специалиста для неё. Open-source библиотеки в этом сравнении сильны в своих задачах. Spire.PDF нацелен на другой случай: конвейер, в котором один документ проходит через извлечение, редактирование, конвертацию и шифрование, и вы предпочитаете поддерживать один SDK, а не три библиотеки.
| Библиотека | Лучше всего подходит для | Ключевое соображение | Лицензия |
|---|---|---|---|
| pypdf | Объединение, разделение, поворот и шифрование страниц на чистом Python | Для шифрования AES требуется дополнительный пакет pypdf[crypto]
|
BSD-3 |
| pdfplumber | Анализ макета, извлечение таблиц, визуальная отладка | Создана для чтения, а не для изменения страниц | MIT |
| PyMuPDF | Быстрое извлечение текста и рендеринг страниц | AGPL-3.0 или коммерческая; оцените с учётом способа распространения | AGPL-3.0 или коммерческая |
| pikepdf | Работа со структурой низкого уровня, линеаризация, шифрование | Нет API для извлечения текста | MPL-2.0 |
| reportlab | Генерация PDF из кода | Только генерация | BSD |
| Spire.PDF | Смешанные задачи (извлечение, редактирование, конвертация, шифрование) в одном SDK | Коммерческая лицензия; доступны бесплатная, ознакомительная и временная лицензии | Коммерческая |
Читайте таблицу по задачам, а не по названиям. Если вашему конвейеру нужна только операция из первого столбца библиотеки, третий столбец — единственное, что осталось взвесить. Условия лицензий и вес установки обычно решают выбор между близкими кандидатами, и разделы ниже дают цифры по обоим пунктам.
Примечание об охвате: это пять выбранных open-source библиотек и один коммерческий SDK. Охват не включает все специализированные PDF-инструменты экосистемы Python.
В чём сильны выбранные open-source библиотеки Python для PDF
Люди, которые ищут библиотеку Python для разбора PDF или библиотеку Python для чтения PDF, обычно имеют в виду одно из двух: извлечение текста и таблиц из существующих файлов или перестройку самих файлов. Пять библиотек ниже разделяются по этой линии. pdfplumber и PyMuPDF сильнее всего на стороне чтения, pypdf и pikepdf — на стороне структуры страниц, а reportlab — на стороне создания документов с нуля. В каждом пункте указаны направленность библиотеки, что мы измеряли и где заканчивается её область применения.
pypdf
pypdf — библиотека на чистом Python для работы на уровне страниц; в нашей чистой среде её установленный размер составлял 1,8 МБ. В наших запусках она извлекла 10-страничный текстовый документ за 43,1 мс, повернула страницу за 9,2 мс, удалила страницу за 8,6 мс, объединила два файла за 14,7 мс, выделила три страницы за 10,2 мс и применила шифрование AES-256 за 19,6 мс. Для AES требуется дополнительный пакет pypdf[crypto], который увеличивает установку до 13,2 МБ. Это естественный первый выбор, когда вы реорганизуете страницы и не хотите скомпилированных зависимостей; защита AES подключает дополнительный пакет crypto, указанный выше.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
Сценарий объединяет два файла, поворачивает первую страницу и записывает копию, защищённую AES-256.
pdfplumber
pdfplumber — инструмент, к которому стоит обратиться, когда нужно увидеть, как размещена страница. Он предоставляет координаты символов, линий и прямоугольников, что делает извлечение таблиц и визуальную отладку практичными. Таблица 21 × 4 с рамками в нашем тестовом наборе была получена за 44,6 мс, а извлечение обычного текста с десяти страниц заняло 320,4 мс — дольше, чем у читателей, ориентированных на текст, при этом библиотека также предоставляет позиционные данные, на которые опираются анализ макета и работа с таблицами. Одностраничный счёт на китайском был прочитан за 7,7 мс и вернул ожидаемую фразу «发票编号». Она читает PDF и не изменяет их, поэтому обычно используется вместе со второй библиотекой.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
Вызов возвращает первую таблицу на первой странице в виде списка строк.
PyMuPDF
PyMuPDF объединяет обработку текста и рендеринг поверх скомпилированного движка. В тесте у него было самое низкое время извлечения текста — 7,2 мс для десяти страниц; страницу он удалил за 3,0 мс, а рендеринг страницы при 150 DPI занял 48,8 мс. Установка по умолчанию занимает 201,3 МБ вместе с зависимостями (104,5 МБ с --no-deps), поэтому это самый тяжёлый вариант здесь, а лицензия — AGPL-3.0 или коммерческая. Если ваш сервис создаёт эскизы или пропускает много страниц через извлечение текста, цифры объясняют его популярность.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
Фрагмент читает текст первой страницы и сохраняет её PNG с разрешением 150 DPI.
pikepdf
pikepdf оборачивает библиотеку QPDF и работает с самой объектной структурой PDF. Это подходит для таких задач, как поворот или удаление страниц (6,4 мс и 5,8 мс), изменение их порядка (6,5 мс), применение шифрования AES-256 с обработчиком ревизии 6 (32,0 мс) и сохранение линеаризованного файла для веб-доставки (7,8 мс). Он не предлагает API для извлечения текста, поэтому команды обычно используют его вместе с программой чтения. Выбирайте его, когда нужны низкоуровневая работа с объектами PDF, перестройка страниц, шифрование или линеаризация.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
Код задаёт поворот первой страницы на 90 градусов и сохраняет результат.
reportlab
reportlab существует для создания PDF и делает это с полным контролем над шрифтами, координатами и потоковой вёрсткой. В тесте он создал 10-страничный документ, по 40 строк на странице, Arial 10 пт, за 14,1 мс. Он не предназначен для чтения или редактирования существующих файлов, и это чёткая граница, а не пробел: счета, этикетки и сгенерированные отчёты — там, где он оправдывает своё место.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
Цикл создаёт 10-страничный файл A4 с 40 строками на странице.
Когда рабочий процесс PDF с несколькими библиотеками становится сложно поддерживать
Ничто из перечисленного выше не является недостатком. Трудности появляются, когда для одного требования нужно последовательно использовать несколько таких библиотек, и каждый добавленный инструмент несёт издержки, которых не видно в одной строке бенчмарка:
- Для конвертации нужен отдельный конвертер. Преобразование PDF в Word не входит в перечисленные выше программы чтения и редактирования страниц, поэтому вы добавляете ещё один инструмент, а точность макета приходится проверять файл за файлом.
- Редактирование текста на месте — отдельная задача. Операции со страницами перемещают или удаляют целые страницы; для изменения слов внутри страницы нужно другое средство.
- Сложные формы — отдельная тема. Чтение простых полей — одно, а создание и уплощение форм — другое, и библиотеки различаются по глубине поддержки.
- Подписи и PDF/A требуют дополнительных инструментов. Рабочие процессы архивирования и подписания обычно требуют дополнительных пакетов.
- OCR по своей природе внешний. Для сканированных страниц нужен движок, не входящий ни в одну из этих библиотек.
Полезна конкретная картина. Типичный связующий сценарий открывает файл в одной библиотеке, записывает промежуточный файл, повторно открывает этот файл во второй библиотеке, снова сохраняет, а затем передаёт результат конвертеру, который разбирает его в третий раз. Каждая передача — место, где могут измениться шрифты, границы страниц или флаги шифрования, и каждая требует собственного теста. Ничего из этого не сложно написать; именно эта часть продолжает расти по мере изменения требований.
Под всеми пятью лежит одна и та же дополнительная нагрузка: ещё один API для изучения, ещё одно дерево зависимостей, ещё одна матрица совместимости и ещё один путь обработки ошибок, а также передача файлов между инструментами.
Лицензирование заслуживает отдельной строки. Распространённый конвертер pdf2docx имеет лицензию MIT и зависит от PyMuPDF, который распространяется по AGPL-3.0 или коммерческой лицензии. Это два отдельных факта, и распространяемый продукт должен оценивать оба. Чтобы подробнее рассмотреть сторону чтения, см. наше руководство по разбору PDF в Python.
Что Spire.PDF for Python добавляет к рабочим процессам PDF
Spire.PDF for Python — коммерческий SDK, который выполняет чтение, редактирование, конвертацию, обеспечение безопасности и генерацию в рамках одного пакета. Для сравнения важны четыре области.
1. Общая модель документа и согласованный API
Общая модель документа и согласованный Python API позволяют разработчикам выполнять несколько операций с PDF в одном SDK. Специализированные вспомогательные классы, например PdfTableExtractor, работают с загруженным PdfDocument. Один и тот же загруженный PdfDocument можно использовать для нескольких операций, не передавая промежуточные PDF-файлы между отдельными библиотеками. Это также означает один шаблон обработки ошибок и один набор ограничений версий, которые нужно отслеживать при обновлении.
2. Производительность извлечения таблиц в нашем бенчмарке
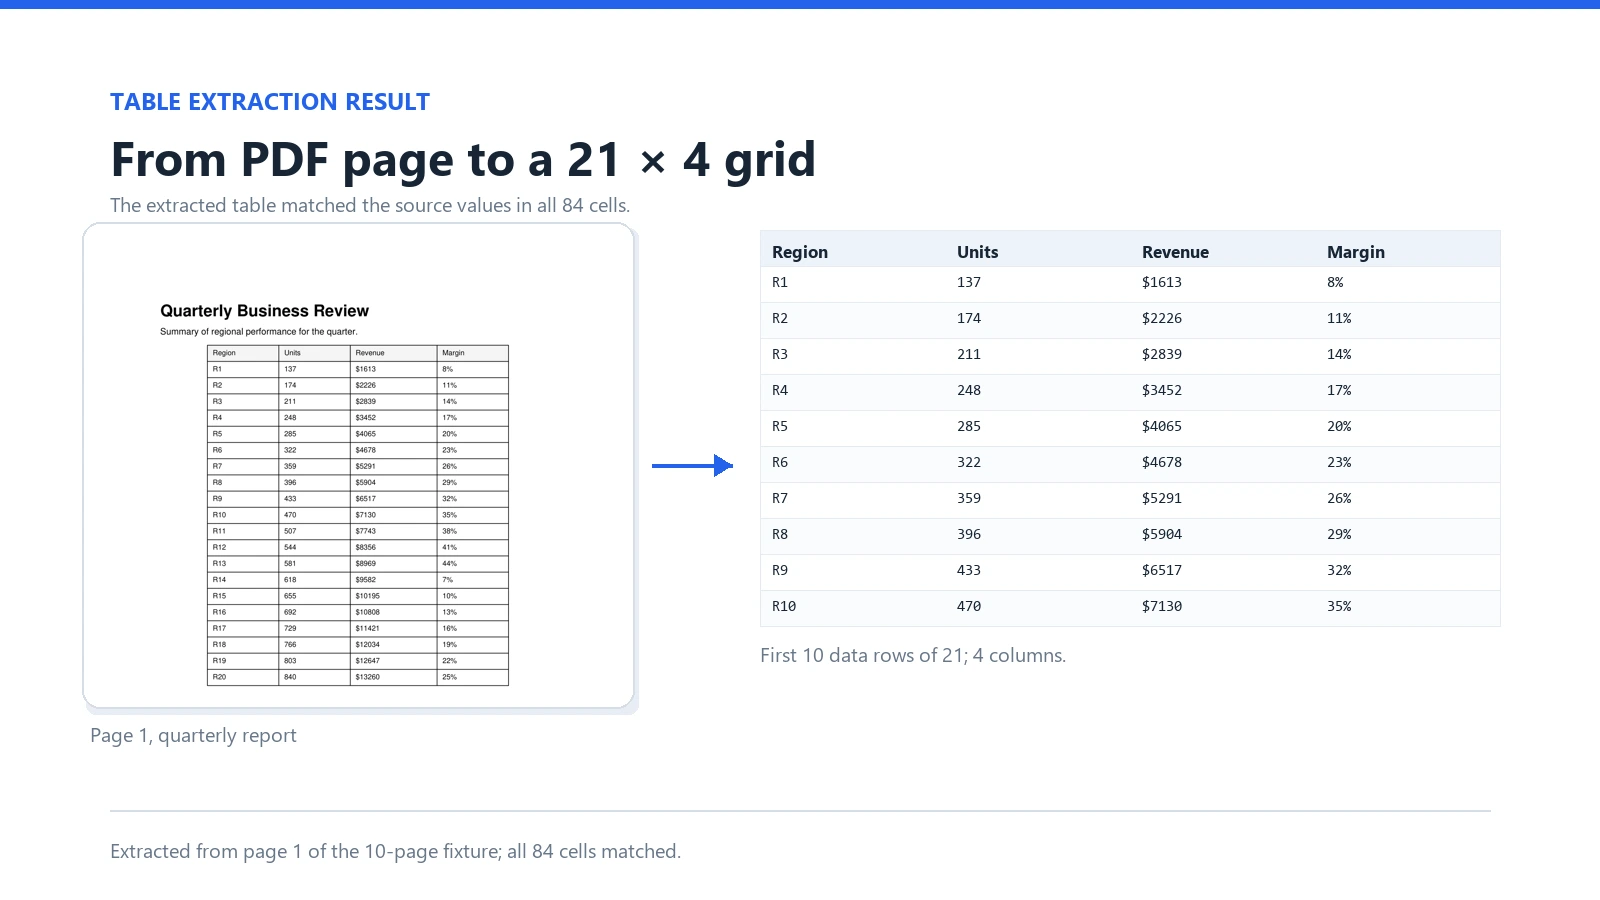
Мы прогнали одну и ту же таблицу с рамками через три библиотеки. Тестовый набор содержит 21 строку и 4 столбца, имеет чётко нарисованные границы и не содержит объединённых ячеек. Официальная документация говорит, что извлечение таблиц лучше всего работает с чётко отформатированными таблицами, поэтому эти результаты описывают только такие таблицы.
| Библиотека | Медиана | Диапазон | Результат |
|---|---|---|---|
| Spire.PDF | 18,9 мс | 16,2–26,4 мс | 21 × 4, все 84 ячейки верны |
| pdfplumber | 44,6 мс | 42,3–53,7 мс | 21 × 4, все 84 ячейки верны |
| PyMuPDF | 363,4 мс | 341,6–385,7 мс | 21 × 4, все 84 ячейки верны |
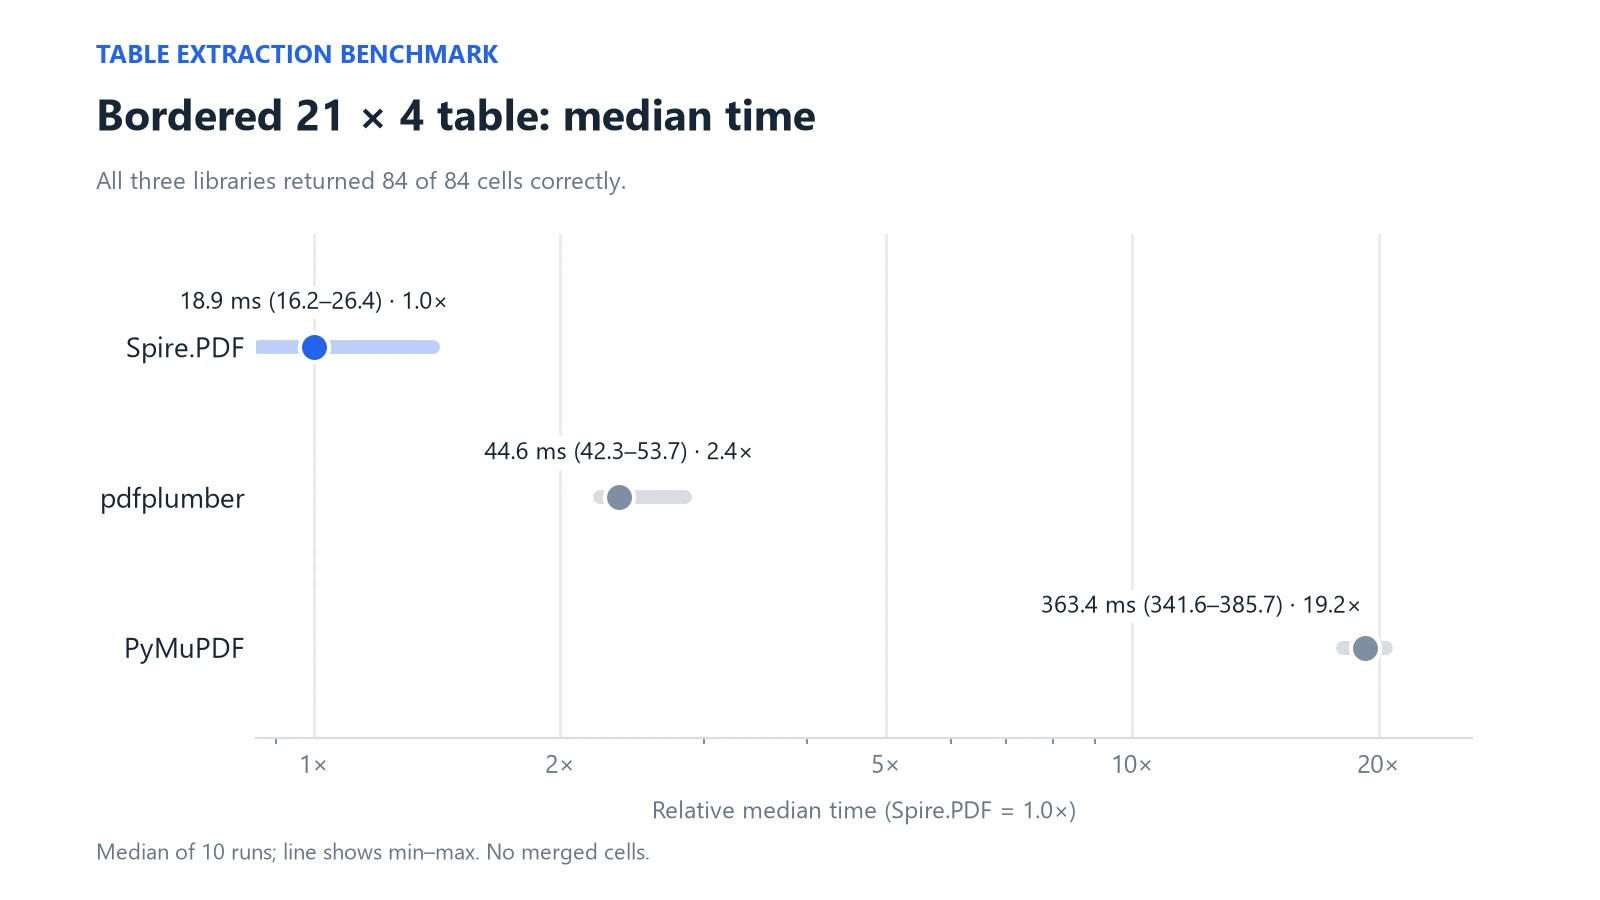
Все три вернули одинаковое содержимое ячеек, поэтому сравнение идёт о времени при равной корректности. Spire.PDF показал самую низкую медиану в этом тесте. Таблицы с объединёнными ячейками, отсутствующими границами или сканированные страницы не измерялись и могут дать другой рейтинг. Пошаговое руководство по тому же API см. в статье извлечение таблиц из PDF в Python.
3. Формы
Spire.PDF for Python документирует API для создания и заполнения полей форм, а также для их уплощения в статическое содержимое. Обработка форм не входила в наш бенчмарк производительности, поэтому в этом разделе описаны только документированные возможности.
4. Экспорт в другие форматы
Один и тот же загруженный документ можно сохранить в нескольких форматах. В наших запусках приведённые ниже результаты были получены из 10-страничного отчёта.
| Направление | Глубина проверки |
|---|---|
| PDF в DOCX, HTML, Markdown | Результат создан; текстовое содержимое проверено |
| PDF в XLSX | Результат создан; содержимое ячеек присутствует; структура зависит от исходного макета |
| PDF в PNG, XPS, SVG, PPTX | Результат создан; визуальная точность зависит от исходного макета |
| PDF в PDF/A-1a и PDF/A-1b | Методы конвертации доступны; результат создан и идентификаторы XMP проверены; формальное соответствие PDF/A независимо не проверялось |
Результат конвертации зависит от исходного макета; проверяйте репрезентативные файлы перед использованием в производстве. Подробнее о преобразовании в DOCX см. руководство по конвертации PDF в Word в Python.
Многоэтапный рабочий процесс PDF в Python
Чтобы увидеть аргумент о поддержке в коде, мы взяли реалистичную задачу. Из 40-страничного квартального отчёта нужно извлечь сводную таблицу и удалить страницы приложения. Из обновлённого файла требуются два результата: редактируемый DOCX и PDF-архив, зашифрованный AES-256.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
Open-source реализация использует pdfplumber для таблицы, pypdf[crypto] для удаления страниц и шифрования, а pdf2docx — для копии Word. Это три пакета, которые напрямую работают с PDF. Установленные вместе в чистой среде, они дают 29 дистрибутивов и 388,9 МБ против 70,5 МБ у Spire.PDF, измеренного тем же способом.
Со Spire.PDF весь процесс остаётся внутри одного объекта документа:
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
Для сопоставимого сравнения времени обе реализации запускались на 10-страничной версии отчёта. Три open-source пакета заняли в сумме медиану 1 346,2 мс, а Spire.PDF — 267,3 мс. Обе реализации правильно извлекли все 84 ячейки таблицы, и обе создали 9-страничный зашифрованный PDF, который открывался с паролем. Оба архива не открывались без пароля. На 40-страничном отчёте open-source стек занял 3 241,4 мс и создал 39 страниц; ознакомительная сборка Spire.PDF обрабатывает только первые 10 страниц, поэтому этот запуск мы не сравниваем (см. раздел о редакциях).
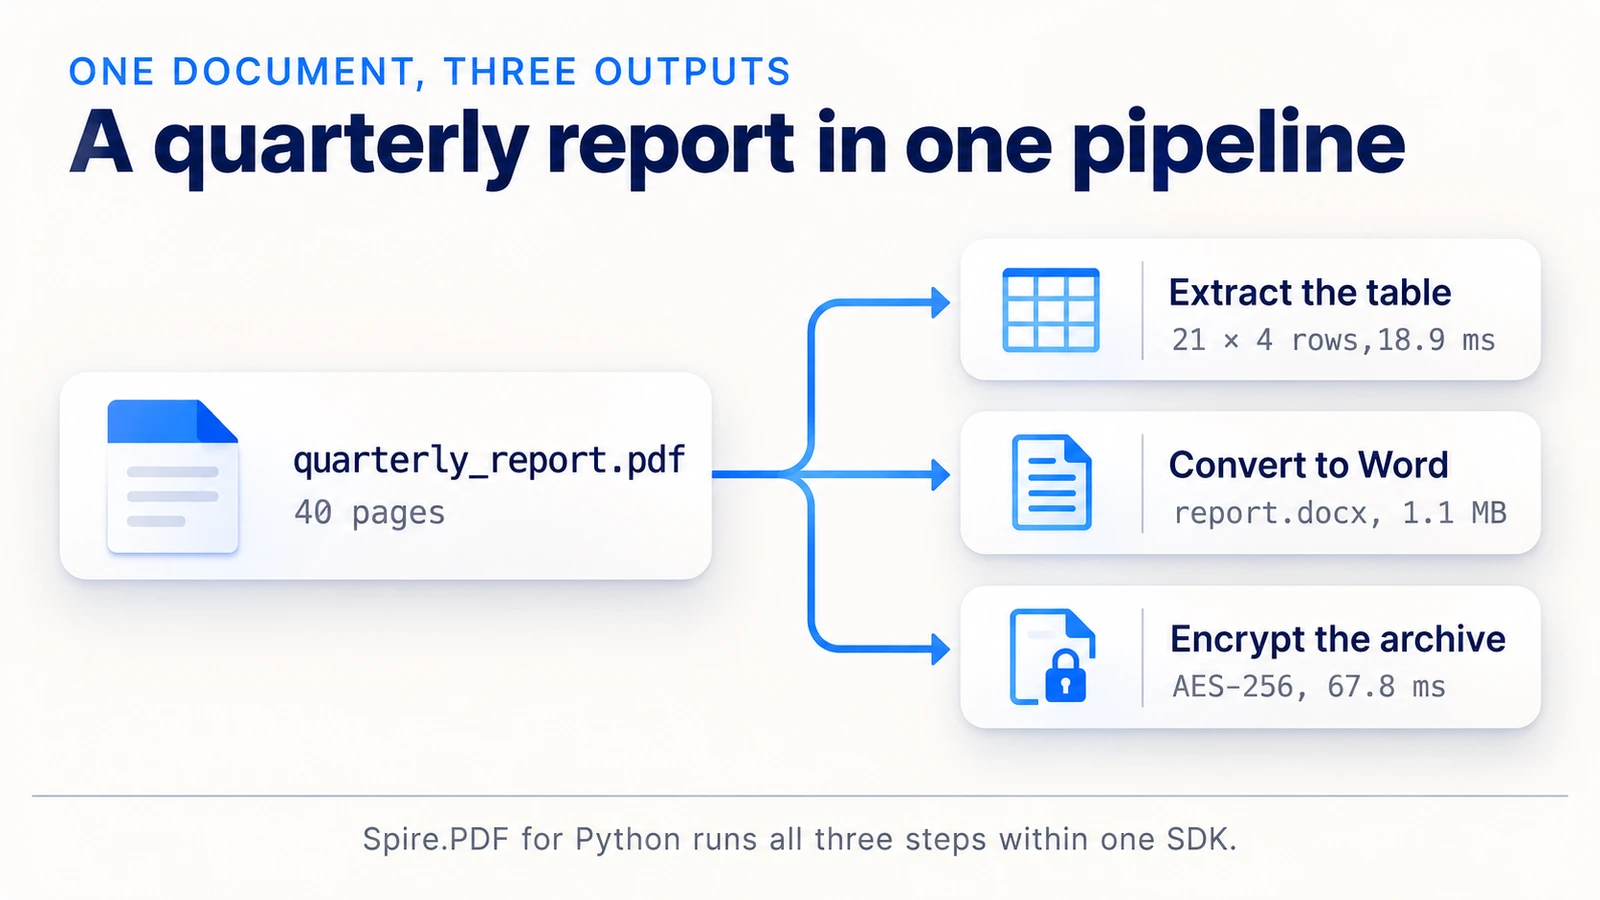
Это сравнение охватывает извлечение таблиц, удаление страниц, генерацию DOCX и PDF, шифрование и затраченное время; точность макета DOCX находится за пределами этого сравнения времени и должна проверяться на ваших собственных файлах. Большая часть разницы во времени приходится на этап DOCX, где open-source конвертер затратил около 1,3 с. Смысл упражнения меньше в секундомере, чем в форме кода: один импорт, один объект документа, никаких файлов, передаваемых между пакетами. Подробнее об обработке паролей см. в статье защита и снятие защиты PDF-документов в Python.
Производительность и размер установки
Каждое число ниже — медиана 10 запусков с замером времени после одного прогрева, в миллисекундах, с минимумом и максимумом в скобках. Каждая цифра — сквозное время операции: открытие тестового файла и сохранение результата включены, где применимо. «н/д» означает, что у библиотеки нет такой операции.
| Задача | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| Текст, 10 страниц | 43,1 (39,9–46,1) | 320,4 (295,5–573,8) | 7,2 (6,7–8,4) | н/д | н/д | 58,2 (53,8–64,6) |
| Таблица, 84 ячейки | н/д | 44,6 (42,3–53,7) | 363,4 (341,6–385,7) | н/д | н/д | 18,9 (16,2–26,4) |
| Поворот одной страницы | 9,2 (8,5–13,1) | н/д | 3,8 (2,7–11,0) | 6,4 (5,6–7,7) | н/д | 22,4 (20,6–29,9) |
| Удаление одной страницы | 8,6 (8,2–14,7) | н/д | 3,0 (2,8–3,4) | 5,8 (5,5–6,9) | н/д | 23,3 (20,2–27,8) |
| Рендеринг при 150 DPI | н/д | н/д | 48,8 (47,2–52,3) | н/д | н/д | 161,4 (153,8–180,3) |
| Шифрование AES-256 | 19,6 (17,2–24,6) | н/д | н/д | 32,0 (30,9–34,4) | н/д | 67,8 (62,1–72,2) |
| Генерация 10 страниц | н/д | н/д | н/д | н/д | 14,1 (13,7–15,3) | 85,3 (79,4–106,9) |
В отдельных операциях специалисты лидируют в большинстве строк: PyMuPDF — в тексте, повороте, удалении и рендеринге, pypdf — в правке страниц на чистом Python, pikepdf — в структурной работе, и обе — в шифровании, а reportlab — в генерации. У Spire.PDF самая низкая медиана была в тесте таблиц. При генерации сравнивались 10 страниц по 40 строк, A4, Arial 10 пт. В тесте рендеринга PyMuPDF и Spire.PDF оба создали изображения 1241 × 1754 пикселя при 150 DPI. Ценность одного SDK проявляется в комбинированных рабочих процессах, а не в какой-либо отдельной строке.
Установка, измеренная в чистой виртуальной среде и без учёта интерпретатора, pip, setuptools, wheel и __pycache__:
| Цель | Установленный размер | Пакеты | Импорт в новом процессе |
|---|---|---|---|
| pypdf | 1,8 МБ | 1 | 219,9 мс |
| pypdf[crypto] | 13,2 МБ | 4 | 331,8 мс |
| pdfplumber | 43,9 МБ | 8 | 246,5 мс |
| PyMuPDF (по умолчанию) | 201,3 МБ | 12 | 223,8 мс |
PyMuPDF (--no-deps) |
104,5 МБ | 1 | 217,0 мс |
| pikepdf | 35,2 МБ | 4 | 178,4 мс |
| reportlab | 20,4 МБ | 3 | 9,0 мс |
| Spire.PDF | 70,5 МБ | 2 | 640,6 мс |
| Стек рабочего процесса из трёх пакетов | 388,9 МБ | 29 | н/д |
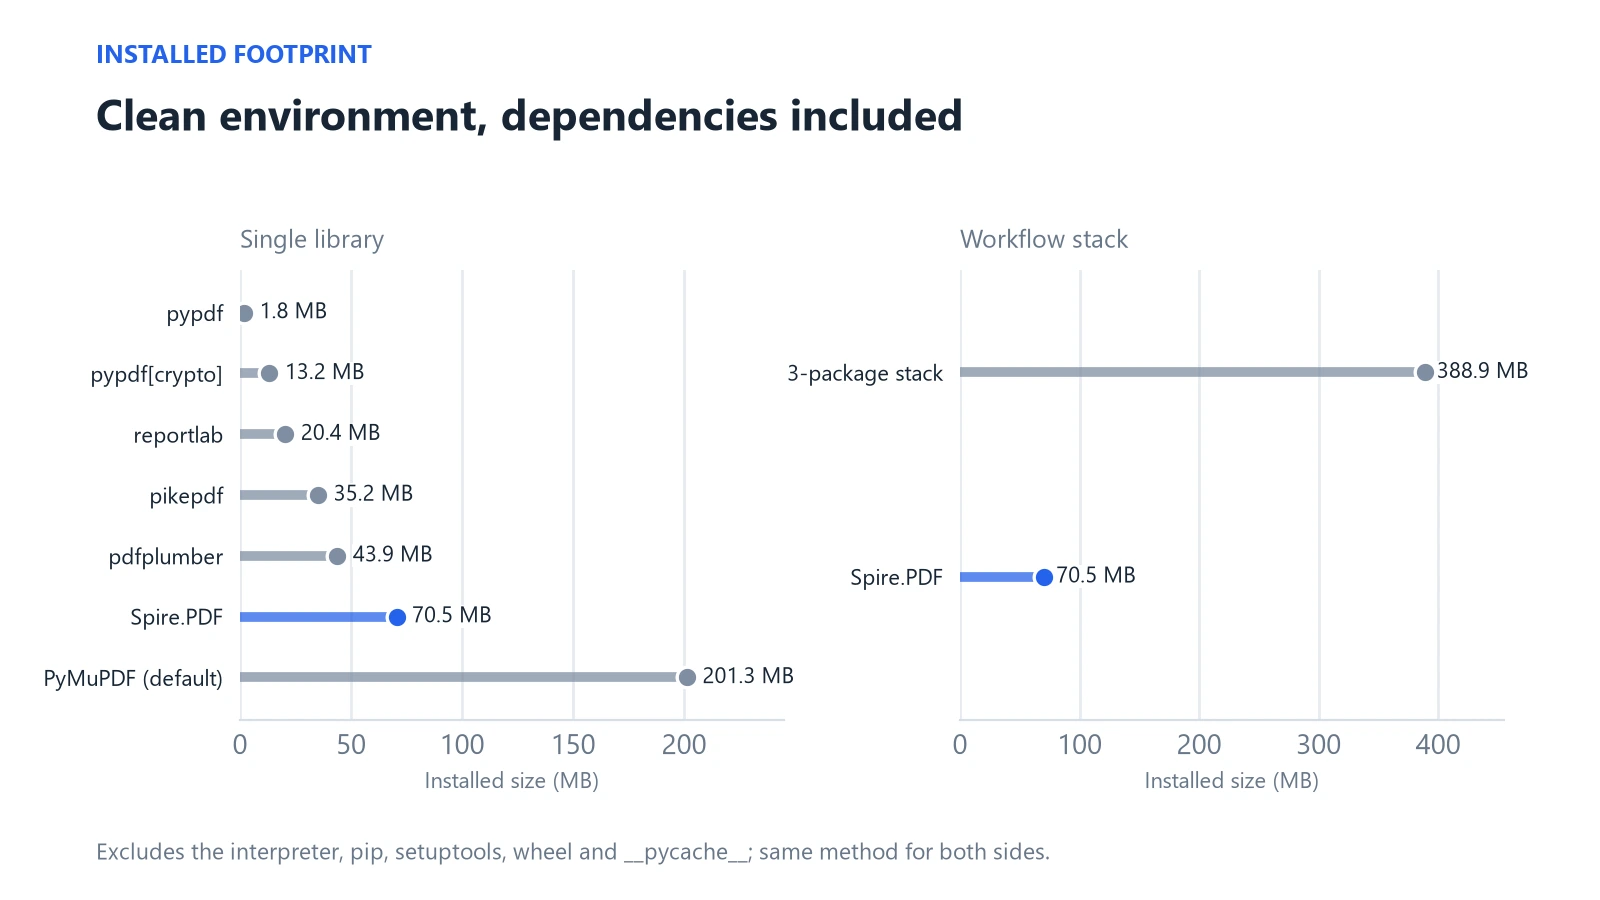
Две детали стоит вынести из таблицы установки. Время импорта — разовая стоимость на процесс, поэтому оно важнее для короткоживущих задач командной строки и бессерверных функций, чем для долго работающих сервисов; холодный импорт Spire.PDF составил 640,6 мс, всё ещё меньше секунды, а у reportlab он был самым коротким — 9,0 мс. Размер установки важен для образов контейнеров и упаковки настольных приложений, где выделяются PyMuPDF с 201,3 МБ по умолчанию и стек из трёх пакетов на 388,9 МБ.
Лицензии по одной строке: pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 или коммерческая, pikepdf MPL-2.0, reportlab BSD, Spire.PDF коммерческая. Условия AGPL следует оценивать с учётом способа распространения вашего программного обеспечения.
Бесплатная редакция, ознакомительная, временная и коммерческая
Spire.PDF — коммерческий продукт с несколькими редакциями, и они ведут себя по-разному, поэтому проверьте, какая установлена, перед бенчмарком или выпуском.
| Пакет / версия | Статус | Ограничения |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | Бесплатная редакция | Вывод ограничен 10 страницами; конвертация в изображения, XPS, Word и HTML ограничена первыми 3 страницами |
| spire-pdf 12.10.0 (2026-10-12) | Ознакомительная | Ознакомительное предупреждение; обрабатываются первые 10 страниц |
| spire-pdf 12.10.0 | Временная лицензия (30 дней) | Ознакомительные ограничения сняты |
| spire-pdf 12.10.0 | Коммерческая | Никаких из указанных выше ограничений |
Помимо API, коммерческая лицензия — это ещё и отношения по поддержке. Пакет поставляется в виде wheel-пакетов для Windows, Linux и macOS, зафиксировал семь выпусков с января по октябрь 2026 года (с 12.1.3 по 12.10.0), а коммерческие лицензии включают обновления и техническую поддержку через форум и электронную почту поставщика, с целевыми сроками ответа, зависящими от уровня лицензии.
Ограничение на количество страниц легко проверить: 40-страничный файл, загруженный в ознакомительной сборке, даёт только 10 обработанных страниц. Это свойство ознакомительной редакции, а не возможности продукта, и именно поэтому наш запуск рабочего процесса на 40 страницах приводится только для open-source стека. Ознакомительные сборки предназначены для оценки, а не для производства. Для команд, впервые знакомящихся с продуктом, разумная последовательность: начать с ознакомительной сборки на собственных файлах, запросить временную лицензию, когда нужно протестировать более 10 страниц, и перейти на коммерческую лицензию перед выпуском.
Как выбрать подходящую библиотеку PDF для вашего проекта
Три профиля охватывают большинство команд:
- Одна специализированная задача. Массовое извлечение текста, рендеринг страниц, объединение файлов или генерация отчётов: выберите библиотеку, созданную для этой операции, например PyMuPDF, pypdf или reportlab. Проверьте лицензию, если вы распространяете продукт.
- Чтение с учётом макета. Если в центре внимания таблицы и позиции, начните с pdfplumber, а для любых правок страниц используйте pypdf или pikepdf.
- Связанные задачи с одним и тем же файлом. Когда извлечение, правка страниц, конвертация и шифрование входят в один конвейер, единый SDK сокращает количество API и деревьев зависимостей, которые вы поддерживаете. Именно для этого предназначен Spire.PDF; коммерческая лицензия включает обновления и поддержку.
Быстрая проверка перед выбором: выпишите каждую операцию, которая понадобится проекту в течение следующего года, включая конвертацию, шифрование и архивирование, и отметьте, какая библиотека покрывает каждую. Если одна библиотека покрывает весь список, вопрос решён. Если для списка нужны три, сравните стоимость трёх зависимостей со стоимостью одной лицензии.
Считайте задачи, а не функции. Если вы можете назвать операции, нужные проекту, одним предложением и их одна или две, специализированной библиотеки, вероятно, достаточно. Если список продолжает расти, попробуйте Spire.PDF for Python на своих файлах.
Как мы тестировали
Раскрытие информации: Spire.PDF for Python — продукт E-iceblue, и этот бенчмарк проводился издателем. Поэтому мы опубликовали тестовые наборы, версии и методику, а open-source библиотеки тестировались на точно таких же файлах.
- Среда: Windows 11, Intel Core i3-10105 с частотой 3,70 ГГц (4 ядра, 8 потоков), 8,4 ГБ ОЗУ, Python 3.14.6.
- Версии: pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- Тестовые наборы: 10-страничный текстовый документ, таблица 21 × 4 с рамками на первой странице, счёт на китайском языке, страница со смешанным содержимым для рендеринга и сгенерированные квартальные отчёты на 10 и 40 страниц. Количество страниц, размеры и хеши SHA-256 записаны в манифесте тестовых наборов.
- Замер времени: один прогрев и 10 измеряемых запусков на тест, результаты представлены медианами с минимумом и максимумом. Открытие, операция и сохранение замерялись отдельными фазами.
- Корректность: текст сравнивался по покрытию уникальных токенов и сходству последовательностей (а не по сырому количеству символов, поскольку соглашения о пробелах различаются); таблицы сравнивались ячейка за ячейкой; зашифрованные файлы открывались с паролем и проверялись на блокировку доступа без него.
- Не охвачено: одна машина и одна рабочая нагрузка; сканированные документы, OCR, подписи, обработка форм, таблицы с объединёнными ячейками и произвольные повреждённые файлы не измерялись. Время будет отличаться на вашем оборудовании и документах.
Часто задаваемые вопросы
Какая библиотека Python для PDF лучшая в целом? Единственного победителя нет. PyMuPDF лидирует по скорости работы с текстом и рендеринга, pypdf — простой выбор для операций со страницами, pdfplumber — для таблиц, reportlab — для генерации. Для конвейеров, объединяющих несколько задач, единый SDK, такой как Spire.PDF, может сократить количество напрямую интегрируемых PDF-пакетов.
pypdf или PyMuPDF: что использовать? Выберите pypdf для операций со страницами в небольшом пакете на чистом Python с лицензией BSD. Выберите PyMuPDF для более быстрого извлечения текста и рендеринга страниц, но сначала проверьте его условия AGPL-3.0 или коммерческой лицензии. В нашем тесте PyMuPDF затратил 7,2 мс на текст против 43,1 мс.
Как извлечь таблицу из PDF в Python?
Для таблиц с рамками вызовите extract_tables() в pdfplumber или используйте извлекатель таблиц в PyMuPDF или Spire.PDF. На нашем тестовом наборе 21 × 4 все три совпали по 84 из 84 ячеек. Таблицы без рамок или с объединёнными ячейками требуют отдельного тестирования.
Может ли Python конвертировать PDF в Word? Да. pdf2docx — распространённый open-source вариант, а Spire.PDF может сохранить загруженный документ как DOCX. Результат конвертации зависит от исходного макета; проверяйте репрезентативные файлы перед использованием в производстве.
Эти библиотеки бесплатны для коммерческого использования? pypdf, pdfplumber, pikepdf и reportlab используют разрешительные лицензии или лицензии со слабым копилефтом (BSD-3, MIT, MPL-2.0, BSD). PyMuPDF распространяется по AGPL-3.0 или коммерческой лицензии, поэтому оценивайте его с учётом способа распространения. Spire.PDF требует коммерческой лицензии для производства; коммерческие лицензии включают обновления и техническую поддержку, а бесплатная и ознакомительная редакции имеют ограничения по страницам.
Источники
- Документация pypdf
- Репозиторий pdfplumber
- Документация PyMuPDF
- Документация pikepdf
- Документация ReportLab
- Документация pdf2docx
- Руководство по программированию Spire.PDF for Python