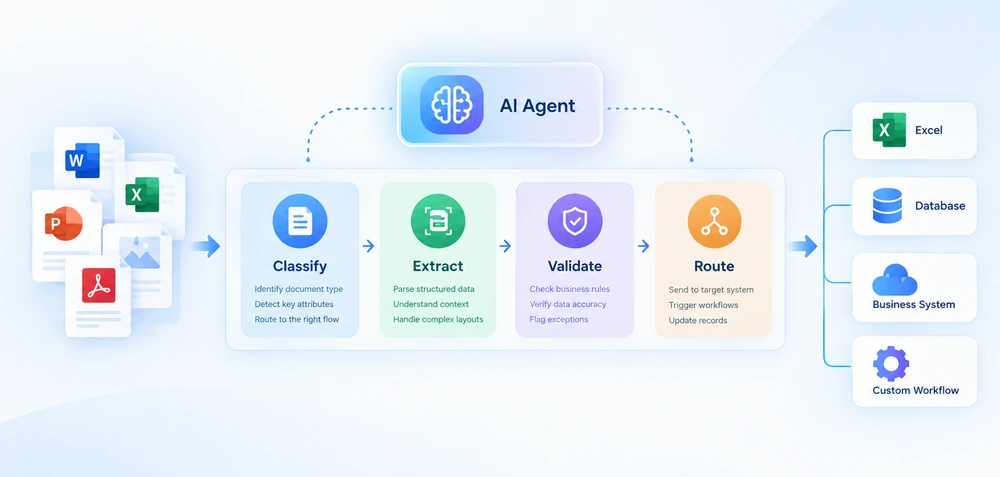
Интеллектуальная обработка документов (IDP) сочетает понимание документов на основе AI с автоматизированным извлечением, валидацией и последующей обработкой. Для .NET-разработчиков внедрение IDP обычно означает соединение понимания документов на основе AI с детерминированным кодом, который отвечает за файлы, бизнес-правила и интеграцию с системами.
Это руководство посвящено рабочим процессам IDP для документов Office и PDF в .NET. В нём рассматривается архитектура четырёхэтапного конвейера, показаны шаблоны реализации на C# и приводится схема принятия решений при выборе между собственной разработкой и использованием платформы поставщика.
Быстрая навигация
- Четырёхэтапный конвейер IDP
- Создание конвейера IDP в .NET
- Пакетная и многодокументная обработка
- IDP на практике
- Создание или покупка: выбор подхода к IDP
1. Что такое интеллектуальная обработка документов?
Интеллектуальная обработка документов — это подход к автоматизации, который использует AI для классификации документов, извлечения из них структурированных данных, проверки результатов на соответствие бизнес-правилам и маршрутизации вывода в нижестоящие системы. В отличие от традиционного OCR, который в первую очередь преобразует визуальное содержимое в машиночитаемый текст, IDP добавляет классификацию документов, семантическое извлечение, валидацию и автоматизацию рабочих процессов. Он может обрабатывать различные макеты документов, не полагаясь полностью на фиксированные шаблоны.
Практический конвейер IDP можно организовать в четыре этапа: классификация, извлечение, валидация и маршрутизация. У каждого этапа есть свои входные данные, выходные данные и режимы отказа. AI-агент выполняет классификацию и извлечение через понимание естественного языка, тогда как валидация и маршрутизация остаются детерминированным кодом, который обеспечивает соблюдение бизнес-правил и интеграцию с нижестоящими системами.
IDP и OCR, обработка документов и интеллектуальный анализ документов
Эти термины часто используются взаимозаменяемо, но они описывают разные возможности:
| Технология | Основная роль |
|---|---|
| OCR | Преобразование визуального содержимого в текст |
| Обработка документов | Чтение, изменение, преобразование или создание файлов |
| Интеллектуальный анализ документов | Понимание содержимого документа и извлечение смысла |
| IDP | Сочетание понимания документов с автоматизированными рабочими процессами |
На практике эти возможности часто пересекаются. Конвейер IDP может использовать OCR для отсканированных документов, AI для семантического понимания и API обработки документов для детерминированных файловых операций. Это различие важно для архитектуры: понимание того, какой уровень за что отвечает, определяет, как вы строите и поддерживаете систему.
IDP не означает замену всего рабочего процесса AI. AI отвечает за понимание и извлечение; детерминированный код отвечает за валидацию, маршрутизацию, манипуляции с файлами и интеграцию с системами. Именно это разделение делает IDP поддерживаемым в производственной среде — бизнес-правила меняются чаще, чем форматы документов, и вы хотите, чтобы эти правила были в коде, который вы контролируете, а не в подсказке модели.
2. Четырёхэтапный конвейер IDP
Конвейер IDP — это не один вызов API. Это последовательность этапов, у каждого из которых свои входные данные, выходные данные и режимы отказа. Понимание этой архитектуры — это разница между созданием конвейера, который справляется с реальным разнообразием документов, и написанием скрипта, который ломается на первом же неожиданном входе.
Практический конвейер IDP можно организовать в четыре этапа:
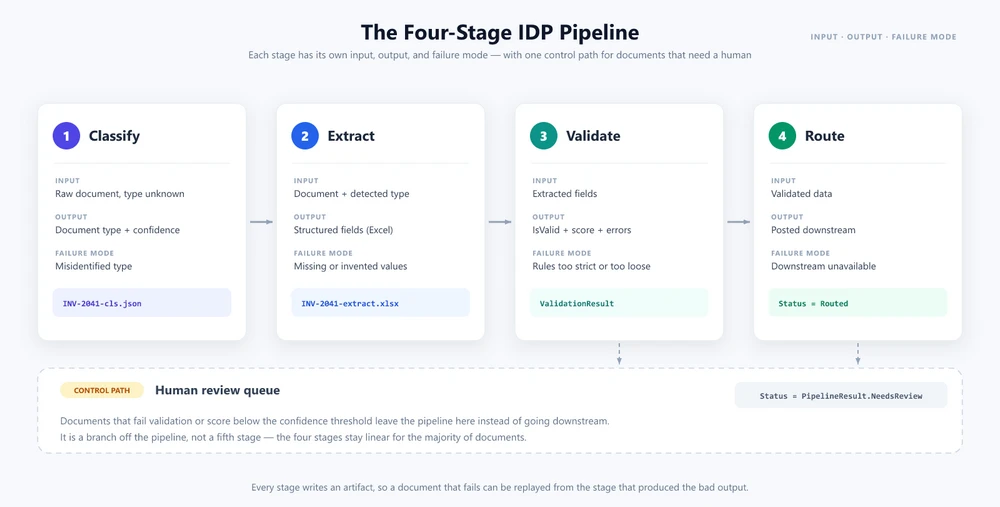
Этап 1 — Классификация
Конвейер получает документ неизвестного типа. Классификация определяет, что это за документ — счёт, договор, заказ на покупку, квитанция, банковская выписка — и прикрепляет метаданные, которые управляют дальнейшим поведением. В традиционной системе классификация опирается на соглашения об именовании файлов, пути к папкам или сопоставление с шаблонами. В конвейере на основе AI классификация использует анализ естественного языка: агент читает содержимое документа и определяет его тип на основе семантического понимания.
Этап 2 — Извлечение
Когда тип документа известен, извлечение вытягивает структурированные данные из документа. Для счёта это означает название поставщика, номер счёта, позиции, итоги, суммы налога, условия оплаты. Для договора это стороны, даты вступления в силу, положения о расторжении, финансовые обязательства. Этап извлечения преобразует неструктурированное или полуструктурированное содержимое документа в структурированный формат (JSON, XML, записи базы данных), который могут использовать нижестоящие системы.
Этап 3 — Валидация
Извлечённые данные проверяются на соответствие бизнес-правилам. Совпадает ли итог счёта с суммой позиций? Есть ли поставщик в списке утверждённых поставщиков? Подписан ли договор уполномоченным лицом? Валидация выявляет ошибки извлечения, отмечает аномалии и формирует оценку уверенности, которая определяет, можно ли автоматически маршрутизировать документ или требуется проверка человеком.
Этап 4 — Маршрутизация
Проверенные данные отправляются в соответствующую нижестоящую систему: ERP для данных счёта, платформу управления договорами для данных договора, архив документов для всего остального. Маршрутизация также может запускать нижестоящие рабочие процессы — цепочки утверждения, обработку платежей, проверки соответствия.
Проверка человеком — это путь контроля, а не обязательный этап: документы, которые не прошли валидацию или оказались ниже порога уверенности, могут быть направлены на ручную проверку. Это сохраняет четырёхэтапный конвейер линейным для большинства документов, обеспечивая контролируемый запасной вариант для граничных случаев.
Почему IDP требует большего, чем вызов AI API
У каждого этапа есть независимые режимы отказа. Классификация может неверно определить тип документа. Извлечение может пропустить поля или выдать ошибочные значения. Валидация может отклонить допустимые данные из-за слишком строгих правил. Маршрутизация может не сработать из-за недоступности нижестоящей системы. Надёжный конвейер IDP обрабатывает каждый режим отказа независимо, с логикой повторных попыток, запасным поведением и журналированием аудита на каждом этапе.
3. Создание конвейера IDP в .NET
Один из способов реализовать эту архитектуру в .NET — использовать Spire.Agent.Office, SDK AI-агента, который обрабатывает документы Word, Excel, PowerPoint и PDF с помощью инструкций на естественном языке. SDK предоставляет метод расширения AI() для объектов документов (Document, PdfDocument, Workbook, Presentation), который принимает конфигурацию AIOptions и возвращает AIDocumentProcessor. Вызов ExecuteInstruction у процессора выполняет инструкцию и записывает вывод в файл, возвращая AIResult со свойствами Success и ErrorMessage.
Предварительные требования
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Примеры ниже посвящены архитектуре конвейера и интеграции Spire.Agent.Office. Вспомогательные методы, такие как разбор результатов и нижестоящая маршрутизация, для краткости опущены.
3.1. Определение модели конвейера
Конвейеру нужны структуры данных для передачи результатов между этапами и общая конфигурация для AI-агента.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken используется для аутентификации Spire.Agent.Office. SDK управляет подключением к AI-сервису через AIOptions, поэтому приложению не нужно напрямую реализовывать интеграцию с API базовой модели. WorkDir задаёт, где агент хранит промежуточные файлы во время обработки.
3.2. Классификация и извлечение документов с помощью AI-агента
Классификация загружает документ, просит агента определить его тип и записывает результат в JSON-файл. Один и тот же шаблон LoadFromFile → AI(options) → ExecuteInstruction работает для всех форматов документов — меняется только класс документа, и этот выбор нужно написать самостоятельно. AI() привязывается к конкретному типу документа: PDF нужно загрузить как PdfDocument, книгу — как Workbook, презентацию — как Presentation, а файл Word — как Document. Передача файла неправильному классу не приводит к откату к универсальному средству чтения; она вызывает исключение, поэтому выберите класс по расширению файла перед вызовом AI().
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
Извлечение использует инструкции, зависящие от типа, чтобы вытянуть структурированные поля из документа:
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
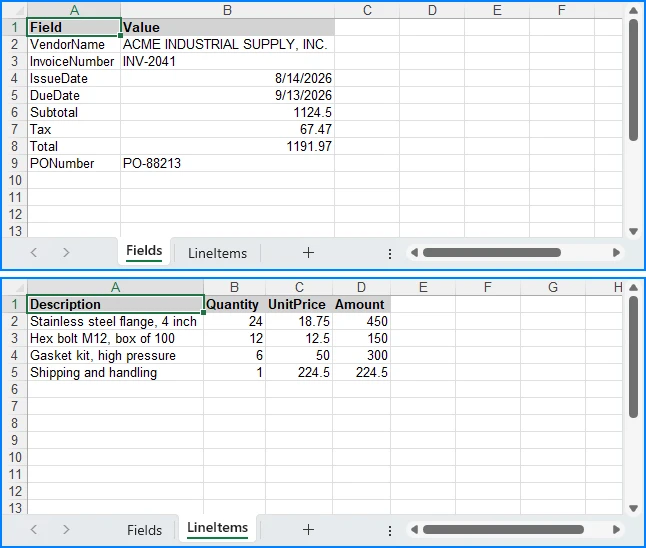
Каждый тип документа получает отдельную инструкцию, которая сообщает агенту, какие поля искать и в каком формате создавать вывод. Агент читает исходный документ и записывает структурированную книгу Excel в extractPath. Именно инструкция задаёт форму этой книги — указание листов, заголовков и точных имён полей делает вывод пригодным для дальнейшего разбора. Инструкция, которая лишь говорит «извлеки поля счёта», может вернуть другое имя листа, другую строку заголовков или другое написание одного и того же поля при каждом запуске, потому что агент сам выбирает макет. GetField в следующем разделе покрывает вариации, которые всё равно проскользнут.
Это разделение между суждением агента и детерминированным кодом далее рассматривается в AI-агент для обработки документов.
3.3. Валидация извлечённых данных с помощью C#
Валидация — это чистая логика C#, вызов AI не нужен. Агент уже создал структурированные данные; валидация проверяет эти данные на соответствие бизнес-правилам.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
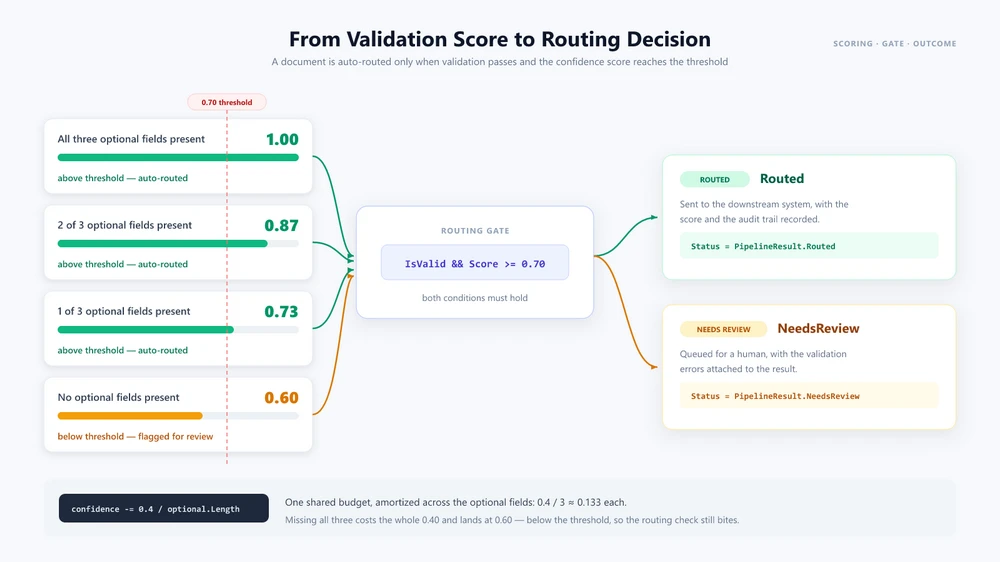
Валидация отделяет жёсткие сбои от предупреждений о качестве. Отсутствие обязательного поля, итог, который не сходится с позициями, или тип документа без правил создают запись в Errors, и документ считается недействительным. Необязательное поле, которое не удалось извлечь, только снижает ValidationScore, поэтому в остальном корректный документ всё равно маршрутизируется. Вычет — это фиксированный бюджет, распределённый между необязательными полями, а не одинаковая санкция за каждое поле: при трёх необязательных полях и бюджете 0.4 в приведённом коде одно отсутствующее поле оставляет оценку на уровне 0.87, а два — на уровне 0.73, всё ещё выше порога автоматической маршрутизации 0.7, поэтому только потеря всех трёх снижает её до 0.60 и отправляет документ на проверку. Сохранение этих двух сигналов раздельными — это то, что оставляет проверку человеком для документов, которые действительно в ней нуждаются.
3.4. Оркестрация конвейера
Метод оркестрации связывает этапы вместе и принимает решения о маршрутизации на основе уверенности валидации:
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Каждый этап можно тестировать независимо, у него есть собственная обработка ошибок, и он создаёт вывод аудита. Возвращаемый PipelineResult также записывает результат этапа 4 в Status, что позволяет пакетному отчёту в следующем разделе подсчитывать документы по результату, а не выводить его заново из полезной нагрузки валидации. В этом примере AI-агент выполняет классификацию и извлечение через инструкции на естественном языке, тогда как валидация и маршрутизация остаются детерминированной логикой C#.
4. Пакетная и многодокументная обработка
Конвейер для одного документа — это отправная точка. Производственные системы IDP ежедневно обрабатывают сотни или тысячи документов с разными типами, приоритетами и нижестоящими назначениями.
Параллельная пакетная обработка
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
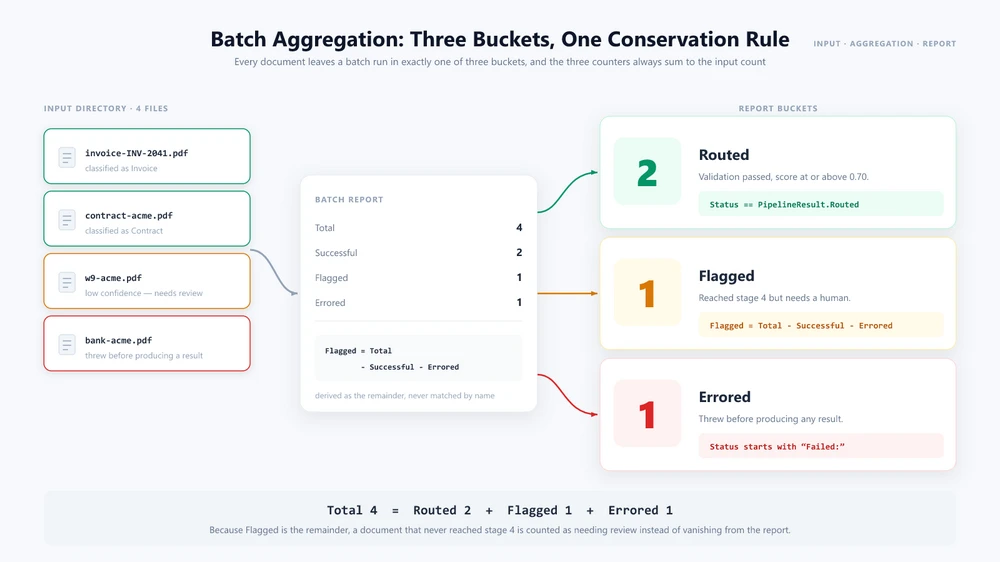
SemaphoreSlim ограничивает параллелизм, чтобы не перегружать AI-сервис или нижестоящие системы. Каждый документ обрабатывается независимо через все четыре этапа. Пакетный отчёт распределяет результаты по трём способам, которыми документ может покинуть конвейер: Routed (проверен и отправлен дальше), Flagged (достиг этапа 4, но требует проверки) и Errored (выбросил исключение до получения результата). Flagged вычисляется как остаток, а не путём сопоставления строки состояния, поэтому три счётчика всегда в сумме дают Total — документ, который неожиданно даёт сбой, будет отчитан как требующий проверки, а не исчезнет из отчёта. Подходящий предел параллелизма зависит от ограничений скорости AI-сервиса, размера документов и ресурсов приложения.
Рабочие процессы с несколькими документами
Некоторые бизнес-процессы требуют совместной обработки нескольких документов. Например, рабочий процесс адаптации поставщика в США может обрабатывать налоговую форму, договор и банковскую выписку как единое целое — извлекать данные из каждого, перекрёстно проверять и создавать объединённый вывод.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
Параметр attachments передаёт несколько путей к документам агенту за один вызов. Агент читает все прикреплённые файлы, рассуждает по ним и создаёт объединённый вывод. Это выходит за рамки роли распознавания текста традиционного OCR, позволяя AI-модели рассуждать по нескольким входным документам.
Повторные попытки и проверка человеком
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
Документы, которые не проходят валидацию или оказываются ниже порога уверенности, помечаются для проверки человеком, а не молча завершаются сбоем. Стратегия повторных попыток использует экспоненциальную задержку для временных ошибок и повторяет граничные случаи в надежде, что вторая попытка классифицирует или извлечёт их иначе.
5. IDP на практике
В этом разделе показано, как конвейер обрабатывает реальные бизнес-сценарии, включающие несколько типов документов в одном рабочем процессе.
Автоматизация счетов к оплате
Отдел кредиторской задолженности получает счета в смешанных форматах — PDF, Excel, Word, отсканированные изображения. Каждый счёт нужно классифицировать, извлечь данные, проверить на соответствие заказу на покупку и направить в ERP-систему.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
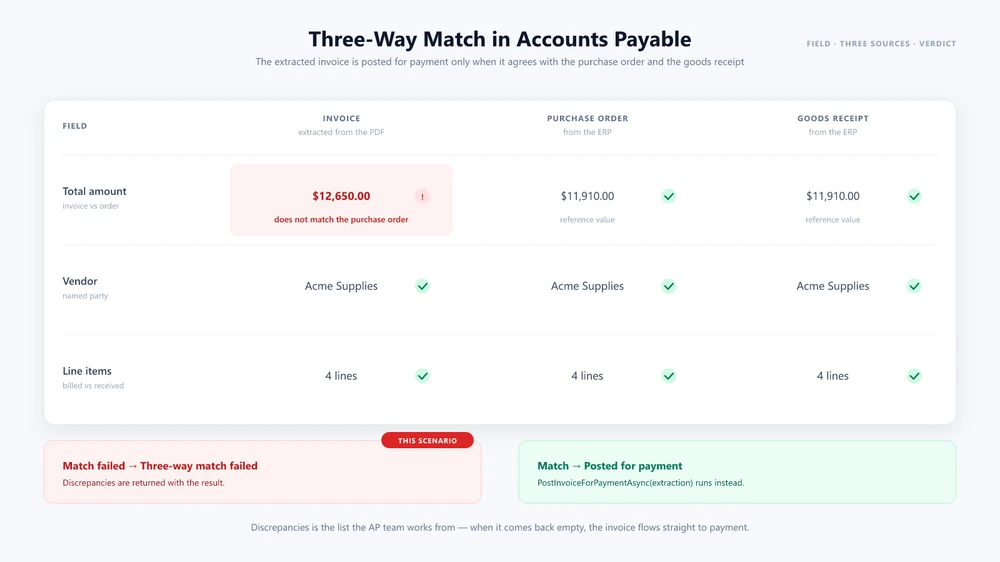
В руководстве по обработке счетов этот сценарий рассматривается от начала до конца: инструкция по извлечению, сравнение с заказом на покупку и отчёт, который использует финансовая система.
Анализ договоров
Юридическая команда получает договоры от внешних сторон. Каждый договор нужно проанализировать, извлечь ключевые условия, сравнить со стандартным шаблоном компании и направить на проверку, если обнаружены нестандартные положения. Агент обрабатывает входящий договор с прикреплённым стандартным шаблоном в качестве справочного документа.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Этот рабочий процесс объединяет извлечение, сравнение нескольких документов и создание документов в одном процессе, показывая, как AI-агент может расширить традиционный конвейер IDP за пределы извлечения структурированных полей. Шаблоны, специфичные для договоров — проверка, извлечение и создание по шаблону — рассматриваются в руководстве по AI-проверке договоров.
6. Создание или покупка: выбор подхода к IDP
Рынок IDP в основном занят SaaS-платформами. Этот раздел помогает разработчикам решить, когда создание конвейера в .NET — правильный выбор, а когда более практично использовать платформу поставщика.
Создавайте, когда вам нужна тесная интеграция с существующим .NET-приложением, пользовательские правила валидации или создание и преобразование документов вместе с извлечением. Создание слоя оркестрации в .NET даёт больше контроля над тем, где хранятся документы и как они обрабатываются. Фактическое размещение данных зависит от AI-модели и конфигурации сервиса.
Покупайте, когда приоритетом являются рабочие нагрузки с интенсивным OCR, готовые модели извлечения, управляемая инфраструктура или быстрое развёртывание. Если у вашей команды нет экспертизы в .NET или она сосредоточена на других приоритетах, управляемая платформа снимает бремя реализации.
Схема принятия решений:
| Фактор | Создание (.NET + AI-агент) | Покупка (SaaS IDP) |
|---|---|---|
| Интеграция | Внутри процесса, нативно для .NET | Внешний вызов API |
| Размещение данных | Зависит от конфигурации модели | Облако поставщика |
| Операции с документами | Извлечение + создание + преобразование + конвертация | Зависит от платформы |
| Пользовательская валидация | Полный контроль над кодом | Конфигурация платформы |
| Пользовательский рабочий процесс | Полный контроль над кодом | Зависит от платформы |
| Время до внедрения | От недель до месяцев | От дней до недель |
| Модель затрат | Фиксированная стоимость API + лицензия SDK | Оплата за документ |
Правильный выбор зависит от требований вашего приложения, возможностей команды и типов обрабатываемых документов. Многие команды используют гибридный подход: платформа поставщика для крупнообъёмного извлечения стандартизированных форм и пользовательский конвейер .NET для сложных рабочих процессов, требующих создания документов, рассуждений по нескольким документам или тесной интеграции с системами.
7. Часто задаваемые вопросы
Что такое интеллектуальная обработка документов (IDP)?
Интеллектуальная обработка документов — это подход к автоматизации, который использует AI и машинное обучение для классификации документов, извлечения структурированных данных, проверки результатов на соответствие бизнес-правилам и маршрутизации вывода в нижестоящие системы. В отличие от традиционного OCR, который в первую очередь преобразует визуальное содержимое в машиночитаемый текст, IDP добавляет классификацию документов, семантическое извлечение, валидацию и автоматизацию рабочих процессов. Он может обрабатывать различные макеты документов, не полагаясь полностью на фиксированные шаблоны.
Чем конвейер IDP отличается от одиночного вызова LLM API?
Одиночный вызов LLM обрабатывает текст, но не работает с форматами файлов, не выполняет операции с документами и не управляет состоянием конвейера. Конвейер IDP оркестрирует несколько этапов — классификацию, извлечение, валидацию, маршрутизацию — каждый с независимой обработкой ошибок, логикой повторных попыток и журналированием аудита. Конвейер также соединяет рассуждения AI с детерминированными манипуляциями с файлами, гарантируя, что вывод сохраняет правильное форматирование.
Можно ли создать конвейер IDP без платформы поставщика?
Да. Используя SDK AI-агента для .NET, такой как Spire.Agent.Office, вы можете реализовать все четыре этапа конвейера на C#. SDK обеспечивает обработку документов Word, Excel, PowerPoint и PDF с помощью естественного языка с детерминированным выводом файлов. Этот подход даёт полный контроль над логикой валидации и правилами маршрутизации.
Какие форматы документов поддерживает конвейер IDP?
С Spire.Agent.Office конвейер поддерживает файлы Word (.docx, .doc), Excel (.xlsx, .xls), PowerPoint (.pptx, .ppt) и PDF. Отсканированные документы могут требовать этапа OCR перед извлечением на основе AI, в зависимости от документа и рабочего процесса обработки. Конвейер также может конвертировать форматы в рамках этапа маршрутизации.
Как AI-агент подключается к языковой модели?
Spire.Agent.Office использует свойство SpireToken в AIOptions для аутентификации в AI-сервисе. SDK управляет подключением к AI-сервису через AIOptions, поэтому приложению не нужно напрямую реализовывать интеграцию с API базовой модели. Такая архитектура отделяет обработку документов от конфигурации модели, поэтому код вашего конвейера остаётся неизменным независимо от того, какая модель обеспечивает работу агента.
Насколько точно извлечение документов на основе AI?
Точность извлечения сильно зависит от качества документов, вариативности макета, качества OCR, поведения модели и инструкций по извлечению. Производственные системы должны проверять извлечённые значения на соответствие детерминированным бизнес-правилам и направлять неопределённые случаи на проверку человеком. Этап валидации помогает сделать извлечение на основе AI более надёжным в производственной среде, проверяя извлечённые значения по детерминированным правилам и направляя неопределённые результаты на проверку.
В чём разница между IDP и OCR?
OCR (Optical Character Recognition) преобразует визуальное содержимое документа в машиночитаемый текст. IDP строится на этой возможности, но добавляет понимание на основе AI, валидацию и автоматизацию рабочих процессов. Конвейер IDP может внутренне использовать OCR для отсканированных документов, но сам по себе OCR не классифицирует документы, не проверяет извлечённые данные и не маршрутизирует результаты в нижестоящие системы.
Как работает пакетная обработка в конвейере IDP?
Пакетная обработка запускает конвейер параллельно для нескольких документов с настраиваемыми ограничениями параллелизма для управления использованием ресурсов. Каждый документ обрабатывается независимо через все четыре этапа, а результаты агрегируются в пакетный отчёт. Документы с ошибками помечаются для проверки, не блокируя остальную часть пакета.
Готовы создать конвейер IDP?
Если вы создаёте интеллектуальную обработку документов в .NET-приложении, начните с руководства по началу работы со Spire.Agent.Office, в котором описаны установка SDK и запуск первой инструкции в .NET.
Дополнительные материалы
- AI-агент против сырого LLM API: слой документов в .NET — что слой документов добавляет по сравнению с прямым вызовом LLM API и когда подходит каждый подход
- Преобразование документов в презентации PowerPoint с помощью AI в C# — тот же управляемый инструкциями шаблон, применённый к выводу слайдов