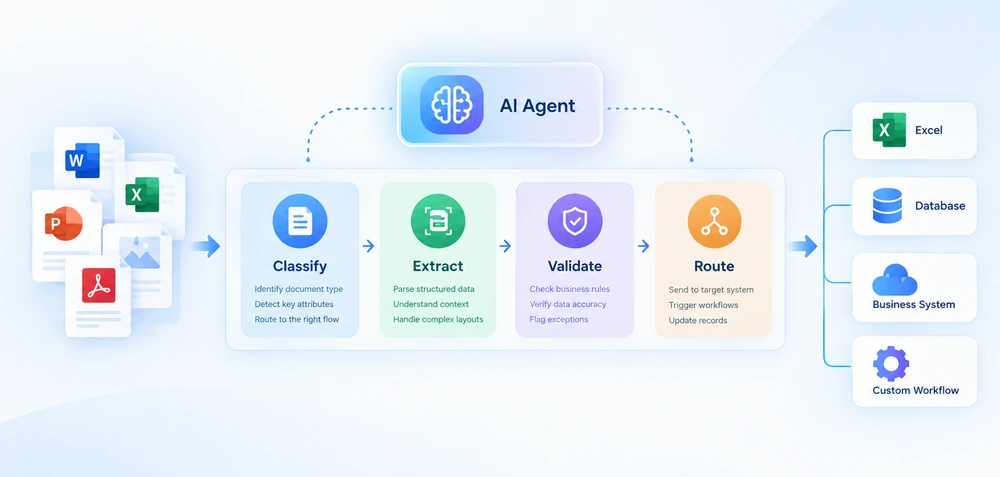
O processamento inteligente de documentos (IDP) combina compreensão de documentos baseada em IA com extração automatizada, validação e processamento downstream. Para desenvolvedores .NET, implementar IDP geralmente significa conectar a compreensão de documentos baseada em IA com código determinístico que lida com arquivos, regras de negócios e integração de sistemas.
Este guia concentra-se em fluxos de trabalho IDP para documentos do Office e PDF em .NET. Ele aborda a arquitetura de pipeline de quatro estágios, mostra padrões de implementação em C# e fornece uma estrutura de decisão para escolher entre construir internamente e adotar uma plataforma de fornecedor.
Navegação Rápida
- O Pipeline IDP de Quatro Estágios
- Criando um Pipeline IDP em .NET
- Processamento em Lote e de Vários Documentos
- IDP na Prática
- Construir vs Comprar: Escolhendo uma Abordagem de IDP
1. O que é Processamento Inteligente de Documentos?
O processamento inteligente de documentos é uma abordagem de automação que usa IA para classificar documentos, extrair dados estruturados deles, validar os resultados em relação a regras de negócios e encaminhar a saída para sistemas downstream. Diferentemente do OCR tradicional, que converte principalmente conteúdo visual em texto legível por máquina, o IDP adiciona classificação de documentos, extração semântica, validação e automação de fluxo de trabalho. Ele consegue lidar com layouts de documentos variados sem depender inteiramente de modelos fixos.
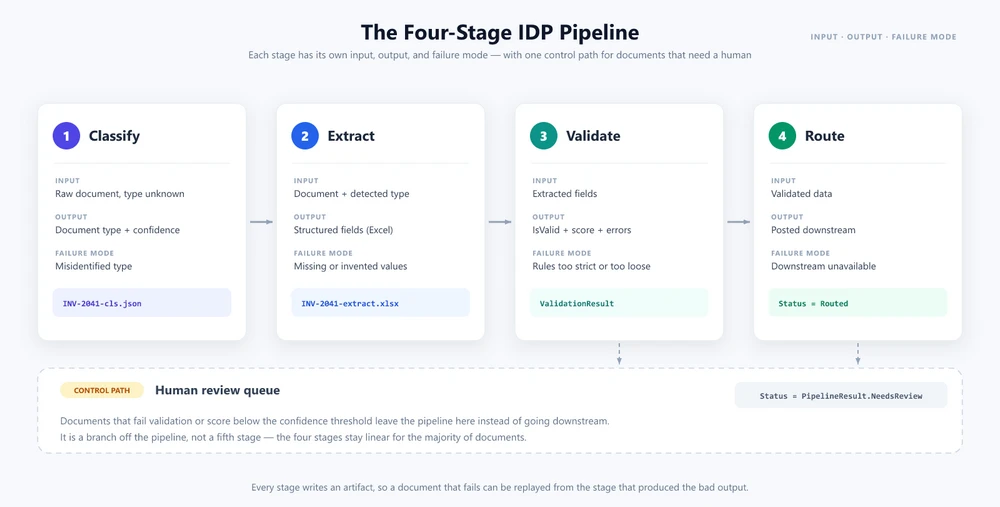
Um pipeline IDP prático pode ser organizado em quatro estágios: classificar, extrair, validar e encaminhar. Cada estágio tem entradas, saídas e modos de falha distintos. O agente de IA lida com classificação e extração por meio de compreensão de linguagem natural, enquanto validação e encaminhamento permanecem como código determinístico que aplica regras de negócios e integra-se com sistemas downstream.
IDP vs. OCR, Processamento de Documentos e Inteligência de Documentos
Esses termos muitas vezes são usados de forma intercambiável, mas descrevem capacidades diferentes:
| Tecnologia | Função principal |
|---|---|
| OCR | Converter conteúdo visual em texto |
| Processamento de documentos | Ler, manipular, converter ou gerar arquivos |
| Inteligência de documentos | Compreender o conteúdo do documento e extrair significado |
| IDP | Combinar compreensão de documentos com fluxos de trabalho automatizados |
Na prática, essas capacidades muitas vezes se sobrepõem. Um pipeline IDP pode usar OCR para documentos digitalizados, IA para compreensão semântica e APIs de processamento de documentos para operações determinísticas de arquivos. A distinção é importante para a arquitetura: saber qual camada é responsável por qual tarefa determina como você constrói e mantém o sistema.
IDP não significa substituir todo o fluxo de trabalho por IA. A IA lida com compreensão e extração; código determinístico lida com validação, encaminhamento, manipulação de arquivos e integração de sistemas. Essa separação é o que torna o IDP sustentável em produção — regras de negócios mudam com mais frequência do que formatos de documentos, e você quer essas regras em código que você controla, não em um prompt de modelo.
2. O Pipeline IDP de Quatro Estágios
Um pipeline IDP não é uma única chamada de API. É uma sequência de estágios, cada um com entradas, saídas e modos de falha distintos. Entender essa arquitetura é a diferença entre construir um pipeline que lida com variedade real de documentos e escrever um script que quebra na primeira entrada inesperada.
Um pipeline IDP prático pode ser organizado em quatro estágios:
Estágio 1 — Classificação
O pipeline recebe um documento de tipo desconhecido. A classificação determina o que o documento é — uma fatura, um contrato, um pedido de compra, um recibo, um extrato bancário — e anexa metadados que orientam o comportamento downstream. Em um sistema tradicional, a classificação depende de convenções de nomenclatura de arquivos, caminhos de pastas ou correspondência de modelos. Em um pipeline orientado por IA, a classificação usa análise de linguagem natural: o agente lê o conteúdo do documento e determina seu tipo com base na compreensão semântica.
Estágio 2 — Extração
Assim que o tipo de documento é conhecido, a extração obtém dados estruturados do documento. Para uma fatura, isso significa nome do fornecedor, número da fatura, itens de linha, totais, valores de impostos, condições de pagamento. Para um contrato, significa partes, datas de vigência, cláusulas de rescisão, obrigações financeiras. O estágio de extração transforma conteúdo de documento não estruturado ou semiestruturado em um formato estruturado (JSON, XML, registros de banco de dados) que sistemas downstream podem consumir.
Estágio 3 — Validação
Os dados extraídos são verificados em relação a regras de negócios. O total da fatura corresponde à soma dos itens de linha? O fornecedor está na lista de fornecedores aprovados? O contrato foi assinado por um signatário autorizado? A validação detecta erros de extração, sinaliza anomalias e produz uma pontuação de confiança que determina se o documento pode ser encaminhado automaticamente ou exige revisão humana.
Estágio 4 — Encaminhamento
Dados validados são enviados ao sistema downstream apropriado: um ERP para dados de fatura, uma plataforma de gestão de contratos para dados de contrato, um arquivo de documentos para todo o resto. O encaminhamento também pode disparar fluxos de trabalho downstream — cadeias de aprovação, processamento de pagamentos, verificações de conformidade.
A revisão humana é um caminho de controle, e não um estágio obrigatório: documentos que falham na validação ou ficam abaixo de um limite de confiança podem ser encaminhados para revisão manual. Isso mantém o pipeline de quatro estágios linear para a maioria dos documentos, ao mesmo tempo que fornece um fallback controlado para casos limite.
Por que o IDP precisa de mais do que uma chamada de API de IA
Cada estágio tem modos de falha independentes. A classificação pode identificar incorretamente um tipo de documento. A extração pode deixar passar campos ou alucinar valores. A validação pode rejeitar dados válidos devido a regras excessivamente rígidas. O encaminhamento pode falhar devido à indisponibilidade de sistemas downstream. Um pipeline IDP robusto lida com cada modo de falha de forma independente, com lógica de repetição, comportamento de fallback e registro de auditoria em cada estágio.
3. Criando um Pipeline IDP em .NET
Uma forma de implementar essa arquitetura em .NET é usar Spire.Agent.Office, um SDK de agente de IA que processa documentos Word, Excel, PowerPoint e PDF por meio de instruções em linguagem natural. O SDK fornece o método de extensão AI() em objetos de documento (Document, PdfDocument, Workbook, Presentation), que aceita uma configuração AIOptions e retorna um AIDocumentProcessor. Chamar ExecuteInstruction no processador executa a instrução e grava a saída em um arquivo, retornando um AIResult com as propriedades Success e ErrorMessage.
Pré-requisitos
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Os exemplos abaixo concentram-se na arquitetura do pipeline e na integração com Spire.Agent.Office. Métodos auxiliares, como análise de resultados e encaminhamento downstream, são omitidos por brevidade.
3.1 Definir o Modelo do Pipeline
O pipeline precisa de estruturas de dados para transportar resultados entre estágios e uma configuração compartilhada para o agente de IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken é usado para autenticar o Spire.Agent.Office. O SDK gerencia a conexão com o serviço de IA por meio de AIOptions, então a aplicação não precisa implementar diretamente a integração com a API do modelo subjacente. WorkDir designa onde o agente armazena arquivos intermediários durante o processamento.
3.2 Classificar e Extrair Documentos com um Agente de IA
A classificação carrega o documento, pede ao agente para identificar seu tipo e grava o resultado em um arquivo JSON. O mesmo padrão LoadFromFile → AI(options) → ExecuteInstruction funciona para todos os formatos de documento — apenas a classe do documento muda, e esse despacho é seu para escrever. AI() vincula-se a um tipo concreto de documento: um PDF deve ser carregado como PdfDocument, uma pasta de trabalho como Workbook, uma apresentação como Presentation e um arquivo Word como Document. Entregar um arquivo à classe errada não recorre a um leitor genérico; ele lança uma exceção, então escolha a classe pela extensão do arquivo antes de chamar AI().
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
A extração usa instruções específicas por tipo para obter campos estruturados do documento:
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
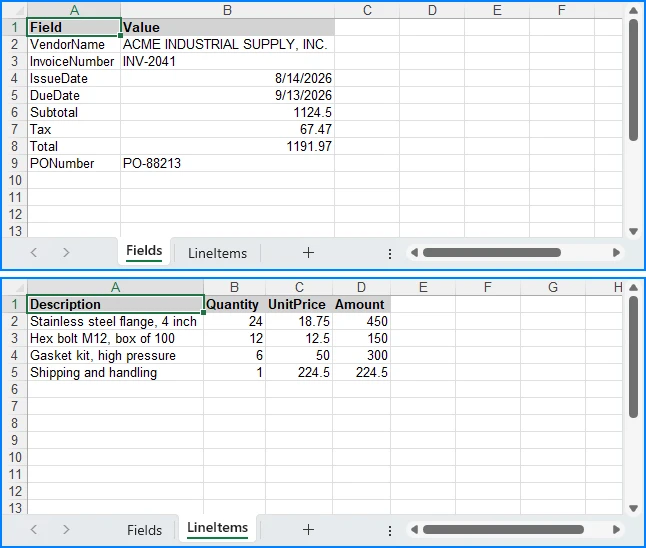
Cada tipo de documento recebe uma instrução dedicada que informa ao agente quais campos procurar e qual formato de saída produzir. O agente lê o documento de origem e grava uma pasta de trabalho Excel estruturada em extractPath. A instrução é o que fixa o formato dessa pasta de trabalho — nomear as planilhas, os cabeçalhos e os nomes exatos dos campos é o que torna a saída analisável downstream. Uma instrução que apenas diz "extraia os campos da fatura" pode retornar com um nome de planilha diferente, uma linha de cabeçalho diferente ou uma grafia diferente para o mesmo campo a cada execução, porque o agente decide o layout sozinho. O GetField na próxima seção cobre as variações que ainda assim escapam.
Essa divisão entre julgamento do agente e código determinístico é abordada mais adiante em Agente de IA para Processamento de Documentos.
3.3 Validar Dados Extraídos com C#
A validação é lógica pura em C# — nenhuma chamada de IA é necessária. O agente já produziu dados estruturados; a validação verifica esses dados em relação a regras de negócios.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
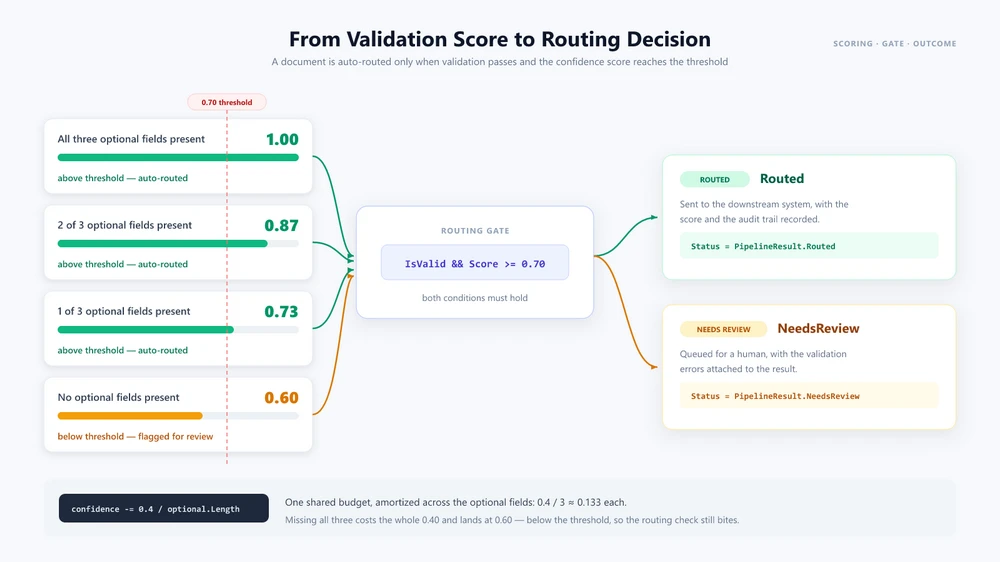
A validação separa falhas rígidas de avisos de qualidade. Um campo obrigatório ausente, um total que não concilia com os itens de linha ou um tipo de documento sem regras produz uma entrada em Errors, e o documento é tratado como inválido. Um campo opcional que não pôde ser extraído apenas reduz ValidationScore, então um documento que de outra forma está íntegro ainda é encaminhado. A dedução é um orçamento fixo compartilhado entre os campos opcionais, em vez de uma penalidade fixa por campo: com três campos opcionais e o orçamento de 0,4 no código acima, um campo ausente deixa a pontuação em 0,87 e dois a deixam em 0,73 — ainda acima do limite de encaminhamento automático de 0,7 —, então somente perder todos os três a reduz para 0,60 e envia o documento para revisão. Manter esses dois sinais separados é o que reserva a revisão humana para documentos que realmente precisam dela.
3.4 Orquestrar o Pipeline
O método de orquestração conecta os estágios e toma decisões de encaminhamento com base na confiança da validação:
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Cada estágio é testável de forma independente, tem seu próprio tratamento de erros e produz saída de auditoria. O PipelineResult retornado também registra o resultado do estágio 4 em Status, o que permite que o relatório em lote na próxima seção conte documentos por resultado em vez de derivá-lo novamente do payload de validação. Neste exemplo, o agente de IA lida com classificação e extração por meio de instruções em linguagem natural, enquanto validação e encaminhamento permanecem como lógica determinística em C#.
4. Processamento em Lote e de Vários Documentos
Um pipeline de documento único é um ponto de partida. Sistemas IDP de produção processam centenas ou milhares de documentos diariamente, com tipos, prioridades e destinos downstream variados.
Processamento em Lote Paralelo
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
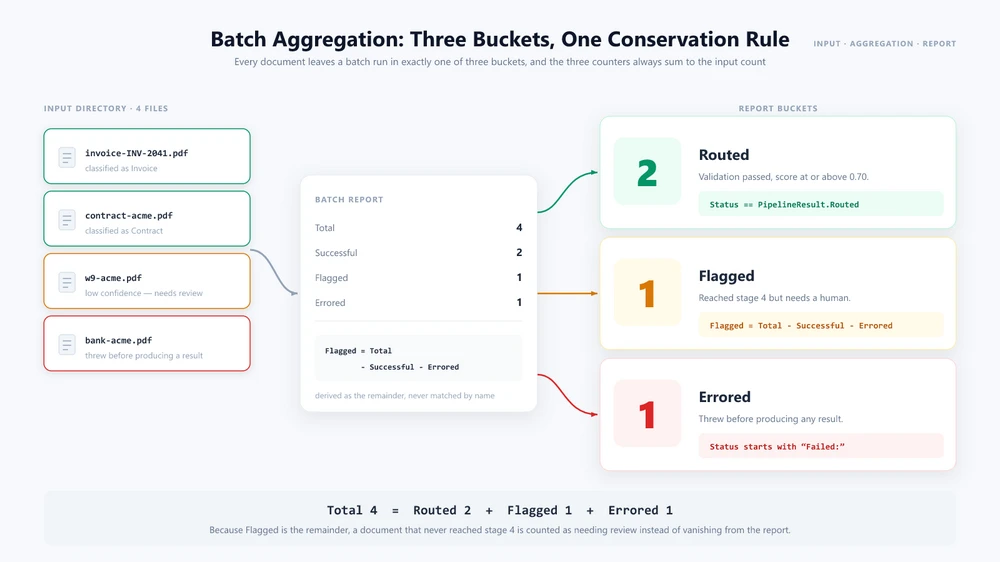
O SemaphoreSlim limita a concorrência para evitar sobrecarregar o serviço de IA ou sistemas downstream. Cada documento é processado independentemente por todos os quatro estágios. O relatório em lote classifica os resultados nas três formas pelas quais um documento pode sair do pipeline: Routed (validado e enviado downstream), Flagged (chegou ao estágio 4, mas precisa de revisão) e Errored (lançou exceção antes de produzir um resultado). Flagged é calculado como o restante, em vez de corresponder a uma string de status, então os três contadores sempre somam Total — um documento que falha inesperadamente é relatado como precisando de revisão em vez de desaparecer do relatório. O limite de concorrência apropriado depende dos limites de taxa do serviço de IA, do tamanho do documento e dos recursos da aplicação.
Fluxos de Trabalho entre Documentos
Alguns processos de negócios exigem que vários documentos sejam processados juntos. Um fluxo de trabalho de integração de fornecedor nos EUA, por exemplo, pode processar um formulário fiscal, um contrato e um extrato bancário como uma única unidade — extraindo dados de cada um, fazendo validação cruzada e produzindo uma saída combinada.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
O parâmetro attachments passa vários caminhos de documentos para o agente em uma única chamada. O agente lê todos os arquivos anexados, raciocina sobre eles e produz uma saída combinada. Isso vai além do papel de reconhecimento de texto do OCR tradicional, permitindo que um modelo de IA raciocine sobre múltiplas entradas de documentos.
Retentativa e Revisão Humana
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
Documentos que falham na validação ou ficam abaixo do limite de confiança são sinalizados para revisão humana em vez de falharem silenciosamente. A estratégia de retentativa usa backoff exponencial para erros transitórios e tenta novamente casos limítrofes na chance de que uma segunda passagem os classifique ou extraia de forma diferente.
5. IDP na Prática
Esta seção mostra como o pipeline lida com cenários de negócios reais que envolvem vários tipos de documentos em um único fluxo de trabalho.
Automação de Contas a Pagar
Um departamento de Contas a Pagar recebe faturas em formatos variados — PDF, Excel, Word, imagens digitalizadas. Cada fatura precisa ser classificada, extraída, validada em relação a um pedido de compra e encaminhada ao sistema ERP.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
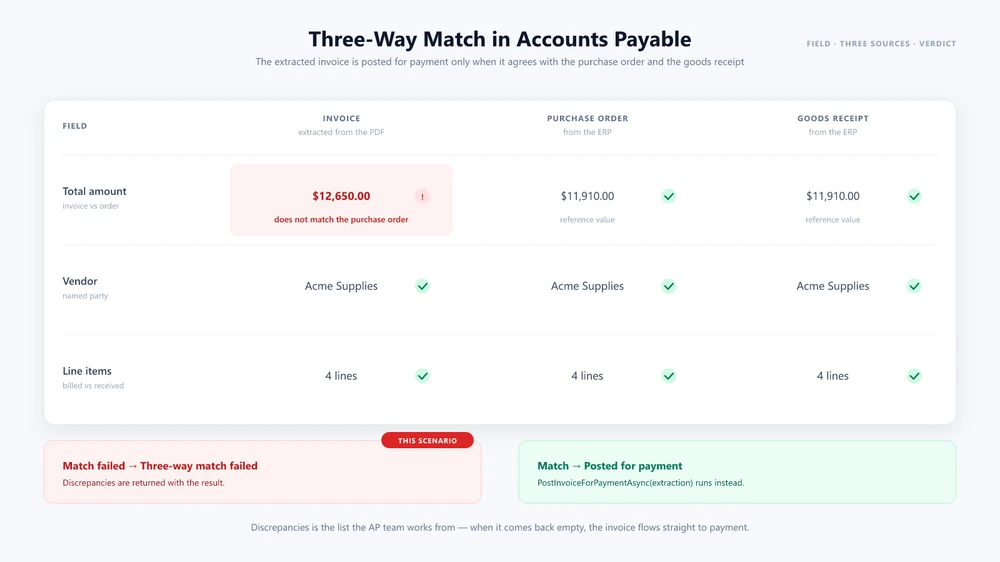
O tutorial de processamento de faturas cobre esse cenário de ponta a ponta: a instrução de extração, a comparação com o pedido de compra e o relatório que o sistema financeiro consome.
Análise de Contratos
Uma equipe jurídica recebe contratos de partes externas. Cada contrato precisa ser analisado, ter termos-chave extraídos, ser comparado ao modelo padrão da empresa e ser encaminhado para revisão se cláusulas não padrão forem encontradas. O agente processa o contrato recebido com o modelo padrão anexado como documento de referência.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Este fluxo de trabalho combina extração, comparação entre documentos e geração de documentos em um único processo, ilustrando como um agente de IA pode estender um pipeline IDP tradicional além da extração de campos estruturados. Padrões específicos de contratos — revisão, extração e geração a partir de um modelo — são abordados no guia de revisão de contratos com IA.
6. Construir vs Comprar: Escolhendo uma Abordagem de IDP
O mercado de IDP é dominado por plataformas SaaS. Esta seção ajuda desenvolvedores a decidir quando construir um pipeline em .NET é a escolha certa e quando adotar uma plataforma de fornecedor é mais prático.
Construa quando você precisar de integração estreita com uma aplicação .NET existente, regras de validação personalizadas ou geração e transformação de documentos junto com a extração. Construir a camada de orquestração em .NET oferece maior controle sobre onde os documentos são armazenados e como são processados. A residência real dos dados depende do modelo de IA e da configuração do serviço.
Compre quando cargas de trabalho com muito OCR, modelos de extração pré-construídos, infraestrutura gerenciada ou implantação rápida forem a prioridade. Se sua equipe não tem expertise em .NET ou está focada em outras prioridades, uma plataforma gerenciada remove o ônus da implementação.
Estrutura de decisão:
| Fator | Construir (.NET + agente de IA) | Comprar (IDP SaaS) |
|---|---|---|
| Integração | Em processo, nativo .NET | Chamada de API externa |
| Residência de dados | Depende da configuração do modelo | Nuvem do fornecedor |
| Operações de documentos | Extrair + gerar + transformar + converter | Depende da plataforma |
| Validação personalizada | Controle total do código | Configuração da plataforma |
| Fluxo de trabalho personalizado | Controle total do código | Dependente da plataforma |
| Tempo até produção | Semanas a meses | Dias a semanas |
| Modelo de custo | Custo fixo de API + licença do SDK | Preço por documento |
A escolha certa depende dos requisitos da sua aplicação, das capacidades da equipe e dos tipos de documentos que você processa. Muitas equipes usam uma abordagem híbrida: uma plataforma de fornecedor para extração em alto volume de formulários padronizados e um pipeline .NET personalizado para fluxos de trabalho complexos que exigem geração de documentos, raciocínio entre documentos ou integração estreita de sistemas.
7. Perguntas Frequentes
O que é processamento inteligente de documentos (IDP)?
O processamento inteligente de documentos é uma abordagem de automação que usa IA e aprendizado de máquina para classificar documentos, extrair dados estruturados, validar os resultados em relação a regras de negócios e encaminhar a saída para sistemas downstream. Diferentemente do OCR tradicional, que converte principalmente conteúdo visual em texto legível por máquina, o IDP adiciona classificação de documentos, extração semântica, validação e automação de fluxo de trabalho. Ele consegue lidar com layouts de documentos variados sem depender inteiramente de modelos fixos.
Como um pipeline IDP difere de uma única chamada de API de LLM?
Uma única chamada de LLM processa texto, mas não lida com formatos de arquivo, executa operações de documentos ou gerencia o estado do pipeline. Um pipeline IDP orquestra vários estágios — classificação, extração, validação, encaminhamento —, cada um com tratamento de erros independente, lógica de retentativa e registro de auditoria. O pipeline também faz a ponte entre raciocínio de IA e manipulação determinística de arquivos, garantindo que a saída preserve a formatação correta.
Posso construir um pipeline IDP sem uma plataforma de fornecedor?
Sim. Usando um SDK de agente de IA .NET como o Spire.Agent.Office, você pode implementar todos os quatro estágios do pipeline em C#. O SDK fornece processamento de documentos em linguagem natural para arquivos Word, Excel, PowerPoint e PDF, com saída de arquivo determinística. Essa abordagem dá controle total sobre a lógica de validação e as regras de encaminhamento.
Quais formatos de documento um pipeline IDP suporta?
Com o Spire.Agent.Office, o pipeline lida com arquivos Word (.docx, .doc), Excel (.xlsx, .xls), PowerPoint (.pptx, .ppt) e PDF. Documentos digitalizados podem exigir uma etapa de OCR antes da extração baseada em IA, dependendo do documento e do fluxo de processamento. O pipeline também pode converter entre formatos como parte do estágio de encaminhamento.
Como o agente de IA se conecta ao modelo de linguagem?
O Spire.Agent.Office usa uma propriedade SpireToken em AIOptions para autenticar com o serviço de IA. O SDK gerencia a conexão com o serviço de IA por meio de AIOptions, então a aplicação não precisa implementar diretamente a integração com a API do modelo subjacente. Esse design separa o processamento de documentos da configuração do modelo, então o código do seu pipeline permanece o mesmo independentemente de qual modelo alimenta o agente.
Quão precisa é a extração de documentos baseada em IA?
A precisão da extração depende fortemente da qualidade do documento, da variabilidade de layout, da qualidade do OCR, do comportamento do modelo e das instruções de extração. Sistemas de produção devem validar os valores extraídos em relação a regras de negócios determinísticas e encaminhar casos incertos para revisão humana. O estágio de validação ajuda a tornar a extração baseada em IA mais confiável em produção, verificando os valores extraídos em relação a regras determinísticas e encaminhando resultados incertos para revisão.
Qual é a diferença entre IDP e OCR?
OCR (Reconhecimento Óptico de Caracteres) converte conteúdo visual de documentos em texto legível por máquina. O IDP baseia-se nessa capacidade, mas adiciona compreensão, validação e automação de fluxo de trabalho impulsionadas por IA. Um pipeline IDP pode usar OCR internamente para documentos digitalizados, mas o OCR sozinho não classifica documentos, valida dados extraídos nem encaminha resultados para sistemas downstream.
Como o processamento em lote funciona em um pipeline IDP?
O processamento em lote executa o pipeline simultaneamente em vários documentos, com limites de concorrência configuráveis para gerenciar o uso de recursos. Cada documento é processado independentemente por todos os quatro estágios, com resultados agregados em um relatório em lote. Documentos com falha são sinalizados para revisão sem bloquear o restante do lote.
Pronto para Construir um Pipeline IDP?
Se você está construindo processamento inteligente de documentos em uma aplicação .NET, comece com o guia de Introdução do Spire.Agent.Office, que aborda a instalação do SDK e a execução da sua primeira instrução em .NET.
Leitura Adicional
- Agente de IA vs. API LLM Bruta: Camada de Documentos em .NET — o que uma camada de documentos adiciona sobre uma chamada de API LLM bruta e quando cada abordagem se encaixa
- Transforme Documentos em Apresentações PowerPoint com IA em C# — o mesmo padrão orientado por instruções aplicado à saída de slides