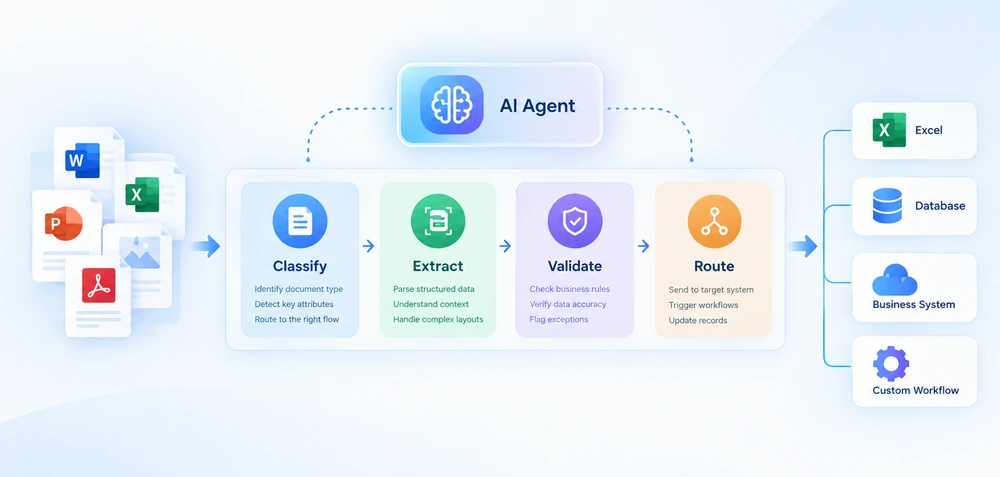
L'elaborazione intelligente dei documenti (IDP) combina la comprensione dei documenti basata sull'IA con estrazione, convalida ed elaborazione downstream automatizzate. Per gli sviluppatori .NET, implementare l'IDP di solito significa collegare la comprensione dei documenti basata sull'IA con codice deterministico che gestisce file, regole di business e integrazione di sistema.
Questa guida si concentra sui flussi di lavoro IDP per documenti Office e PDF in .NET. Copre l'architettura della pipeline in quattro fasi, mostra modelli di implementazione C# e fornisce un quadro decisionale per scegliere tra la creazione interna e l'adozione di una piattaforma di fornitore.
Navigazione rapida
- La pipeline IDP in quattro fasi
- Creare una pipeline IDP in .NET
- Elaborazione batch e multi-documento
- IDP in pratica
- Build vs Buy: scegliere un approccio IDP
1. Che cos'è l'elaborazione intelligente dei documenti?
L'elaborazione intelligente dei documenti è un approccio di automazione che utilizza l'IA per classificare i documenti, estrarre dati strutturati, convalidare i risultati rispetto alle regole di business e instradare l'output verso sistemi downstream. A differenza dell'OCR tradizionale, che converte principalmente il contenuto visivo in testo leggibile dalla macchina, l'IDP aggiunge la classificazione dei documenti, l'estrazione semantica, la convalida e l'automazione dei flussi di lavoro. Può gestire layout di documenti vari senza fare affidamento interamente su modelli fissi.
Una pipeline IDP pratica può essere organizzata in quattro fasi: classifica, estrai, convalida e instrada. Ogni fase ha input, output e modalità di errore distinte. L'agente AI gestisce la classificazione e l'estrazione tramite comprensione del linguaggio naturale, mentre la convalida e l'instradamento rimangono codice deterministico che applica regole di business e si integra con sistemi downstream.
IDP vs. OCR, elaborazione documenti e intelligenza documentale
Questi termini sono spesso usati in modo intercambiabile, ma descrivono capacità diverse:
| Tecnologia | Ruolo principale |
|---|---|
| OCR | Convertire il contenuto visivo in testo |
| Elaborazione documenti | Leggere, manipolare, convertire o generare file |
| Intelligenza documentale | Comprendere il contenuto del documento ed estrarne il significato |
| IDP | Combinare la comprensione dei documenti con flussi di lavoro automatizzati |
In pratica, queste capacità spesso si sovrappongono. Una pipeline IDP può usare l'OCR per documenti scansionati, l'IA per la comprensione semantica e API di elaborazione documenti per operazioni deterministiche sui file. La distinzione è importante per l'architettura: sapere quale livello gestisce quale responsabilità determina come si costruisce e si mantiene il sistema.
IDP non significa sostituire l'intero flusso di lavoro con l'IA. L'IA gestisce la comprensione e l'estrazione; il codice deterministico gestisce convalida, instradamento, manipolazione dei file e integrazione di sistema. Questa separazione è ciò che rende l'IDP manutenibile in produzione—le regole di business cambiano più spesso dei formati dei documenti, e si desidera che tali regole siano nel codice che si controlla, non in un prompt del modello.
2. La pipeline IDP in quattro fasi
Una pipeline IDP non è una singola chiamata API. È una sequenza di fasi, ciascuna con input, output e modalità di errore distinte. Comprendere questa architettura è la differenza tra costruire una pipeline che gestisce una reale varietà di documenti e scrivere uno script che si rompe al primo input imprevisto.
Una pipeline IDP pratica può essere organizzata in quattro fasi:
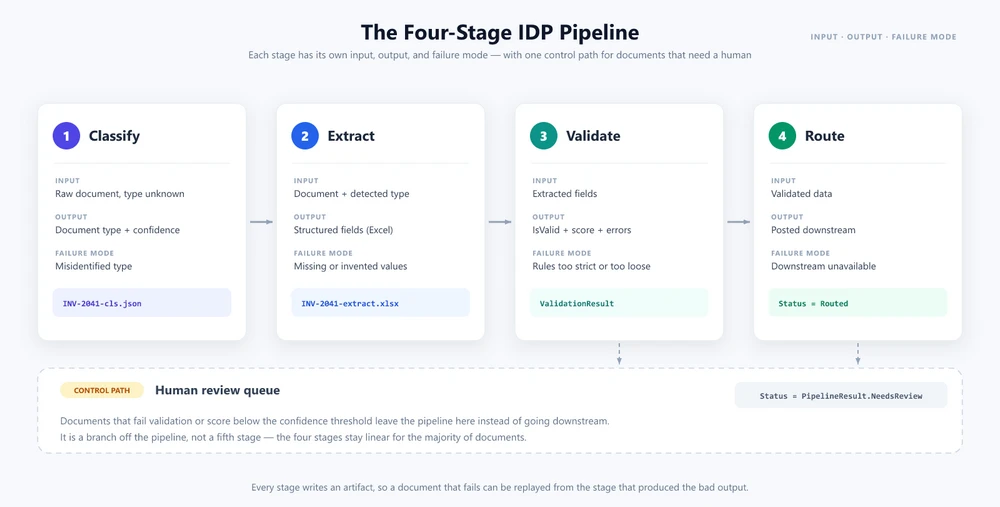
Fase 1 — Classificazione
La pipeline riceve un documento di tipo sconosciuto. La classificazione determina che cos'è il documento—una fattura, un contratto, un ordine di acquisto, una ricevuta, un estratto conto bancario—e allega metadati che guidano il comportamento downstream. In un sistema tradizionale, la classificazione si basa su convenzioni di denominazione dei file, percorsi di cartelle o corrispondenza con modelli. In una pipeline guidata dall'IA, la classificazione utilizza l'analisi del linguaggio naturale: l'agente legge il contenuto del documento e ne determina il tipo in base alla comprensione semantica.
Fase 2 — Estrazione
Una volta noto il tipo di documento, l'estrazione preleva i dati strutturati dal documento. Per una fattura, ciò significa nome del fornitore, numero di fattura, voci di riga, totali, importi fiscali, termini di pagamento. Per un contratto, significa parti, date di efficacia, clausole di risoluzione, obblighi finanziari. La fase di estrazione trasforma il contenuto del documento non strutturato o semi-strutturato in un formato strutturato (JSON, XML, record di database) che i sistemi downstream possono utilizzare.
Fase 3 — Convalida
I dati estratti vengono verificati rispetto alle regole di business. Il totale della fattura corrisponde alla somma delle voci di riga? Il fornitore è nell'elenco dei fornitori approvati? Il contratto è firmato da un firmatario autorizzato? La convalida intercetta errori di estrazione, segnala anomalie e produce un punteggio di confidenza che determina se il documento può essere instradato automaticamente o richiede revisione umana.
Fase 4 — Instradamento
I dati convalidati vengono inviati al sistema downstream appropriato: un ERP per i dati delle fatture, una piattaforma di gestione contratti per i dati dei contratti, un archivio documenti per tutto il resto. L'instradamento può anche attivare flussi di lavoro downstream—catene di approvazione, elaborazione dei pagamenti, controlli di conformità.
La revisione umana è un percorso di controllo piuttosto che una fase obbligatoria: i documenti che non superano la convalida o scendono sotto una soglia di confidenza possono essere instradati per la revisione manuale. Questo mantiene la pipeline in quattro fasi lineare per la maggior parte dei documenti, fornendo al contempo un fallback controllato per i casi limite.
Perché l'IDP richiede più di una chiamata API AI
Ogni fase ha modalità di errore indipendenti. La classificazione può identificare erroneamente un tipo di documento. L'estrazione può perdere campi o allucinare valori. La convalida può rifiutare dati validi a causa di regole troppo rigide. L'instradamento può fallire a causa dell'indisponibilità del sistema downstream. Una pipeline IDP robusta gestisce ogni modalità di errore in modo indipendente, con logica di retry, comportamento di fallback e registrazione di audit a ogni fase.
3. Creare una pipeline IDP in .NET
Un modo per implementare questa architettura in .NET è usare Spire.Agent.Office, un SDK per agenti AI che elabora documenti Word, Excel, PowerPoint e PDF tramite istruzioni in linguaggio naturale. L'SDK fornisce il metodo di estensione AI() sugli oggetti documento (Document, PdfDocument, Workbook, Presentation), che accetta una configurazione AIOptions e restituisce un AIDocumentProcessor. Chiamare ExecuteInstruction sul processore esegue l'istruzione e scrive l'output su un file, restituendo un AIResult con le proprietà Success e ErrorMessage.
Prerequisiti
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Gli esempi seguenti si concentrano sull'architettura della pipeline e sull'integrazione con Spire.Agent.Office. I metodi helper come l'analisi dei risultati e l'instradamento downstream sono omessi per brevità.
3.1 Definire il modello della pipeline
La pipeline necessita di strutture dati per trasportare i risultati tra le fasi e di una configurazione condivisa per l'agente AI.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken viene usato per autenticare Spire.Agent.Office. L'SDK gestisce la connessione al servizio AI tramite AIOptions, quindi l'applicazione non deve implementare direttamente l'integrazione con l'API del modello sottostante. WorkDir designa dove l'agente archivia i file intermedi durante l'elaborazione.
3.2 Classificare ed estrarre documenti con un agente AI
La classificazione carica il documento, chiede all'agente di identificarne il tipo e scrive il risultato in un file JSON. Lo stesso schema LoadFromFile → AI(options) → ExecuteInstruction funziona per ogni formato di documento—cambia solo la classe del documento, e quel dispatch è tuo da scrivere. AI() si associa a un tipo concreto di documento: un PDF deve essere caricato come PdfDocument, una cartella di lavoro come Workbook, una presentazione come Presentation e un file Word come Document. Passare un file alla classe sbagliata non ripiega su un lettore generico; genera un'eccezione, quindi scegli la classe dall'estensione del file prima di chiamare AI().
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
L'estrazione usa istruzioni specifiche per tipo per estrarre campi strutturati dal documento:
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
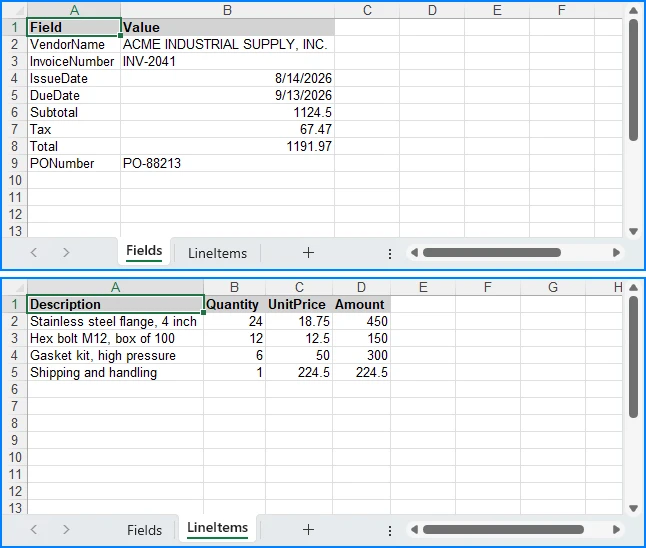
Ogni tipo di documento riceve un'istruzione dedicata che indica all'agente quali campi cercare e quale formato di output produrre. L'agente legge il documento di origine e scrive una cartella di lavoro Excel strutturata in extractPath. L'istruzione è ciò che fissa la forma di quella cartella di lavoro—denominare i fogli, le intestazioni e i nomi esatti dei campi è ciò che rende l'output analizzabile downstream. Un'istruzione che dice solo «estrai i campi della fattura» può restituire un nome di foglio diverso, una riga di intestazione diversa o un'ortografia diversa per lo stesso campo a ogni esecuzione, perché l'agente decide da sé il layout. GetField nella sezione successiva copre le variazioni che comunque sfuggono.
La separazione tra il giudizio dell'agente e il codice deterministico è trattata ulteriormente in Agente AI per l'elaborazione dei documenti.
3.3 Convalidare i dati estratti con C#
La convalida è pura logica C#—nessuna chiamata AI necessaria. L'agente ha già prodotto dati strutturati; la convalida verifica quei dati rispetto alle regole di business.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
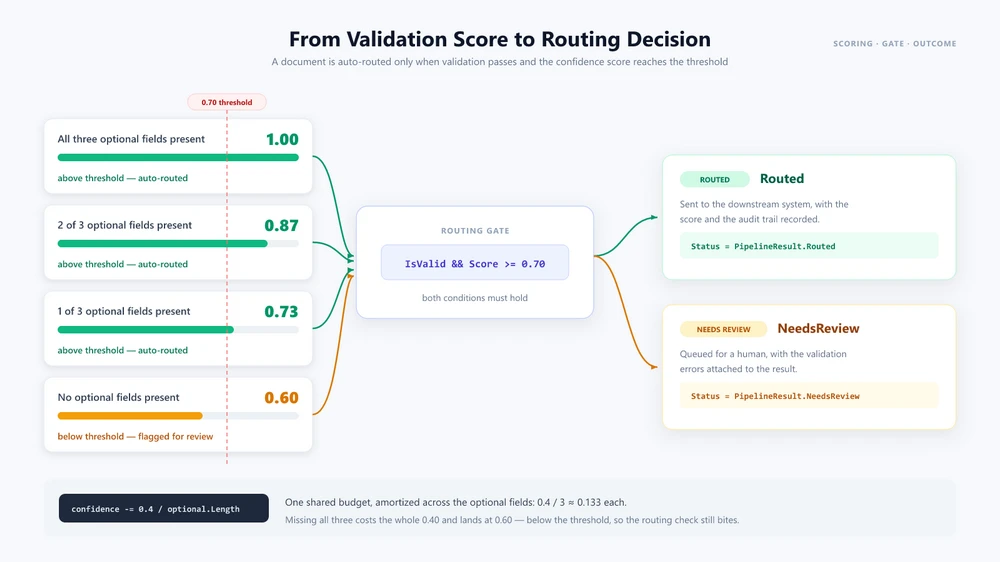
La convalida separa i fallimenti gravi dagli avvisi di qualità. Un campo obbligatorio mancante, un totale che non quadra con le voci di riga o un tipo di documento senza regole produce una voce in Errors, e il documento viene considerato non valido. Un campo opzionale che non è stato possibile estrarre abbassa solo ValidationScore, quindi un documento altrimenti valido viene comunque instradato. La deduzione è un budget fisso condiviso tra i campi opzionali anziché una penalità fissa per campo: con tre campi opzionali e il budget di 0,4 nel codice sopra, un campo mancante lascia il punteggio a 0,87 e due lo lasciano a 0,73—ancora sopra la soglia di instradamento automatico di 0,70—quindi solo perderli tutti e tre lo fa scendere a 0,60 e invia il documento in revisione. Mantenere separati questi due segnali è ciò che riserva la revisione umana ai documenti che ne hanno effettivamente bisogno.
3.4 Orchestrare la pipeline
Il metodo di orchestrazione collega le fasi insieme e prende decisioni di instradamento in base alla confidenza della convalida:
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Ogni fase è testabile in modo indipendente, ha la propria gestione degli errori e produce output di audit. Il PipelineResult restituito registra anche l'esito della fase 4 in Status, che è ciò che consente al report batch nella sezione successiva di contare i documenti in base al risultato invece di ricavarlo dal payload di convalida. In questo esempio, l'agente AI gestisce la classificazione e l'estrazione tramite istruzioni in linguaggio naturale, mentre la convalida e l'instradamento rimangono logica C# deterministica.
4. Elaborazione batch e multi-documento
Una pipeline per singolo documento è un punto di partenza. I sistemi IDP di produzione elaborano centinaia o migliaia di documenti al giorno, con tipi, priorità e destinazioni downstream variabili.
Elaborazione batch parallela
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
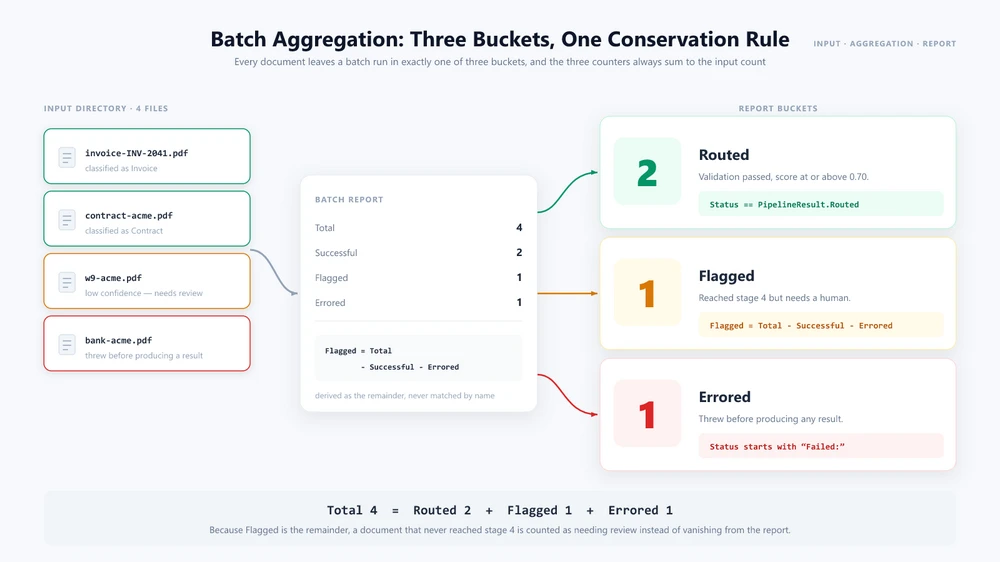
Il SemaphoreSlim limita la concorrenza per evitare di sovraccaricare il servizio AI o i sistemi downstream. Ogni documento viene elaborato in modo indipendente attraverso tutte e quattro le fasi. Il report batch suddivide i risultati nei tre modi in cui un documento può uscire dalla pipeline: Routed (convalidato e inviato downstream), Flagged (ha raggiunto la fase 4 ma richiede revisione) e Errored (ha generato un'eccezione prima di produrre un risultato). Flagged è calcolato come resto anziché confrontando una stringa di stato, quindi i tre contatori sommano sempre a Total—un documento che fallisce inaspettatamente viene segnalato come bisognoso di revisione invece di svanire dal report. Il limite di concorrenza appropriato dipende dai limiti di velocità del servizio AI, dalle dimensioni del documento e dalle risorse dell'applicazione.
Flussi di lavoro cross-documento
Alcuni processi aziendali richiedono che più documenti vengano elaborati insieme. Un flusso di lavoro di onboarding di un fornitore statunitense, ad esempio, potrebbe elaborare un modulo fiscale, un contratto e un estratto conto bancario come un'unica unità—estraendo dati da ciascuno, convalidandoli incrociatamente e producendo un output combinato.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
Il parametro attachments passa più percorsi di documenti all'agente in un'unica chiamata. L'agente legge tutti i file allegati, ragiona su di essi e produce un output combinato. Questo va oltre il ruolo di riconoscimento del testo dell'OCR tradizionale consentendo a un modello AI di ragionare su più input documentali.
Retry e revisione umana
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
I documenti che non superano la convalida o scendono sotto la soglia di confidenza vengono segnalati per la revisione umana anziché fallire silenziosamente. La strategia di retry utilizza un backoff esponenziale per errori transitori e ritenta i casi limite nella possibilità che una seconda passata li classifichi o estragga diversamente.
5. IDP in pratica
Questa sezione mostra come la pipeline gestisce scenari aziendali reali che coinvolgono più tipi di documento in un unico flusso di lavoro.
Automazione dei conti fornitori
Un reparto AP riceve fatture in formati misti—PDF, Excel, Word, immagini scansionate. Ogni fattura deve essere classificata, estratta, convalidata rispetto a un ordine di acquisto e instradata al sistema ERP.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
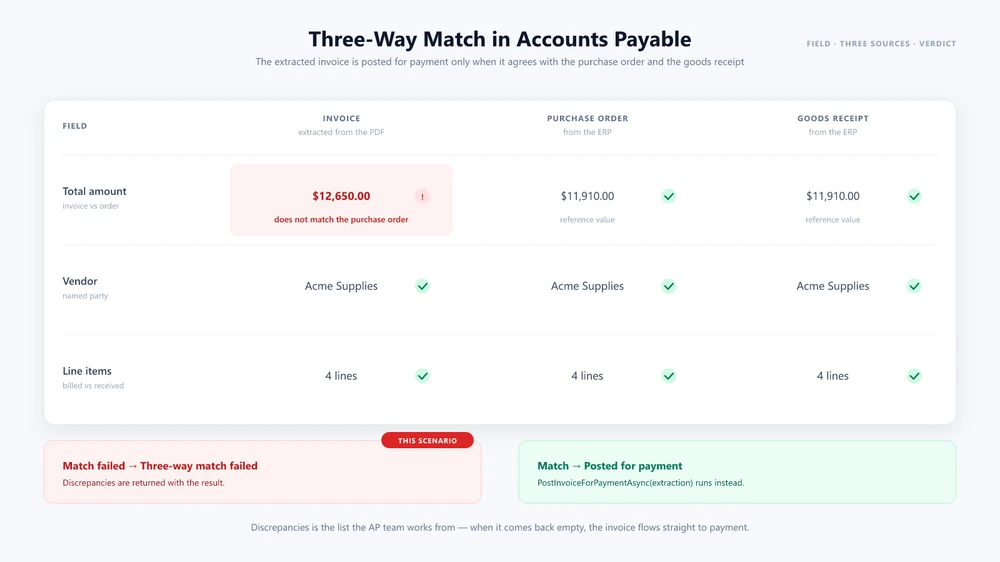
Il tutorial sull'elaborazione delle fatture copre questo scenario end-to-end: l'istruzione di estrazione, il confronto con l'ordine di acquisto e il report che il sistema finanziario consuma.
Analisi dei contratti
Un team legale riceve contratti da parti esterne. Ogni contratto deve essere analizzato, i termini chiave estratti, confrontati con il modello standard dell'azienda e instradati per la revisione se vengono trovate clausole non standard. L'agente elabora il contratto in arrivo con il modello standard allegato come documento di riferimento.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Questo flusso di lavoro combina estrazione, confronto cross-documento e generazione di documenti in un unico processo, illustrando come un agente AI possa estendere una pipeline IDP tradizionale oltre l'estrazione di campi strutturati. I pattern specifici per i contratti—revisione, estrazione e generazione da un modello—sono trattati nella guida alla revisione dei contratti con AI.
6. Build vs Buy: scegliere un approccio IDP
Il mercato IDP è dominato da piattaforme SaaS. Questa sezione aiuta gli sviluppatori a decidere quando costruire una pipeline in .NET è la scelta giusta e quando adottare una piattaforma di fornitore è più pratico.
Costruisci quando hai bisogno di una stretta integrazione con un'applicazione .NET esistente, regole di convalida personalizzate o generazione e trasformazione di documenti insieme all'estrazione. Costruire il livello di orchestrazione in .NET offre maggiore controllo su dove vengono archiviati i documenti e su come vengono elaborati. L'effettiva residenza dei dati dipende dal modello AI e dalla configurazione del servizio.
Acquista quando carichi di lavoro ad alto uso di OCR, modelli di estrazione predefiniti, infrastruttura gestita o distribuzione rapida sono la priorità. Se il tuo team non ha competenze .NET o è concentrato su altre priorità, una piattaforma gestita rimuove l'onere di implementazione.
Quadro decisionale:
| Fattore | Build (.NET + agente AI) | Buy (SaaS IDP) |
|---|---|---|
| Integrazione | In-process, nativo .NET | Chiamata API esterna |
| Residenza dei dati | Dipende dalla configurazione del modello | Cloud del fornitore |
| Operazioni sui documenti | Estrai + genera + trasforma + converti | Dipende dalla piattaforma |
| Convalida personalizzata | Controllo completo del codice | Configurazione della piattaforma |
| Flusso di lavoro personalizzato | Controllo completo del codice | Dipendente dalla piattaforma |
| Tempo per la produzione | Da settimane a mesi | Da giorni a settimane |
| Modello di costo | Costo API fisso + licenza SDK | Prezzo per documento |
La scelta giusta dipende dai requisiti della tua applicazione, dalle capacità del team e dai tipi di documento che elabori. Molti team usano un approccio ibrido: una piattaforma di fornitore per l'estrazione ad alto volume di moduli standardizzati e una pipeline .NET personalizzata per flussi di lavoro complessi che richiedono generazione di documenti, ragionamento cross-documento o stretta integrazione di sistema.
7. Domande frequenti
Che cos'è l'elaborazione intelligente dei documenti (IDP)?
L'elaborazione intelligente dei documenti è un approccio di automazione che utilizza IA e machine learning per classificare documenti, estrarre dati strutturati, convalidare i risultati rispetto alle regole di business e instradare l'output verso sistemi downstream. A differenza dell'OCR tradizionale, che converte principalmente il contenuto visivo in testo leggibile dalla macchina, l'IDP aggiunge classificazione dei documenti, estrazione semantica, convalida e automazione dei flussi di lavoro. Può gestire layout di documenti vari senza fare affidamento interamente su modelli fissi.
In che modo una pipeline IDP differisce da una singola chiamata API LLM?
Una singola chiamata LLM elabora testo ma non gestisce formati di file, non esegue operazioni sui documenti né gestisce lo stato della pipeline. Una pipeline IDP orchestra più fasi—classificazione, estrazione, convalida, instradamento—ciascuna con gestione degli errori indipendente, logica di retry e registrazione di audit. La pipeline collega anche il ragionamento AI con la manipolazione deterministica dei file, garantendo che l'output preservi la formattazione corretta.
Posso creare una pipeline IDP senza una piattaforma di fornitore?
Sì. Usando un SDK per agenti AI .NET come Spire.Agent.Office, puoi implementare tutte e quattro le fasi della pipeline in C#. L'SDK fornisce elaborazione di documenti in linguaggio naturale per file Word, Excel, PowerPoint e PDF, con output di file deterministico. Questo approccio offre il pieno controllo sulla logica di convalida e sulle regole di instradamento.
Quali formati di documento gestisce una pipeline IDP?
Con Spire.Agent.Office, la pipeline gestisce file Word (.docx, .doc), Excel (.xlsx, .xls), PowerPoint (.pptx, .ppt) e PDF. I documenti scansionati possono richiedere un passaggio OCR prima dell'estrazione basata su AI, a seconda del documento e del flusso di lavoro di elaborazione. La pipeline può anche convertire tra formati come parte della fase di instradamento.
In che modo l'agente AI si connette al modello linguistico?
Spire.Agent.Office usa una proprietà SpireToken in AIOptions per autenticarsi con il servizio AI. L'SDK gestisce la connessione al servizio AI tramite AIOptions, quindi l'applicazione non deve implementare direttamente l'integrazione con l'API del modello sottostante. Questa progettazione separa l'elaborazione dei documenti dalla configurazione del modello, così il codice della pipeline rimane lo stesso indipendentemente dal modello che alimenta l'agente.
Quanto è accurata l'estrazione di documenti basata su AI?
L'accuratezza dell'estrazione dipende fortemente dalla qualità del documento, dalla variabilità del layout, dalla qualità dell'OCR, dal comportamento del modello e dalle istruzioni di estrazione. I sistemi di produzione dovrebbero convalidare i valori estratti rispetto a regole di business deterministiche e instradare i casi incerti per la revisione umana. La fase di convalida aiuta a rendere l'estrazione basata su AI più affidabile in produzione verificando i valori estratti rispetto a regole deterministiche e instradando i risultati incerti per la revisione.
Qual è la differenza tra IDP e OCR?
L'OCR (Optical Character Recognition) converte il contenuto visivo del documento in testo leggibile dalla macchina. L'IDP si basa su questa capacità ma aggiunge comprensione, convalida e automazione dei flussi di lavoro guidate dall'AI. Una pipeline IDP può utilizzare l'OCR internamente per documenti scansionati, ma l'OCR da solo non classifica i documenti, non convalida i dati estratti né instrada i risultati verso sistemi downstream.
Come funziona l'elaborazione batch in una pipeline IDP?
L'elaborazione batch esegue la pipeline in modo concorrente su più documenti, con limiti di concorrenza configurabili per gestire l'uso delle risorse. Ogni documento viene elaborato in modo indipendente attraverso tutte e quattro le fasi, con risultati aggregati in un report batch. I documenti non riusciti vengono segnalati per la revisione senza bloccare il resto del batch.
Pronto a creare una pipeline IDP?
Se stai sviluppando l'elaborazione intelligente dei documenti in un'applicazione .NET, inizia con la guida introduttiva per Spire.Agent.Office, che copre l'installazione dell'SDK e l'esecuzione della tua prima istruzione in .NET.
Ulteriori letture
- Agente AI vs. API LLM grezza: livello documentale in .NET — cosa aggiunge un livello documentale rispetto a una chiamata API LLM grezza e quando ciascun approccio è adatto
- Trasforma documenti in presentazioni PowerPoint con AI in C# — lo stesso schema guidato da istruzioni applicato all'output di diapositive