Lire un PDF avec pypdf est l’affaire de dix minutes. Les difficultés commencent lorsque le même script doit extraire un tableau récapitulatif de la première page, supprimer l’annexe, produire une copie Word modifiable et verrouiller l’archive avec un mot de passe. Chaque demande a une bonne réponse en Python, mais elles proviennent rarement du même paquet.
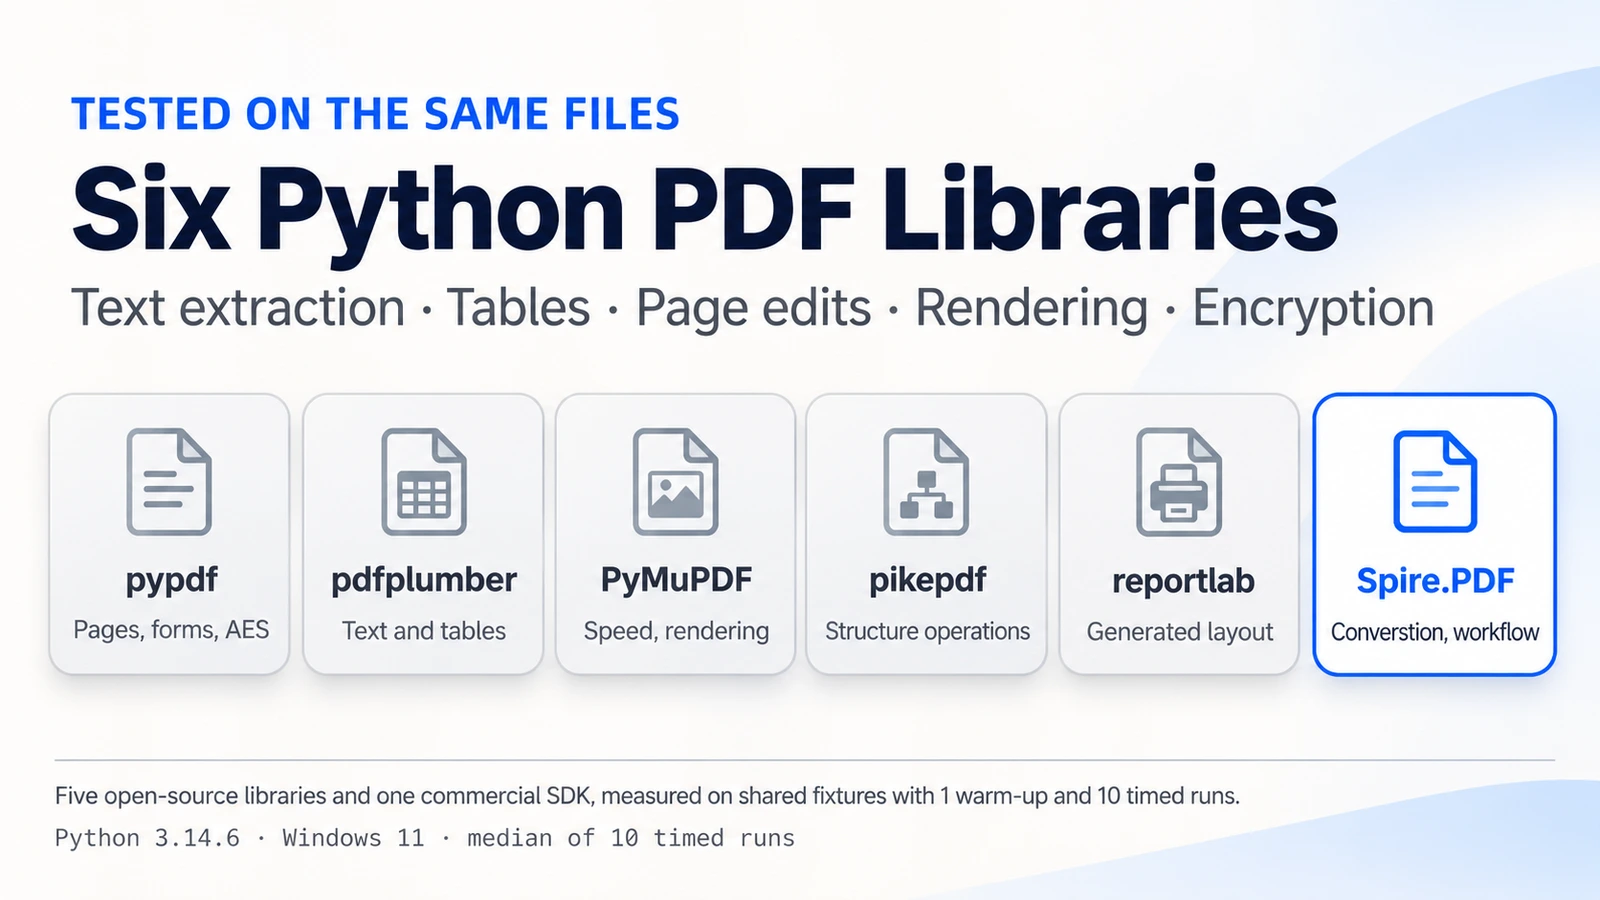
Ce guide compare six options sur un même ensemble de fichiers de test : pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab et Spire.PDF pour Python. Divulgation : Spire.PDF est un produit commercial d’E-iceblue, éditeur de cet article, et E-iceblue a réalisé les tests. Les fixtures, les versions et la méthode de chronométrage sont indiquées dans la section « Comment nous avons testé » afin que vous puissiez reproduire n’importe quel résultat. Chaque bibliothèque ci-dessous est un choix raisonnable pour la tâche à laquelle elle est destinée.
Quelle bibliothèque PDF Python choisir ?
Si votre travail consiste en une seule opération, choisissez le spécialiste correspondant. Les bibliothèques open source de cette comparaison sont solides dans leur domaine. Spire.PDF vise l’autre cas : un pipeline dans lequel un même document passe par l’extraction, la modification, la conversion et le chiffrement, et où vous préférez maintenir un seul SDK plutôt que trois bibliothèques.
| Bibliothèque | Idéal pour | Point clé | Licence |
|---|---|---|---|
| pypdf | Fusionner, fractionner, faire pivoter et chiffrer des pages en Python pur | Le chiffrement AES nécessite l’extra pypdf[crypto]
|
BSD-3 |
| pdfplumber | Analyse de mise en page, extraction de tableaux, débogage visuel | Conçu pour la lecture, pas pour la modification des pages | MIT |
| PyMuPDF | Extraction de texte et rendu de pages rapides | AGPL-3.0 ou commercial ; à évaluer selon votre mode de distribution | AGPL-3.0 ou commercial |
| pikepdf | Travail sur la structure bas niveau, linéarisation, chiffrement | Aucune API d’extraction de texte | MPL-2.0 |
| reportlab | Générer des PDF à partir de code | Génération uniquement | BSD |
| Spire.PDF | Tâches mixtes (extraire, modifier, convertir, chiffrer) dans un seul SDK | Licence commerciale ; options de licence gratuite, d’évaluation et temporaire | Commerciale |
Lisez le tableau par tâche plutôt que par nom. Si votre pipeline n’a besoin que de l’opération indiquée dans la première colonne d’une bibliothèque, la troisième colonne est la seule chose qui reste à évaluer. Les conditions de licence et le poids de l’installation ont tendance à départager des candidats proches, et les sections ci-dessous chiffrent les deux.
Note de périmètre : il s’agit de cinq bibliothèques open source sélectionnées et d’un SDK commercial. Cela ne couvre pas tous les outils PDF spécialisés de l’écosystème Python.
Ce que font le mieux certaines bibliothèques PDF Python open source
Les personnes qui recherchent une bibliothèque d’analyse PDF Python ou une bibliothèque de lecture PDF Python veulent généralement l’une de deux choses : extraire du texte et des tableaux de fichiers existants, ou restructurer les fichiers eux-mêmes. Les cinq bibliothèques ci-dessous se répartissent le long de cette ligne. pdfplumber et PyMuPDF sont les plus fortes du côté lecture, pypdf et pikepdf du côté structure de page, et reportlab du côté création de documents à partir de zéro. Chaque entrée indique l’axe principal de la bibliothèque, ce que nous avons mesuré et où s’arrête son périmètre.
pypdf
pypdf est une bibliothèque Python pure pour le travail au niveau des pages, avec une empreinte installée de 1,8 Mo dans notre environnement propre. Lors de nos exécutions, elle a extrait un document texte de 10 pages en 43,1 ms, fait pivoter une page en 9,2 ms, supprimé une page en 8,6 ms, fusionné deux fichiers en 14,7 ms, extrait trois pages en 10,2 ms et appliqué un chiffrement AES-256 en 19,6 ms. AES nécessite l’extra pypdf[crypto], ce qui porte l’installation à 13,2 Mo. C’est un premier choix naturel lorsque vous réorganisez des pages sans vouloir de dépendances compilées ; la protection AES implique l’extra crypto mentionné ci-dessus.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
Le script fusionne deux fichiers, fait pivoter la première page et écrit une copie protégée par AES-256.
pdfplumber
pdfplumber est l’outil à utiliser lorsque vous devez voir comment une page est agencée. Il expose les positions des caractères, des lignes et des rectangles, ce qui rend l’extraction de tableaux et le débogage visuel pratiques. Le tableau bordé de 21 × 4 de notre fixture a été produit en 44,6 ms, et l’extraction de texte brut sur dix pages a pris 320,4 ms, plus longtemps que les lecteurs axés sur le texte, tandis que la bibliothèque expose aussi le détail positionnel dont dépendent l’analyse de mise en page et le travail sur les tableaux. Une facture chinoise d’une page a été lue en 7,7 ms et a renvoyé l’expression attendue « 发票编号 ». Il lit les PDF et ne les modifie pas, il accompagne donc généralement une seconde bibliothèque.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
L’appel renvoie le premier tableau de la première page sous forme de liste de lignes.
PyMuPDF
PyMuPDF combine traitement de texte et rendu au-dessus d’un moteur compilé. Il a obtenu le temps d’extraction de texte le plus bas du test, 7,2 ms pour dix pages, a supprimé une page en 3,0 ms et rendu une page à 150 DPI en 48,8 ms. L’installation par défaut est de 201,3 Mo avec ses dépendances (104,5 Mo avec --no-deps), ce qui en fait l’option la plus lourde ici, et la licence est AGPL-3.0 ou commerciale. Si votre service génère des vignettes ou fait passer beaucoup de pages par l’extraction de texte, les chiffres expliquent sa popularité.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
L’extrait lit le texte de la première page et en enregistre un PNG à 150 DPI.
pikepdf
pikepdf encapsule la bibliothèque QPDF et travaille sur la structure d’objet PDF elle-même. Cela convient à des tâches comme faire pivoter ou supprimer des pages (6,4 ms et 5,8 ms), les réordonner (6,5 ms), appliquer un chiffrement AES-256 avec un gestionnaire de révision 6 (32,0 ms) et enregistrer un fichier linéarisé pour une diffusion web (7,8 ms). Il ne propose pas d’API d’extraction de texte, les équipes l’associent donc généralement à un lecteur. Choisissez-le lorsque vous avez besoin de manipuler des objets PDF bas niveau, de restructurer des pages, de chiffrer ou de linéariser.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
Le code définit une rotation de 90 degrés sur la première page et enregistre le résultat.
reportlab
reportlab existe pour créer des PDF, et il le fait avec un contrôle total sur les polices, les coordonnées et les mises en page fluides. Dans le test, il a généré un document de 10 pages, 40 lignes par page en Arial 10 pt, en 14,1 ms. Il n’a pas vocation à lire ou modifier des fichiers existants, ce qui est une frontière claire plutôt qu’une lacune : factures, étiquettes et rapports générés sont ses domaines de prédilection.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
La boucle produit un fichier A4 de 10 pages avec 40 lignes par page.
Quand un workflow PDF multi-bibliothèques devient difficile à maintenir
Rien de ce qui précède n’est un défaut. Les frictions apparaissent lorsqu’une seule exigence nécessite plusieurs de ces bibliothèques à la suite, et chaque outil ajouté entraîne des coûts qui n’apparaissent pas dans une seule ligne de benchmark :
- La conversion nécessite un convertisseur distinct. La conversion PDF vers Word ne fait pas partie des lecteurs et éditeurs de pages ci-dessus, vous en ajoutez donc un, et la fidélité de la mise en page doit être vérifiée fichier par fichier.
- La modification de texte sur place est une tâche à part. Les opérations sur les pages déplacent ou suppriment des pages entières ; modifier des mots à l’intérieur d’une page demande autre chose.
- Les formulaires complexes sont un sujet distinct. Lire des champs simples est une chose, créer et aplatir des formulaires en est une autre, et les bibliothèques diffèrent dans leur degré de prise en charge.
- Les signatures et le PDF/A nécessitent des outils supplémentaires. Les workflows d’archivage et de signature impliquent généralement des paquets additionnels.
- L’OCR est externe par conception. Les pages numérisées nécessitent un moteur extérieur à toutes ces bibliothèques.
Un exemple concret aide. Un script de collage typique ouvre le fichier dans une bibliothèque, écrit un fichier intermédiaire, rouvre ce fichier dans une deuxième bibliothèque, l’enregistre à nouveau, puis passe le résultat à un convertisseur qui l’analyse une troisième fois. Chaque transfert est un endroit où les polices, les zones de page ou les indicateurs de chiffrement peuvent changer, et chacun nécessite son propre test. Rien de tout cela n’est difficile à écrire ; c’est la partie qui ne cesse de grossir à mesure que les exigences évoluent.
Sous les cinq se trouve le même surcoût : une API de plus à apprendre, une arborescence de dépendances de plus, une matrice de compatibilité de plus et un chemin de gestion des erreurs de plus, ainsi qu’un transfert de fichiers entre outils.
Les licences méritent une ligne à part. Le convertisseur courant pdf2docx est sous licence MIT, et il dépend de PyMuPDF, qui est sous AGPL-3.0 ou commerciale. Ce sont deux faits distincts, et un produit distribué devrait évaluer les deux. Pour un examen plus approfondi du côté lecture du problème, consultez notre guide sur l’analyse des PDF en Python.
Ce que Spire.PDF pour Python apporte aux workflows PDF
Spire.PDF pour Python est un SDK commercial qui gère la lecture, la modification, la conversion, la sécurité et la génération dans un seul paquet. Quatre domaines comptent pour la comparaison.
1. Un modèle de document partagé et une API cohérente
Un modèle de document partagé et une API Python cohérente permettent aux développeurs d’effectuer plusieurs opérations PDF dans un seul SDK. Des classes d’assistance spécialisées, comme PdfTableExtractor, fonctionnent avec le PdfDocument chargé. Le même PdfDocument chargé peut servir à plusieurs opérations, sans transmettre de fichiers PDF intermédiaires entre bibliothèques distinctes. Cela signifie aussi un seul schéma de gestion des erreurs et un seul ensemble de contraintes de version à suivre lors des mises à niveau.
2. Performance d’extraction de tableaux dans notre benchmark
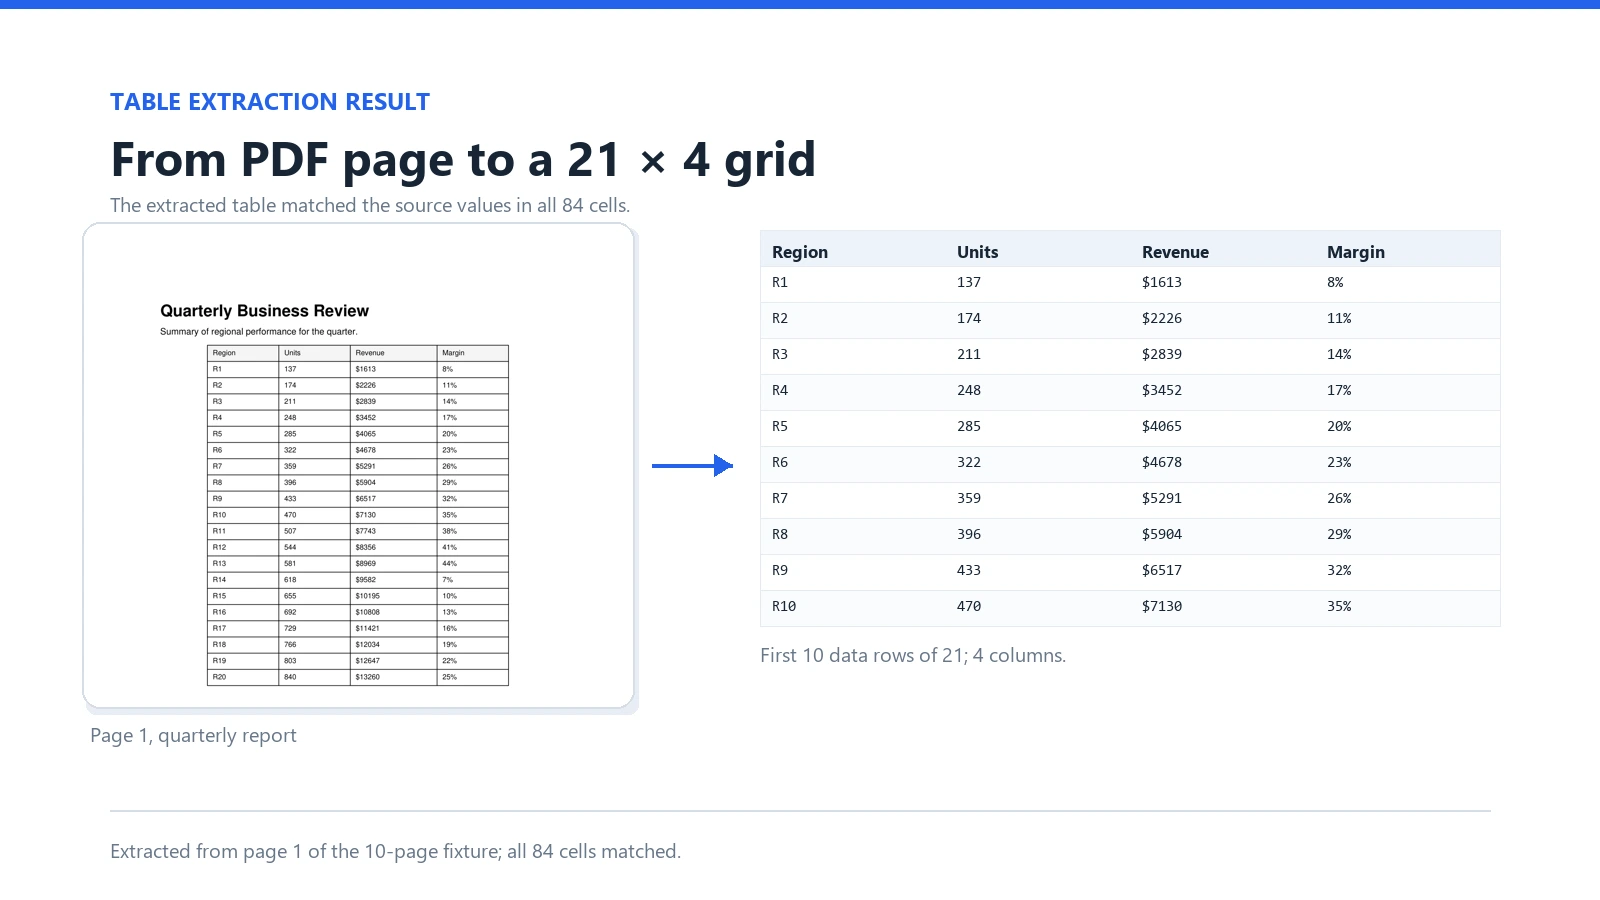
Nous avons fait passer le même tableau bordé par trois bibliothèques. La fixture comporte 21 lignes sur 4 colonnes, des bordures clairement dessinées et aucune cellule fusionnée. La documentation officielle indique que l’extraction de tableaux fonctionne mieux avec des tableaux clairement formatés, ces résultats ne décrivent donc que ce type de tableau.
| Bibliothèque | Médiane | Plage | Résultat |
|---|---|---|---|
| Spire.PDF | 18,9 ms | 16,2 à 26,4 ms | 21 × 4, les 84 cellules correctes |
| pdfplumber | 44,6 ms | 42,3 à 53,7 ms | 21 × 4, les 84 cellules correctes |
| PyMuPDF | 363,4 ms | 341,6 à 385,7 ms | 21 × 4, les 84 cellules correctes |
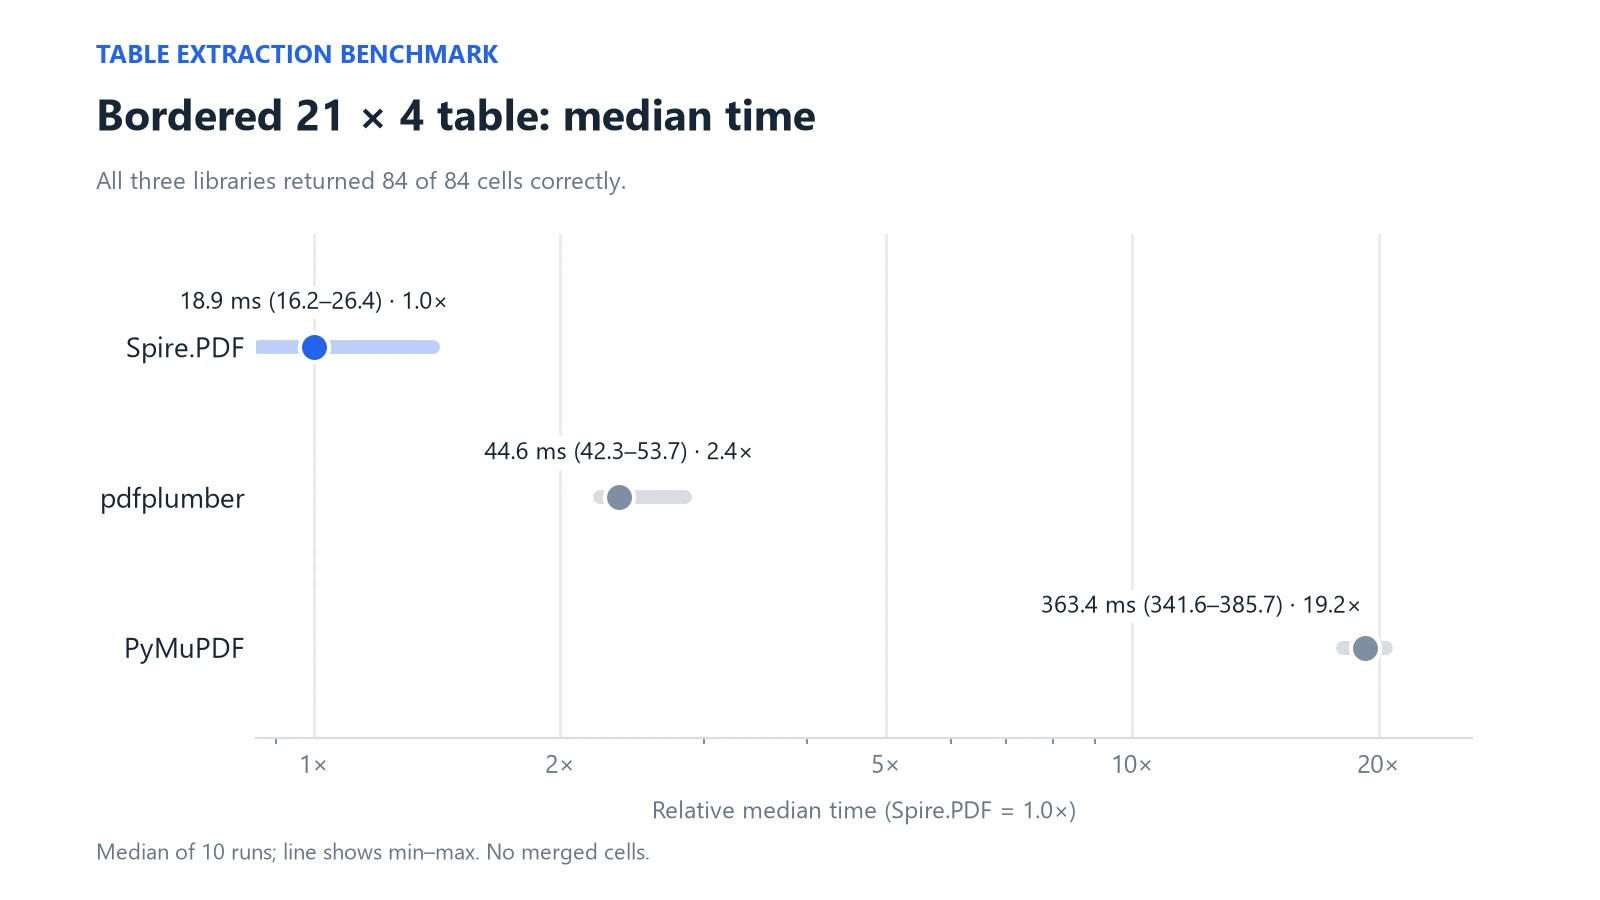
Les trois ont renvoyé des contenus de cellules identiques, la comparaison porte donc sur le temps à exactitude égale. Spire.PDF a enregistré la médiane la plus basse dans ce test. Les tableaux avec cellules fusionnées, bordures manquantes ou pages numérisées n’ont pas été mesurés et peuvent donner un classement différent. Pour une démonstration pas à pas de la même API, consultez l’extraction de tableaux depuis un PDF en Python.
3. Formulaires
Spire.PDF pour Python documente des API pour créer et remplir des champs de formulaire, ainsi que pour les aplatir en contenu statique. La gestion des formulaires n’a pas été incluse dans notre benchmark de performance, cette section ne décrit donc que les capacités documentées.
4. Export vers d’autres formats
Le même document chargé peut être enregistré dans plusieurs formats. Lors de nos exécutions, les sorties ci-dessous ont été produites à partir d’un rapport de 10 pages.
| Direction | Niveau de vérification |
|---|---|
| PDF vers DOCX, HTML, Markdown | Sortie générée ; contenu texte vérifié |
| PDF vers XLSX | Sortie générée ; contenu des cellules présent ; la structure dépend de la mise en page source |
| PDF vers PNG, XPS, SVG, PPTX | Sortie générée ; la fidélité visuelle dépend de la mise en page source |
| PDF vers PDF/A-1a et PDF/A-1b | Méthodes de conversion disponibles ; sortie générée et identifiants XMP vérifiés ; conformité formelle PDF/A non validée indépendamment |
La sortie de conversion dépend de la mise en page source ; validez des fichiers représentatifs avant une utilisation en production. Pour le détail de la conversion DOCX, consultez le tutoriel sur la conversion de PDF en Word en Python.
Un workflow PDF multi-étapes en Python
Pour voir l’argument de maintenance en code, nous avons pris une tâche réaliste. Un rapport trimestriel de 40 pages nécessite l’extraction de son tableau récapitulatif et la suppression de ses pages d’annexe. À partir du fichier mis à jour, deux sorties sont requises : un DOCX modifiable et une archive PDF chiffrée en AES-256.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
L’implémentation open source utilise pdfplumber pour le tableau, pypdf[crypto] pour la suppression de pages et le chiffrement, et pdf2docx pour la copie Word. Cela fait trois paquets qui touchent directement aux PDF. Installés ensemble dans un environnement propre, ils totalisent 29 distributions et 388,9 Mo, contre 70,5 Mo pour Spire.PDF mesuré de la même manière.
Avec Spire.PDF, tout le flux reste à l’intérieur d’un seul objet document :
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
Pour une comparaison de temps à conditions égales, les deux implémentations ont été exécutées sur la version de 10 pages du rapport. Les trois paquets open source ont pris une médiane de 1 346,2 ms au total et Spire.PDF a pris 267,3 ms. Les deux ont extrait correctement les 84 cellules du tableau, et les deux ont produit un PDF chiffré de 9 pages qui s’est rouvert avec le mot de passe. Les deux archives ont refusé de s’ouvrir sans le mot de passe. Sur le rapport de 40 pages, la pile open source a pris 3 241,4 ms et produit 39 pages ; la version d’évaluation de Spire.PDF ne traite que les 10 premières pages, nous ne comparons donc pas cette exécution (voir la section sur les éditions).
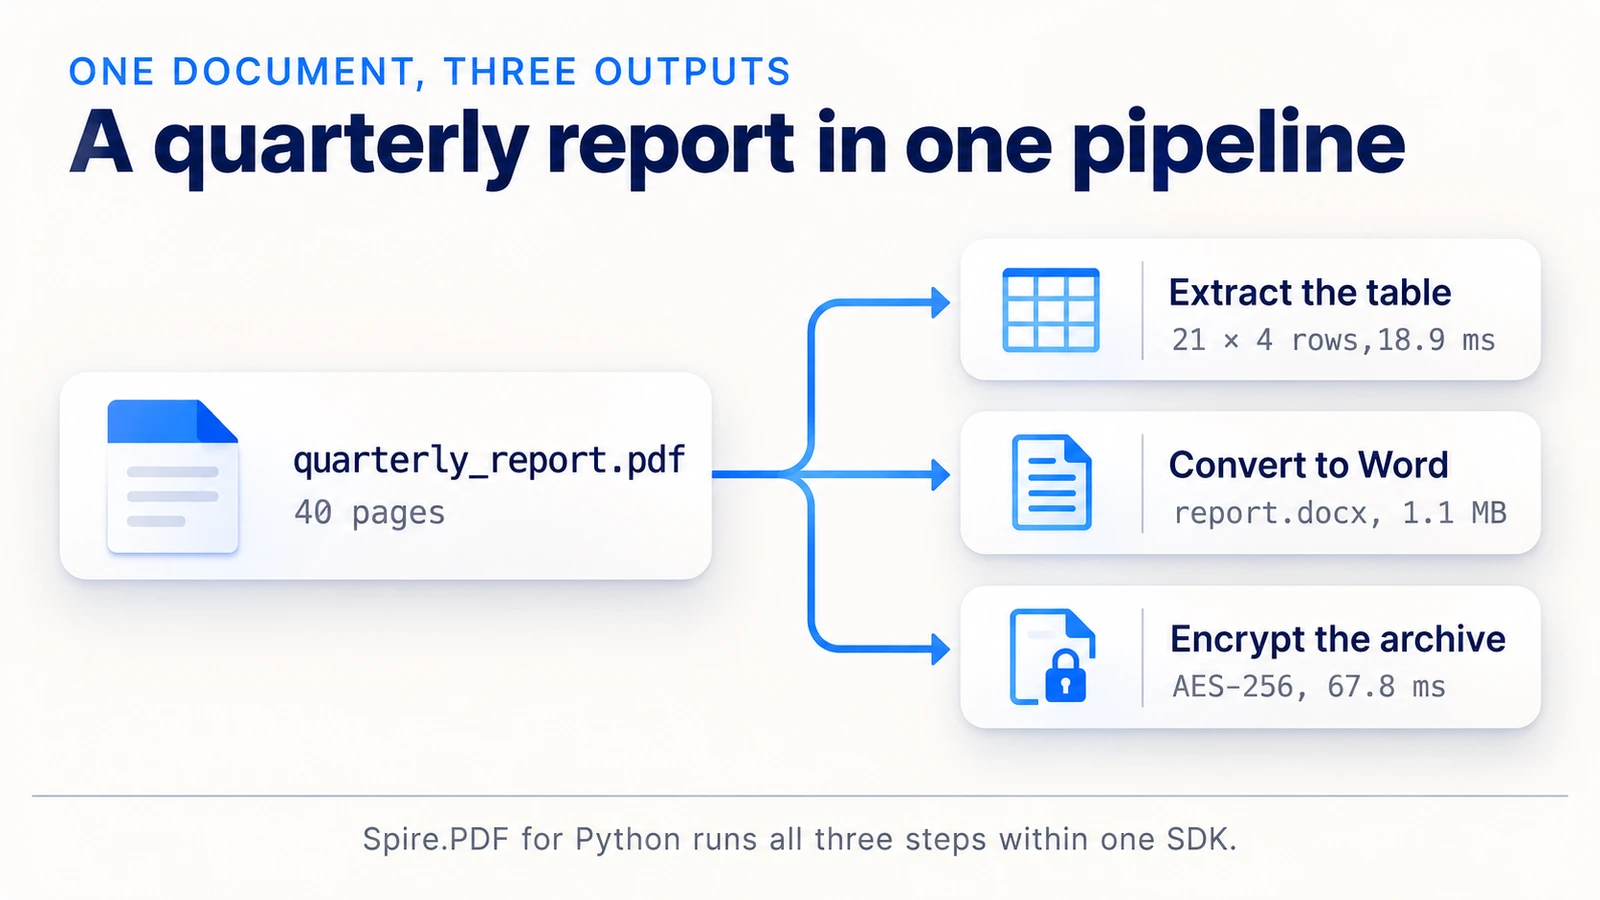
Cette comparaison couvre l’extraction de tableaux, la suppression de pages, la génération DOCX et PDF, le chiffrement et le temps écoulé ; la fidélité de mise en page DOCX est hors de cette comparaison de temps et doit être validée sur vos propres fichiers. L’essentiel de la différence de temps se situe à l’étape DOCX, où le convertisseur open source a passé environ 1,3 s. L’intérêt de l’exercice tient moins au chronomètre qu’à la forme du code : un seul import, un seul objet document, aucun fichier transmis entre paquets. Pour plus de détails sur la gestion des mots de passe, consultez la protection ou la déprotection de documents PDF en Python.
Performance et taille d’installation
Chaque chiffre ci-dessous est une médiane de 10 exécutions chronométrées après une exécution de préchauffage, en millisecondes, avec le minimum et le maximum entre parenthèses. Chaque valeur est un temps de bout en bout pour l’opération : l’ouverture de la fixture et l’enregistrement de la sortie sont inclus lorsqu’ils s’appliquent. « n/d » signifie que la bibliothèque ne propose pas cette opération.
| Tâche | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| Texte, 10 pages | 43,1 (39,9–46,1) | 320,4 (295,5–573,8) | 7,2 (6,7–8,4) | n/d | n/d | 58,2 (53,8–64,6) |
| Tableau, 84 cellules | n/d | 44,6 (42,3–53,7) | 363,4 (341,6–385,7) | n/d | n/d | 18,9 (16,2–26,4) |
| Faire pivoter une page | 9,2 (8,5–13,1) | n/d | 3,8 (2,7–11,0) | 6,4 (5,6–7,7) | n/d | 22,4 (20,6–29,9) |
| Supprimer une page | 8,6 (8,2–14,7) | n/d | 3,0 (2,8–3,4) | 5,8 (5,5–6,9) | n/d | 23,3 (20,2–27,8) |
| Rendu à 150 DPI | n/d | n/d | 48,8 (47,2–52,3) | n/d | n/d | 161,4 (153,8–180,3) |
| Chiffrement AES-256 | 19,6 (17,2–24,6) | n/d | n/d | 32,0 (30,9–34,4) | n/d | 67,8 (62,1–72,2) |
| Générer 10 pages | n/d | n/d | n/d | n/d | 14,1 (13,7–15,3) | 85,3 (79,4–106,9) |
Sur des opérations isolées, les spécialistes arrivent en tête dans la plupart des lignes : PyMuPDF pour le texte, la rotation, la suppression et le rendu, pypdf pour les modifications de pages en Python pur, pikepdf pour le travail structurel, et les deux pour le chiffrement, avec reportlab pour la génération. La médiane la plus basse de Spire.PDF était dans le test de tableaux. La génération comparait 10 pages de 40 lignes chacune, A4, Arial 10 pt. Dans le test de rendu, PyMuPDF et Spire.PDF ont tous deux produit des images de 1241 × 1754 pixels à 150 DPI. La valeur d’un SDK unique apparaît dans les workflows combinés, pas dans une ligne isolée.
Installation, mesurée dans un environnement virtuel propre et hors interpréteur, pip, setuptools, wheel et __pycache__ :
| Cible | Taille installée | Paquets | Import dans un nouveau processus |
|---|---|---|---|
| pypdf | 1,8 Mo | 1 | 219,9 ms |
| pypdf[crypto] | 13,2 Mo | 4 | 331,8 ms |
| pdfplumber | 43,9 Mo | 8 | 246,5 ms |
| PyMuPDF (par défaut) | 201,3 Mo | 12 | 223,8 ms |
PyMuPDF (--no-deps) |
104,5 Mo | 1 | 217,0 ms |
| pikepdf | 35,2 Mo | 4 | 178,4 ms |
| reportlab | 20,4 Mo | 3 | 9,0 ms |
| Spire.PDF | 70,5 Mo | 2 | 640,6 ms |
| Pile de workflow à trois paquets | 388,9 Mo | 29 | n/d |
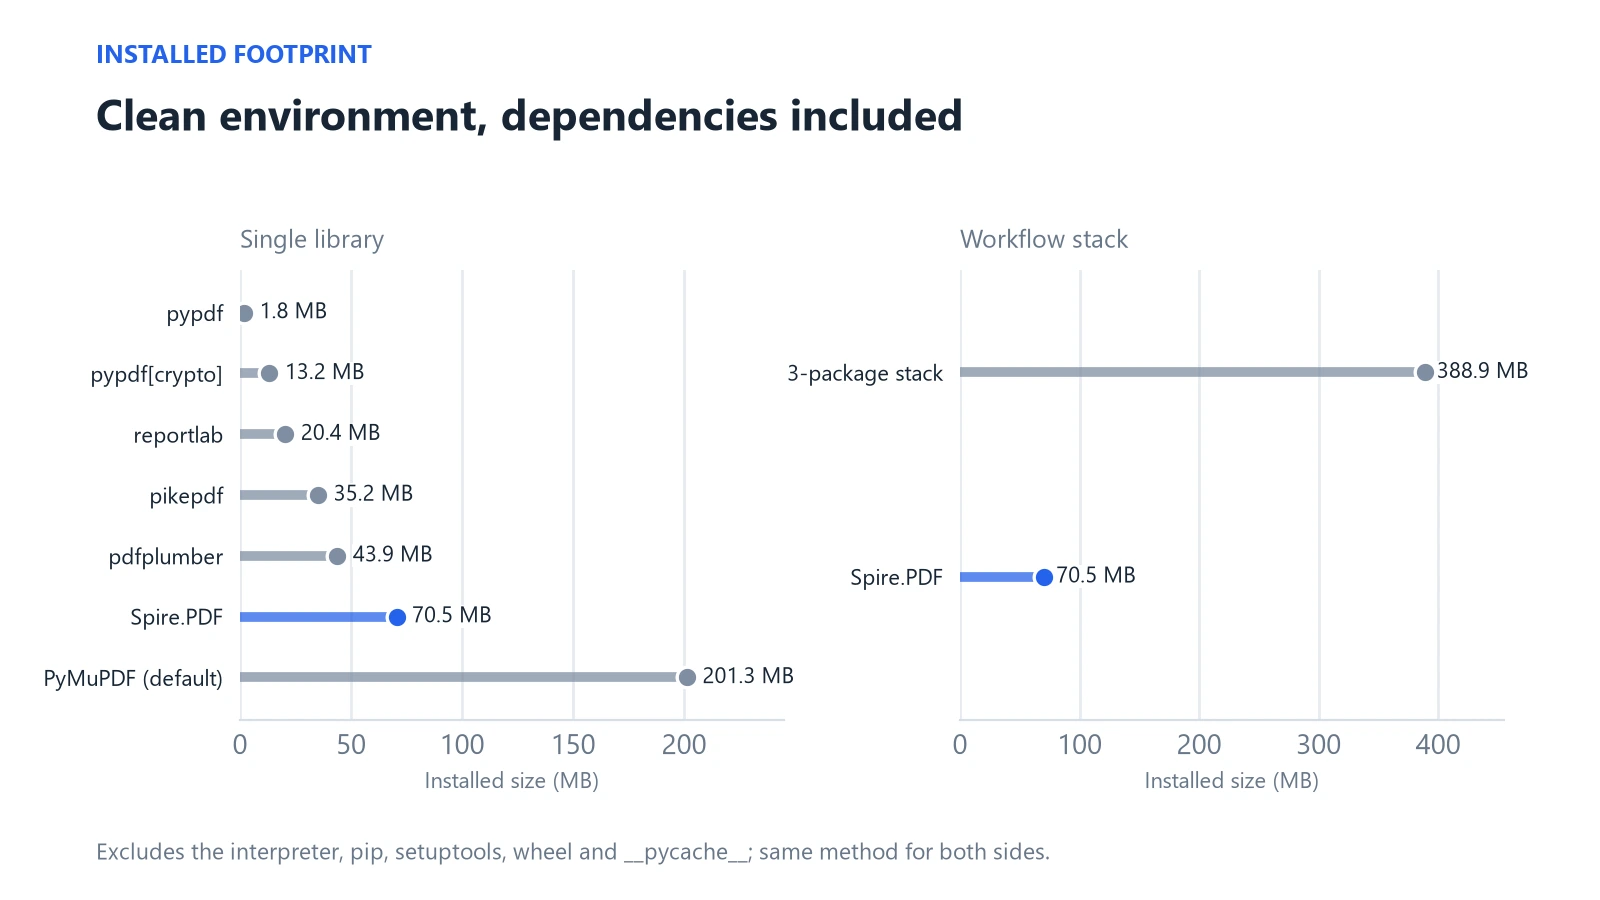
Deux détails méritent d’être relevés dans le tableau d’installation. Le temps d’import est un coût ponctuel par processus, il compte donc davantage pour les tâches en ligne de commande de courte durée et les fonctions serverless que pour les services de longue durée ; l’import à froid de Spire.PDF a mesuré 640,6 ms, toujours sous une seconde, tandis que celui de reportlab était le plus court à 9,0 ms. La taille d’installation compte pour les images de conteneurs et le packaging de bureau, où les 201,3 Mo par défaut de PyMuPDF et la pile de 388,9 Mo à trois paquets se distinguent.
Licences en une ligne chacune : pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 ou commerciale, pikepdf MPL-2.0, reportlab BSD, Spire.PDF commerciale. Les conditions AGPL doivent être évaluées au regard de votre mode de distribution de logiciel.
Édition gratuite, évaluation, temporaire et commerciale
Spire.PDF est un produit commercial avec plusieurs éditions, et elles se comportent différemment ; vérifiez donc laquelle est installée avant de faire des benchmarks ou de livrer.
| Paquet / version | Statut | Limites |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | Édition gratuite | Sortie limitée à 10 pages ; conversion en image, XPS, Word et HTML limitée aux 3 premières pages |
| spire-pdf 12.10.0 (2026-10-12) | Évaluation | Avertissement d’évaluation ; 10 premières pages traitées |
| spire-pdf 12.10.0 | Licence temporaire (30 jours) | Limites d’évaluation supprimées |
| spire-pdf 12.10.0 | Commerciale | Aucune des limites ci-dessus |
Au-delà de l’API, une licence commerciale est aussi une relation de maintenance. Le paquet fournit des wheels pour Windows, Linux et macOS, a enregistré sept versions entre janvier et octobre 2026 (12.1.3 à 12.10.0), et les licences commerciales incluent les mises à jour et le support technique via le forum et l’e-mail du fournisseur, avec des objectifs de réponse dépendant du niveau de licence.
Le plafond de pages est facile à vérifier : un fichier de 40 pages chargé dans la version d’évaluation ne produit que 10 pages traitées. C’est une propriété de l’édition d’évaluation, pas de la capacité du produit, et c’est la raison pour laquelle notre exécution du workflow de 40 pages n’est rapportée que pour la pile open source. Les versions d’évaluation sont destinées à l’évaluation, pas à la production. Pour les équipes qui découvrent le produit, une séquence sensée consiste à commencer par la version d’évaluation sur vos propres fichiers, demander une licence temporaire lorsque vous devez tester au-delà de 10 pages, puis passer à une licence commerciale avant la livraison.
Choisir la bonne bibliothèque PDF pour votre projet
Trois profils couvrent la plupart des équipes :
- Une tâche spécialisée unique. Extraire du texte à grande échelle, générer le rendu de pages, fusionner des fichiers ou produire des rapports : choisissez la bibliothèque conçue pour cette opération, comme PyMuPDF, pypdf ou reportlab. Vérifiez la licence si vous redistribuez.
- Lecture sensible à la mise en page. Si les tableaux et les positions sont au centre, pdfplumber est l’outil de départ, avec pypdf ou pikepdf pour les modifications de pages.
- Tâches enchaînées sur le même fichier. Lorsque l’extraction, les modifications de pages, la conversion et le chiffrement font partie d’un même pipeline, un SDK unique réduit le nombre d’API et d’arbres de dépendances à maintenir. C’est là que Spire.PDF est conçu pour s’intégrer ; une licence commerciale couvre les mises à jour et le support.
Un test rapide avant de vous engager : notez chaque opération dont le projet aura besoin au cours de l’année à venir, y compris la conversion, le chiffrement et l’archivage, et indiquez quelle bibliothèque couvre chacune. Si une seule bibliothèque couvre toute la liste, vous avez terminé. Si la liste en nécessite trois, comparez le coût de trois dépendances à celui d’une licence.
Comptez les tâches, pas les fonctionnalités. Si vous pouvez nommer les opérations dont votre projet a besoin en une phrase et qu’il y en a une ou deux, un spécialiste suffit probablement. Si la liste ne cesse de s’allonger, essayez Spire.PDF pour Python sur vos propres fichiers.
Comment nous avons testé
Divulgation : Spire.PDF pour Python est un produit d’E-iceblue, et ce benchmark a été réalisé par l’éditeur. Nous avons donc publié les fixtures, les versions et la méthode, et les bibliothèques open source ont été testées sur exactement les mêmes fichiers.
- Environnement : Windows 11, Intel Core i3-10105 à 3,70 GHz (4 cœurs, 8 threads), 8,4 Go de RAM, Python 3.14.6.
- Versions : pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- Fixtures : un document texte de 10 pages, un tableau bordé de 21 × 4 en première page, une facture en chinois, une page à contenu mixte pour le rendu, et des rapports trimestriels générés de 10 et 40 pages. Les nombres de pages, tailles et hachages SHA-256 sont consignés dans un manifeste de fixtures.
- Chronométrage : un préchauffage et 10 exécutions mesurées par test, rapportés sous forme de médianes avec minimum et maximum. L’ouverture, l’opération et l’enregistrement ont été chronométrés en phases séparées.
- Exactitude : texte comparé par couverture de jetons uniques et similarité de séquence (pas par nombre brut de caractères, car les conventions d’espacement diffèrent) ; tableaux comparés cellule par cellule ; fichiers chiffrés rouverts avec le mot de passe et vérification du blocage d’accès sans celui-ci.
- Non couvert : une seule machine et une seule charge de travail ; documents numérisés, OCR, signatures, gestion de formulaires, tableaux à cellules fusionnées et fichiers endommagés arbitraires n’ont pas été mesurés. Les temps varieront sur votre matériel et vos documents.
Questions fréquentes
Quelle est la meilleure bibliothèque PDF Python dans l’ensemble ? Il n’y a pas de vainqueur unique. PyMuPDF domine pour la vitesse de texte et de rendu, pypdf est le choix simple pour les opérations sur les pages, pdfplumber pour les tableaux, reportlab pour la génération. Pour les pipelines qui enchaînent plusieurs tâches, un SDK unique comme Spire.PDF peut réduire le nombre de paquets PDF directement intégrés.
pypdf ou PyMuPDF : lequel utiliser ? Choisissez pypdf pour les opérations sur les pages dans un petit paquet Python pur sous licence BSD. Choisissez PyMuPDF pour une extraction de texte et un rendu de pages plus rapides, et vérifiez d’abord ses conditions AGPL-3.0 ou commerciales. Dans notre test, PyMuPDF a pris 7,2 ms pour le texte contre 43,1 ms.
Comment extraire un tableau d’un PDF en Python ?
Pour les tableaux bordés, appelez extract_tables() dans pdfplumber, ou utilisez un extracteur de tableaux dans PyMuPDF ou Spire.PDF. Sur notre fixture de 21 × 4, les trois ont correspondi à 84 cellules sur 84. Les tableaux sans bordures ou avec cellules fusionnées nécessitent des tests séparés.
Python peut-il convertir un PDF en Word ? Oui. pdf2docx est une option open source courante, et Spire.PDF peut enregistrer un document chargé au format DOCX. La sortie de conversion dépend de la mise en page source ; validez des fichiers représentatifs avant une utilisation en production.
Ces bibliothèques sont-elles gratuites pour un usage commercial ? pypdf, pdfplumber, pikepdf et reportlab utilisent des licences permissives ou à faible copyleft (BSD-3, MIT, MPL-2.0, BSD). PyMuPDF est sous AGPL-3.0 ou commerciale, évaluez-le donc selon votre mode de distribution. Spire.PDF nécessite une licence commerciale pour la production ; les licences commerciales incluent les mises à jour et le support technique, tandis que les éditions gratuite et d’évaluation ont des limites de pages.
Sources
- Documentation pypdf
- Dépôt pdfplumber
- Documentation PyMuPDF
- Documentation pikepdf
- Documentation ReportLab
- Documentation pdf2docx
- Guide de programmation Spire.PDF pour Python