Le choix d'une bibliothèque PDF JavaScript commence généralement par une tâche simple : générer une facture, afficher un contrat, apposer un tampon sur une page. Quelques mois plus tard, le même projet doit lire des PDF, imprimer du texte chinois ou transformer un modèle Word en PDF, et la bibliothèque choisie pour la première tâche ne couvre qu'une partie de la seconde.
Nous avons fait passer sept bibliothèques par un même banc d'essai dans le navigateur afin de voir où chacune résiste : pdf-lib, jsPDF, PDFKit, PDF.js, @react-pdf/renderer, pdfmake et Spire.PDF for JavaScript. Vous trouverez ci-dessous des temps mesurés, des tailles de sortie, le comportement des polices et les résultats de conversion, suivis d'une recommandation pour chaque scénario.
Divulgation : Spire.PDF for JavaScript est un produit d'E-iceblue, l'éditeur de cet article, et E-iceblue a réalisé les tests. Les versions, les fichiers de test et la méthode sont indiqués dans Comment nous avons testé. Les résultats défavorables à notre propre produit sont rapportés aux côtés de ceux qui lui sont favorables.
Quelle bibliothèque PDF JavaScript choisir ?
Partez de la tâche. Chaque bibliothèque de cette comparaison arrive en tête dans certaines lignes du tableau ci-dessous, et aucune ne l'emporte dans toutes.
| Tâche | Meilleur choix dans ce test | Pourquoi |
|---|---|---|
| Générer un PDF à partir de code, petit et rapide | jsPDF, PDFKit | jsPDF avait la médiane la plus basse sur 10 pages (3,9 ms) |
| Générer des tableaux et de longs rapports avec sauts de page automatiques | pdfmake | Mise en page déclarative avec prise en charge des tableaux |
| Générer des PDF à partir de composants React | @react-pdf/renderer | API de composants, PDFKit en dessous |
| Lire du texte, afficher des PDF | PDF.js | Analyseur, API d'affichage et visionneuse dans un seul projet |
| Modifier un PDF existant | pdf-lib | Modifie des fichiers qui existent déjà |
| Convertir des PDF vers d'autres formats, ou combiner plusieurs des tâches ci-dessus dans un seul package | Spire.PDF for JavaScript | 12 cibles de sortie exercées dans nos tests |
Les cinq premières lignes correspondent à des tâches uniques, et une bibliothèque open source spécialisée les réalise bien chacune. La dernière ligne correspond à l'autre cas : un projet qui a besoin de plusieurs de ces tâches, ou de n'importe quelle conversion entre formats, où le calcul change. Les sections sur les limites d'une bibliothèque unique et sur Spire expliquent pourquoi.
Ce que chaque bibliothèque fait le mieux
Deux des trois expressions que les gens recherchent ici décrivent des tâches plutôt que des bibliothèques. Un analyseur PDF JavaScript lit des fichiers, et un éditeur PDF JavaScript modifie des fichiers qui existent déjà. Cette distinction est déterminante, c'est pourquoi chaque entrée ci-dessous se termine par ce que la bibliothèque ne sait pas faire.
pdf-lib (1.17.1) crée des PDF et modifie ceux qui existent déjà, ce qui en fait l'éditeur PDF JavaScript open source habituel.
import { PDFDocument, StandardFonts } from 'pdf-lib'

const doc = await PDFDocument.create()
const page = doc.addPage([595.28, 841.89])
const font = await doc.embedFont(StandardFonts.Helvetica)
page.drawText('Hello', { x: 40, y: 800, size: 12, font })
const bytes = await doc.save()
Choisissez-la lorsqu'un PDF arrive d'ailleurs et que vous devez ajouter une page, superposer du texte ou renseigner des valeurs. Elle n'a pas d'API d'extraction de texte : elle a lu le nombre de pages de notre fichier de test de 10 pages en 8 ms, et c'est là toute l'étendue de sa prise en charge de la lecture. Sa dernière version, 1.17.1, date du 2021-11-06. Si vous cherchez une alternative à pdf-lib pour cette raison, le fork communautaire @cantoo/pdf-lib poursuit le code.
jsPDF (4.2.1) génère des documents dans le navigateur avec des appels impératifs.
import { jsPDF } from 'jspdf'

const doc = new jsPDF()
doc.text('Hello', 10, 10)
const buffer = doc.output('arraybuffer')
Elle convient aux exports rapides où quelques lignes de code produisent un reçu ou une page de rapport. Elle ne fait que créer des fichiers, elle ne peut donc pas ouvrir et modifier un PDF existant, ce qui constitue la ligne de démarcation habituelle entre pdf-lib et jsPDF. Son option compress endommage aussi le texte chinois, ce qui est traité dans la section sur les polices ci-dessous. Toute personne cherchant une alternative à jsPDF doit d'abord déterminer si la pièce manquante est l'édition (pdf-lib), les tableaux (pdfmake) ou React (React-PDF).
PDFKit (0.20.2) génère des documents dans Node et, avec un bundler, dans le navigateur. La version navigateur nécessite l'enregistrement manuel des polices standard.
import PDFDocument, { registerStdFonts } from 'pdfkit'
import Helvetica from 'pdfkit/standard-fonts/Helvetica'
registerStdFonts(Helvetica)

const doc = new PDFDocument()
doc.font('Helvetica').text('Hello')
Vous placez vous-même le texte et les graphiques, car PDFKit est une API de dessin et non un moteur de rendu HTML/CSS ; une page web ne peut donc pas lui être simplement transmise. Ce contrôle convient aux documents à mise en page fixe, comme les étiquettes, les certificats et les relevés. Elle ne peut pas lire les PDF existants.
PDF.js (6.5.438) est un cœur d'analyseur, une API d'affichage et une visionneuse prête à l'emploi. C'est le choix open source pour lire et afficher des PDF, et elle gère l'extraction de texte.
import * as pdfjsLib from 'pdfjs-dist'

const doc = await pdfjsLib.getDocument({ data: bytes }).promise
const page = await doc.getPage(1)
const content = await page.getTextContent()
Les développeurs qui recherchent un analyseur PDF JavaScript aboutissent généralement ici, car elle renvoie du texte structuré et des données de page plutôt que des octets bruts. Elle ne peut pas créer un PDF de zéro, et ses capacités d'édition se limitent à ce que couvre saveDocument, comme la sélection de pages et les modifications d'annotations. Ce n'est pas un éditeur PDF polyvalent.
@react-pdf/renderer (4.9.0) transforme des composants React en PDF. Elle repose sur PDFKit, elle rencontre donc la même erreur de police standard non enregistrée dans le navigateur.
import { Document, Page, Text, pdf } from '@react-pdf/renderer'

const blob = await pdf(
  <Document><Page><Text>Hello</Text></Page></Document>
).toBlob()
Elle convient aux équipes qui décrivent déjà leur interface en React et veulent que les factures ou les rapports partagent des composants avec elle. Elle ne produit que des fichiers. Lire ou modifier un fichier existant nécessite une autre bibliothèque.
pdfmake (0.3.14) prend une définition de document déclarative et gère les tableaux et les sauts de page. Depuis la version 0.3, getBuffer renvoie une Promise. Le code qui passe un callback n'est jamais rappelé.
import pdfMake from 'pdfmake/build/pdfmake'
import pdfFonts from 'pdfmake/build/vfs_fonts'
pdfMake.vfs = pdfFonts.vfs

const buffer = await pdfMake.createPdf({ content: ['Hello'] }).getBuffer()
C'est la plus confortable des six bibliothèques open source pour les sorties longues et riches en tableaux, car vous décrivez le contenu et la bibliothèque décide où les pages se coupent. Elle génère des documents à partir d'un objet de définition et ne peut ni analyser ni modifier des PDF existants.
Spire.PDF for JavaScript (11.7.0) est la seule entrée ici qui ne couvre pas un seul segment.
Chaque bibliothèque ci-dessus se spécialise dans une tâche, et la section suivante montre ce que cela coûte lorsqu'un projet en nécessite deux. Celle-ci exécute les mêmes quatre tâches via une API unique — génération, extraction de texte, opérations sur les pages et rendu en image — et ajoute douze cibles de conversion qu'aucune des autres ne possède. Ses limites sont celles que nous avons mesurées et rapportées ci-dessous : ce n'est pas un composant de visionneuse, et l'utilisation en production nécessite une licence commerciale. Des exemples de code et les résultats complets de conversion se trouvent dans sa propre section.
Où s'arrête une bibliothèque unique
Aucune des six bibliothèques open source ne génère, n'analyse, ne modifie et n'affiche des PDF. Chacune couvre un segment.
Prenons un flux de travail qui semble ordinaire : lire un modèle DOCX client, renseigner les données de commande, produire un PDF, puis le protéger par mot de passe. Aucune des six n'ouvre un fichier Word ; un package gère donc l'étape DOCX, généralement sur un serveur. Une bibliothèque de mise en page écrit ensuite le PDF, et un troisième package applique la protection. Cela fait trois packages et deux transferts.
Les rôles se brouillent aussi dans les conversations. Les gens disent « générer un PDF » alors qu'ils veulent dire trois choses différentes : dessiner un document à partir de code, afficher un fichier existant à un utilisateur, ou transformer une page en image. PDF.js affiche, les générateurs dessinent, et aucune des six ne fait les trois. Noter le sens dont votre projet a besoin élimine la moitié de la liste restreinte.
Chaque transfert est un ArrayBuffer à valider, et chaque package apporte ses propres règles pour les polices et les encodages. Les pièces sont bonnes individuellement, et c'est dans la glue entre elles que le coût de maintenance s'accumule. Les équipes le ressentent généralement la première fois qu'une exigence franchit une frontière, par exemple « exporter aussi le résultat au format Word ».
Ce que Spire.PDF for JavaScript ajoute
Spire.PDF for JavaScript s'exécute en WebAssembly dans le navigateur, de sorte que les documents peuvent être traités côté client sans aller-retour avec un serveur. Nous l'avons testée via le package spire.office, version 11.7.0.
Son API couvre la fusion, la division, la compression, les opérations sur les pages, les champs de formulaire, les annotations, les signets, les pièces jointes et les calques ; le guide de programmation de Spire.PDF for JavaScript répertorie l'ensemble des fonctionnalités. La partie que nous avons mesurée ici est la conversion. Nous avons converti un PDF chinois de 2 pages (13,1 Ko) vers dix des treize valeurs de l'énumération FileFormat, plus l'export PNG et une conversion PDF/A.
| Sortie | Taille |
|---|---|
| DOCX | 5 132 598 o |
| XLSX | 9 594 o |
| PPTX | 27 827 o |
| HTML | 89 687 o |
| Markdown | 558 o |
| XPS | 24 202 o |
| OFD | 17 281 o |
| PCL | 47 272 o |
| PostScript | 87 159 o |
| PNG (page 1, 184 ms) | 19 789 o |
| PDF/A-1b | 57 581 o |
| SVG (un fichier par page) | 44 777 o par page |
Les douze cibles ont converti le fichier chinois. L'export SVG écrit un fichier par page, nommé output_1.svg, output_2.svg, etc. Le DOCX de 5,1 Mo provient de la police chinoise transportée dans le fichier Word, et les documents anglais ne se comportent pas de cette manière.
import * as spire from '/spire.pdf.js'
const { PdfDocument, PdfFont, PdfFontFamily, PdfBrushes } = spire.spirepdf

const doc = new PdfDocument()
const page = doc.Pages.Add()
const font = new PdfFont({ fontFamily: PdfFontFamily.Helvetica, size: 12 })
page.Canvas.DrawString({ s: 'Hello', font, brush: PdfBrushes.get_Black(), x: 40, y: 60 })
doc.SaveToFile({ fileName: 'out.pdf' })
Les paramètres sont fournis sous forme d'un seul objet littéral. Les arguments positionnels déclenchent une erreur Ambiguous call. La conversion nécessite une étape supplémentaire, car WebAssembly n'a pas de polices système :
PdfDocument.LoadCustomFontFolder('/Library/Fonts')   // skipping this raises "Cannot found font"

const doc = new PdfDocument()
doc.LoadFromFile({ fileName: 'in.pdf' })
doc.SaveToFile({ fileName: 'out.docx', fileFormat: spire.spirepdf.FileFormat.DOCX })
Copiez un fichier de police dans ce dossier du système de fichiers virtuel avant de l'appeler.
Comme tout s'exécute dans un seul package WebAssembly, une seule page peut ouvrir un PDF, le modifier et l'enregistrer dans un autre format sans transmettre d'octets à une seconde bibliothèque. Les équipes qui traitent dans le navigateur des fichiers téléversés par les utilisateurs, où l'envoi de documents à un serveur pose une question de confidentialité ou de conformité, ont tendance à en bénéficier le plus.
Trois chiffres ont leur place dans tout plan de déploiement. Le premier chargement a pris 1 900,7 ms (2 756 ms lors d'une autre exécution à froid), et l'essentiel est du CPU : l'environnement d'exécution télécharge environ 19 Mo d'archives WebAssembly et les décompresse avec JSZip avant l'ouverture du premier document. Les deux archives sont Spire.Common.Wasm (10,1 Mo) et Spire.Pdf.Wasm (8,6 Mo). La glue JavaScript ajoute environ 1,3 Mo brut mais se compresse à environ 117 Ko sur le réseau ; les archives elles-mêmes sont déjà dégonflées et ne gagnent rien avec gzip.
Office vers PDF dans un seul package
Les six bibliothèques open source partent d'un PDF. Les fichiers Word, Excel et PowerPoint sortent de leur périmètre, c'est pourquoi le flux de travail de la section précédente nécessitait un quatrième package.
Spire.Office for JavaScript est une famille de packages npm avec quatre points d'entrée pour Word, Excel, PowerPoint et PDF. Chaque point d'entrée possède son propre module WebAssembly, et un module commun se trouve sous tous. Word vers PDF, Excel vers PDF et PowerPoint vers PDF s'exécutent dans le navigateur sans serveur, et PDF vers Word, Excel, PowerPoint et HTML passent par la même famille.
Pour un didacticiel avec du code fonctionnel, voir convertir Word en PDF avec JavaScript dans React.
Une limite s'applique à chaque affirmation de cette section : notre benchmark n'a chronométré que des opérations PDF. La conversion Office vers PDF n'a pas été mesurée ici, il n'y a donc aucun chiffre de vitesse ou de fidélité pour elle dans cet article. Quiconque prévoit de dépendre de cette voie doit la chronométrer avec ses propres fichiers Word et Excel, car la complexité de la mise en page modifie bien plus le coût de conversion que la taille du fichier. Ce que nous pouvons dire est structurel. Un flux de travail de modèle qui nécessitait trois packages peut être écrit avec une seule famille de packages, et les transferts de fichiers entre bibliothèques disparaissent.
Performances et coût de chargement
Chaque bibliothèque a terminé un document anglais de 10 pages en moins de 100 ms. jsPDF a été la plus rapide à 3,9 ms et Spire a pris 90,7 ms, un écart mesurable mais peu susceptible d'avoir de l'importance dans un export déclenché par un clic.
| Bibliothèque | Premier appel | Médiane (10 pages) | Taille de sortie |
|---|---|---|---|
| jsPDF | 12,1 ms | 3,9 ms | 6 609 o |
| PDFKit | 45,7 ms | 6,8 ms | 6 194 o |
| pdf-lib | 86,1 ms | 9,2 ms | 3 123 o |
| pdfmake | 75,6 ms | 25,4 ms | 16 823 o |
| React-PDF | 125,5 ms | 36,3 ms | 7 395 o |
| Spire | 486,0 ms | 90,7 ms | 7 723 o |
La colonne du premier appel mérite un coup d'œil. Elle inclut l'initialisation unique, elle montre donc ce que voit un utilisateur au premier clic après le chargement de la page. Les bibliothèques open source vont de 12,1 à 125,5 ms, et Spire prend 486,0 ms. Toutes se stabilisent rapidement lors des appels répétés.
Le coût réel réside dans le chargement : Spire a pris 1 900,7 ms contre 13 à 211 ms pour les autres.
| Bibliothèque | Premier import |
|---|---|
| jsPDF | 13,0 ms |
| React-PDF | 53,2 ms |
| PDFKit | 119,2 ms |
| pdf-lib | 191,7 ms |
| pdfmake | 197,0 ms |
| PDF.js | 211,2 ms |
| Spire.PDF for JavaScript | 1 900,7 ms |
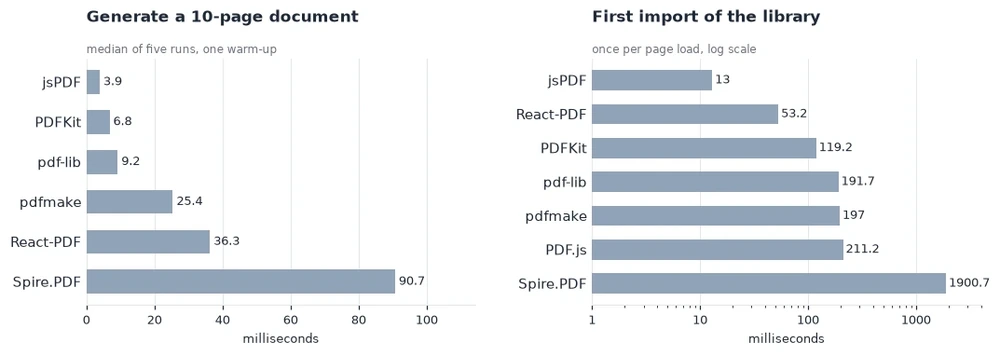
Considérez les deux chiffres comme des budgets différents. Le temps de génération est dépensé par document, et le temps de chargement est dépensé une fois par visite. Un outil qui exporte des centaines de fichiers dans une session ne paie les 1,9 seconde qu'une seule fois, tandis qu'une page d'atterrissage qui exporte un seul fichier paie tout ce temps pour ce fichier.
Ce délai pénalise une page où le travail PDF intervient lors du premier rendu. Lorsque la conversion démarre après un clic, le chargement anticipé ou à la demande du module masque l'essentiel.
La taille de sortie dépend davantage des réglages que de la bibliothèque. Avec un PNG de 800x800, jsPDF a produit 1 923 288 o par défaut et 32 044 o avec compress: true. pdf-lib (128,1 ms) et PDFKit (189,6 ms) ont inséré la même image plus vite que jsPDF (257,8 ms), à 26 846 o et 27 993 o.
La lecture est un benchmark distinct, exécuté sur un PDF de 10 pages :
| Bibliothèque | Lire le nombre de pages | Extraire le texte |
|---|---|---|
| pdf-lib | 8 ms | Non pris en charge |
| Spire | 94 ms | 284 ms |
| PDF.js | 200 ms | 190 ms |
Comparez uniquement les temps. Spire a été configurée pour préserver les espaces et a renvoyé 1 381 caractères, tandis que PDF.js joint les éléments de texte et a renvoyé 521, les nombres de caractères ne sont donc pas comparables.
Texte chinois et gestion des polices
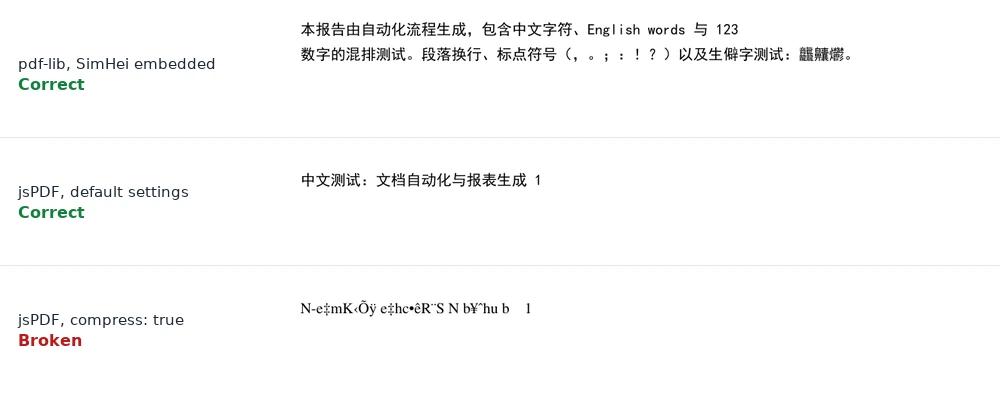
Les six bibliothèques open source nécessitent un fichier de police chinoise que vous fournissez. Nous avons utilisé SimHei (TrueType de 9,7 Mo). Une fois fourni, chacune d'elles a intégré la police et rendu le texte correctement, ce que nous avons confirmé en rendant la sortie avec PyMuPDF.
| Bibliothèque | Médiane, 1 page en chinois | Taille de sortie |
|---|---|---|
| jsPDF | 1,1 ms (premier appel 479,8 ms) | 3 160 o |
| React-PDF | 7,3 ms | 11 286 o |
| pdfmake | 10,7 ms | 5 323 o |
| PDFKit | 11,3 ms | 10 743 o |
| pdf-lib | 32,7 ms | 9 693 o |
| Spire (TTF intégré) | 169,3 ms | 12 289 o |
Le fichier de police lui-même fait 9,7 Mo, que votre page doit livrer ou récupérer ; prévoyez donc de le charger à la demande et de le mettre en cache. Les 1,1 ms de jsPDF s'appliquent après l'enregistrement de la police. Le premier appel, qui inclut l'enregistrement, a pris 479,8 ms ; ce chiffre ne doit donc pas être interprété comme un avantage de vitesse.
Le piège se trouve dans jsPDF. Une page chinoise générée avec les réglages par défaut faisait 184 355 o et s'affichait correctement. Avec compress: true, le fichier est tombé à 3 168 o, ne contenait aucun caractère chinois et s'affichait en charabia latin. La police avait disparu de la table des polices, et le rendu l'a confirmé ; l'extraction n'était donc pas le problème. Laissez la compression désactivée pour les documents chinois et vérifiez la page rendue. Les pages composées uniquement d'images se compressent sans risque (de 1 923 288 o à 32 044 o), il s'agit donc d'une décision à prendre document par document.
Spire propose des familles de polices CJK intégrées qui ne nécessitent aucun fichier de police, et elles produisent la plus petite sortie que nous ayons vue (2 262 o) car la police n'est pas intégrée. La couverture dépend de la famille : SinoTypeSongLight a rendu chaque caractère de notre échantillon, tandis que MonotypeHeiMedium et MonotypeSungLight ont supprimé 报 et 数. Vérifiez votre jeu de caractères par rapport à la famille choisie, ou intégrez un TTF, qui s'est affiché correctement dans notre test.
PDF/A et licences
PDF/A est le profil d'archivage du PDF, et de nombreux flux de travail documentaires et de conformité l'exigent. Un fichier peut sembler correct dans une visionneuse et pourtant échouer à la norme ; nous avons donc vérifié la sortie avec un validateur plutôt qu'à l'œil. Nous avons validé la sortie d'archivage avec veraPDF 1.30.3. Les fichiers PDF/A-1b et PDF/A-2b de Spire ont tous deux réussi. PDFKit, appelé via son option documentée subset: 'PDF/A-1b', a échoué avec cinq violations : polices non intégrées (6.3.4), clé de métadonnées manquante (6.7.2) et métadonnées Info et XMP qui ne concordent pas (6.7.3). Le fichier source Spire, non converti, a également échoué à la 1b, ce qui montre que le validateur distingue les bons fichiers des mauvais. Nous n'avons pas testé les autres bibliothèques pour PDF/A.
Spire.PDF for JavaScript existe en trois éditions. L'édition gratuite, sur free-pdf-for-javascript, couvre la génération et la conversion de fichiers PDF et ne comporte pas de filigrane. La version d'évaluation utilisée pour ce benchmark protège sa sortie par un filigrane et une limite de pages. Une licence temporaire gratuite supprime les deux pendant que vous évaluez le produit, et une licence commerciale couvre l'utilisation en production, ce qui est l'arrangement habituel pour un SDK commercial.
Une façon pratique d'évaluer consiste à choisir trois de vos documents réels : le plus long, un avec du texte chinois ou autre texte non latin, et un qui doit sortir en PDF/A ou en Word. Demandez une licence temporaire gratuite pour cette exécution, afin que la longueur du document ne soit pas un facteur, puis comparez avec la bibliothèque open source que vous auriez utilisée autrement, sur le temps de chargement comme sur la sortie.
Comment nous avons testé
Les tests ont été exécutés dans un projet Vite dans un navigateur basé sur Chromium sous Windows 11 Pro (10.0.26300), avec Node v26.12.1 et npm 12.0.1. Chaque mesure a utilisé une exécution de préchauffage et cinq répétitions, et nous rapportons la médiane. Le fichier de test d'image était un PNG de 800x800 généré sur un canvas à l'exécution, et les tests en chinois ont utilisé SimHei.
Les versions des bibliothèques étaient pdf-lib 1.17.1, jsPDF 4.2.1, PDFKit 0.20.2, PDF.js 6.5.438, @react-pdf/renderer 4.9.0, pdfmake 0.3.14 et spire.office 11.7.0. Les polices ont été vérifiées par rendu avec PyMuPDF, et les fichiers PDF/A avec veraPDF.
Le projet de banc d'essai et ses scripts d'analyse sont reproductibles, afin qu'une équipe puisse réexécuter les mêmes cas sur son propre matériel et comparer. Les temps varieront selon la machine, et les ratios entre bibliothèques constituent le signal le plus utile.
Les documents de test faisaient 10 pages ou moins. La comparaison des pixels rendus entre bibliothèques, ainsi que la sortie PDF/A pour les bibliothèques autres que Spire et PDFKit, ne faisaient pas partie de cette exécution. Comme indiqué au début, E-iceblue a réalisé ce benchmark et publie Spire.PDF for JavaScript.
Questions fréquentes
Puis-je afficher des PDF dans le navigateur ? Utilisez PDF.js, qui comprend une API d'affichage et une visionneuse. Nous n'avons pas comparé les pixels rendus entre bibliothèques. Spire.PDF for JavaScript convertit une page en PNG (184 ms pour la page 1 dans notre test) mais n'est pas un composant de visionneuse ; pour l'affichage et l'édition dans le navigateur, Spire.OfficeJS est la suite front-end conçue pour cette tâche.
Quelle bibliothèque est la meilleure pour le texte chinois ?
N'importe laquelle des six bibliothèques open source fonctionne une fois que vous fournissez une police, sauf jsPDF avec compress: true. Les familles CJK intégrées de Spire ne nécessitent aucun fichier de police ; SinoTypeSongLight couvrait tout notre échantillon chinois, tandis que les deux familles Monotype ont supprimé quelques caractères.
Et si je dois traiter des fichiers Word ou Excel ? Les six bibliothèques open source partent du PDF. Spire.Office for JavaScript gère Word, Excel et PowerPoint dans la même famille de packages.
La taille du bundle sera-t-elle un problème ? Les bibliothèques open source se sont initialisées en 13 à 211 ms. Spire a pris 1,9 seconde et totalise environ 19,6 Mo de fichiers, ce qui n'est pas la même chose que la taille de téléchargement. Chargez-la à la demande si le premier rendu compte.
Ai-je besoin d'une licence en production ? L'édition gratuite couvre la génération et la conversion de fichiers PDF sans filigrane. La version d'évaluation protège sa sortie par un filigrane et un plafond de pages, qu'une licence temporaire gratuite supprime pendant que vous évaluez le produit. Une licence commerciale est requise pour la production.
Notre recommandation selon le scénario
Le choix dépend du nombre de tâches que comporte votre projet.
Une seule tâche : prenez le spécialiste.
- Factures et reçus, la vitesse d'abord : jsPDF ou PDFKit, avec une vérification de police pour le chinois.
- Tableaux et longs rapports : pdfmake.
- Applications React : @react-pdf/renderer.
- Modifier un PDF existant : pdf-lib, en gardant à l'esprit sa date de publication de 2021.
- Lire et afficher : PDF.js.
- Sortie d'archivage devant passer un validateur : Spire.PDF for JavaScript. Ses fichiers PDF/A-1b et PDF/A-2b ont réussi veraPDF, tandis que l'option
subsetdocumentée de PDFKit a échoué à cinq règles. - Sortie en chinois sans livrer de fichier de police : les familles CJK intégrées de Spire. SinoTypeSongLight couvrait tout notre échantillon, et les six bibliothèques open source nécessitent chacune un fichier de police que vous distribuez vous-même, 9,7 Mo dans notre test.
Deux tâches ou plus, ou n'importe quelle conversion entre formats : le calcul change. Un projet qui lit un modèle DOCX, écrit un PDF et convertit ensuite le résultat a besoin de deux ou trois des bibliothèques ci-dessus, plus un quatrième package pour Word, et chaque transfert entre elles est un ArrayBuffer à valider et un pipeline de polices distinct à configurer. C'est le cas pour lequel Spire.PDF for JavaScript est conçu : une API couvrant les quatre tâches ci-dessus et douze cibles de conversion, exécutée dans le navigateur sans serveur.
Le coût est mesurable et nous l'avons rapporté : 1,9 seconde au premier chargement, car l'environnement d'exécution décompresse environ 19 Mo de WebAssembly avant l'ouverture du premier document. Chargez-la avant le premier clic et l'utilisateur ne le verra jamais. L'édition gratuite couvre la génération et la conversion sans filigrane, et une licence temporaire supprime les limites d'évaluation pendant que vous comparez avec vos propres documents.
Voir aussi
- Convertir PDF en Word avec JavaScript dans React
- Convertir PDF en Excel avec JavaScript dans React
- Comment diviser des documents PDF avec JavaScript dans React
- Convertir PDF en PDF/A et inversement avec JavaScript dans React
- Ajouter, remplir et supprimer des champs de formulaire PDF avec JavaScript dans React