Puedes generar un documento PDF en C# a partir de datos de la aplicación, desde una página HTML o rellenando un PDF que ya existe. Cada punto de partida conduce a un flujo de trabajo diferente, y la elección depende del control del diseño, la paginación cuando el contenido crece, las dependencias de renderizado que debe tener la máquina de destino y cómo se verifica el resultado.
Las secciones siguientes clasifican los flujos de trabajo de Spire.PDF for .NET según el material con el que empiezas e informan de lo que hizo cada uno en las pruebas, incluidas las partes que fallaron. Probado con Spire.PDF for .NET 12.11.0 (noviembre de 2026, Windows 11 Pro, aplicación de consola .NET 10).
Navegación rápida
- Empieza con lo que ya tienes
- Genera PDF a partir de datos de la aplicación
- Convierte HTML y CSS a PDF
- Trabaja con formularios y plantillas PDF existentes
- Implementación y validación de la salida
- Preguntas frecuentes
- Conclusión
1. Empieza con lo que ya tienes
Parte del material que tu programa tiene en tiempo de ejecución: registros de una consulta, una página HTML o un PDF que diseñó otra persona. La tabla relaciona cada entrada con un flujo de trabajo.
| Clase | Entrada en tiempo de ejecución | Flujo de trabajo |
|---|---|---|
| Crear un PDF nuevo | Datos de la aplicación / datos estructurados | Diseño basado en coordenadas o flujo nativo |
| Crear un PDF nuevo | Página o plantilla HTML/CSS | Renderizado de HTML a PDF |
| PDF existente | Formulario rellenable (AcroForm) | Relleno de campos del formulario |
| PDF existente | Formulario rellenable (XFA) | Procesamiento de campos XFA |
| PDF existente | Diseño fijo con texto de marcador de posición | Reemplazo de texto |
Las dos primeras filas crean un PDF nuevo, así que tú controlas el diseño y debes decidir cómo se dividen las páginas. Las tres últimas parten de un PDF existente, donde el archivo fija el diseño y la tarea consiste en introducir valores en los lugares que proporciona. Una tarea para generar un informe PDF en C# a partir de los resultados de una consulta, como el informe mensual de QA que se usa en esta guía, empieza en la primera fila. Una plantilla de factura HTML mantenida por un equipo de front-end empieza en la segunda, y un formulario recibido de un proveedor empieza en una de las tres últimas.
Esta guía cubre los flujos de trabajo que admite Spire.PDF, no una taxonomía exhaustiva de todas las técnicas de PDF en C#.
2. Genera PDF a partir de datos de la aplicación
El dibujo basado en coordenadas coloca cada bloque de texto, línea e imagen en las posiciones que especifiques. Ofrece un control exacto sobre un diseño fijo y no necesita ningún motor de renderizado más allá de la biblioteca. El coste aparece cuando la longitud del contenido varía, porque la paginación pasa a ser responsabilidad de tu código: haces un seguimiento de dónde terminó el último elemento, añades páginas tú mismo y recalculas las posiciones cuando cambia el contenido. Un breve extracto muestra el patrón.
var font = new PdfTrueTypeFont("Segoe UI", 11f, PdfFontStyle.Regular, true);
var layout = new PdfTextLayout { Layout = PdfLayoutType.Paginate };
PdfPageBase page = doc.Pages.Add();
float y = 40;

foreach (string text in summaryParagraphs)
{
    var r = new PdfTextWidget(text, font, PdfBrushes.Black)
        .Draw(page, new RectangleF(40, y, 500, 0), layout);
    page = r.Page;                  // the text may have flowed onto a new page
    y = r.Bounds.Bottom + 10;
    if (y > 760) { page = doc.Pages.Add(); y = 40; }   // you own the page breaks
}
El paso que importa es seguir la página que devuelve el resultado del diseño: sigue dibujando en la página que informa el widget y añade una página nueva cuando el marco llegue al final. Los informes creados a partir de un DataTable tienen su propio tutorial de DataTable a PDF.
El diseño de flujo nativo saca la paginación de tu código. PdfContentBuilder, disponible desde Spire.PDF for .NET 12.9.18, transmite contenido en secciones y pagina a medida que crece. Ofrece encabezados, párrafos, tablas creadas a partir de un string[][], imágenes, listas, bloques de código, seis tipos de gráficos, saltos de página y una tabla de contenidos. Solo crea documentos nuevos, sin punto de entrada para cargar un archivo existente.
El informe mensual de QA que aparece a continuación usa dos secciones y una tabla. summaryParagraphs, results (un string[][] con el encabezado en la primera fila) y closing provienen de tu propio código.
using Spire.Pdf;
using Spire.Pdf.Layout;

PdfDocument doc = new PdfDocument();
PdfContentBuilder builder = new PdfContentBuilder(doc);

var s1 = builder.AddSection();
s1.AddHeading1("Monthly QA Report - October");
foreach (var p in summaryParagraphs) s1.AddParagraph(p);
s1.AddTable(results);            // string[][] rows; header row repeats on page breaks

var s2 = builder.AddSection();
s2.AddHeading1("Next Month Outlook");
s2.AddParagraph(closing);

builder.Build();
doc.SaveToFile("QA-Report.pdf");
doc.Dispose();
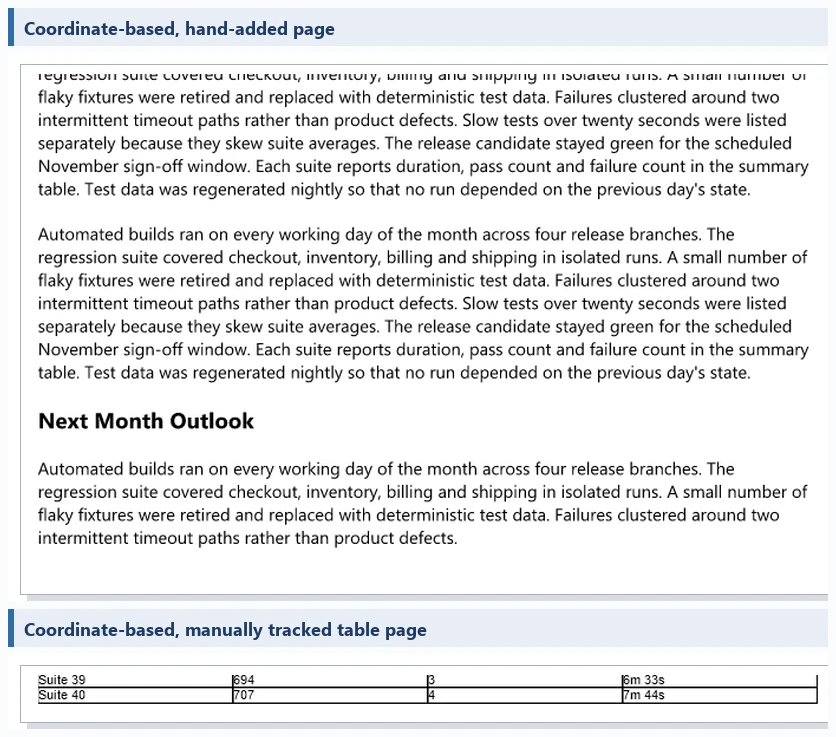
El volumen del contenido separa ambos enfoques. Un informe pequeño (dos secciones, una tabla de cinco filas) se generó en dos páginas en 676 ms. Uno más grande, con ocho párrafos largos y una tabla de 40 filas, se paginó en cinco páginas en 1.369 ms (10,8 KB). El mismo contenido dibujado con coordenadas dio tres páginas en 510 ms (28,7 KB). Estos tiempos provienen de una sola máquina Windows y sirven como comprobación rápida de esta configuración. Compara cómo se ve cada archivo antes de comparar la rapidez con la que se ejecutó.
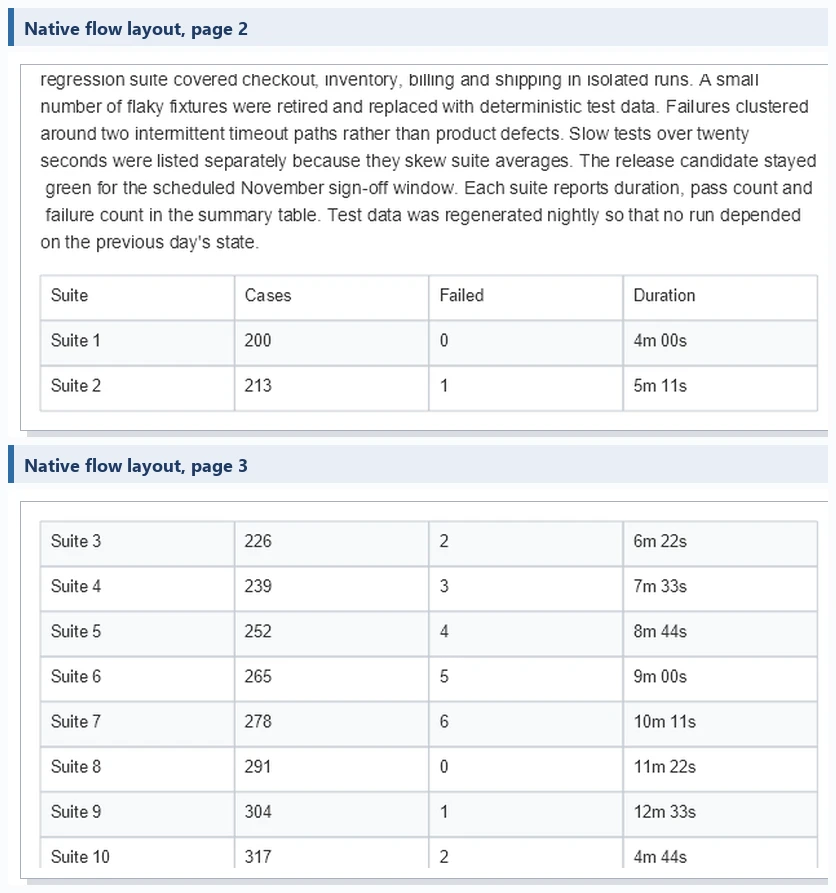
El dibujo basado en coordenadas encaja en páginas cuya estructura no depende del volumen de datos. El diseño de flujo encaja en documentos cuya longitud sigue a los datos, como informes y listados. Los desarrolladores que quieran la ruta de composición manual con más detalle pueden empezar por el tutorial de creación de documentos PDF en C#.
El diseño de flujo nativo y el renderizado HTML son mecanismos distintos. El generador organiza el contenido mediante su propia API y no lee CSS, mientras que un renderizador HTML analiza el marcado y las hojas de estilo, por lo que las opciones de estilo y los requisitos de tiempo de ejecución difieren. La tabla compara todos los flujos de trabajo de esta guía.
| Flujo de trabajo | Control del diseño | Contenido dinámico | Requisitos externos de tiempo de ejecución | Limitación principal |
|---|---|---|---|---|
| Basado en coordenadas | Coordenadas explícitas, elemento por elemento | Tú gestionas el diseño y la paginación (PdfTextLayout.Paginate) |
Sin motor de renderizado adicional | Los cambios de tamaño del contenido obligan a rehacer las coordenadas |
Diseño de flujo nativo (PdfContentBuilder, 12.9.18+) |
Transmisión por secciones, encabezados y párrafos | Contenido en streaming; paginación automática verificada en las pruebas | Sin motor de renderizado adicional | Solo creación; la cobertura de elementos es la que ofrece la API (tablas, imágenes, listas, bloques de código, gráficos, índice) |
| HTML a PDF | CSS más un motor de renderizado | Adecuado para contenido basado en HTML | Chromium (ruta de Chrome o Edge) o el plugin de renderizado Qt | Depende del entorno de renderizado; los fondos CSS difieren según el motor |
| Relleno de AcroForm | Diseño de campos del formulario original | Relleno por nombre de campo | Sin motor de renderizado adicional | Limitado por las definiciones de campo del archivo |
| Reemplazo de texto estático | Diseño de página original | Reemplazo de texto fijo | Sin motor de renderizado adicional | Sin rediseño dinámico general |
3. Convierte HTML y CSS a PDF
Para generar un PDF a partir de HTML en C#, Spire.PDF pasa la página a un motor de renderizado y guarda el resultado impreso. Hay dos motores disponibles. ChromeHtmlConverter controla Chromium y toma la ruta a un ejecutable de Chrome o Edge. La opción Qt, Spire.Additions.Qt.HtmlConverter, depende del paquete oficial de plugins, que contiene HTMLConverter.dll, el entorno de ejecución Qt5 y Html2Pdf.exe. La carpeta de plugins va junto al ejecutable de la aplicación. Cuando falta, la llamada falla con Fail to load ...\plugins\HTMLConverter.dll : error 126.
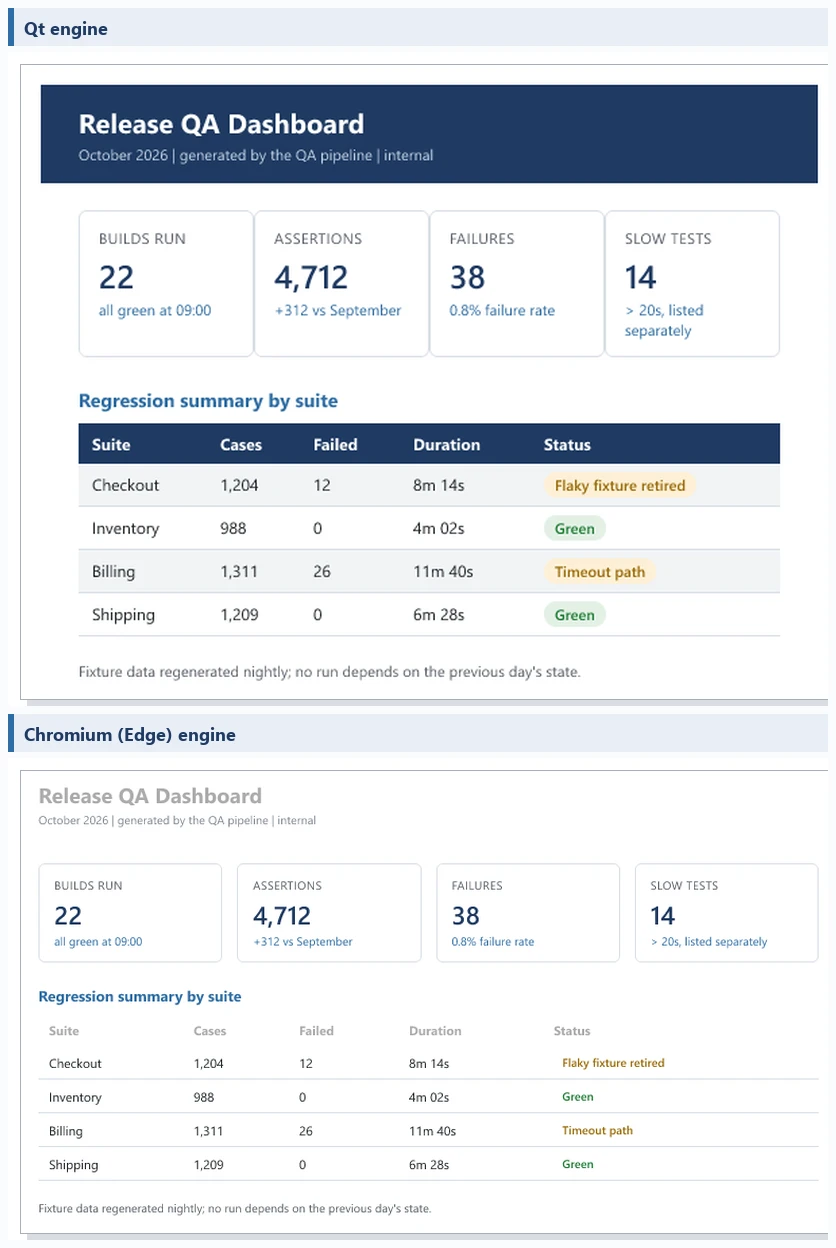
Las pruebas enviaron el mismo HTML a través de ambos motores. Ambos produjeron dos páginas y respetaron page-break-before de CSS. La ejecución con Qt tardó 4.398 ms y escribió un archivo de 60,6 KB con el fondo azul oscuro del encabezado de la tabla intacto. La ejecución con Chromium usó Edge 157.0.4341.42, papel A4 y márgenes de 0,4 pulgadas, reutilizando el navegador que ya estaba en la máquina.
Las dos rutas tienen compensaciones diferentes. Qt requiere una instalación de plugin aparte, mientras que Chromium reutiliza una instalación de Chrome o Edge. Cada motor tiene sus propias reglas para imprimir fondos CSS, y la hoja de estilo decide qué solicitar, por ejemplo con print-color-adjust: exact. En una aplicación web, ejecuta la conversión como un trabajo en segundo plano en lugar de dentro de la solicitud.
Varios aspectos no se cubrieron: páginas que dependen de JavaScript para renderizarse, recursos externos, fuentes personalizadas, carga concurrente en un servidor y Linux o Docker. Un convertidor que funciona en una máquina de desarrollo no ha demostrado que funcione en un contenedor de producción, y esta guía no ha verificado Linux. Para páginas basadas en plantillas con un recorrido completo, consulta generar un PDF a partir de una plantilla HTML en C#.
4. Trabaja con formularios y plantillas PDF existentes
Crear un PDF a partir de una plantilla en C# significa dos cosas distintas cuando la plantilla ya es un PDF. Un formulario rellenable contiene objetos de campo AcroForm con nombre. Una página diseñada puede contener solo texto de marcador de posición que parece un espacio en blanco. Se ven igual en pantalla y se comportan de forma diferente en el código.
| Propiedad | Campo AcroForm | Texto de marcador de posición estático |
|---|---|---|
| Existe en el archivo como | Un objeto de campo con su propio nombre | Texto normal de la página |
| Se localiza por | Nombre del campo | El propio texto |
| Interactividad | Se mantiene hasta que lo aplanas | Nunca es interactivo |
| Después de aplanar | El valor pasa a ser texto de la página | No aplica |
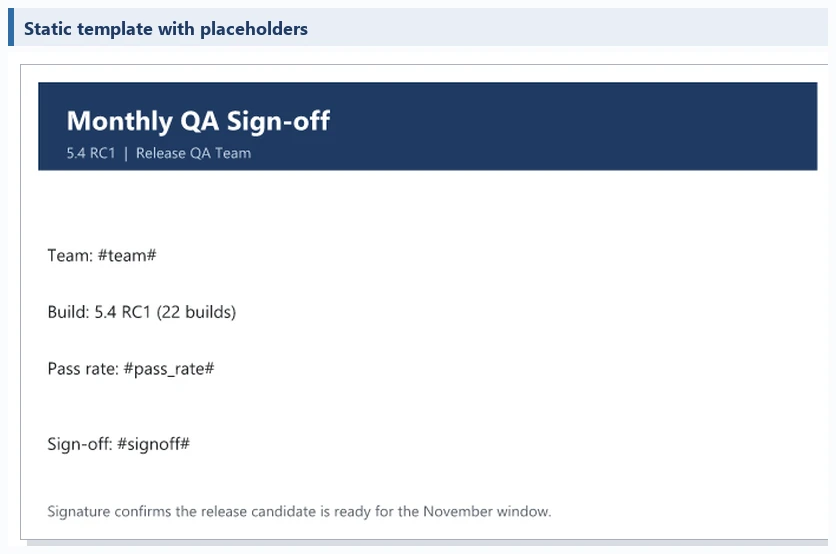
Un campo real se localiza por nombre, se rellena y, opcionalmente, se aplana. La API de AcroForm del espacio de nombres Spire.Pdf.Interactive.Forms llegó en la versión 12.10.7 y se probó en la 12.11.0.
using Spire.Pdf.Interactive.Forms;

PdfDocument doc = new PdfDocument();
doc.LoadFromFile("existing-form.pdf");
PdfForm form = PdfForm.Create(doc);
var field = form.GetField("team") as PdfTextField;
field.Text = "Release QA";
field.RefreshAppearances();     // without this the value is stored but renders invisible
form.Flatten();                 // after this the value sits in the page text layer
doc.SaveToFile("final.pdf");
Surgieron tres comportamientos en las pruebas:
- Llama a
RefreshAppearances()después de establecerText, para que el valor se dibuje en la apariencia del campo y se muestre de inmediato. - Los valores de los campos que siguen siendo interactivos viven en la capa del formulario; después de aplanar, el recuento de campos pasó de 4 a 0 y los valores se unieron al texto de la página, donde
PdfTextExtractorlos lee. -
AddWidgetusa coordenadas a nivel de página mientras que las posiciones depage.Canvasson relativas a los márgenes; mantén ambos sistemas separados al colocar widgets.
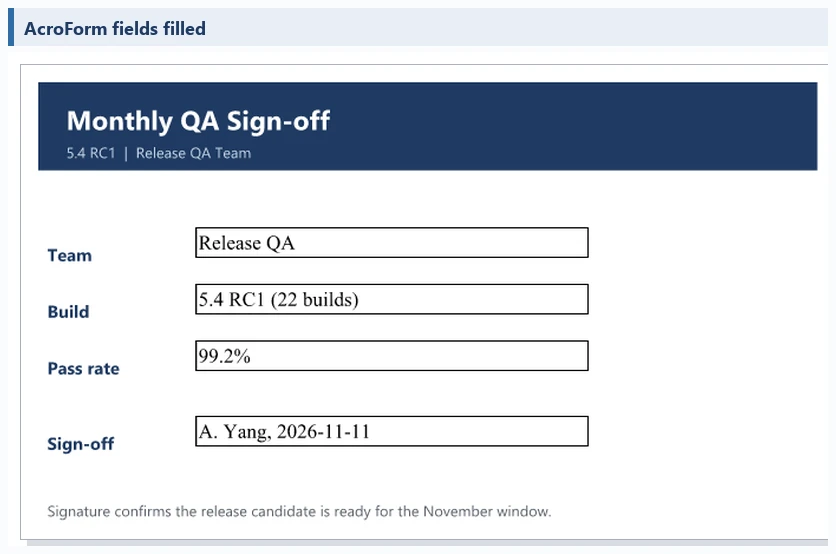
Los datos del formulario también pueden salir del archivo como XFDF mediante form.ExportData(path, DataFormat.XFDF, ...), que produjo XFDF estándar en las pruebas. El tutorial de importación y exportación de datos de formularios PDF profundiza más.
El texto de marcador de posición fijo funciona en una página terminada cuando los valores que insertas son de tamaño similar a los marcadores que reemplazan. El reemplazo conserva el diseño original, así que verifica que cada valor nuevo encaje en el espacio que dejó el original.
Los formularios XFA son un tipo de formulario aparte. La capacidad documentada es leer y modificar los campos admitidos mediante el objeto de formulario XFA; valida el flujo de trabajo con tus propias muestras como parte de la evaluación.
5. Implementación y validación de la salida
Todo lo de esta guía se ejecutó en una máquina de desarrollo Windows. Linux, Docker y el alojamiento en servidor no se verificaron en esta guía. Los motores HTML son los que más atención requieren en otros entornos: la ruta de Chromium necesita un ejecutable de navegador en la máquina de destino, y la ruta de Qt necesita su carpeta de plugins junto a la aplicación. Spire.PDF publica paquetes oficiales de plugins para Linux y macOS. Pruébalos en tu propia imagen de implementación antes de confiar en ellos, y mide el tiempo de conversión en el host de destino, ya que los tiempos anteriores provienen de una máquina de desarrollo.
Los problemas de generación rara vez lanzan excepciones: el archivo se produce, y cualquier fallo solo se muestra en la propia salida. Por eso las comprobaciones siguientes inspeccionan el archivo en lugar de confiar en que el código se ejecutó sin errores.
| Comprobación | Qué detecta | Cómo |
|---|---|---|
| Recuento de páginas | Paginación que se alargó, se detuvo antes o nunca avanzó | check.Pages.Count |
| Extracción de texto | Títulos o datos faltantes, marcadores de posición sobrantes |
PdfTextExtractor en cada página |
| Validación de formularios | Valores que nunca llegaron a un campo | Lee los valores de los campos mediante la API antes de aplanar; después de aplanar, vuelve a abrir el archivo y comprueba el contenido visible |
| Inspección visual | Desbordamiento de texto, saltos de página incorrectos, fuentes sustituidas, imágenes faltantes | Abre el PDF y revisa cada página |
PdfDocument check = new PdfDocument();
check.LoadFromFile("QA-Report.pdf");
Console.WriteLine(check.Pages.Count);                        // expected page count

string text = new PdfTextExtractor(check.Pages[0])
    .ExtractText(new PdfTextExtractOptions());               // titles, data, leftovers
Console.WriteLine(text.Contains("#"));                       // a stray placeholder marker
La extracción de texto no sustituye a mirar las páginas. Confirma que existen caracteres en el archivo y no dice nada sobre desbordamientos, recortes o un fondo de encabezado que no se imprimió. Adapta las comprobaciones al flujo de trabajo: recuento de páginas y una revisión visual para la salida por coordenadas y por flujo, una revisión visual de los fondos en la salida HTML, y una lectura mediante la API antes de aplanar en el caso de los formularios. Para los trabajos de informes, ejecuta las tres primeras comprobaciones en tu canalización de pruebas y repite la revisión visual siempre que cambie la plantilla o el diseño. Conserva una salida de referencia válida por flujo de trabajo y compárala después de actualizar la biblioteca, porque todos los resultados aquí están vinculados a la 12.11.0.
6. Preguntas frecuentes
¿Cuál es la diferencia entre crear y generar un PDF en C#?
A nivel de API no hay ninguna. Ambas expresiones describen la producción de un archivo PDF desde el código. Lo que importa es la entrada: datos de la aplicación, una página HTML o un PDF existente con campos o texto de marcador de posición. Elige el flujo de trabajo a partir de esa entrada, como muestra la tabla de decisión de esta guía.
¿Puedo generar un PDF en C# sin una biblioteca?
Técnicamente sí, porque PDF es un formato de archivo documentado que el código puede escribir directamente. En la práctica, el coste recae en la incrustación de fuentes, la compresión de flujos, la compatibilidad con la extracción de texto y la coherencia del renderizado entre visores. Cada uno de esos aspectos necesita su propio código y pruebas, y una biblioteca absorbe ese trabajo.
¿Cómo elijo entre la creación basada en código y el renderizado HTML?
Decídelo según quién controla el diseño. Si los desarrolladores lo controlan y los datos determinan la estructura, crea el PDF en código. Si los diseñadores ya mantienen el HTML y el CSS, renderiza esa página y acepta la dependencia del motor de renderizado. Elige código cuando los datos definen la página y HTML cuando una página define la salida.
7. Conclusión
Los datos de la aplicación apuntan al dibujo basado en coordenadas o al diseño de flujo nativo, y el diseño de flujo se paginó por sí solo en las pruebas. Una página HTML apunta a un motor de renderizado, que en las pruebas cambió el tiempo de conversión, la impresión de fondos y lo que necesitaba la máquina de destino. Un PDF existente apunta a los campos de formulario cuando existen y al reemplazo de texto cuando el diseño es fijo. Comprueba el recuento de páginas, el texto extraído y las páginas renderizadas antes de entregar cualquiera de estos archivos.
Si necesitas probar Spire.PDF for .NET en un entorno empresarial real, puedes solicitar una licencia temporal.