Leer un PDF con pypdf es un trabajo de diez minutos. El problema empieza cuando al mismo script se le pide extraer una tabla resumen de la primera página, eliminar el apéndice, devolver una copia editable de Word y bloquear el archivo con una contraseña. Cada solicitud tiene una buena respuesta en Python, pero rara vez provienen del mismo paquete.
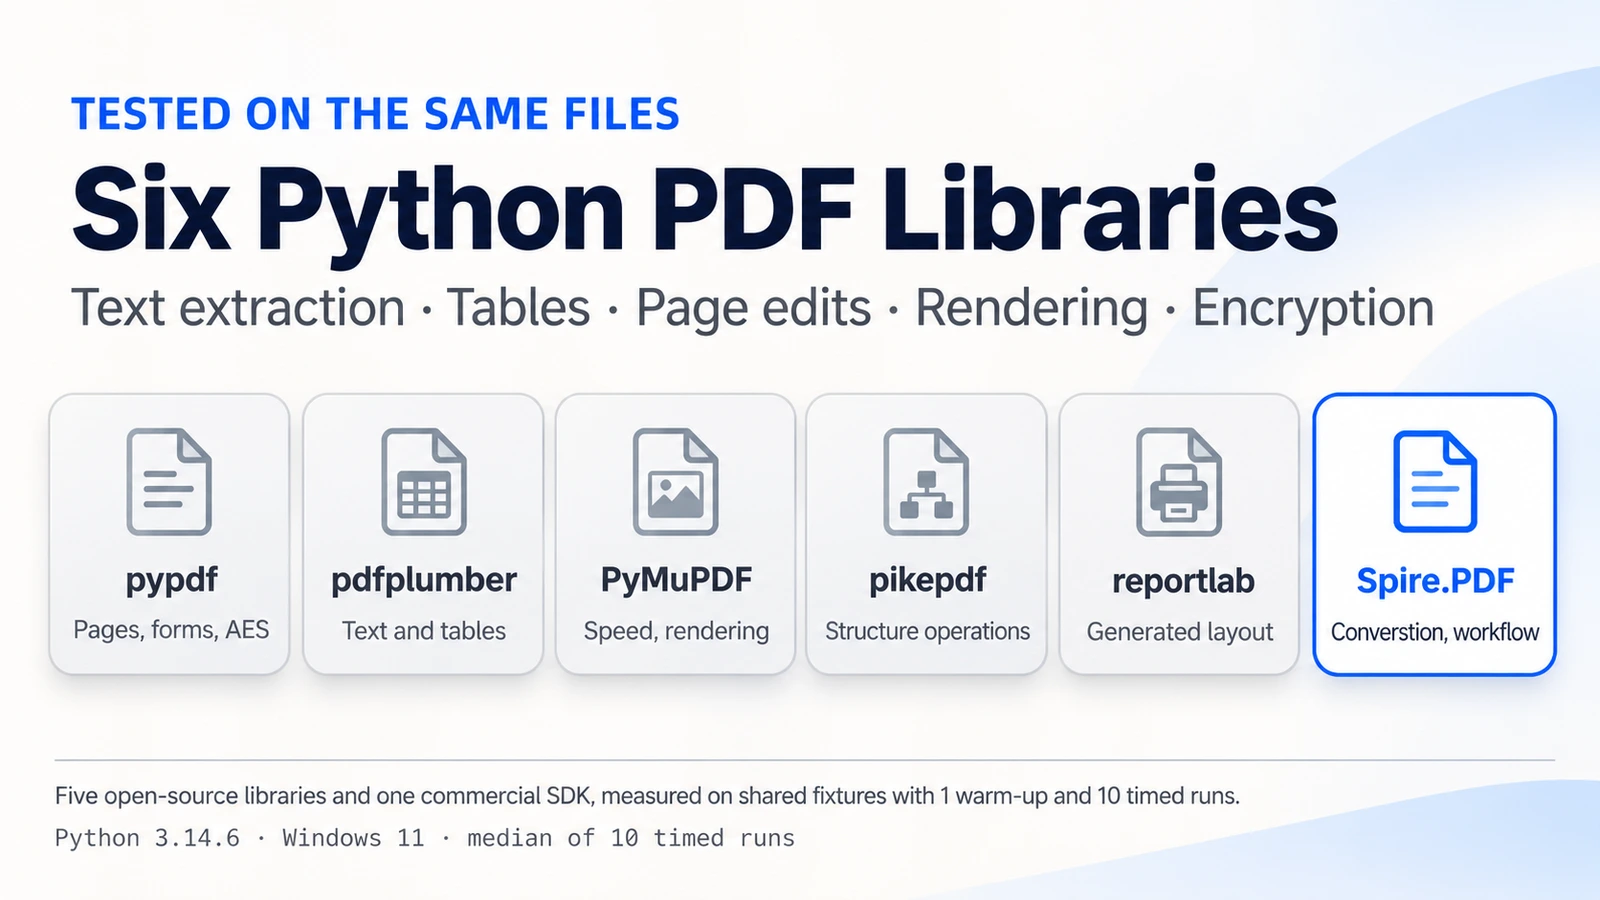
Esta guía compara seis opciones en un mismo conjunto de archivos de prueba: pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab y Spire.PDF para Python. Divulgación: Spire.PDF es un producto comercial de E-iceblue, el editor de este artículo, y E-iceblue realizó las pruebas. Los archivos de prueba, las versiones y el método de medición se detallan en la sección "Cómo lo probamos" para que puedas repetir cualquier resultado. Cada biblioteca a continuación es una elección razonable para el trabajo para el que fue creada.
¿Qué biblioteca PDF de Python deberías elegir?
Si tu trabajo es una sola operación, elige el especialista para ello. Las bibliotecas de código abierto en esta comparación son fuertes en sus propias tareas. Spire.PDF está orientado al otro caso: un flujo de trabajo en el que un documento pasa por extracción, edición, conversión y cifrado, y prefieres mantener un solo SDK en lugar de tres bibliotecas.
| Biblioteca | Mejor para | Consideración clave | Licencia |
|---|---|---|---|
| pypdf | Fusionar, dividir, rotar y cifrar páginas en Python puro | El cifrado AES necesita el extra pypdf[crypto]
|
BSD-3 |
| pdfplumber | Análisis de diseño, extracción de tablas, depuración visual | Creado para leer, no para modificar páginas | MIT |
| PyMuPDF | Extracción rápida de texto y renderizado de páginas | AGPL-3.0 o comercial; evalúa según cómo distribuyas | AGPL-3.0 o comercial |
| pikepdf | Trabajo de estructura de bajo nivel, linealización, cifrado | Sin API de extracción de texto | MPL-2.0 |
| reportlab | Generar PDFs desde código | Solo generación | BSD |
| Spire.PDF | Trabajos mixtos (extraer, editar, convertir, cifrar) en un solo SDK | Licencia comercial; opciones de licencia gratuita, de evaluación y temporal | Comercial |
Lee la tabla por trabajo en lugar de por nombre. Si tu flujo de trabajo solo necesita la operación en la primera columna de una biblioteca, la tercera columna es lo único que queda por sopesar. Los términos de licencia y el peso de la instalación tienden a decidir entre candidatos cercanos, y las secciones siguientes ponen números a ambos.
Nota de alcance: esto es cinco bibliotecas de código abierto seleccionadas y un SDK comercial. No cubre todas las herramientas PDF especializadas del ecosistema Python.
Qué hacen mejor las bibliotecas PDF de Python de código abierto seleccionadas
Las personas que buscan una biblioteca analizadora de PDF de Python o una biblioteca lectora de PDF de Python normalmente se refieren a una de dos cosas: extraer texto y tablas de archivos existentes, o reestructurar los archivos mismos. Las cinco bibliotecas a continuación se dividen en esa línea. pdfplumber y PyMuPDF son las más fuertes en el lado de la lectura, pypdf y pikepdf en el lado de la estructura de páginas, y reportlab en la creación de documentos desde cero. Cada entrada brinda el enfoque de la biblioteca, lo que medimos y dónde termina su alcance.
pypdf
pypdf es una biblioteca de Python puro para trabajo a nivel de página, con una huella instalada de 1.8 MB en nuestro entorno limpio. En nuestras ejecuciones extrajo un documento de texto de 10 páginas en 43.1 ms, rotó una página en 9.2 ms, eliminó una en 8.6 ms, fusionó dos archivos en 14.7 ms, dividió tres páginas en 10.2 ms y aplicó cifrado AES-256 en 19.6 ms. AES necesita el extra pypdf[crypto], que eleva la instalación a 13.2 MB. Es una primera elección natural cuando reorganizas páginas y no quieres dependencias compiladas; la protección AES incorpora el extra crypto mencionado anteriormente.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
El script fusiona dos archivos, rota la primera página y escribe una copia protegida con AES-256.
pdfplumber
pdfplumber es la herramienta a la que recurrir cuando necesitas ver cómo está diseñada una página. Expone posiciones de caracteres, líneas y rectángulos, lo que hace práctica la extracción de tablas y la depuración visual. La tabla con bordes de 21 × 4 en nuestro archivo de prueba se obtuvo en 44.6 ms, y la extracción de texto plano en diez páginas tomó 320.4 ms, más tiempo que los lectores enfocados en texto, mientras que la biblioteca también expone el detalle posicional del que dependen el análisis de diseño y el trabajo con tablas. Una factura china de una sola página se leyó en 7.7 ms y devolvió la frase esperada "发票编号". Lee PDFs y no los modifica, por lo que normalmente se usa junto a una segunda biblioteca.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
La llamada devuelve la primera tabla de la página uno como una lista de filas.
PyMuPDF
PyMuPDF combina procesamiento de texto y renderizado sobre un motor compilado. Tuvo el menor tiempo de extracción de texto en la prueba, 7.2 ms para diez páginas, eliminó una página en 3.0 ms y renderizó una página a 150 DPI en 48.8 ms. La instalación predeterminada es de 201.3 MB con sus dependencias (104.5 MB con --no-deps), por lo que es la opción más pesada aquí, y la licencia es AGPL-3.0 o comercial. Si tu servicio renderiza miniaturas o procesa muchas páginas mediante extracción de texto, los números explican su popularidad.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
El fragmento lee el texto de la primera página y guarda un PNG de 150 DPI de ella.
pikepdf
pikepdf envuelve la biblioteca QPDF y trabaja sobre la estructura de objetos PDF en sí. Eso sirve para tareas como rotar o eliminar páginas (6.4 ms y 5.8 ms), reordenarlas (6.5 ms), aplicar cifrado AES-256 con un manejador de revisión 6 (32.0 ms) y guardar un archivo linealizado para entrega web (7.8 ms). No ofrece una API de extracción de texto, por lo que los equipos normalmente lo combinan con un lector. Elígelo cuando necesites manipulación de objetos PDF de bajo nivel, reestructuración de páginas, cifrado o linealización.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
El código establece la primera página en una rotación de 90 grados y guarda el resultado.
reportlab
reportlab existe para crear PDFs, y lo hace con control total sobre fuentes, coordenadas y diseños fluidos. En la prueba generó un documento de 10 páginas, 40 líneas por página en Arial 10 pt, en 14.1 ms. No tiene la tarea de leer o editar archivos existentes, lo cual es un límite claro en lugar de una carencia: facturas, etiquetas e informes generados son donde se gana su lugar.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
El bucle produce un archivo A4 de 10 páginas con 40 líneas por página.
Cuándo un flujo de trabajo PDF con múltiples bibliotecas se vuelve difícil de mantener
Nada de lo anterior es un defecto. La fricción aparece cuando un requisito necesita varias de estas bibliotecas en secuencia, y cada herramienta añadida conlleva costos que no aparecen en una sola fila de referencia:
- La conversión necesita un convertidor separado. PDF a Word no forma parte de los lectores y editores de páginas anteriores, así que añades uno, y la fidelidad del diseño debe verificarse archivo por archivo.
- Editar texto en su lugar es una tarea propia. Las operaciones de página mueven o eliminan páginas completas; cambiar palabras dentro de una página requiere otra cosa.
- Los formularios complejos son un tema aparte. Leer campos simples es una cosa, construir y aplanar formularios es otra, y las bibliotecas difieren en hasta dónde llegan.
- Las firmas y PDF/A necesitan herramientas adicionales. Los flujos de trabajo de archivo y firma normalmente incorporan paquetes adicionales.
- El OCR es externo por diseño. Las páginas escaneadas requieren un motor fuera de cualquiera de estas bibliotecas.
Una imagen concreta ayuda. Un script de pegamento típico abre el archivo en una biblioteca, escribe un archivo intermedio, reabre ese archivo en una segunda biblioteca, guarda de nuevo y luego pasa el resultado a un convertidor que lo analiza por tercera vez. Cada traspaso es un lugar donde las fuentes, las cajas de página o los indicadores de cifrado pueden cambiar, y cada uno necesita su propia prueba. Nada de esto es difícil de escribir; es la parte que sigue creciendo a medida que cambian los requisitos.
Debajo de las cinco se encuentra la misma sobrecarga: otra API que aprender, otro árbol de dependencias, otra matriz de compatibilidad y otra ruta de manejo de errores, además de un traspaso de archivos entre herramientas.
Las licencias merecen su propia línea. El convertidor común pdf2docx tiene licencia MIT, y depende de PyMuPDF, que es AGPL-3.0 o comercial. Esos son dos hechos separados, y un producto distribuido debe evaluar ambos. Para una mirada más profunda al lado de la lectura del problema, consulta nuestra guía para analizar PDFs en Python.
Qué añade Spire.PDF para Python a los flujos de trabajo PDF
Spire.PDF para Python es un SDK comercial que maneja lectura, edición, conversión, seguridad y generación dentro de un solo paquete. Cuatro áreas importan para la comparación.
1. Un modelo de documento compartido y una API consistente
Un modelo de documento compartido y una API de Python consistente permiten a los desarrolladores realizar múltiples operaciones PDF dentro de un solo SDK. Clases auxiliares especializadas, como PdfTableExtractor, trabajan con el PdfDocument cargado. El mismo PdfDocument cargado se puede usar para múltiples operaciones, sin pasar archivos PDF intermedios entre bibliotecas separadas. También significa un patrón de manejo de errores y un conjunto de restricciones de versión que rastrear cuando actualizas.
2. Rendimiento de extracción de tablas en nuestra prueba comparativa
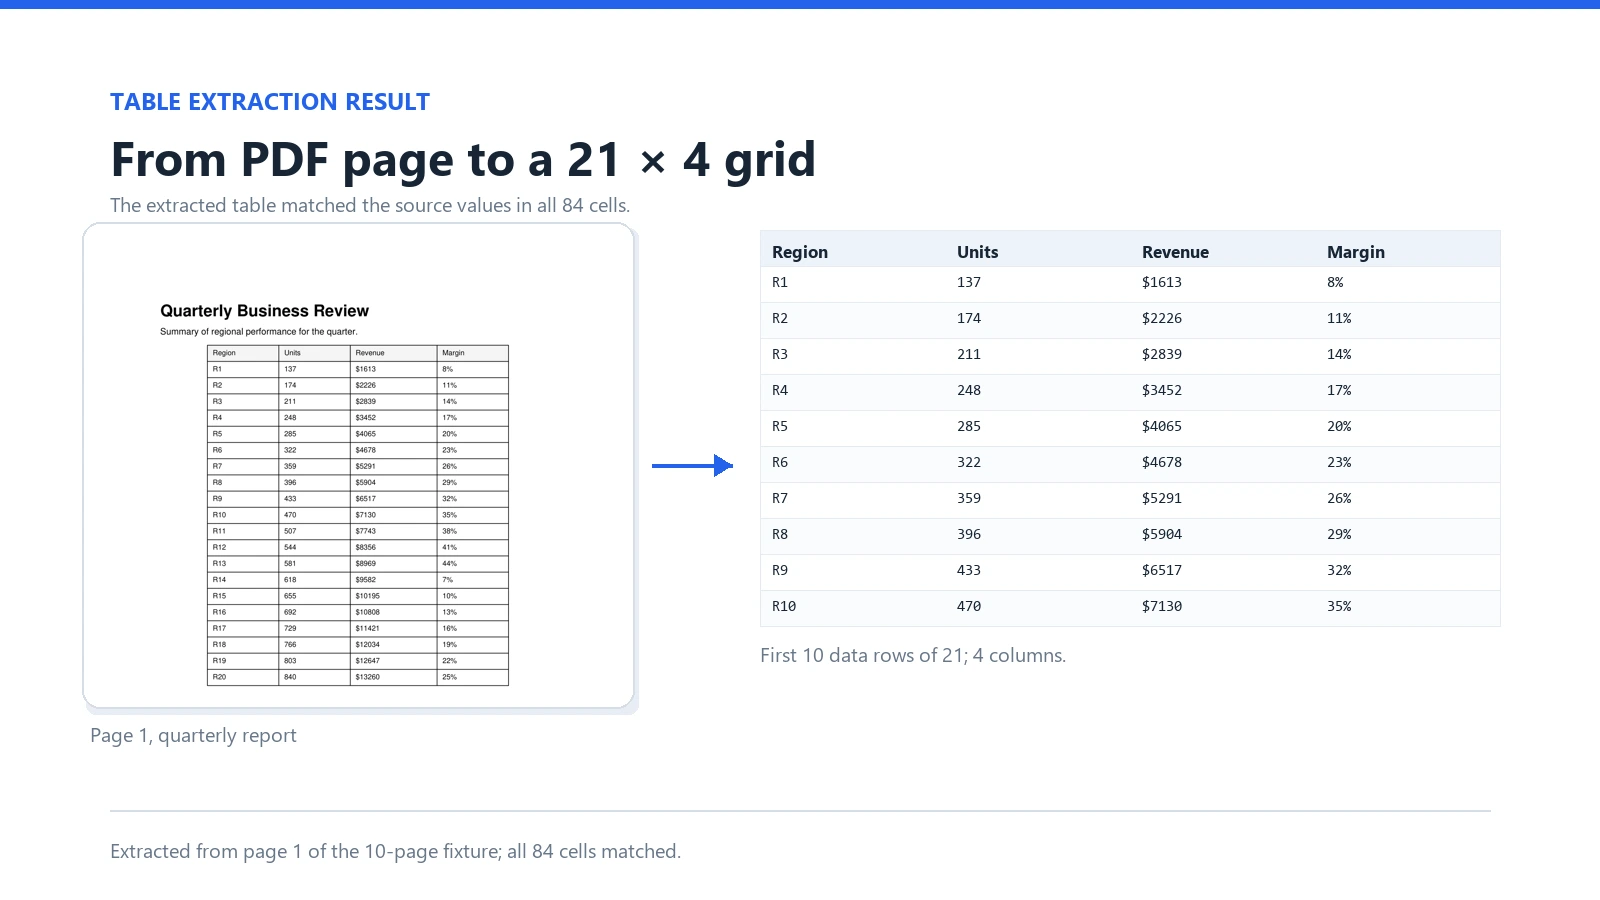
Ejecutamos la misma tabla con bordes en tres bibliotecas. El archivo de prueba es de 21 filas por 4 columnas, tiene bordes claramente dibujados y sin celdas combinadas. La documentación oficial dice que la extracción de tablas funciona mejor con tablas con formato claro, por lo que estos resultados describen solo ese tipo de tabla.
| Biblioteca | Mediana | Rango | Resultado |
|---|---|---|---|
| Spire.PDF | 18.9 ms | 16.2 a 26.4 ms | 21 × 4, las 84 celdas correctas |
| pdfplumber | 44.6 ms | 42.3 a 53.7 ms | 21 × 4, las 84 celdas correctas |
| PyMuPDF | 363.4 ms | 341.6 a 385.7 ms | 21 × 4, las 84 celdas correctas |
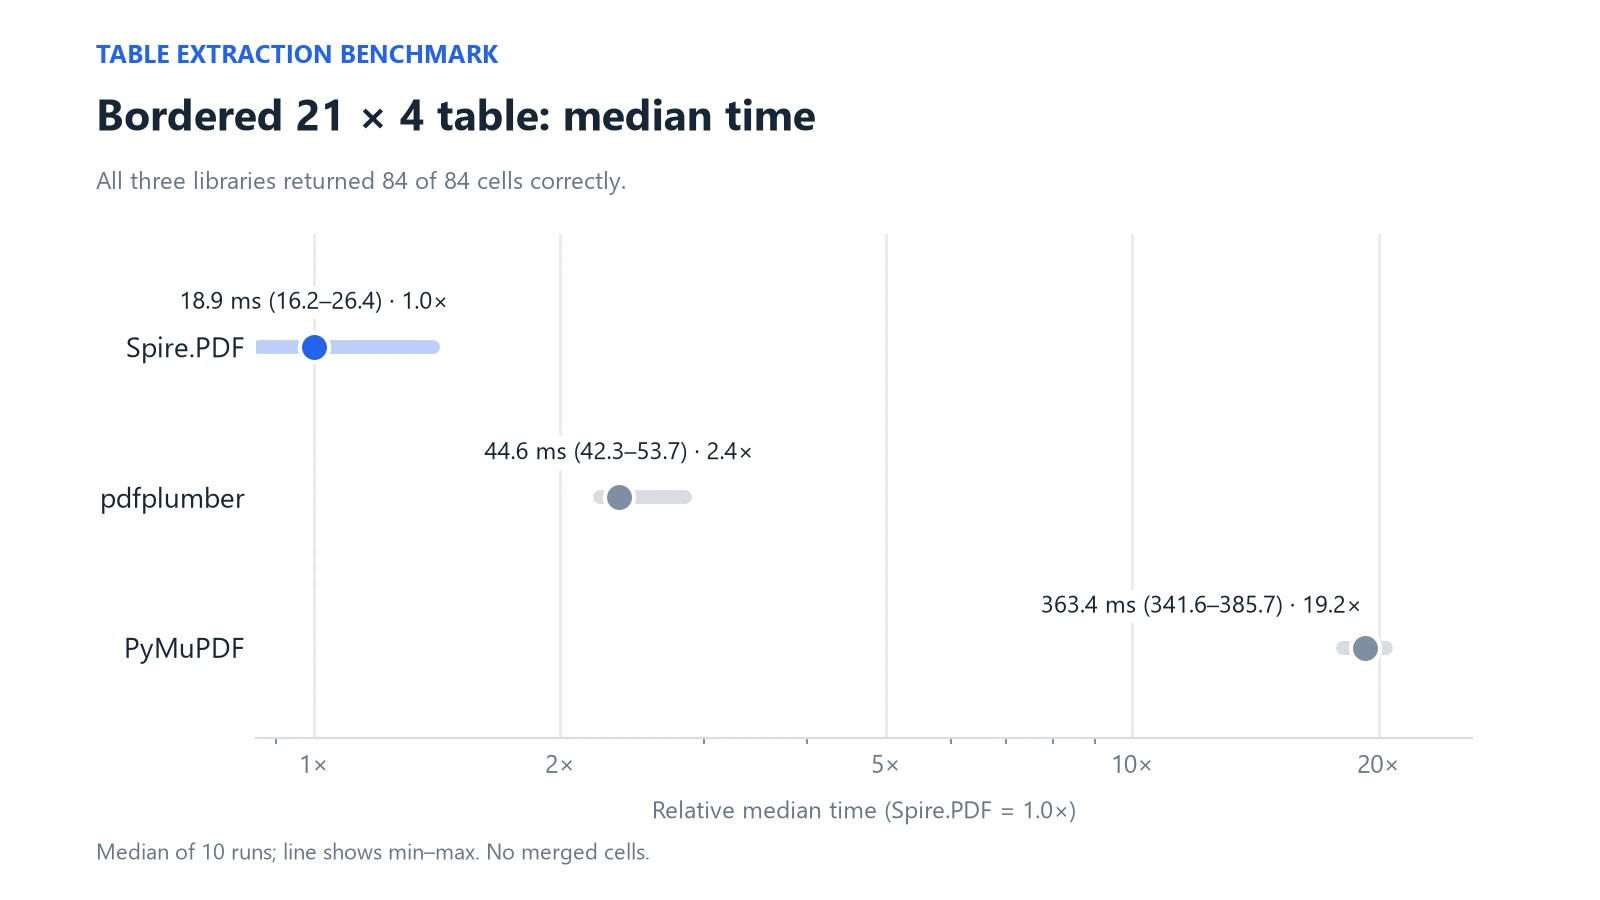
Las tres devolvieron contenidos de celdas idénticos, por lo que la comparación es sobre tiempo con igual corrección. Spire.PDF registró la mediana más baja en esta prueba. Las tablas con celdas combinadas, bordes faltantes o páginas escaneadas no se midieron y pueden clasificarse de manera diferente. Para un recorrido paso a paso de la misma API, consulta extraer tablas de PDF en Python.
3. Formularios
Spire.PDF para Python documenta API para crear y rellenar campos de formulario, y para aplanarlos en contenido estático. El manejo de formularios no se incluyó en nuestra prueba comparativa de rendimiento, por lo que esta sección describe solo la capacidad documentada.
4. Exportación a otros formatos
El mismo documento cargado se puede guardar en varios formatos. En nuestras ejecuciones, las salidas a continuación se produjeron a partir de un informe de 10 páginas.
| Dirección | Profundidad de verificación |
|---|---|
| PDF a DOCX, HTML, Markdown | Salida generada; contenido de texto verificado |
| PDF a XLSX | Salida generada; contenido de celdas presente; la estructura depende del diseño de origen |
| PDF a PNG, XPS, SVG, PPTX | Salida generada; la fidelidad visual depende del diseño de origen |
| PDF a PDF/A-1a y PDF/A-1b | Métodos de conversión disponibles; salida generada e identificadores XMP verificados; conformidad formal con PDF/A no validada de forma independiente |
La salida de conversión depende del diseño de origen; valida archivos representativos antes de su uso en producción. Para la ruta DOCX en detalle, consulta el tutorial sobre convertir PDF a Word en Python.
Un flujo de trabajo PDF de varios pasos en Python
Para ver el argumento de mantenimiento en código, tomamos un trabajo realista. Un informe trimestral de 40 páginas necesita que se extraiga su tabla resumen y se eliminen sus páginas de apéndice. Del archivo actualizado se requieren dos salidas: un DOCX editable y un archivo PDF cifrado con AES-256.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
La implementación de código abierto usa pdfplumber para la tabla, pypdf[crypto] para la eliminación de páginas y el cifrado, y pdf2docx para la copia de Word. Eso son tres paquetes que tocan PDFs directamente. Instalados juntos en un entorno limpio suman 29 distribuciones y 388.9 MB, frente a 70.5 MB de Spire.PDF medido de la misma manera.
Con Spire.PDF todo el flujo permanece dentro de un solo objeto de documento:
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
Para una comparación de tiempos equivalente, ambas implementaciones se ejecutaron en la versión de 10 páginas del informe. Los tres paquetes de código abierto tomaron una mediana de 1,346.2 ms en total y Spire.PDF tomó 267.3 ms. Ambos extrajeron las 84 celdas de la tabla correctamente, y ambos produjeron un PDF cifrado de 9 páginas que se reabrió con la contraseña. Ambos archivos se negaron a abrirse sin la contraseña. En el informe de 40 páginas, la pila de código abierto tomó 3,241.4 ms y produjo 39 páginas; la versión de evaluación de Spire.PDF maneja solo las primeras 10 páginas, por lo que no comparamos esa ejecución (ver la sección de ediciones).
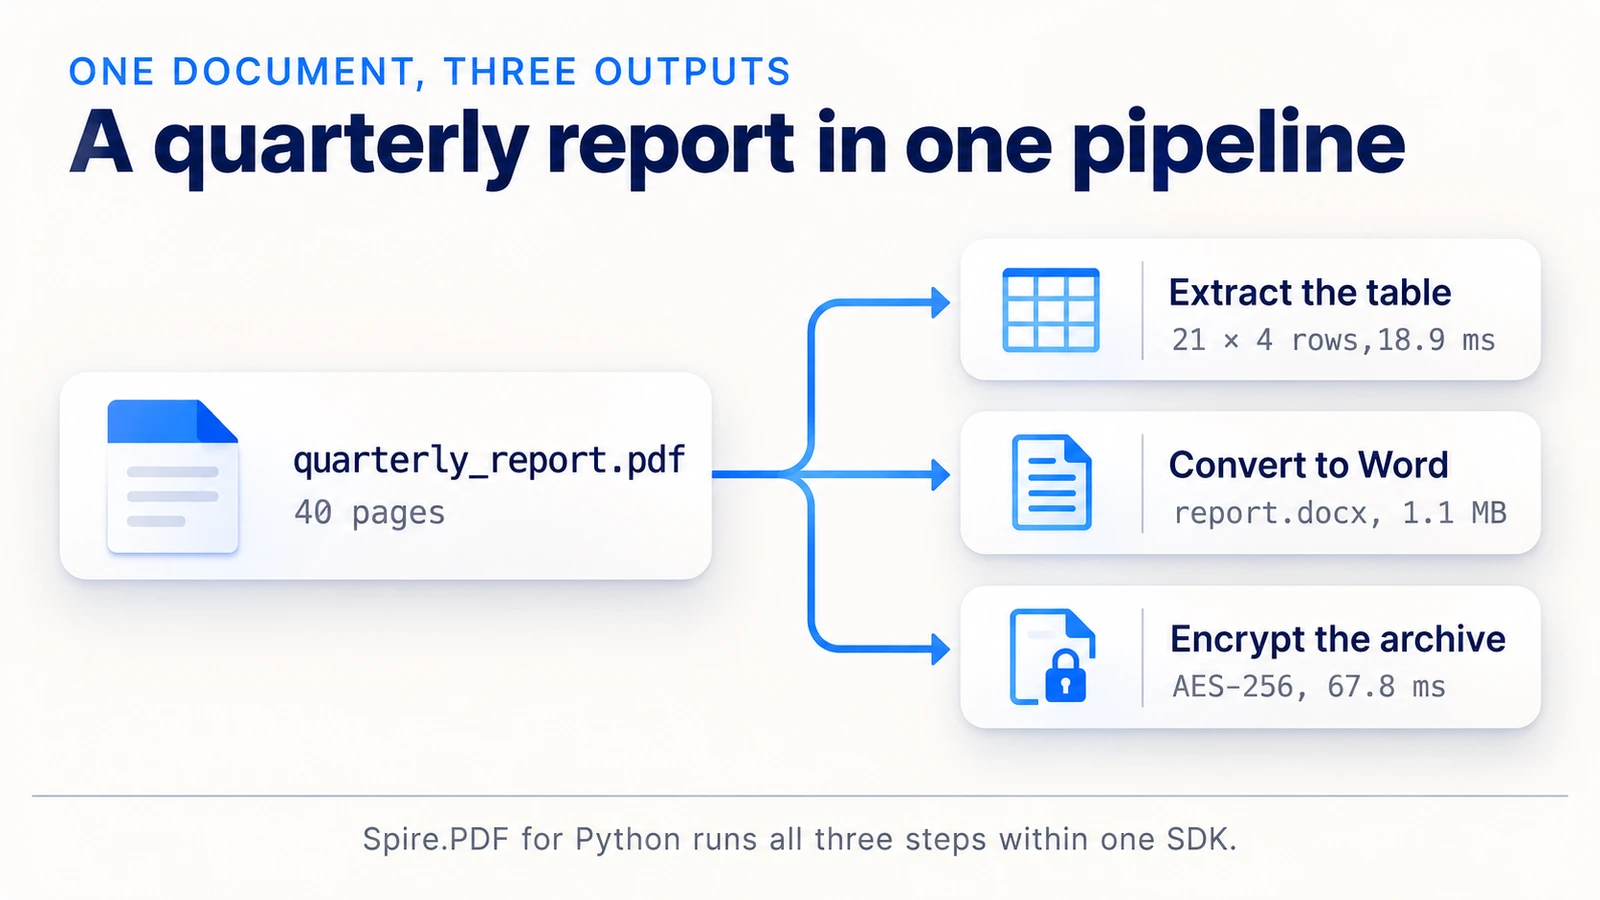
Esta comparación cubre extracción de tablas, eliminación de páginas, generación de DOCX y PDF, cifrado y tiempo transcurrido; la fidelidad del diseño DOCX está fuera de esta comparación de tiempos y debe validarse en tus propios archivos. La mayor parte de la diferencia de tiempo está en el paso DOCX, donde el convertidor de código abierto empleó alrededor de 1.3 s. El punto del ejercicio es menos el cronómetro que la forma del código: una importación, un objeto de documento, sin archivos pasados entre paquetes. Para el manejo de contraseñas con más detalle, consulta proteger o desproteger documentos PDF en Python.
Rendimiento y tamaño de instalación
Cada número a continuación es una mediana de 10 ejecuciones cronometradas después de una ejecución de calentamiento, en milisegundos, con el mínimo y el máximo entre paréntesis. Cada cifra es un tiempo de extremo a extremo para la operación: abrir el archivo de prueba y guardar la salida se incluyen donde corresponde. "n/a" significa que la biblioteca no tiene tal operación.
| Tarea | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| Texto, 10 páginas | 43.1 (39.9–46.1) | 320.4 (295.5–573.8) | 7.2 (6.7–8.4) | n/a | n/a | 58.2 (53.8–64.6) |
| Tabla, 84 celdas | n/a | 44.6 (42.3–53.7) | 363.4 (341.6–385.7) | n/a | n/a | 18.9 (16.2–26.4) |
| Rotar una página | 9.2 (8.5–13.1) | n/a | 3.8 (2.7–11.0) | 6.4 (5.6–7.7) | n/a | 22.4 (20.6–29.9) |
| Eliminar una página | 8.6 (8.2–14.7) | n/a | 3.0 (2.8–3.4) | 5.8 (5.5–6.9) | n/a | 23.3 (20.2–27.8) |
| Renderizar a 150 DPI | n/a | n/a | 48.8 (47.2–52.3) | n/a | n/a | 161.4 (153.8–180.3) |
| Cifrado AES-256 | 19.6 (17.2–24.6) | n/a | n/a | 32.0 (30.9–34.4) | n/a | 67.8 (62.1–72.2) |
| Generar 10 páginas | n/a | n/a | n/a | n/a | 14.1 (13.7–15.3) | 85.3 (79.4–106.9) |
En operaciones individuales, los especialistas lideran en la mayoría de las filas: PyMuPDF para texto, rotación, eliminación y renderizado, pypdf para ediciones de páginas en Python puro, pikepdf para trabajo estructural, y ambos para cifrado, con reportlab para generación. La mediana más baja de Spire.PDF fue en la prueba de tablas. La generación comparó 10 páginas de 40 líneas cada una, A4, Arial 10 pt. En la prueba de renderizado, PyMuPDF y Spire.PDF produjeron imágenes de 1241 × 1754 píxeles a 150 DPI. El valor de un solo SDK se muestra en flujos de trabajo combinados, no en una fila individual.
Instalación, medida en un entorno virtual limpio y excluyendo el intérprete, pip, setuptools, wheel y __pycache__:
| Objetivo | Tamaño instalado | Paquetes | Importación en nuevo proceso |
|---|---|---|---|
| pypdf | 1.8 MB | 1 | 219.9 ms |
| pypdf[crypto] | 13.2 MB | 4 | 331.8 ms |
| pdfplumber | 43.9 MB | 8 | 246.5 ms |
| PyMuPDF (predeterminado) | 201.3 MB | 12 | 223.8 ms |
PyMuPDF (--no-deps) |
104.5 MB | 1 | 217.0 ms |
| pikepdf | 35.2 MB | 4 | 178.4 ms |
| reportlab | 20.4 MB | 3 | 9.0 ms |
| Spire.PDF | 70.5 MB | 2 | 640.6 ms |
| Pila de flujo de trabajo de tres paquetes | 388.9 MB | 29 | n/a |
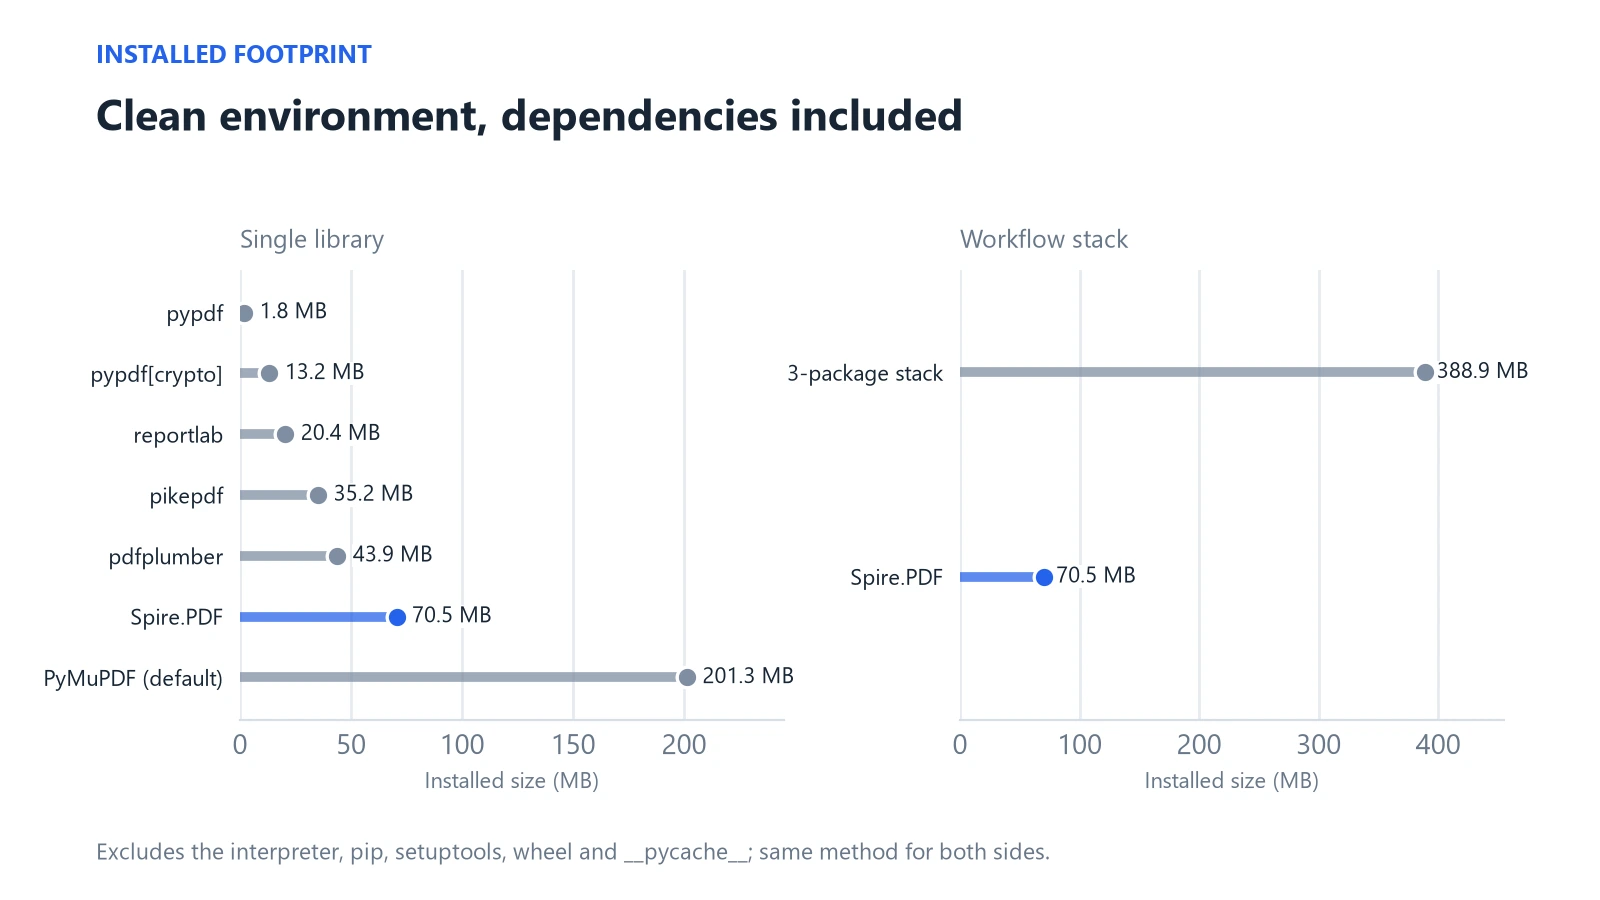
Dos detalles vale la pena leer en la tabla de instalación. El tiempo de importación es un costo único por proceso, por lo que importa para trabajos de línea de comandos de corta duración y funciones sin servidor más que para servicios de larga duración; la importación en frío de Spire.PDF midió 640.6 ms, aún menos de un segundo, mientras que la de reportlab fue la más corta con 9.0 ms. El tamaño de instalación importa para imágenes de contenedor y empaquetado de escritorio, donde el valor predeterminado de 201.3 MB de PyMuPDF y la pila de tres paquetes de 388.9 MB se destacan.
Licencias en una línea cada una: pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 o comercial, pikepdf MPL-2.0, reportlab BSD, Spire.PDF comercial. Los términos AGPL deben evaluarse según cómo distribuyas tu software.
Edición gratuita, evaluación, temporal y comercial
Spire.PDF es un producto comercial con varias ediciones, y se comportan de manera diferente, así que verifica cuál tienes instalada antes de hacer pruebas comparativas o enviar a producción.
| Paquete / versión | Estado | Límites |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | Edición gratuita | Salida limitada a 10 páginas; conversión a imagen, XPS, Word y HTML limitada a las primeras 3 páginas |
| spire-pdf 12.10.0 (2026-10-12) | Evaluación | Advertencia de evaluación; se procesan las primeras 10 páginas |
| spire-pdf 12.10.0 | Licencia temporal (30 días) | Límites de evaluación eliminados |
| spire-pdf 12.10.0 | Comercial | Ninguno de los límites anteriores |
Más allá de la API, una licencia comercial también es una relación de mantenimiento. El paquete incluye wheels para Windows, Linux y macOS, registró siete versiones entre enero y octubre de 2026 (12.1.3 a 12.10.0), y las licencias comerciales incluyen actualizaciones y soporte técnico a través del foro y correo electrónico del proveedor, con objetivos de respuesta que dependen del nivel de licencia.
El límite de páginas es fácil de verificar: un archivo de 40 páginas cargado en la versión de evaluación produce solo 10 páginas procesadas. Esa es una propiedad de la edición de evaluación, no de la capacidad del producto, y es la razón por la que nuestra ejecución de flujo de trabajo de 40 páginas se informa solo para la pila de código abierto. Las versiones de evaluación son para evaluación, no para producción. Para equipos nuevos en el producto, una secuencia sensata es comenzar con la versión de evaluación en tus propios archivos, solicitar una licencia temporal cuando necesites probar más de 10 páginas, y pasar a una licencia comercial antes de enviar a producción.
Elegir la biblioteca PDF adecuada para tu proyecto
Tres perfiles cubren a la mayoría de los equipos:
- Un trabajo especializado. Extraer texto en volumen, renderizar páginas, fusionar archivos o generar informes: elige la biblioteca creada para esa operación, como PyMuPDF, pypdf o reportlab. Verifica la licencia si redistribuyes.
- Lectura consciente del diseño. Si las tablas y las posiciones son el enfoque, pdfplumber es la herramienta para empezar, con pypdf o pikepdf para cualquier edición de páginas.
- Trabajos encadenados en el mismo archivo. Cuando la extracción, las ediciones de páginas, la conversión y el cifrado pertenecen a un solo flujo de trabajo, un solo SDK reduce la cantidad de API y árboles de dependencias que mantienes. Aquí es donde Spire.PDF está diseñado para encajar; una licencia comercial cubre actualizaciones y soporte.
Una prueba rápida antes de comprometerte: anota cada operación que el proyecto necesita durante el próximo año, incluida conversión, cifrado y archivo, y marca qué biblioteca cubre cada una. Si una biblioteca cubre toda la lista, ya está. Si la lista necesita tres, compara el costo de tres dependencias frente a una licencia.
Cuenta los trabajos, no las características. Si puedes nombrar las operaciones que tu proyecto necesita en una oración y es una o dos, un especialista probablemente sea suficiente. Si la lista sigue creciendo, prueba Spire.PDF para Python en tus propios archivos.
Cómo lo probamos
Divulgación: Spire.PDF para Python es un producto de E-iceblue, y esta prueba comparativa fue realizada por el editor. Por lo tanto, publicamos archivos de prueba, versiones y método, y las bibliotecas de código abierto se probaron exactamente en los mismos archivos.
- Entorno: Windows 11, Intel Core i3-10105 a 3.70 GHz (4 núcleos, 8 hilos), 8.4 GB de RAM, Python 3.14.6.
- Versiones: pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- Archivos de prueba: un documento de texto de 10 páginas, una tabla con bordes de 21 × 4 en la página uno, una factura en chino, una página de contenido mixto para renderizado, e informes trimestrales generados de 10 y 40 páginas. Los recuentos de páginas, tamaños y hashes SHA-256 se registran en un manifiesto de archivos de prueba.
- Medición de tiempos: un calentamiento y 10 ejecuciones medidas por prueba, informadas como medianas con mínimo y máximo. La apertura, operación y guardado se cronometraron en fases separadas.
- Corrección: texto comparado por cobertura de tokens únicos y similitud de secuencia (no recuentos brutos de caracteres, ya que las convenciones de espacios en blanco difieren); tablas comparadas celda por celda; archivos cifrados reabiertos con la contraseña y verificados para acceso bloqueado sin ella.
- No cubierto: una máquina y una carga de trabajo; documentos escaneados, OCR, firmas, manejo de formularios, tablas con celdas combinadas y archivos dañados arbitrarios no se midieron. Los tiempos variarán en tu hardware y documentos.
Preguntas frecuentes
¿Cuál es la mejor biblioteca PDF de Python en general? No hay un único ganador. PyMuPDF lidera en velocidad de texto y renderizado, pypdf es la elección simple para operaciones de página, pdfplumber para tablas, reportlab para generación. Para flujos de trabajo que encadenan varios trabajos, un solo SDK como Spire.PDF puede reducir la cantidad de paquetes PDF integrados directamente.
pypdf vs PyMuPDF: ¿cuál debería usar? Elige pypdf para operaciones de página en un paquete pequeño de Python puro con licencia BSD. Elige PyMuPDF para extracción de texto y renderizado de páginas más rápidos, y verifica primero sus términos AGPL-3.0 o comerciales. En nuestra prueba PyMuPDF tomó 7.2 ms para texto frente a 43.1 ms.
¿Cómo extraigo una tabla de un PDF en Python?
Para tablas con bordes, llama a extract_tables() en pdfplumber, o usa un extractor de tablas en PyMuPDF o Spire.PDF. En nuestro archivo de prueba de 21 × 4 las tres coincidieron en 84 de 84 celdas. Las tablas sin bordes o con celdas combinadas necesitan pruebas separadas.
¿Puede Python convertir un PDF a Word? Sí. pdf2docx es una opción de código abierto común, y Spire.PDF puede guardar un documento cargado como DOCX. La salida de conversión depende del diseño de origen; valida archivos representativos antes de su uso en producción.
¿Estas bibliotecas son gratuitas para uso comercial? pypdf, pdfplumber, pikepdf y reportlab usan licencias permisivas o de copyleft débil (BSD-3, MIT, MPL-2.0, BSD). PyMuPDF es AGPL-3.0 o comercial, así que evalúalo según cómo distribuyas. Spire.PDF requiere una licencia comercial para producción; las licencias comerciales incluyen actualizaciones y soporte técnico, mientras que las ediciones gratuita y de evaluación tienen límites de páginas.
Fuentes
- Documentación de pypdf
- Repositorio de pdfplumber
- Documentación de PyMuPDF
- Documentación de pikepdf
- Documentación de ReportLab
- Documentación de pdf2docx
- Guía de programación de Spire.PDF para Python