Elegir una biblioteca PDF de JavaScript normalmente comienza con una tarea pequeña: generar una factura, mostrar un contrato, estampar una página. Meses después, el mismo proyecto tiene que leer PDF, imprimir texto en chino o convertir una plantilla de Word en un PDF, y la biblioteca elegida para la primera tarea cubre solo una parte de la segunda.
Ejecutamos siete bibliotecas en un mismo banco de pruebas de navegador para ver dónde resiste cada una: pdf-lib, jsPDF, PDFKit, PDF.js, @react-pdf/renderer, pdfmake y Spire.PDF for JavaScript. A continuación encontrará tiempos medidos, tamaños de salida, comportamiento de fuentes y resultados de conversión, seguidos de una recomendación para cada escenario.
Divulgación: Spire.PDF for JavaScript es un producto de E-iceblue, la editorial de este artículo, y E-iceblue realizó las pruebas. Las versiones, los archivos de prueba y el método se enumeran en Cómo realizamos las pruebas. Los resultados que van en contra de nuestro propio producto se informan junto con los que lo favorecen.
¿Qué biblioteca PDF de JavaScript debería elegir?
Comience por la tarea. Cada biblioteca de esta comparación lidera en algunas filas de la tabla siguiente, y ninguna lidera en todas.
| Tarea | Mejor opción en esta prueba | Por qué |
|---|---|---|
| Generar un PDF desde código, pequeño y rápido | jsPDF, PDFKit | jsPDF tuvo la mediana más baja para 10 páginas (3.9 ms) |
| Generar tablas e informes largos con saltos de página automáticos | pdfmake | Diseño declarativo con soporte de tablas |
| Generar PDF desde componentes de React | @react-pdf/renderer | API de componentes, PDFKit por debajo |
| Leer texto, mostrar PDF | PDF.js | Analizador, API de visualización y visor en un solo proyecto |
| Modificar un PDF existente | pdf-lib | Edita archivos que ya existen |
| Convertir PDF a otros formatos, o combinar varias de las tareas anteriores en un solo paquete | Spire.PDF for JavaScript | 12 destinos de salida ejercitados en nuestras pruebas |
Las primeras cinco filas son tareas individuales, y una biblioteca de código abierto especializada hace bien cada una. La última fila es el otro caso: un proyecto que necesita varias de esas tareas, o cualquier conversión entre formatos, donde cambia la aritmética. Las secciones sobre los límites de una sola biblioteca y sobre Spire explican por qué.
Qué hace mejor cada biblioteca
Dos de las tres frases que la gente busca aquí describen tareas, no bibliotecas. Un analizador PDF de JavaScript lee archivos, y un editor PDF de JavaScript cambia archivos que ya existen. Esa división decide mucho, así que cada entrada a continuación termina con lo que la biblioteca no puede hacer.
pdf-lib (1.17.1) crea PDF y modifica los existentes, lo que lo convierte en el editor PDF de JavaScript de código abierto habitual.
import { PDFDocument, StandardFonts } from 'pdf-lib'

const doc = await PDFDocument.create()
const page = doc.addPage([595.28, 841.89])
const font = await doc.embedFont(StandardFonts.Helvetica)
page.drawText('Hello', { x: 40, y: 800, size: 12, font })
const bytes = await doc.save()
Elíjalo cuando llegue un PDF de otro lugar y necesite agregar una página, superponer texto o rellenar valores. No tiene API de extracción de texto: leyó el número de páginas de nuestro archivo de prueba de 10 páginas en 8 ms, y eso es todo su soporte de lectura. Su última versión, 1.17.1, data del 06-11-2021. Si busca una alternativa a pdf-lib por eso, el fork de la comunidad @cantoo/pdf-lib continúa el código.
jsPDF (4.2.1) genera documentos en el navegador con llamadas imperativas.
import { jsPDF } from 'jspdf'

const doc = new jsPDF()
doc.text('Hello', 10, 10)
const buffer = doc.output('arraybuffer')
Es adecuado para exportaciones rápidas donde unas pocas líneas de código producen un recibo o una página de informe. Solo crea archivos, por lo que no puede abrir y editar un PDF existente, que es la línea divisoria habitual entre pdf-lib y jsPDF. Su opción compress también daña el texto en chino, cubierto en la sección de fuentes a continuación. Quien busque una alternativa a jsPDF primero debe decidir si la pieza faltante es edición (pdf-lib), tablas (pdfmake) o React (React-PDF).
PDFKit (0.20.2) genera documentos en Node y, con un empaquetador, en el navegador. La compilación para navegador necesita fuentes estándar registradas manualmente.
import PDFDocument, { registerStdFonts } from 'pdfkit'
import Helvetica from 'pdfkit/standard-fonts/Helvetica'
registerStdFonts(Helvetica)

const doc = new PDFDocument()
doc.font('Helvetica').text('Hello')
Usted coloca el texto y los gráficos, porque PDFKit es una API de dibujo y no un renderizador HTML/CSS, así que no se le puede entregar simplemente una página web. Ese control es adecuado para documentos con un diseño fijo, como etiquetas, certificados y estados de cuenta. No puede leer PDF existentes.
PDF.js (6.5.438) es un núcleo de analizador, una API de visualización y un visor listo para usar. Es la opción de código abierto para leer y mostrar PDF, y maneja la extracción de texto.
import * as pdfjsLib from 'pdfjs-dist'

const doc = await pdfjsLib.getDocument({ data: bytes }).promise
const page = await doc.getPage(1)
const content = await page.getTextContent()
Los desarrolladores que buscan un analizador PDF de JavaScript suelen terminar aquí, porque devuelve texto estructurado y datos de página en lugar de bytes sin procesar. No puede crear un PDF desde cero, y su edición se limita a lo que cubre saveDocument, como la selección de páginas y los cambios de anotaciones. No es un editor PDF de propósito general.
@react-pdf/renderer (4.9.0) convierte componentes de React en PDF. Se basa en PDFKit, así que produce el mismo error de fuente estándar no registrada en el navegador.
import { Document, Page, Text, pdf } from '@react-pdf/renderer'

const blob = await pdf(
  <Document><Page><Text>Hello</Text></Page></Document>
).toBlob()
Encaja en equipos que ya describen su interfaz en React y quieren que las facturas o los informes compartan componentes con ella. Solo produce salida. Leer o editar un archivo existente requiere otra biblioteca.
pdfmake (0.3.14) toma una definición declarativa de documento y maneja tablas y saltos de página. Desde la 0.3, getBuffer devuelve una Promise. El código que pasa una función de devolución de llamada nunca recibe respuesta.
import pdfMake from 'pdfmake/build/pdfmake'
import pdfFonts from 'pdfmake/build/vfs_fonts'
pdfMake.vfs = pdfFonts.vfs

const buffer = await pdfMake.createPdf({ content: ['Hello'] }).getBuffer()
Es la más cómoda de las seis de código abierto para salidas largas con muchas tablas, porque usted describe el contenido y la biblioteca decide dónde se rompen las páginas. Genera documentos a partir de un objeto de definición y no puede analizar ni editar PDF existentes.
Spire.PDF for JavaScript (11.7.0) es la única entrada aquí que no se limita a una parcela.
Cada biblioteca anterior se especializa en una tarea, y la siguiente sección muestra lo que eso cuesta cuando un proyecto necesita dos de ellas. Esta ejecuta las mismas cuatro tareas mediante una sola API: generación, extracción de texto, operaciones de página y renderizado a imagen, y agrega doce destinos de conversión que ninguna de las otras tiene. Sus límites son los que medimos e informamos a continuación: no es un componente visor, y el uso en producción requiere una licencia comercial. Los ejemplos de código y los resultados completos de conversión están en su propia sección.
Dónde se detiene una sola biblioteca
Ninguna de las seis bibliotecas de código abierto genera, analiza, modifica y renderiza PDF. Cada una posee una parcela.
Tomemos un flujo de trabajo que suena común: leer una plantilla DOCX de un cliente, rellenar datos de pedido, producir un PDF y luego protegerlo con contraseña. Ninguna de las seis abre un archivo de Word, así que un paquete maneja el paso DOCX, normalmente en un servidor. Luego una biblioteca de maquetación escribe el PDF, y un tercer paquete aplica la protección. Eso son tres paquetes y dos traspasos.
Los roles también se difuminan en la conversación. La gente dice "renderizar un PDF" cuando quiere decir tres cosas diferentes: dibujar un documento desde código, mostrar un archivo existente a un usuario o convertir una página en una imagen. PDF.js muestra, los generadores dibujan, y ninguna de las seis hace las tres. Anotar qué significado necesita su proyecto elimina la mitad de la lista corta.
Cada traspaso es un ArrayBuffer que validar, y cada paquete aporta sus propias reglas para fuentes y codificaciones. Las piezas son buenas individualmente, y el pegamento entre ellas es donde se acumula el costo de mantenimiento. Los equipos suelen sentirlo la primera vez que un requisito cruza una frontera, como "exportar también el resultado como Word".
Qué agrega Spire.PDF for JavaScript
Spire.PDF for JavaScript se ejecuta como WebAssembly en el navegador, por lo que los documentos se pueden procesar en el cliente sin un viaje de ida y vuelta al servidor. Lo probamos mediante el paquete spire.office, versión 11.7.0.
Su API cubre fusión, división, compresión, operaciones de página, campos de formulario, anotaciones, marcadores, adjuntos y capas; la guía del programa Spire.PDF for JavaScript enumera toda la superficie. La parte que medimos aquí es la conversión. Convertimos un PDF chino de 2 páginas (13.1 KB) a diez de los trece valores de la enumeración FileFormat, además de exportación a PNG y una conversión a PDF/A.
| Salida | Tamaño |
|---|---|
| DOCX | 5,132,598 B |
| XLSX | 9,594 B |
| PPTX | 27,827 B |
| HTML | 89,687 B |
| Markdown | 558 B |
| XPS | 24,202 B |
| OFD | 17,281 B |
| PCL | 47,272 B |
| PostScript | 87,159 B |
| PNG (página 1, 184 ms) | 19,789 B |
| PDF/A-1b | 57,581 B |
| SVG (un archivo por página) | 44,777 B por página |
Los doce destinos convirtieron el archivo chino. La exportación a SVG escribe un archivo por página, llamado output_1.svg, output_2.svg, etc. El DOCX de 5.1 MB proviene de la fuente china que se traslada al archivo de Word, y los documentos en inglés no se comportan así.
import * as spire from '/spire.pdf.js'
const { PdfDocument, PdfFont, PdfFontFamily, PdfBrushes } = spire.spirepdf

const doc = new PdfDocument()
const page = doc.Pages.Add()
const font = new PdfFont({ fontFamily: PdfFontFamily.Helvetica, size: 12 })
page.Canvas.DrawString({ s: 'Hello', font, brush: PdfBrushes.get_Black(), x: 40, y: 60 })
doc.SaveToFile({ fileName: 'out.pdf' })
Los parámetros se pasan como un único objeto literal. Los argumentos posicionales generan un error Ambiguous call. La conversión necesita un paso más, porque WebAssembly no tiene fuentes del sistema:
PdfDocument.LoadCustomFontFolder('/Library/Fonts')   // skipping this raises "Cannot found font"

const doc = new PdfDocument()
doc.LoadFromFile({ fileName: 'in.pdf' })
doc.SaveToFile({ fileName: 'out.docx', fileFormat: spire.spirepdf.FileFormat.DOCX })
Copie un archivo de fuente en esa carpeta del sistema de archivos virtual antes de llamarlo.
Como todo se ejecuta en un solo paquete WebAssembly, una sola página puede abrir un PDF, cambiarlo y guardarlo en otro formato sin pasar bytes a una segunda biblioteca. Los equipos que procesan archivos subidos por el usuario en el navegador, donde enviar documentos a un servidor es una cuestión de privacidad o cumplimiento, suelen beneficiarse más.
Tres números pertenecen a cualquier plan de despliegue. La primera carga tardó 1,900.7 ms (2,756 ms en otra ejecución en frío), y la mayor parte es CPU: el runtime descarga aproximadamente 19 MB de archivos WebAssembly y los descomprime con JSZip antes de que se abra el primer documento. Los dos archivos son Spire.Common.Wasm (10.1 MB) y Spire.Pdf.Wasm (8.6 MB). El pegamento JavaScript agrega alrededor de 1.3 MB sin comprimir pero se comprime a aproximadamente 117 KB en tránsito; los archivos en sí ya están comprimidos y no ganan nada con gzip.
Office a PDF en un solo paquete
Las seis bibliotecas de código abierto parten de un PDF. Los archivos de Word, Excel y PowerPoint quedan fuera de su alcance, por lo que el flujo de trabajo de la sección anterior necesitaba un cuarto paquete.
Spire.Office for JavaScript es una familia de paquetes npm con cuatro puntos de entrada para Word, Excel, PowerPoint y PDF. Cada entrada tiene su propio módulo WebAssembly, y un módulo común se encuentra debajo de todos ellos. Word a PDF, Excel a PDF y PowerPoint a PDF se ejecutan en el navegador sin servidor, y PDF a Word, Excel, PowerPoint y HTML se ejecutan a través de la misma familia.
Para un recorrido con código funcional, consulte la conversión de Word a PDF con JavaScript en React.
Un límite se aplica a cada afirmación de esta sección: nuestro benchmark cronometró solo operaciones PDF. La conversión de Office a PDF no se midió aquí, así que no hay números de velocidad o fidelidad para ella en este artículo. Cualquiera que planee depender de esa ruta debería cronometrarla con sus propios archivos de Word y Excel, porque la complejidad del diseño cambia el costo de conversión mucho más que el tamaño del archivo. Lo que sí podemos decir es estructural. Un flujo de trabajo de plantillas que necesitaba tres paquetes se puede escribir contra una sola familia de paquetes, y los traspasos de archivos entre bibliotecas desaparecen.
Rendimiento y costo de carga
Todas las bibliotecas terminaron un documento en inglés de 10 páginas en menos de 100 ms. jsPDF fue la más rápida con 3.9 ms y Spire tardó 90.7 ms, una diferencia que es medible pero improbable que importe en una exportación activada por clic.
| Biblioteca | Primera ejecución | Mediana (10 páginas) | Tamaño de salida |
|---|---|---|---|
| jsPDF | 12.1 ms | 3.9 ms | 6,609 B |
| PDFKit | 45.7 ms | 6.8 ms | 6,194 B |
| pdf-lib | 86.1 ms | 9.2 ms | 3,123 B |
| pdfmake | 75.6 ms | 25.4 ms | 16,823 B |
| React-PDF | 125.5 ms | 36.3 ms | 7,395 B |
| Spire | 486.0 ms | 90.7 ms | 7,723 B |
Vale la pena echar un vistazo a la columna de primera ejecución. Incluye la inicialización única, así que muestra lo que ve un usuario en el primer clic después de que se carga la página. Las bibliotecas de código abierto van de 12.1 a 125.5 ms allí, y Spire tarda 486.0 ms. Todas se estabilizan rápidamente en llamadas repetidas.
El costo real está en la carga: Spire tardó 1,900.7 ms frente a 13 a 211 ms de las demás.
| Biblioteca | Primera importación |
|---|---|
| jsPDF | 13.0 ms |
| React-PDF | 53.2 ms |
| PDFKit | 119.2 ms |
| pdf-lib | 191.7 ms |
| pdfmake | 197.0 ms |
| PDF.js | 211.2 ms |
| Spire.PDF for JavaScript | 1,900.7 ms |
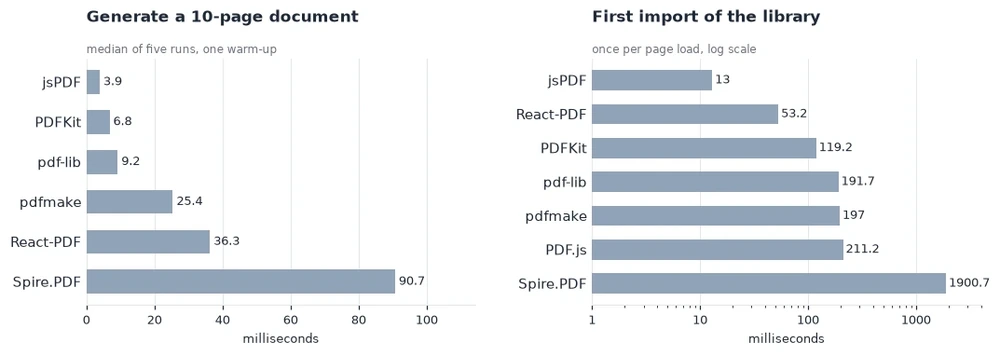
Trate los dos números como presupuestos diferentes. El tiempo de generación se gasta por documento, y el tiempo de carga se gasta una vez por visita. Una herramienta que exporta cientos de archivos en una sesión paga los 1.9 segundos una sola vez, mientras que una página de destino que exporta un archivo paga todo por ese archivo.
Esa demora perjudica en una página donde el trabajo de PDF ocurre durante el primer renderizado. Cuando la conversión comienza después de un clic, cargar el módulo con antelación o bajo demanda oculta la mayor parte.
El tamaño de salida depende más de la configuración que de la biblioteca. Con un PNG de 800x800, jsPDF produjo 1,923,288 B por defecto y 32,044 B con compress: true. pdf-lib (128.1 ms) y PDFKit (189.6 ms) insertaron la misma imagen más rápido que jsPDF (257.8 ms), con 26,846 B y 27,993 B.
La lectura es un benchmark aparte, ejecutado sobre un PDF de 10 páginas:
| Biblioteca | Leer número de páginas | Extraer texto |
|---|---|---|
| pdf-lib | 8 ms | No compatible |
| Spire | 94 ms | 284 ms |
| PDF.js | 200 ms | 190 ms |
Compare solo los tiempos. Spire se configuró para preservar espacios en blanco y devolvió 1,381 caracteres, mientras que PDF.js une elementos de texto y devolvió 521, así que los recuentos de caracteres no son comparables.
Texto en chino y manejo de fuentes
Las seis bibliotecas de código abierto necesitan un archivo de fuente china que usted proporcione. Usamos SimHei (TrueType de 9.7 MB). Una vez proporcionada, todas incorporaron la fuente y renderizaron el texto correctamente, lo que confirmamos renderizando la salida con PyMuPDF.
| Biblioteca | Mediana, 1 página en chino | Tamaño de salida |
|---|---|---|
| jsPDF | 1.1 ms (primera llamada 479.8 ms) | 3,160 B |
| React-PDF | 7.3 ms | 11,286 B |
| pdfmake | 10.7 ms | 5,323 B |
| PDFKit | 11.3 ms | 10,743 B |
| pdf-lib | 32.7 ms | 9,693 B |
| Spire (TTF incorporado) | 169.3 ms | 12,289 B |
El archivo de fuente en sí tiene 9.7 MB, que su página tiene que enviar o buscar, así que planifique cargarlo bajo demanda y almacenarlo en caché. Los 1.1 ms de jsPDF se aplican después de que la fuente está registrada. La primera llamada, que incluye el registro, tardó 479.8 ms, así que la cifra no debe interpretarse como una ventaja de velocidad.
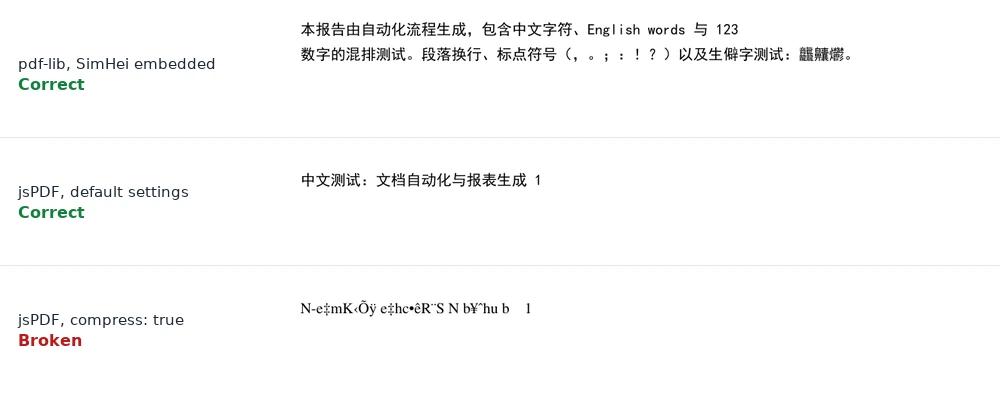
La trampa está en jsPDF. Una página en chino generada con la configuración predeterminada llegó a 184,355 B y se renderizó correctamente. Con compress: true el archivo se redujo a 3,168 B, contenía cero caracteres chinos y se renderizó como galimatías latinas. La fuente había desaparecido de la tabla de fuentes, y el renderizado lo confirmó, así que la extracción no era el problema. Deje la compresión desactivada para documentos en chino y revise la página renderizada. Las páginas solo de imagen se comprimen de forma segura (de 1,923,288 B a 32,044 B), así que es una decisión por documento.
Spire ofrece familias de fuentes CJK integradas que no necesitan archivo de fuente, y producen la salida más pequeña que vimos (2,262 B) porque la fuente no se incorpora. La cobertura depende de la familia: SinoTypeSongLight renderizó todos los caracteres de nuestra muestra, mientras que MonotypeHeiMedium y MonotypeSungLight omitieron 报 y 数. Verifique su conjunto de caracteres con la familia que elija, o incorpore un TTF, que se renderizó correctamente en nuestra prueba.
PDF/A y licencias
PDF/A es el perfil de archivo de PDF, y muchos flujos de trabajo de registros y cumplimiento lo exigen. Un archivo puede verse correcto en un visor y aun así fallar el estándar, así que verificamos la salida con un validador en lugar de a ojo. Validamos la salida de archivo con veraPDF 1.30.3. Los archivos PDF/A-1b y PDF/A-2b de Spire pasaron ambos. PDFKit, llamado mediante su opción documentada subset: 'PDF/A-1b', falló con cinco infracciones: fuentes no incorporadas (6.3.4), una clave de metadatos faltante (6.7.2) y metadatos Info y XMP que no coinciden (6.7.3). El archivo fuente de Spire, sin convertir, también falló 1b, lo que muestra que el validador separa archivos buenos de malos. No probamos las otras bibliotecas para PDF/A.
Spire.PDF for JavaScript está disponible en tres ediciones. La edición gratuita, en free-pdf-for-javascript, cubre la generación y conversión de archivos PDF y no lleva marca de agua. La compilación de evaluación usada para este benchmark protege su salida con una marca de agua y un límite de páginas. Una licencia temporal gratuita elimina ambas mientras evalúa el producto, y una licencia comercial cubre el uso en producción, que es el arreglo normal para un SDK comercial.
Una forma práctica de evaluar es elegir tres de sus documentos reales: el más largo, uno con texto en chino u otro texto no latino, y uno que tenga que salir como PDF/A o Word. Solicite una licencia temporal gratuita para esa ejecución, para que la longitud del documento no sea un factor, y luego compare con la biblioteca de código abierto que usaría de otro modo, tanto en tiempo de carga como en salida.
Cómo realizamos las pruebas
Las pruebas se ejecutaron en un proyecto Vite en un navegador basado en Chromium en Windows 11 Pro (10.0.26300), con Node v26.12.1 y npm 12.0.1. Cada medición usó una ejecución de calentamiento y cinco repeticiones, e informamos la mediana. El archivo de imagen era un PNG de 800x800 generado en un canvas en tiempo de ejecución, y las pruebas en chino usaron SimHei.
Las versiones de las bibliotecas eran pdf-lib 1.17.1, jsPDF 4.2.1, PDFKit 0.20.2, PDF.js 6.5.438, @react-pdf/renderer 4.9.0, pdfmake 0.3.14 y spire.office 11.7.0. Las fuentes se verificaron renderizando con PyMuPDF, y los archivos PDF/A con veraPDF.
El proyecto de benchmark y sus scripts de análisis son reproducibles, así que un equipo puede volver a ejecutar los mismos casos en su propio hardware y comparar. Los tiempos variarán según la máquina, y las proporciones entre bibliotecas son la señal más útil.
Los documentos de prueba tenían 10 páginas o menos. La comparación de píxeles renderizados entre bibliotecas, y la salida PDF/A para bibliotecas distintas de Spire y PDFKit, quedaron fuera de esta ejecución. Como se indicó al principio, E-iceblue realizó este benchmark y publica Spire.PDF for JavaScript.
Preguntas frecuentes
¿Puedo renderizar PDF en el navegador? Use PDF.js, que incluye una API de visualización y un visor. No comparamos píxeles renderizados entre bibliotecas. Spire.PDF for JavaScript convierte una página a PNG (184 ms para la página 1 en nuestra prueba), pero no es un componente visor; para visualización y edición en el navegador, Spire.OfficeJS es la suite de front-end creada para esa tarea.
¿Qué biblioteca es mejor para texto en chino?
Cualquiera de las seis bibliotecas de código abierto funciona una vez que proporciona una fuente, excepto jsPDF con compress: true. Las familias CJK integradas de Spire no necesitan archivo de fuente; SinoTypeSongLight cubrió nuestra muestra completa en chino, mientras que las dos familias Monotype omitieron algunos caracteres.
¿Y si necesito procesar archivos de Word o Excel? Las seis bibliotecas de código abierto parten de PDF. Spire.Office for JavaScript maneja Word, Excel y PowerPoint en la misma familia de paquetes.
¿El tamaño del paquete será un problema? Las bibliotecas de código abierto se inicializaron en 13 a 211 ms. Spire tardó 1.9 segundos y suma aproximadamente 19.6 MB de archivos, lo que no es lo mismo que el tamaño de descarga. Cárguelo bajo demanda si el primer renderizado importa.
¿Necesito una licencia en producción? La edición gratuita cubre la generación y conversión de archivos PDF sin marca de agua. La compilación de evaluación protege su salida con una marca de agua y un límite de páginas, que una licencia temporal gratuita elimina mientras evalúa el producto. Se requiere una licencia comercial para producción.
Nuestra recomendación según el escenario
La división se reduce a cuántas tareas tiene su proyecto.
Una tarea: elija el especialista.
- Facturas y recibos, velocidad ante todo: jsPDF o PDFKit, con una comprobación de fuentes para chino.
- Tablas e informes largos: pdfmake.
- Aplicaciones React: @react-pdf/renderer.
- Editar un PDF existente: pdf-lib, teniendo en cuenta su fecha de lanzamiento de 2021.
- Lectura y visualización: PDF.js.
- Salida de archivo que tiene que pasar un validador: Spire.PDF for JavaScript. Sus archivos PDF/A-1b y PDF/A-2b pasaron veraPDF, mientras que la opción documentada
subsetde PDFKit falló cinco reglas. - Salida en chino sin enviar un archivo de fuente: las familias CJK integradas de Spire. SinoTypeSongLight cubrió nuestra muestra completa, y las seis bibliotecas de código abierto necesitan cada una un archivo de fuente que usted mismo distribuye, 9.7 MB en nuestra prueba.
Dos o más tareas, o cualquier conversión entre formatos: cambia la aritmética. Un proyecto que lee una plantilla DOCX, escribe un PDF y convierte el resultado hacia adelante necesita dos o tres de las bibliotecas anteriores, más un cuarto paquete para Word, y cada traspaso entre ellas es un ArrayBuffer que validar y una canalización de fuentes separada que configurar. Ese es el caso para el que está hecha Spire.PDF for JavaScript: una API que abarca las cuatro tareas anteriores y doce destinos de conversión, ejecutándose en el navegador sin servidor.
El costo es medible y lo hemos informado: 1.9 segundos en la primera carga, porque el runtime descomprime aproximadamente 19 MB de WebAssembly antes de que se abra el primer documento. Cárguelo antes del primer clic y el usuario nunca lo verá. La edición gratuita cubre la generación y la conversión sin marca de agua, y una licencia temporal elimina los límites de evaluación mientras compara con sus propios documentos.