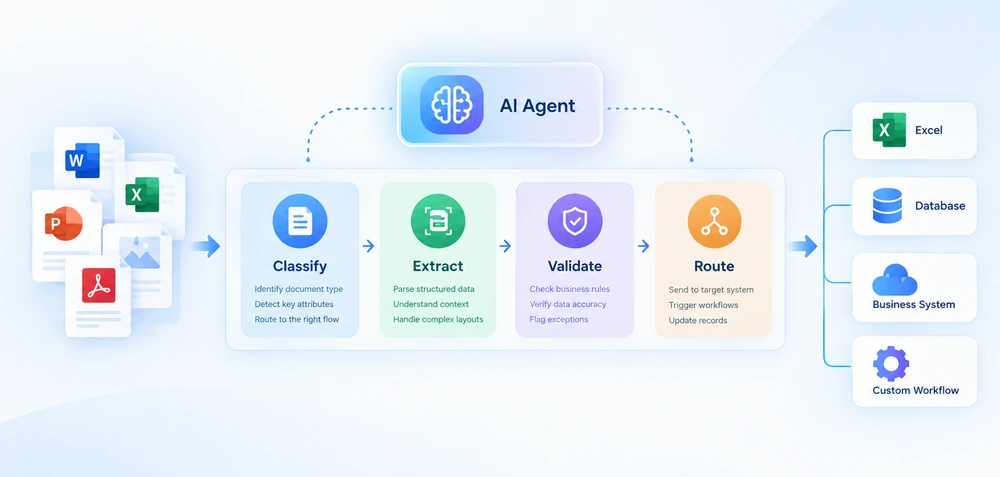
El procesamiento inteligente de documentos (IDP) combina la comprensión de documentos basada en IA con extracción automatizada, validación y procesamiento posterior. Para los desarrolladores de .NET, implementar IDP normalmente significa conectar la comprensión de documentos basada en IA con código determinista que maneja archivos, reglas de negocio e integración de sistemas.
Esta guía se centra en los flujos de trabajo de IDP para documentos de Office y PDF en .NET. Cubre la arquitectura de canalización de cuatro etapas, muestra patrones de implementación en C# y proporciona un marco de decisión para elegir entre desarrollarlo internamente y adoptar una plataforma de proveedor.
Navegación rápida
- La canalización IDP de cuatro etapas
- Creación de una canalización IDP en .NET
- Procesamiento por lotes y de múltiples documentos
- IDP en la práctica
- Crear vs. comprar: elegir un enfoque de IDP
1. ¿Qué es el procesamiento inteligente de documentos?
El procesamiento inteligente de documentos es un enfoque de automatización que utiliza IA para clasificar documentos, extraer datos estructurados de ellos, validar los resultados según reglas de negocio y enrutar la salida a sistemas posteriores. A diferencia del OCR tradicional, que principalmente convierte contenido visual en texto legible por máquina, el IDP añade clasificación de documentos, extracción semántica, validación y automatización de flujos de trabajo. Puede manejar diseños de documentos variados sin depender por completo de plantillas fijas.
Una canalización IDP práctica se puede organizar en cuatro etapas: clasificar, extraer, validar y enrutar. Cada etapa tiene entradas, salidas y modos de fallo distintos. El agente de IA maneja la clasificación y la extracción mediante comprensión de lenguaje natural, mientras que la validación y el enrutamiento siguen siendo código determinista que aplica reglas de negocio y se integra con sistemas posteriores.
IDP vs. OCR, procesamiento de documentos e inteligencia de documentos
Estos términos a menudo se usan indistintamente, pero describen capacidades diferentes:
| Tecnología | Función principal |
|---|---|
| OCR | Convertir contenido visual en texto |
| Procesamiento de documentos | Leer, manipular, convertir o generar archivos |
| Inteligencia de documentos | Comprender el contenido del documento y extraer significado |
| IDP | Combinar la comprensión de documentos con flujos de trabajo automatizados |
En la práctica, estas capacidades a menudo se superponen. Una canalización IDP puede usar OCR para documentos escaneados, IA para comprensión semántica y API de procesamiento de documentos para operaciones deterministas con archivos. La distinción importa para la arquitectura: saber qué capa maneja cada responsabilidad determina cómo se construye y mantiene el sistema.
IDP no significa reemplazar todo el flujo de trabajo con IA. La IA se encarga de la comprensión y la extracción; el código determinista se encarga de la validación, el enrutamiento, la manipulación de archivos y la integración de sistemas. Esta separación es lo que hace que el IDP sea mantenible en producción: las reglas de negocio cambian con más frecuencia que los formatos de documentos, y esas reglas deben estar en código que usted controle, no en un mensaje de modelo.
2. La canalización IDP de cuatro etapas
Una canalización IDP no es una sola llamada a API. Es una secuencia de etapas, cada una con entradas, salidas y modos de fallo distintos. Comprender esta arquitectura es la diferencia entre construir una canalización que maneje variedad real de documentos y escribir un script que falle ante la primera entrada inesperada.
Una canalización IDP práctica se puede organizar en cuatro etapas:
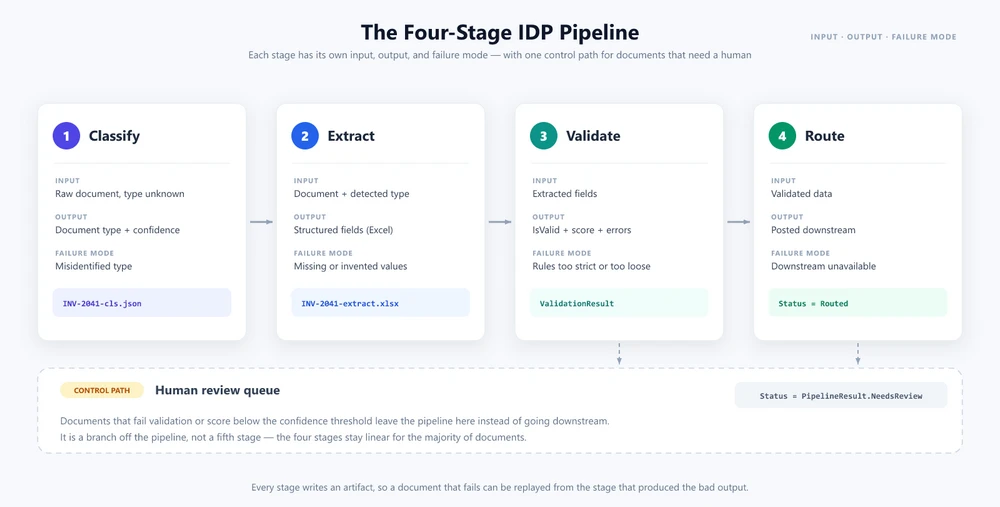
Etapa 1 — Clasificación
La canalización recibe un documento de tipo desconocido. La clasificación determina qué es el documento —una factura, un contrato, una orden de compra, un recibo, un extracto bancario— y adjunta metadatos que impulsan el comportamiento posterior. En un sistema tradicional, la clasificación se basa en convenciones de nombres de archivo, rutas de carpetas o coincidencia de plantillas. En una canalización impulsada por IA, la clasificación utiliza análisis de lenguaje natural: el agente lee el contenido del documento y determina su tipo según la comprensión semántica.
Etapa 2 — Extracción
Una vez que se conoce el tipo de documento, la extracción obtiene datos estructurados del documento. Para una factura, esto significa nombre del proveedor, número de factura, partidas, totales, importes de impuestos, condiciones de pago. Para un contrato, significa partes, fechas de vigencia, cláusulas de terminación, obligaciones financieras. La etapa de extracción transforma el contenido del documento no estructurado o semiestructurado en un formato estructurado (JSON, XML, registros de base de datos) que los sistemas posteriores pueden consumir.
Etapa 3 — Validación
Los datos extraídos se verifican según las reglas de negocio. ¿El total de la factura coincide con la suma de las partidas? ¿El proveedor está en la lista de proveedores aprobados? ¿El contrato está firmado por un firmante autorizado? La validación detecta errores de extracción, marca anomalías y produce una puntuación de confianza que determina si el documento puede enrutarse automáticamente o requiere revisión humana.
Etapa 4 — Enrutamiento
Los datos validados se envían al sistema posterior adecuado: un ERP para datos de facturas, una plataforma de gestión de contratos para datos de contratos, un archivo de documentos para todo lo demás. El enrutamiento también puede desencadenar flujos de trabajo posteriores: cadenas de aprobación, procesamiento de pagos, verificaciones de cumplimiento.
La revisión humana es una ruta de control en lugar de una etapa obligatoria: los documentos que no superan la validación o quedan por debajo de un umbral de confianza pueden enrutarse para revisión manual. Esto mantiene la canalización de cuatro etapas lineal para la mayoría de los documentos, a la vez que proporciona un respaldo controlado para casos límite.
Por qué el IDP necesita más que una llamada a la API de IA
Cada etapa tiene modos de fallo independientes. La clasificación puede identificar mal un tipo de documento. La extracción puede omitir campos o alucinar valores. La validación puede rechazar datos válidos debido a reglas demasiado estrictas. El enrutamiento puede fallar debido a la indisponibilidad del sistema posterior. Una canalización IDP robusta maneja cada modo de fallo de forma independiente, con lógica de reintento, comportamiento de respaldo y registro de auditoría en cada etapa.
3. Creación de una canalización IDP en .NET
Una forma de implementar esta arquitectura en .NET es usar Spire.Agent.Office, un SDK de agente de IA que procesa documentos de Word, Excel, PowerPoint y PDF mediante instrucciones en lenguaje natural. El SDK proporciona el método de extensión AI() en objetos de documento (Document, PdfDocument, Workbook, Presentation), que acepta una configuración AIOptions y devuelve un AIDocumentProcessor. Llamar a ExecuteInstruction en el procesador ejecuta la instrucción y escribe la salida en un archivo, devolviendo un AIResult con las propiedades Success y ErrorMessage.
Requisitos previos
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Los ejemplos a continuación se centran en la arquitectura de la canalización y la integración con Spire.Agent.Office. Los métodos auxiliares, como el análisis de resultados y el enrutamiento posterior, se omiten por brevedad.
3.1 Definir el modelo de canalización
La canalización necesita estructuras de datos para transportar resultados entre etapas y una configuración compartida para el agente de IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken se utiliza para autenticar Spire.Agent.Office. El SDK gestiona la conexión con el servicio de IA a través de AIOptions, por lo que la aplicación no necesita implementar directamente la integración con la API del modelo subyacente. WorkDir designa dónde almacena el agente los archivos intermedios durante el procesamiento.
3.2 Clasificar y extraer documentos con un agente de IA
La clasificación carga el documento, pide al agente que identifique su tipo y escribe el resultado en un archivo JSON. El mismo patrón LoadFromFile → AI(options) → ExecuteInstruction funciona para todos los formatos de documento; solo cambia la clase de documento, y ese despacho es suyo para escribirlo. AI() se enlaza a un tipo de documento concreto: un PDF debe cargarse como PdfDocument, un libro de trabajo como Workbook, una presentación como Presentation y un archivo de Word como Document. Entregar un archivo a la clase incorrecta no recurre a un lector genérico; lanza una excepción, así que elija la clase según la extensión de archivo antes de llamar a AI().
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
La extracción utiliza instrucciones específicas de tipo para obtener campos estructurados del documento:
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
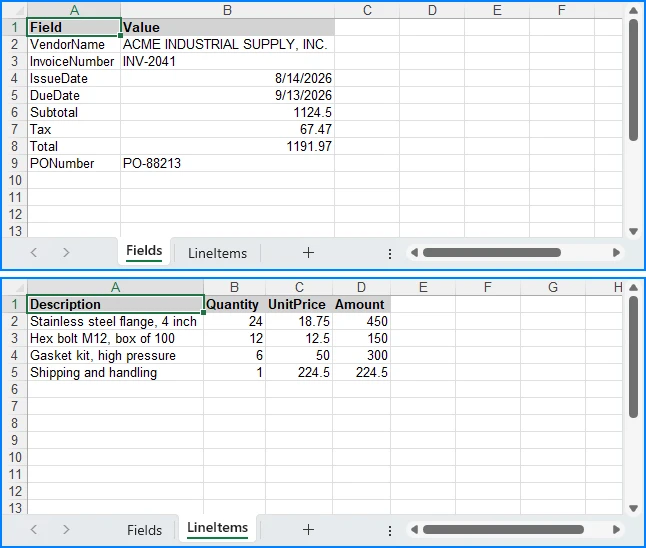
Cada tipo de documento recibe una instrucción dedicada que le dice al agente qué campos buscar y qué formato de salida producir. El agente lee el documento de origen y escribe un libro de Excel estructurado en extractPath. La instrucción es lo que fija la forma de ese libro: nombrar las hojas, los encabezados y los nombres de campo exactos es lo que hace que la salida sea analizable posteriormente. Una instrucción que solo dice "extraer los campos de la factura" puede devolver un nombre de hoja diferente, una fila de encabezado diferente o una ortografía diferente para el mismo campo en cada ejecución, porque el agente decide el diseño por sí mismo. GetField en la siguiente sección cubre las variaciones que se escapan de todos modos.
Esa división entre el juicio del agente y el código determinista se trata más a fondo en Agente de IA para el procesamiento de documentos.
3.3 Validar datos extraídos con C#
La validación es lógica pura de C#, no se necesita llamada a IA. El agente ya ha producido datos estructurados; la validación verifica esos datos según las reglas de negocio.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
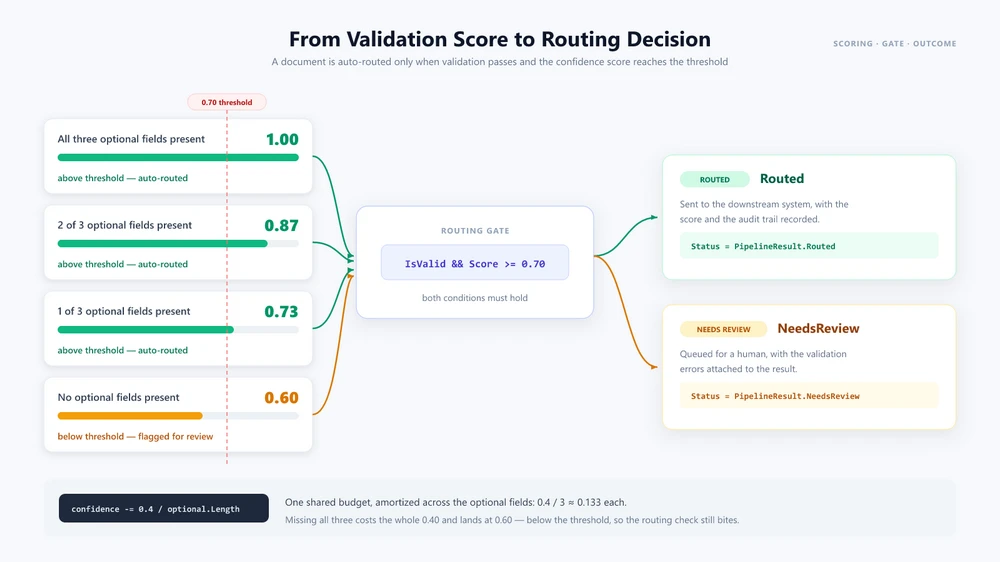
La validación separa los fallos graves de las advertencias de calidad. Un campo obligatorio faltante, un total que no concilia con las partidas o un tipo de documento sin reglas produce una entrada en Errors, y el documento se trata como inválido. Un campo opcional que no se pudo extraer solo reduce ValidationScore, por lo que un documento que por lo demás es sólido aún se enruta. La deducción es un presupuesto fijo compartido entre los campos opcionales en lugar de una penalización plana por campo: con tres campos opcionales y el presupuesto de 0.4 en el código anterior, un campo faltante deja la puntuación en 0.87 y dos la dejan en 0.73, todavía por encima del umbral de enrutamiento automático de 0.7, por lo que solo perder los tres la reduce a 0.60 y envía el documento a revisión. Mantener esas dos señales separadas es lo que reserva la revisión humana para los documentos que realmente la necesitan.
3.4 Orquestar la canalización
El método de orquestación conecta las etapas y toma decisiones de enrutamiento según la confianza de la validación:
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Cada etapa es comprobable de forma independiente, tiene su propio manejo de errores y produce salida de auditoría. El PipelineResult devuelto también registra el resultado de la etapa 4 en Status, lo que permite que el informe por lotes de la siguiente sección cuente los documentos por resultado en lugar de volver a derivarlo de la carga de validación. En este ejemplo, el agente de IA maneja la clasificación y la extracción mediante instrucciones en lenguaje natural, mientras que la validación y el enrutamiento siguen siendo lógica determinista de C#.
4. Procesamiento por lotes y de múltiples documentos
Una canalización de un solo documento es un punto de partida. Los sistemas IDP de producción procesan cientos o miles de documentos diariamente, con tipos, prioridades y destinos posteriores variables.
Procesamiento por lotes en paralelo
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
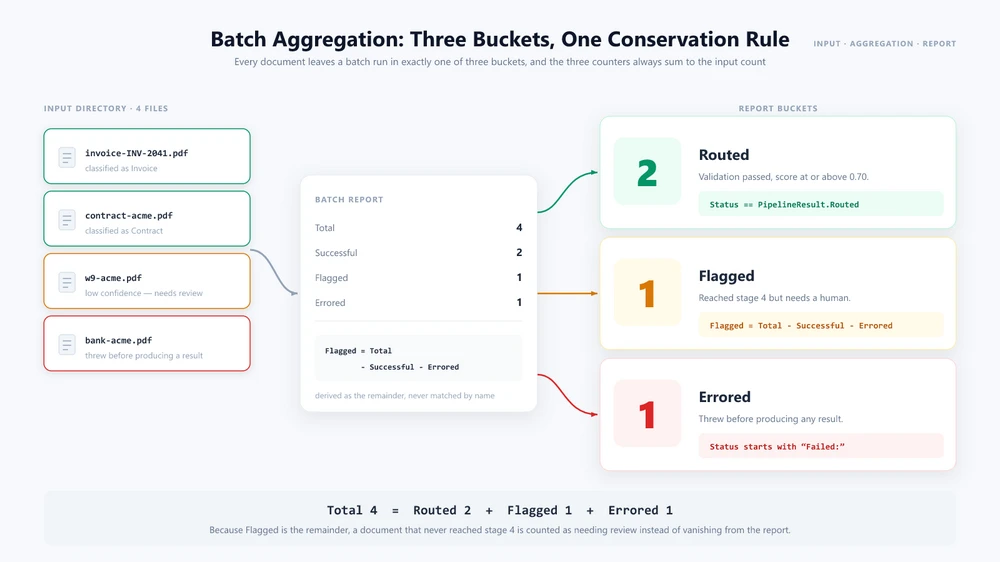
El SemaphoreSlim limita la concurrencia para evitar sobrecargar el servicio de IA o los sistemas posteriores. Cada documento se procesa de forma independiente a través de las cuatro etapas. El informe por lotes clasifica los resultados en las tres formas en que un documento puede salir de la canalización: Routed (validado y enviado posteriormente), Flagged (alcanzó la etapa 4 pero necesita revisión) y Errored (generó una excepción antes de producir un resultado). Flagged se calcula como el resto en lugar de coincidir con una cadena de estado, por lo que los tres contadores siempre suman Total: un documento que falla inesperadamente se informa como que necesita revisión en lugar de desaparecer del informe. El límite de concurrencia adecuado depende de los límites de velocidad del servicio de IA, el tamaño del documento y los recursos de la aplicación.
Flujos de trabajo entre documentos
Algunos procesos de negocio requieren que se procesen varios documentos juntos. Un flujo de trabajo de incorporación de proveedores de EE. UU., por ejemplo, podría procesar un formulario fiscal, un contrato y un extracto bancario como una sola unidad: extraer datos de cada uno, validarlos de forma cruzada y producir una salida combinada.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
El parámetro attachments pasa varias rutas de documentos al agente en una sola llamada. El agente lee todos los archivos adjuntos, razona entre ellos y produce una salida combinada. Esto va más allá del papel de reconocimiento de texto del OCR tradicional al permitir que un modelo de IA razone sobre múltiples entradas de documentos.
Reintentos y revisión humana
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
Los documentos que no superan la validación o quedan por debajo del umbral de confianza se marcan para revisión humana en lugar de fallar silenciosamente. La estrategia de reintentos utiliza retroceso exponencial para errores transitorios y vuelve a intentar casos límite ante la posibilidad de que una segunda pasada los clasifique o extraiga de manera diferente.
5. IDP en la práctica
Esta sección muestra cómo la canalización maneja escenarios de negocio reales que involucran múltiples tipos de documentos en un solo flujo de trabajo.
Automatización de cuentas por pagar
Un departamento de cuentas por pagar recibe facturas en formatos mixtos: PDF, Excel, Word, imágenes escaneadas. Cada factura debe clasificarse, extraerse, validarse contra una orden de compra y enrutarse al sistema ERP.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
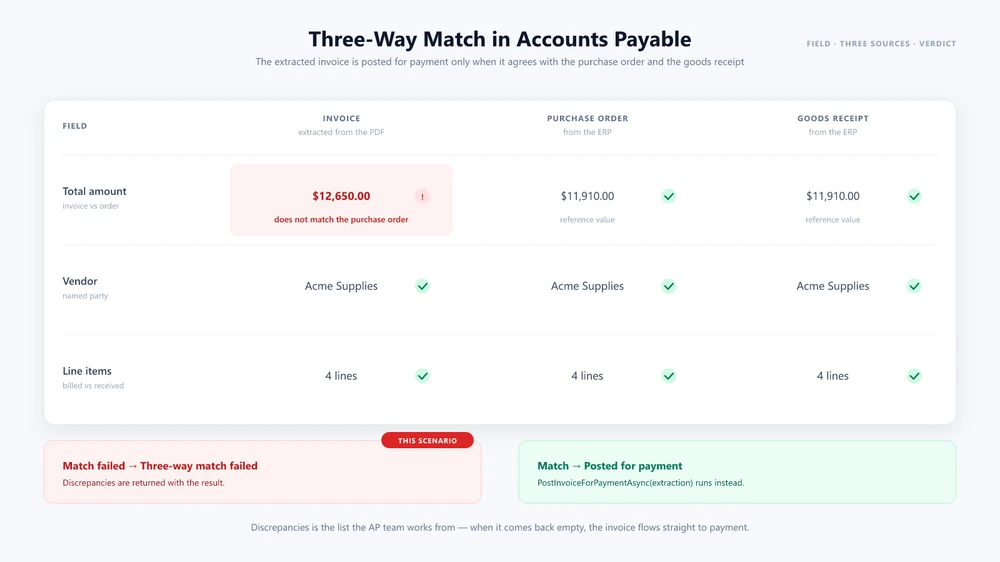
El tutorial de procesamiento de facturas cubre este escenario de principio a fin: la instrucción de extracción, la comparación con la orden de compra y el informe que consume el sistema financiero.
Análisis de contratos
Un equipo legal recibe contratos de terceros. Cada contrato debe analizarse, extraer los términos clave, compararse con la plantilla estándar de la empresa y enrutarse para revisión si se encuentran cláusulas no estándar. El agente procesa el contrato entrante con la plantilla estándar adjunta como documento de referencia.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Este flujo de trabajo combina extracción, comparación entre documentos y generación de documentos en un solo proceso, lo que ilustra cómo un agente de IA puede extender una canalización IDP tradicional más allá de la extracción de campos estructurados. Los patrones específicos de contratos —revisión, extracción y generación a partir de una plantilla— se tratan en la guía de revisión de contratos con IA.
6. Crear vs. comprar: elegir un enfoque de IDP
El mercado de IDP está dominado por plataformas SaaS. Esta sección ayuda a los desarrolladores a decidir cuándo construir una canalización en .NET es la elección correcta y cuándo adoptar una plataforma de proveedor es más práctico.
Cree cuando necesite una integración estrecha con una aplicación .NET existente, reglas de validación personalizadas o generación y transformación de documentos junto con la extracción. Construir la capa de orquestación en .NET le brinda mayor control sobre dónde se almacenan los documentos y cómo se procesan. La residencia real de los datos depende del modelo de IA y la configuración del servicio.
Compre cuando las cargas de trabajo con mucho OCR, los modelos de extracción preconstruidos, la infraestructura gestionada o el despliegue rápido sean la prioridad. Si su equipo no tiene experiencia en .NET o está enfocado en otras prioridades, una plataforma gestionada elimina la carga de implementación.
Marco de decisión:
| Factor | Crear (.NET + agente de IA) | Comprar (IDP SaaS) |
|---|---|---|
| Integración | En proceso, nativo de .NET | Llamada a API externa |
| Residencia de datos | Depende de la configuración del modelo | Nube del proveedor |
| Operaciones con documentos | Extraer + generar + transformar + convertir | Depende de la plataforma |
| Validación personalizada | Control total del código | Configuración de la plataforma |
| Flujo de trabajo personalizado | Control total del código | Depende de la plataforma |
| Tiempo hasta producción | Semanas a meses | Días a semanas |
| Modelo de costos | Costo fijo de API + licencia del SDK | Precio por documento |
La elección correcta depende de los requisitos de su aplicación, las capacidades del equipo y los tipos de documentos que procesa. Muchos equipos utilizan un enfoque híbrido: una plataforma de proveedor para la extracción de gran volumen de formularios estandarizados y una canalización .NET personalizada para flujos de trabajo complejos que requieren generación de documentos, razonamiento entre documentos o una integración estrecha con el sistema.
7. Preguntas frecuentes
¿Qué es el procesamiento inteligente de documentos (IDP)?
El procesamiento inteligente de documentos es un enfoque de automatización que utiliza IA y aprendizaje automático para clasificar documentos, extraer datos estructurados, validar los resultados según reglas de negocio y enrutar la salida a sistemas posteriores. A diferencia del OCR tradicional, que principalmente convierte contenido visual en texto legible por máquina, el IDP añade clasificación de documentos, extracción semántica, validación y automatización de flujos de trabajo. Puede manejar diseños de documentos variados sin depender por completo de plantillas fijas.
¿En qué se diferencia una canalización IDP de una sola llamada a la API de un LLM?
Una sola llamada a un LLM procesa texto, pero no maneja formatos de archivo, ejecuta operaciones con documentos ni gestiona el estado de la canalización. Una canalización IDP orquesta múltiples etapas —clasificación, extracción, validación, enrutamiento—, cada una con manejo de errores independiente, lógica de reintento y registro de auditoría. La canalización también conecta el razonamiento de IA con la manipulación determinista de archivos, asegurando que la salida conserve el formato correcto.
¿Puedo construir una canalización IDP sin una plataforma de proveedor?
Sí. Con un SDK de agente de IA para .NET como Spire.Agent.Office, puede implementar las cuatro etapas de la canalización en C#. El SDK proporciona procesamiento de documentos en lenguaje natural para archivos de Word, Excel, PowerPoint y PDF, con salida de archivos determinista. Este enfoque brinda control total sobre la lógica de validación y las reglas de enrutamiento.
¿Qué formatos de documento maneja una canalización IDP?
Con Spire.Agent.Office, la canalización maneja archivos de Word (.docx, .doc), Excel (.xlsx, .xls), PowerPoint (.pptx, .ppt) y PDF. Los documentos escaneados pueden requerir un paso de OCR antes de la extracción basada en IA, según el documento y el flujo de trabajo de procesamiento. La canalización también puede convertir entre formatos como parte de la etapa de enrutamiento.
¿Cómo se conecta el agente de IA al modelo de lenguaje?
Spire.Agent.Office utiliza una propiedad SpireToken en AIOptions para autenticarse con el servicio de IA. El SDK gestiona la conexión con el servicio de IA a través de AIOptions, por lo que la aplicación no necesita implementar directamente la integración con la API del modelo subyacente. Este diseño separa el procesamiento de documentos de la configuración del modelo, por lo que el código de su canalización permanece igual independientemente del modelo que impulse el agente.
¿Qué precisión tiene la extracción de documentos basada en IA?
La precisión de la extracción depende en gran medida de la calidad del documento, la variabilidad del diseño, la calidad del OCR, el comportamiento del modelo y las instrucciones de extracción. Los sistemas de producción deben validar los valores extraídos contra reglas de negocio deterministas y enrutar los casos inciertos para revisión humana. La etapa de validación ayuda a que la extracción basada en IA sea más fiable en producción al verificar los valores extraídos contra reglas deterministas y enrutar los resultados inciertos para revisión.
¿Cuál es la diferencia entre IDP y OCR?
El OCR (Reconocimiento óptico de caracteres) convierte el contenido visual de un documento en texto legible por máquina. El IDP se basa en esta capacidad, pero añade comprensión impulsada por IA, validación y automatización de flujos de trabajo. Una canalización IDP puede usar OCR internamente para documentos escaneados, pero el OCR por sí solo no clasifica documentos, no valida datos extraídos ni enruta resultados a sistemas posteriores.
¿Cómo funciona el procesamiento por lotes en una canalización IDP?
El procesamiento por lotes ejecuta la canalización de forma concurrente en múltiples documentos, con límites de concurrencia configurables para gestionar el uso de recursos. Cada documento se procesa de forma independiente a través de las cuatro etapas, con resultados agregados en un informe por lotes. Los documentos fallidos se marcan para revisión sin bloquear el resto del lote.
¿Listo para construir una canalización IDP?
Si está construyendo procesamiento inteligente de documentos en una aplicación .NET, comience con la guía de introducción de Spire.Agent.Office, que cubre la instalación del SDK y la ejecución de su primera instrucción en .NET.
Lecturas adicionales
- Agente de IA vs. API de LLM sin procesar: capa de documentos en .NET — qué añade una capa de documentos sobre una llamada a la API de un LLM sin procesar, y cuándo encaja cada enfoque
- Convertir documentos en presentaciones de PowerPoint con IA en C# — el mismo patrón basado en instrucciones aplicado a la salida de diapositivas