Los documentos utilizados en servicio al cliente, finanzas, recursos humanos y flujos de trabajo legales suelen contener nombres, direcciones de correo electrónico, números de teléfono, direcciones particulares, números de cuenta y otra información confidencial. Antes de que estos archivos puedan compartirse, archivarse o utilizarse para su análisis, es posible que sea necesario eliminar o reemplazar el contenido identificativo.
Los programas de censura tradicionales se basan en reglas de búsqueda predefinidas y en una lógica de procesamiento independiente para cada formato de documento. Un SDK de agente de IA ofrece otro enfoque: los desarrolladores pueden describir el requisito de censura en lenguaje natural, lo que permite al agente identificar la información confidencial y modificar los elementos correspondientes del documento de Office. Este artículo demuestra cómo censurar archivos de Word, Excel y PowerPoint en C# conservando su estructura y formato originales.
¿Qué es la censura de documentos?
La censura de documentos es el proceso de eliminar o reemplazar información que no debe divulgarse. Los objetivos de censura más habituales incluyen:
- Nombres de personas
- Direcciones de correo electrónico
- Números de teléfono y fax
- Direcciones particulares o postales
- Fechas de nacimiento
- Identificadores de clientes y empleados
- Números de banco y de cuenta
- Otra información confidencial o de identificación personal
Para los archivos de Office editables, la censura implica más que cambiar texto sin formato. El contenido confidencial puede aparecer en párrafos y tablas de Word, celdas de Excel, formas de PowerPoint, encabezados, pies de página u otros elementos del documento. Un flujo de trabajo de censura útil debe eliminar el valor detectado sin modificar innecesariamente el diseño circundante, los estilos, las imágenes, los gráficos ni la estructura del documento.
Tres formas de censurar documentos de Office en C#
Existen tres enfoques generales de implementación: las API de documentos tradicionales, una integración directa con un LLM y un SDK de agente de IA.
Censura tradicional basada en API
Una implementación tradicional normalmente comienza con el reemplazo exacto de texto o con expresiones regulares. Por ejemplo, Spire.Doc for .NET proporciona API para buscar y reemplazar texto en documentos de Word.
El siguiente pseudocódigo simplificado ilustra un flujo de trabajo de censura basado en reglas. Es intencionalmente incompleto y solo muestra las responsabilidades principales que la aplicación tendría que gestionar.
Document document = new Document();
document.LoadFromFile("Input.docx");

// Patterns must be defined and maintained by the developer.
Regex emailPattern = new Regex("...");
Regex phonePattern = new Regex("...");
Regex accountPattern = new Regex("...");

document.Replace(emailPattern, "[REDACTED]");
document.Replace(phonePattern, "[REDACTED]");
document.Replace(accountPattern, "[REDACTED]");

// Additional logic may still be required for different content containers.
foreach (Section section in document.Sections)
{
    ProcessParagraphs(section);
    ProcessTables(section.Tables);
    ProcessHeadersAndFooters(section.HeadersFooters);
    ProcessTextBoxes(section);
}

document.SaveToFile("Redacted.docx", FileFormat.Docx);
Este enfoque funciona bien cuando los valores confidenciales siguen patrones predecibles. Las direcciones de correo electrónico, los números de teléfono y los números de identificación estandarizados a menudo pueden encontrarse con expresiones regulares.
La dificultad aumenta cuando la información depende del contexto. Un programa puede necesitar determinar si una palabra es el nombre de una persona, si un número es un número de cuenta o un número de factura, y si una ubicación es una dirección privada o la dirección pública de una empresa. Los desarrolladores también deben añadir una lógica diferente de recorrido y reemplazo para Word, Excel y PowerPoint.
Integración directa con un LLM
Un modelo de lenguaje de gran tamaño puede comprender el contexto de manera más eficaz que un conjunto de expresiones regulares. Por ejemplo, puede reconocer el nombre de una persona en una oración incluso cuando el nombre no sigue un patrón predecible.
Sin embargo, un LLM no proporciona automáticamente un procesamiento completo de documentos de Office. Una integración directa normalmente requiere que la aplicación:
- Extraiga texto de cada elemento relevante del documento.
- Divida el contenido en solicitudes adecuadas.
- Envie el texto extraído al modelo.
- Asigne los resultados del modelo de vuelta a los párrafos, celdas o formas originales.
- Reemplace el contenido confidencial sin perder su formato.
- Guarde el archivo modificado en su formato original.
Si el documento se convierte a texto sin formato antes de enviarlo al modelo, se puede perder información sobre tablas, rangos de texto, fuentes, alineación y otras propiedades de diseño. Por lo tanto, el desarrollador sigue siendo responsable de conectar los resultados semánticos del modelo con el modelo de objetos del documento de Office.
SDK de agente de IA
Un SDK de agente de IA combina la comprensión del lenguaje natural con capacidades de procesamiento de documentos. En lugar de definir cada regla de detección y coordinar manualmente cada paso de reemplazo, el desarrollador proporciona el documento y describe el resultado deseado.
Spire.Agent.Office utiliza las capacidades subyacentes de Spire.Office for .NET para trabajar con objetos de Word, Excel y PowerPoint. En un documento de Word, por ejemplo, la capa de procesamiento puede acceder a secciones, párrafos, rangos de texto, tablas, celdas, encabezados, pies de página, imágenes, hipervínculos y su formato. El modelo identifica el contenido confidencial, mientras que las API de documentos modifican los elementos correspondientes.
Este procesamiento a nivel de objeto es lo que hace posible reemplazar texto conservando la estructura y los estilos que rodean el documento.
API tradicional vs. LLM vs. SDK de agente de IA
| Enfoque | Detección contextual | Conservación del formato | Implementación multiformato | Esfuerzo de desarrollo | Más adecuado para |
|---|---|---|---|---|---|
| API tradicional y expresiones regulares | Limitada a menos que se añada lógica NLP adicional | Sólida y controlable | Normalmente se requiere lógica independiente | Alto | Patrones fijos y reglas altamente deterministas |
| API de Office con llamadas directas a un LLM | Sólida | Debe ser implementada por el desarrollador | Se requiere lógica de extracción y reescritura para cada formato | Muy alto | Flujos de trabajo de IA totalmente personalizados |
| SDK de agente de IA | Sólida | Gestionada mediante un procesamiento consciente del documento | Se puede aplicar una instrucción común a varios formatos de Office | Menor | Censura contextual con menos código de orquestación |
El enfoque tradicional sigue siendo útil cuando cada objetivo de censura sigue un patrón conocido y la aplicación requiere un comportamiento estrictamente determinista. El enfoque del SDK de agente resulta más atractivo cuando los documentos contienen información variada y contextual, o cuando el mismo flujo de trabajo debe admitir varios formatos de Office.
Configurar el proyecto de C#
Cree una aplicación de consola de C# y añada Spire.Agent.Office y sus dependencias necesarias al proyecto. También necesitará un SpireToken válido para el procesamiento con IA.
El ejemplo siguiente admite los siguientes formatos:
- Word: DOC y DOCX
- Excel: XLS y XLSX
- PowerPoint: PPT y PPTX
PDF no se incluye en este ejemplo.
Censurar documentos de Word, Excel y PowerPoint con un agente de IA
El siguiente código determina el formato de origen a partir de su extensión, carga el objeto de documento de Office adecuado y pasa la misma instrucción de censura al procesador de IA.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Presentation;
using Spire.Doc;
using Spire.Xls;

string inputPath = @"E:\Documents\Input.docx";
string outputPath = @"E:\Documents\Redacted.docx";
string spireToken = "your spireToken";

string instruction = """
Find personal information such as names, email addresses, phone numbers, addresses,
account numbers, and other sensitive information. Replace the detected content with
“[REDACTED]” while preserving the original document structure and formatting.
""";

// Configure the AI processing options
AIOptions options = new AIOptions();
options.SpireToken = spireToken;

// Select the appropriate document object according to the file extension
string extension = Path.GetExtension(inputPath).ToLower();

if (extension == ".doc" || extension == ".docx")
{
    using (Document document = new Document())
    {
        document.LoadFromFile(inputPath);
        AIDocumentProcessor processor = document.AI(options);
        processor.ExecuteInstruction(
            document,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".xls" || extension == ".xlsx")
{
    using (Workbook workbook = new Workbook())
    {
        workbook.LoadFromFile(inputPath);
        AIDocumentProcessor processor = workbook.AI(options);
        processor.ExecuteInstruction(
            workbook,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".ppt" || extension == ".pptx")
{
    using (Presentation presentation = new Presentation())
    {
        presentation.LoadFromFile(inputPath);
        AIDocumentProcessor processor = presentation.AI(options);
        processor.ExecuteInstruction(
            presentation,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
Si los usings globales implícitos están deshabilitados en su proyecto, añada también using System; y using System.IO; para Array y Path.
Definir la entrada, la salida y la instrucción
inputPath especifica el documento de origen, mientras que outputPath especifica dónde se guardará el archivo censurado. Las extensiones de entrada y salida deben coincidir para que el resultado permanezca en el formato original.
La instrucción en lenguaje natural define tanto el alcance de la detección como la modificación requerida. En este ejemplo, el agente busca tipos comunes de información personal y los reemplaza por [REDACTED].
Puede ajustar la instrucción para un flujo de trabajo más específico. Por ejemplo:
Find email addresses, phone numbers, and customer account numbers. Replace each detected value with “[REDACTED]”. Do not redact company names, product names, invoice numbers, or dates. Preserve the original layout and formatting.
Añadir exclusiones explícitas puede reducir los falsos positivos cuando un documento contiene identificadores comerciales que se asemejan a números de cuenta personales.
Configurar el procesamiento con IA
AIOptions almacena el SpireToken utilizado por el servicio de procesamiento de IA:
AIOptions options = new AIOptions();
options.SpireToken = spireToken;
El mismo objeto de opciones se puede utilizar con la instancia de documento de Word, Excel o PowerPoint.
Seleccionar el tipo de documento adecuado
El programa lee la extensión del archivo y crea el objeto correspondiente:
-
Documentpara archivos de Word -
Workbookpara archivos de Excel -
Presentationpara archivos de PowerPoint
Cada objeto expone el método de extensión AI(). Este devuelve un AIDocumentProcessor, que ejecuta la instrucción en lenguaje natural sobre el documento cargado.
La matriz de archivos adjuntos vacía indica que la instrucción no requiere ningún archivo de apoyo:
processor.ExecuteInstruction(
    document,
    instruction,
    outputPath,
    Array.Empty<string>());
Resultado de la censura
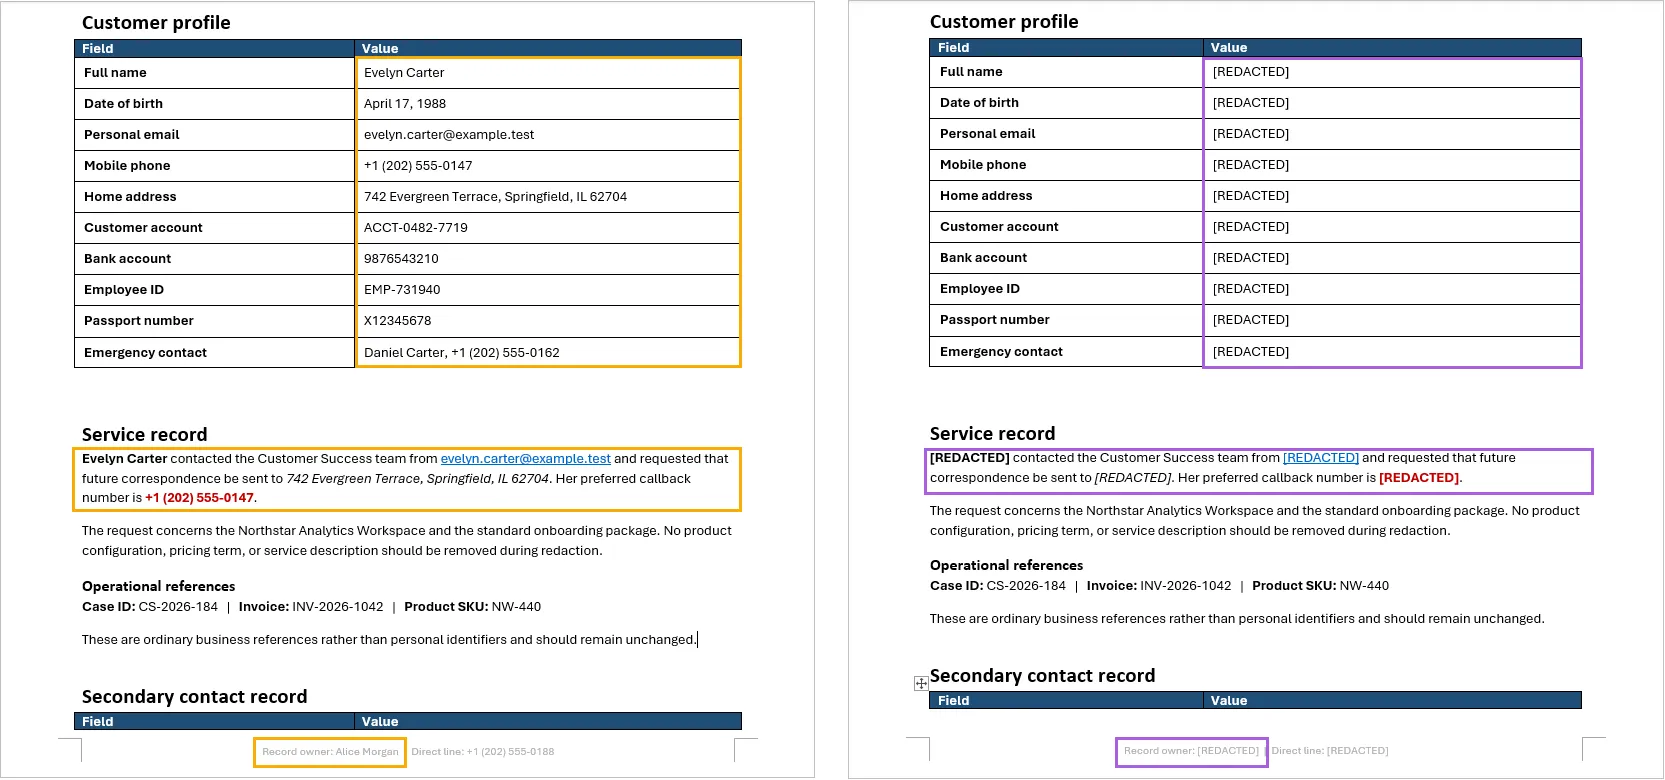
En el documento de prueba de Word, la información confidencial aparecía en párrafos normales, en una tabla de información de clientes y en el pie de página. Tras el procesamiento, los nombres, las direcciones de correo electrónico, los números de teléfono, las direcciones y la información de cuentas se reemplazaron por [REDACTED].
La estructura de la tabla, el formato de los párrafos, los encabezados, los colores y el diseño del pie de página se mantuvieron en su lugar. Este resultado es importante porque demuestra que el flujo de trabajo no se limita a extraer el documento como texto sin formato y reconstruirlo desde cero. Modifica los elementos relevantes del documento conservando su estructura circundante.
Consideraciones importantes para la censura con IA
Revisar el resultado antes de compartirlo
La censura con IA no es perfectamente determinista. Un modelo puede pasar por alto un identificador poco común o clasificar incorrectamente contenido común como confidencial. Los documentos destinados a su distribución externa deben revisarse después del procesamiento, especialmente en flujos de trabajo legales, financieros, sanitarios o sensibles al cumplimiento normativo.
Hacer que la instrucción sea específica
La instrucción debe describir tanto lo que debe eliminarse como lo que debe permanecer. Si los números de factura, los nombres de empresas, los códigos de producto o las direcciones de oficinas públicas no deben censurarse, indique esas exclusiones de forma explícita.
El reemplazo visible no siempre es una sanitización completa
Reemplazar el texto visible no elimina necesariamente todas las copias de la información del archivo. Los datos confidenciales también pueden aparecer en:
- Comentarios y cambios registrados
- Propiedades del documento y metadatos
- Hojas de cálculo u diapositivas ocultas
- Notas del orador de PowerPoint
- Archivos y objetos incrustados
- Imágenes que contienen texto
- Versiones anteriores o copias de seguridad
Para flujos de trabajo de alta seguridad, estas ubicaciones deben inspeccionarse por separado. Si un documento contiene páginas escaneadas o capturas de pantalla, puede ser necesario aplicar OCR antes de poder evaluar el texto que contienen las imágenes.
Preservar el archivo original
Guarde el resultado censurado en una nueva ruta en lugar de sobrescribir el documento de origen. Mantener los archivos separados facilita la comparación del resultado, la investigación del contenido no detectado y la repetición del proceso con una instrucción mejorada.
Conclusión
La censura tradicional basada en API ofrece un control preciso, pero los desarrolladores deben definir reglas de detección y mantener una lógica de recorrido independiente para los distintos formatos de documento y contenedores de contenido. La integración directa con un LLM mejora el reconocimiento contextual, pero aún requiere una capa considerable de extracción, asignación y reescritura para conservar el formato de Office.
Un SDK de agente de IA reúne estas capacidades. Con una sola instrucción en lenguaje natural y una pequeña cantidad de código C#, el mismo flujo de trabajo puede procesar archivos de Word, Excel y PowerPoint, identificar información confidencial contextual y reemplazarla dentro de la estructura del documento original. El resultado aún debe revisarse, pero la implementación es considerablemente más sencilla que construir manualmente todo el proceso de detección y orquestación de documentos.
Preguntas frecuentes
¿Puede el mismo código censurar archivos de Word, Excel y PowerPoint?
Sí. El ejemplo selecciona Document, Workbook o Presentation según la extensión del archivo de entrada y aplica la misma instrucción en lenguaje natural a cada formato.
¿El agente de IA conserva el formato original?
El agente trabaja con los objetos subyacentes del documento de Office, lo que permite reemplazar el texto confidencial dentro de párrafos, celdas, tablas y formas conservando la estructura y el formato circundantes. El resultado final debe verificarse de todos modos, ya que los diseños inusualmente complejos pueden requerir una verificación adicional.
¿Puedo usar una etiqueta de censura diferente?
Sí. Cambie [REDACTED] en la instrucción por otra etiqueta, como [PRIVATE], [REMOVED] o un valor específico de categoría como [EMAIL REDACTED].
¿Cuándo es mejor una API tradicional que la censura con IA?
Una API tradicional puede ser preferible cuando cada valor confidencial sigue un patrón fijo, las reglas rara vez cambian y el resultado debe ser completamente determinista. El reemplazo con expresiones regulares suele ser suficiente para direcciones de correo electrónico, números de teléfono o números de identificación estandarizados.
¿Reemplazar el texto garantiza que el documento sea seguro para publicar?
No. El reemplazo del texto visible no elimina automáticamente los comentarios, los cambios registrados, los metadatos, el contenido oculto, los objetos incrustados, el texto dentro de las imágenes ni las versiones anteriores del archivo. Los documentos sensibles desde el punto de vista de la seguridad requieren una inspección y validación adicionales antes de su publicación.