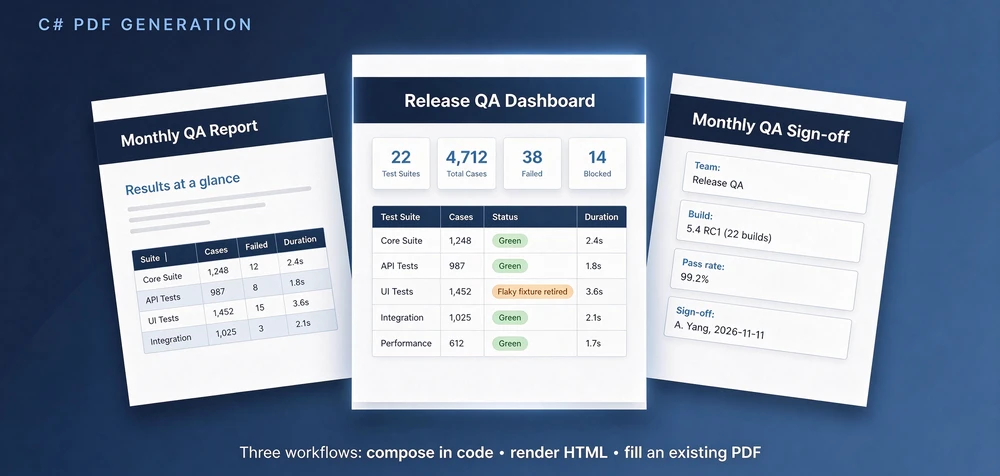
Sie können in C# ein PDF-Dokument aus Anwendungsdaten, aus einer HTML-Seite oder durch Ausfüllen eines bereits vorhandenen PDFs erzeugen. Jeder Ausgangspunkt führt zu einem anderen Workflow, und die Wahl hängt von der Layoutkontrolle, der Paginierung bei wachsendem Inhalt, den Rendering-Abhängigkeiten, die der Zielrechner mitbringen muss, und der Art und Weise ab, wie Sie die Ausgabe überprüfen.
Die folgenden Abschnitte ordnen die Workflows von Spire.PDF for .NET nach dem Material, mit dem Sie beginnen, und berichten, was jeder Workflow im Test geleistet hat – einschließlich der Punkte, die schiefgingen. Getestet mit Spire.PDF for .NET 12.11.0 (November 2026, Windows 11 Pro, .NET 10-Konsolenanwendung).
Schnellnavigation
- Mit dem beginnen, was Sie bereits haben
- PDFs aus Anwendungsdaten erzeugen
- HTML und CSS in PDF konvertieren
- Mit vorhandenen PDF-Formularen und Vorlagen arbeiten
- Bereitstellung und Ausgab validierung
- FAQ
- Fazit
1. Mit dem beginnen, was Sie bereits haben
Beginnen Sie mit dem Material, das Ihr Programm zur Laufzeit enthält: Datensätze aus einer Abfrage, eine HTML-Seite oder ein PDF, das jemand anderes entworfen hat. Die Tabelle ordnet jede Eingabe einem Workflow zu.
| Klasse | Eingabe zur Laufzeit | Workflow |
|---|---|---|
| Neues PDF erstellen | Anwendungsdaten / strukturierte Daten | Koordinatenbasiertes oder natives Flusslayout |
| Neues PDF erstellen | HTML/CSS-Seite oder Vorlage | HTML-zu-PDF-Rendering |
| Vorhandenes PDF | Ausfüllbares Formular (AcroForm) | Ausfüllen von Formularfeldern |
| Vorhandenes PDF | Ausfüllbares Formular (XFA) | Verarbeitung von XFA-Feldern |
| Vorhandenes PDF | Festes Layout mit Platzhaltertext | Textersetzung |
Die ersten beiden Zeilen erstellen ein neues PDF. Sie besitzen also das Layout und müssen entscheiden, wie Seiten umbrochen werden. Die letzten drei beginnen mit einem vorhandenen PDF, bei dem die Datei das Layout festlegt und die Aufgabe darin besteht, Werte an die dafür vorgesehenen Stellen zu bringen. Eine Aufgabe, in C# einen PDF-Bericht aus Abfrageergebnissen zu erzeugen – wie der in dieser Anleitung verwendete monatliche QA-Bericht –, beginnt in der ersten Zeile. Eine von einem Frontend-Team gepflegte HTML-Rechnungsvorlage beginnt in der zweiten, und ein von einem Lieferanten erhaltenes Formular beginnt in einer der letzten drei Zeilen.
Diese Anleitung behandelt die von Spire.PDF unterstützten Workflows, nicht eine vollständige Taxonomie sämtlicher C#-PDF-Techniken.
2. PDFs aus Anwendungsdaten erzeugen
Beim koordinatenbasierten Zeichnen wird jeder Textblock, jede Linie und jedes Bild an von Ihnen angegebenen Positionen platziert. Dies ermöglicht exakte Kontrolle über ein festes Design und benötigt außer der Bibliothek keine Rendering-Engine. Der Preis zeigt sich, wenn die Inhaltslänge variiert, denn dann wird die Paginierung zur Aufgabe Ihres Codes: Sie verfolgen, wo das letzte Element endete, fügen selbst Seiten hinzu und berechnen Positionen neu, wenn sich der Inhalt ändert. Ein kurzer Auszug zeigt das Muster.
var font = new PdfTrueTypeFont("Segoe UI", 11f, PdfFontStyle.Regular, true);
var layout = new PdfTextLayout { Layout = PdfLayoutType.Paginate };
PdfPageBase page = doc.Pages.Add();
float y = 40;

foreach (string text in summaryParagraphs)
{
    var r = new PdfTextWidget(text, font, PdfBrushes.Black)
        .Draw(page, new RectangleF(40, y, 500, 0), layout);
    page = r.Page;                  // the text may have flowed onto a new page
    y = r.Bounds.Bottom + 10;
    if (y > 760) { page = doc.Pages.Add(); y = 40; }   // you own the page breaks
}
Der entscheidende Schritt besteht darin, der Seite zu folgen, die das Layout-Ergebnis zurückgibt: Zeichnen Sie weiter auf der Seite, die das Widget meldet, und fügen Sie eine neue Seite hinzu, wenn der Rahmen den unteren Rand erreicht. Berichte, die aus einer DataTable erstellt werden, haben ihr eigenes DataTable-zu-PDF-Tutorial.
Das native Flusslayout nimmt Ihnen die Paginierung aus dem Code ab. PdfContentBuilder, verfügbar ab Spire.PDF for .NET 12.9.18, streamt Inhalte in Abschnitte und paginiert sie beim Wachsen. Es bietet Überschriften, Absätze, Tabellen aus einem string[][], Bilder, Listen, Codeblöcke, sechs Diagrammtypen, Seitenumbrüche und ein Inhaltsverzeichnis. Es erstellt nur neue Dokumente und besitzt keinen Einstiegspunkt zum Laden einer vorhandenen Datei.
Der folgende monatliche QA-Bericht verwendet zwei Abschnitte und eine Tabelle. summaryParagraphs, results (ein string[][] mit der Kopfzeile in der ersten Zeile) und closing stammen aus Ihrem eigenen Code.
using Spire.Pdf;
using Spire.Pdf.Layout;

PdfDocument doc = new PdfDocument();
PdfContentBuilder builder = new PdfContentBuilder(doc);

var s1 = builder.AddSection();
s1.AddHeading1("Monthly QA Report - October");
foreach (var p in summaryParagraphs) s1.AddParagraph(p);
s1.AddTable(results);            // string[][] rows; header row repeats on page breaks

var s2 = builder.AddSection();
s2.AddHeading1("Next Month Outlook");
s2.AddParagraph(closing);

builder.Build();
doc.SaveToFile("QA-Report.pdf");
doc.Dispose();
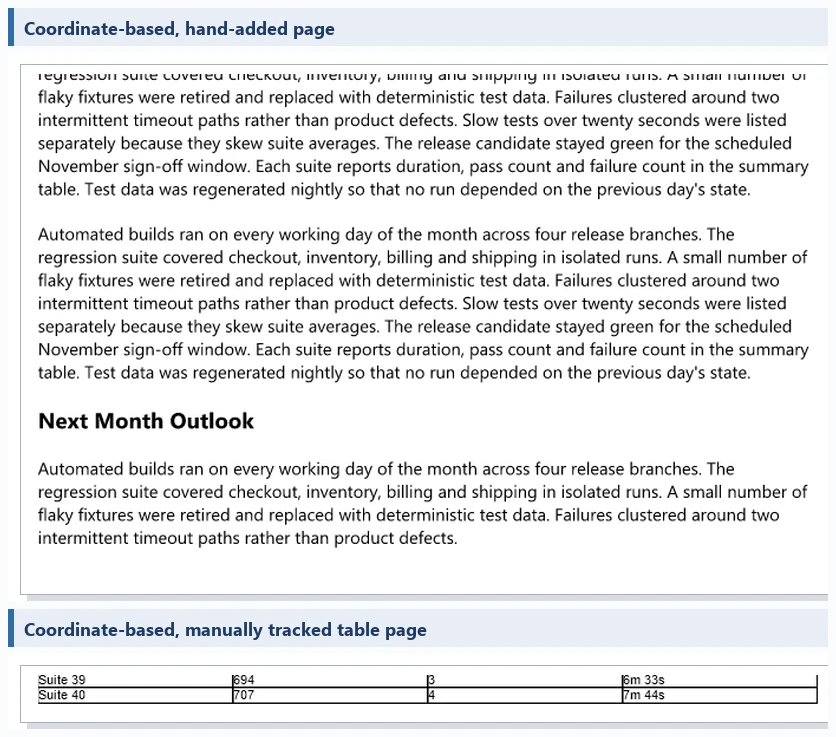
Der Inhaltsumfang unterscheidet die beiden Ansätze. Ein kleiner Bericht (zwei Abschnitte, eine Tabelle mit fünf Zeilen) ergab zwei Seiten in 676 ms. Ein größerer Bericht mit acht langen Absätzen und einer Tabelle mit 40 Zeilen wurde in fünf Seiten mit 1.369 ms paginiert (10,8 KB). Derselbe Inhalt mit Koordinaten gezeichnet ergab drei Seiten in 510 ms (28,7 KB). Diese Zeitangaben stammen von einem Windows-Rechner und dienen als Plausibilitätsprüfung für dieses Setup. Vergleichen Sie, wie die einzelnen Dateien aussehen, bevor Sie vergleichen, wie schnell sie erzeugt wurden.
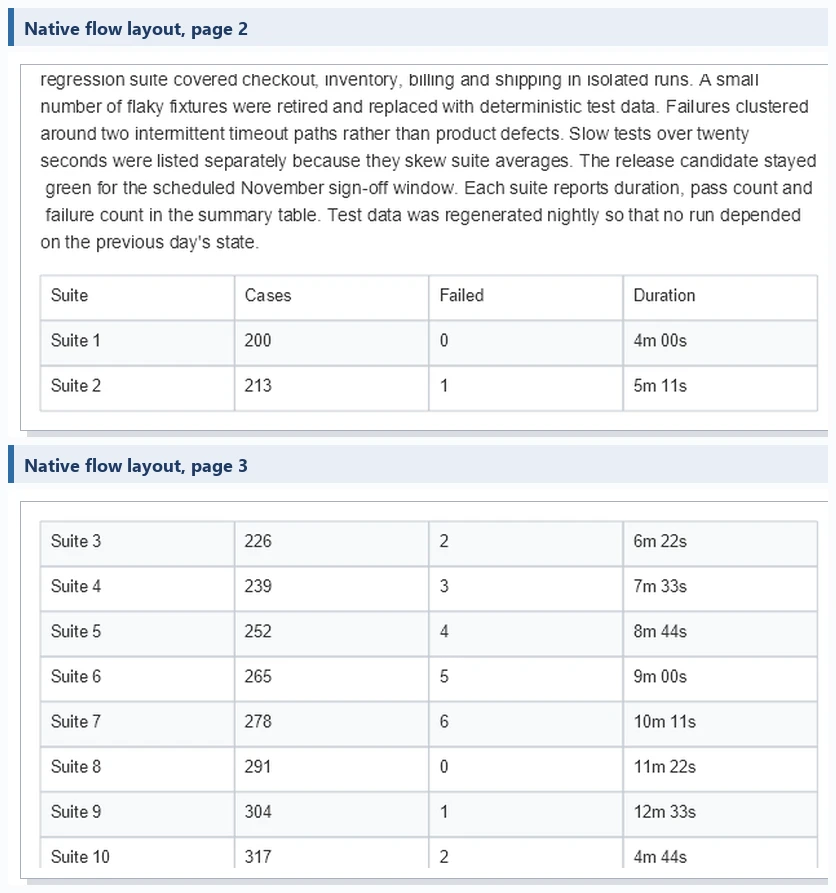
Koordinatenbasiertes Zeichnen eignet sich für Seiten, deren Struktur nicht vom Datenumfang abhängt. Das Flusslayout eignet sich für Dokumente, deren Länge den Daten folgt, etwa Berichte und Auflistungen. Entwickler, die den Weg des manuellen Zusammenstellens ausführlicher kennenlernen möchten, können mit dem Tutorial zum Erstellen eines PDF-Dokuments in C# beginnen.
Das native Flusslayout und das HTML-Rendering sind getrennte Mechanismen. Der Builder organisiert Inhalte über seine eigene API und liest kein CSS, während ein HTML-Renderer Markup und Stylesheets parst; daher unterscheiden sich Gestaltungsoptionen und Laufzeitanforderungen. Die Tabelle vergleicht alle Workflows in dieser Anleitung.
| Workflow | Layoutkontrolle | Dynamischer Inhalt | Externe Laufzeitanforderungen | Hauptbeschränkung |
|---|---|---|---|---|
| Koordinatenbasiert | Explizite Koordinaten, Element für Element | Sie verwalten Layout und Seitenumbruch selbst (PdfTextLayout.Paginate) |
Keine zusätzliche Rendering-Engine | Änderungen des Inhaltsumfangs erzwingen eine Überarbeitung der Koordinaten |
Natives Flusslayout (PdfContentBuilder, 12.9.18+) |
Streaming von Abschnitten, Überschriften und Absätzen | Streaming-Inhalte; automatische Paginierung im Test verifiziert | Keine zusätzliche Rendering-Engine | Nur Erstellung; der Elementumfang entspricht dem, was die API bietet (Tabellen, Bilder, Listen, Codeblöcke, Diagramme, Inhaltsverzeichnis) |
| HTML-zu-PDF | CSS plus eine Rendering-Engine | Eignet sich für HTML-getriebene Inhalte | Chromium (Chrome- oder Edge-Pfad) oder Qt-Rendering-Plugin | Hängt von der Rendering-Umgebung ab; CSS-Hintergründe unterscheiden sich je nach Engine |
| AcroForm-Ausfüllen | Layout der ursprünglichen Formularfelder | Ausfüllen nach Feldnamen | Keine zusätzliche Rendering-Engine | An die Felddefinitionen in der Datei gebunden |
| Ersetzung statischen Texts | Layout der ursprünglichen Seite | Ersetzung festen Texts | Keine zusätzliche Rendering-Engine | Kein allgemeines dynamisches Neulayout |
3. HTML und CSS in PDF konvertieren
Um in C# ein PDF aus HTML zu erzeugen, übergibt Spire.PDF die Seite an eine Rendering-Engine und speichert das Druckergebnis. Es stehen zwei Engines zur Verfügung. ChromeHtmlConverter steuert Chromium an und benötigt den Pfad zu einer ausführbaren Chrome- oder Edge-Datei. Die Qt-Option Spire.Additions.Qt.HtmlConverter hängt vom offiziellen Plugin-Paket ab, das HTMLConverter.dll, die Qt5-Laufzeit und Html2Pdf.exe enthält. Der Plugins-Ordner muss neben der ausführbaren Datei der Anwendung liegen. Fehlt er, schlägt der Aufruf mit Fail to load ...\plugins\HTMLConverter.dll : error 126 fehl.
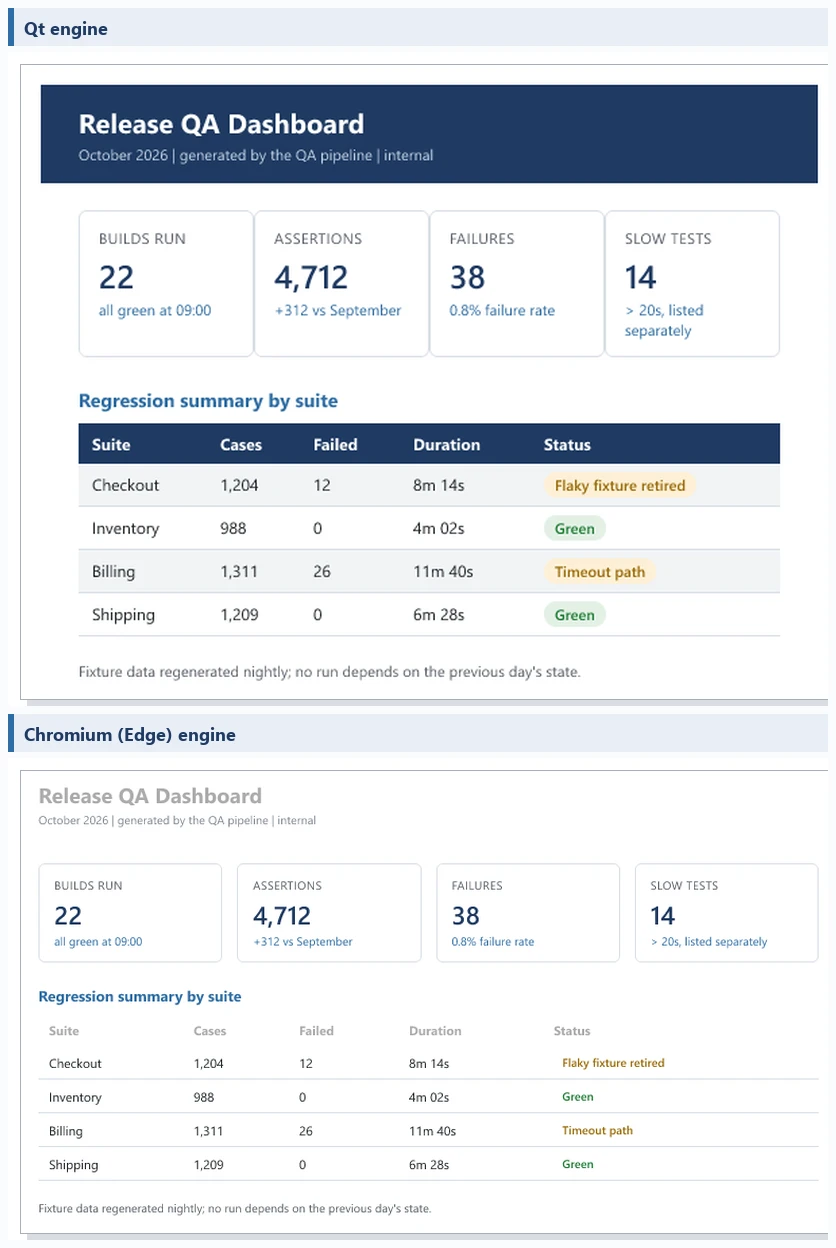
Im Test wurde dasselbe HTML durch beide Engines geschickt. Beide erzeugten zwei Seiten und berücksichtigten das CSS page-break-before. Der Qt-Lauf dauerte 4.398 ms und schrieb eine 60,6 KB große Datei mit intaktem dunkelblauem Hintergrund der Tabellenkopfzeile. Der Chromium-Lauf verwendete Edge 157.0.4341.42, A4-Papier und 0,4-Zoll-Ränder und nutzte den bereits auf dem Rechner vorhandenen Browser.
Die beiden Wege haben unterschiedliche Kompromisse. Qt verlangt eine separate Plugin-Installation, während Chromium eine vorhandene Chrome- oder Edge-Installation wiederverwendet. Jede Engine hat ihre eigenen Regeln für das Drucken von CSS-Hintergründen, und das Stylesheet entscheidet, was angefordert wird, beispielsweise mit print-color-adjust: exact. In einer Webanwendung sollte die Konvertierung als Hintergrundjob und nicht innerhalb der Anfrage ausgeführt werden.
Mehrere Punkte wurden nicht behandelt: Seiten, die zum Rendern JavaScript benötigen, externe Ressourcen, benutzerdefinierte Schriftarten, gleichzeitige Last auf einem Server sowie Linux oder Docker. Ein Konverter, der auf einem Entwicklungsrechner läuft, hat noch nicht gezeigt, dass er in einem Produktionscontainer läuft, und diese Anleitung hat Linux nicht verifiziert. Einen vollständigen Durchlauf für vorlagengesteuerte Seiten finden Sie unter ein PDF aus einer HTML-Vorlage in C# erzeugen.
4. Mit vorhandenen PDF-Formularen und Vorlagen arbeiten
Ein PDF in C# aus einer Vorlage zu erstellen, bedeutet zwei verschiedene Dinge, wenn die Vorlage bereits ein PDF ist. Ein ausfüllbares Formular enthält benannte AcroForm-Feldobjekte. Eine gestaltete Seite enthält möglicherweise nur Platzhaltertext, der wie ein leeres Feld aussieht. Auf dem Bildschirm sehen sie ähnlich aus, im Code verhalten sie sich unterschiedlich.
| Eigenschaft | AcroForm-Feld | Statischer Platzhaltertext |
|---|---|---|
| Existiert in der Datei als | Ein Feldobjekt mit eigenem Namen | Gewöhnlicher Seitentext |
| Lokalisiert durch | Feldnamen | Den Text selbst |
| Interaktivität | Bleibt bis zum Flatten erhalten | Nie interaktiv |
| Nach dem Flatten | Wert wird Seitentext | Nicht zutreffend |
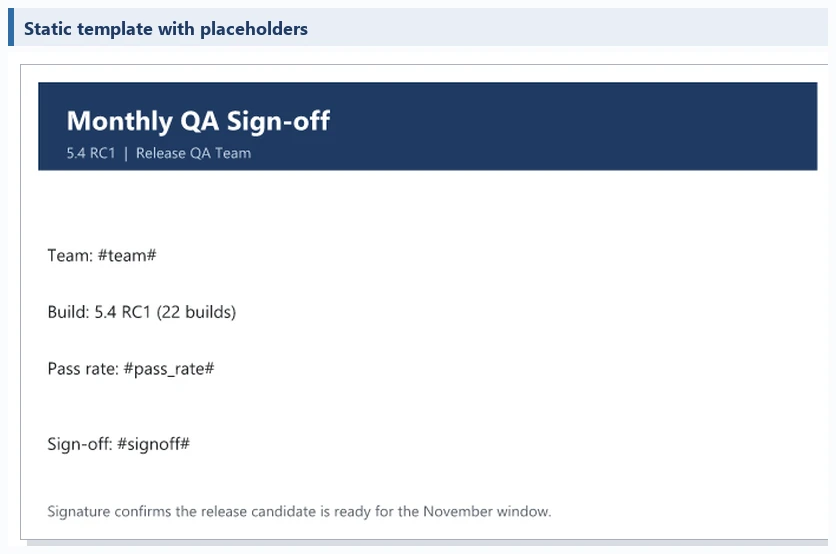
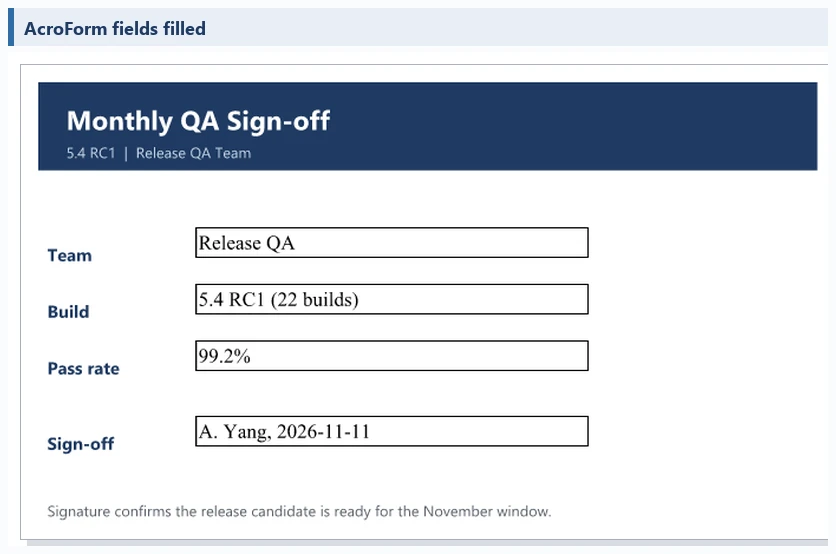
Ein echtes Feld wird anhand seines Namens lokalisiert, ausgefüllt und optional geflattet. Die AcroForm-API im Namespace Spire.Pdf.Interactive.Forms wurde in 12.10.7 eingeführt und mit 12.11.0 getestet.
using Spire.Pdf.Interactive.Forms;

PdfDocument doc = new PdfDocument();
doc.LoadFromFile("existing-form.pdf");
PdfForm form = PdfForm.Create(doc);
var field = form.GetField("team") as PdfTextField;
field.Text = "Release QA";
field.RefreshAppearances();     // without this the value is stored but renders invisible
form.Flatten();                 // after this the value sits in the page text layer
doc.SaveToFile("final.pdf");
Im Test traten drei Verhaltensweisen auf:
- Rufen Sie
RefreshAppearances()nach dem Festlegen vonTextauf, damit der Wert in das Erscheinungsbild des Felds gezeichnet wird und sofort sichtbar ist. - Werte in Feldern, die noch interaktiv sind, liegen in der Formularebene; nach dem Flatten ging die Feldanzahl von 4 auf 0 zurück, und die Werte gelangten in den Seitentext, wo
PdfTextExtractorsie liest. -
AddWidgetverwendet Koordinaten auf Seitenebene, währendpage.Canvas-Positionen relativ zu den Rändern sind; halten Sie die beiden Systeme beim Platzieren von Widgets auseinander.
Formulardaten können die Datei auch als XFDF verlassen, über form.ExportData(path, DataFormat.XFDF, ...), was im Test standardkonformes XFDF erzeugte. Das Tutorial zum Importieren und Exportieren von PDF-Formulardaten geht tiefer.
Fester Platzhaltertext funktioniert auf einer fertig gestalteten Seite, wenn die eingefügten Werte in ihrer Größe den ersetzten Markierungen nahekommen. Die Ersetzung behält das ursprüngliche Layout bei, prüfen Sie daher, ob jeder neue Wert in den Platz passt, den das Original gelassen hat.
XFA-Formulare sind ein eigener Formulartyp. Die dokumentierte Fähigkeit besteht darin, unterstützte Felder über das XFA-Formularobjekt zu lesen und zu ändern; validieren Sie den Workflow im Rahmen Ihrer Evaluierung mit eigenen Beispielen.
5. Bereitstellung und Ausgab validierung
Alles in dieser Anleitung lief auf einem Windows-Entwicklungsrechner. Linux, Docker und Server-Hosting wurden in dieser Anleitung nicht verifiziert. Die HTML-Engines benötigen andernorts die meiste Aufmerksamkeit: Der Chromium-Weg braucht eine ausführbare Browser-Datei auf dem Zielrechner, und der Qt-Weg benötigt seinen Plugins-Ordner neben der Anwendung. Spire.PDF veröffentlicht offizielle Plugin-Pakete für Linux und macOS. Testen Sie diese in Ihrem eigenen Bereitstellungs-Image, bevor Sie sich darauf verlassen, und messen Sie die Konvertierungszeit auf dem Zielhost, da die obigen Zeitangaben von einem Entwicklungsrechner stammen.
Probleme bei der Erzeugung lösen selten Ausnahmen aus: Die Datei wird erzeugt, und alles, was schiefgeht, zeigt sich nur in der Ausgabe selbst. Deshalb prüfen die folgenden Kontrollen die Datei, statt sich darauf zu verlassen, dass der Code fehlerfrei ausgeführt wurde.
| Prüfung | Was sie erkennt | Wie |
|---|---|---|
| Seitenanzahl | Paginierung, die zu lang lief, zu früh stoppte oder nie vorankam | check.Pages.Count |
| Textextraktion | Fehlende Titel oder Daten, zurückgebliebene Platzhaltermarkierungen |
PdfTextExtractor auf jeder Seite |
| Formularvalidierung | Werte, die nie ein Feld erreicht haben | Feldwerte über die API vor dem Flatten lesen; nach dem Flatten die Datei erneut öffnen und den sichtbaren Inhalt prüfen |
| Sichtprüfung | Textüberlauf, falsche Seitenumbrüche, ersetzte Schriftarten, fehlende Bilder | Das PDF öffnen und jede Seite ansehen |
PdfDocument check = new PdfDocument();
check.LoadFromFile("QA-Report.pdf");
Console.WriteLine(check.Pages.Count);                        // expected page count

string text = new PdfTextExtractor(check.Pages[0])
    .ExtractText(new PdfTextExtractOptions());               // titles, data, leftovers
Console.WriteLine(text.Contains("#"));                       // a stray placeholder marker
Die Textextraktion ersetzt nicht das Ansehen der Seiten. Sie bestätigt, dass Zeichen in der Datei vorhanden sind, und sagt nichts über Überlauf, Abschneiden oder einen Kopfzeilenhintergrund aus, der nicht gedruckt wurde. Passen Sie die Prüfungen an den Workflow an: Seitenanzahl und eine Sichtprüfung bei Koordinaten- und Flussausgaben, eine Sichtprüfung der Hintergründe bei HTML-Ausgaben und ein API-Rücklesen vor dem Flatten bei Formularen. Führen Sie bei Berichtsaufträgen die ersten drei Prüfungen in Ihrer Test-Pipeline aus und wiederholen Sie die Sichtprüfung, wenn sich Vorlage oder Layout ändern. Bewahren Sie eine bekannte gute Ausgabe pro Workflow auf und vergleichen Sie sie nach Bibliotheks-Upgrades, denn jedes Ergebnis hier ist an 12.11.0 gebunden.
6. FAQ
Was ist der Unterschied zwischen dem Erstellen und dem Generieren eines PDFs in C#?
Auf API-Ebene gibt es keinen. Beide Formulierungen beschreiben das Erzeugen einer PDF-Datei aus Code. Entscheidend ist die Eingabe: Anwendungsdaten, eine HTML-Seite oder ein vorhandenes PDF mit Feldern oder Platzhaltertext. Wählen Sie den Workflow anhand dieser Eingabe, wie die Entscheidungstabelle in dieser Anleitung zeigt.
Kann ich in C# ein PDF ohne Bibliothek erzeugen?
Technisch ja, denn PDF ist ein dokumentiertes Dateiformat, das Code direkt schreiben kann. In der Praxis fallen die Kosten für das Einbetten von Schriftarten, die Stream-Komprimierung, die Unterstützung der Textextraktion und die konsistente Darstellung in verschiedenen Viewern an. Jeder dieser Punkte erfordert eigenen Code und eigene Tests, und eine Bibliothek übernimmt diese Arbeit.
Wie wähle ich zwischen codebasierter Erstellung und HTML-Rendering?
Entscheiden Sie danach, wer das Layout besitzt. Wenn Entwickler es besitzen und die Daten die Struktur bestimmen, erstellen Sie das PDF im Code. Wenn Designer bereits das HTML und CSS pflegen, rendern Sie diese Seite und akzeptieren die Abhängigkeit von der Rendering-Engine. Wählen Sie Code, wenn Daten die Seite definieren, und HTML, wenn eine Seite die Ausgabe definiert.
7. Fazit
Anwendungsdaten deuten auf koordinatenbasiertes Zeichnen oder natives Flusslayout hin, und das Flusslayout paginierte sich im Test selbst. Eine HTML-Seite deutet auf eine Rendering-Engine hin, die im Test die Konvertierungszeit, das Drucken von Hintergründen und die Anforderungen an den Zielrechner veränderte. Ein vorhandenes PDF deutet auf Formularfelder hin, wo sie existieren, und auf Textersetzung, wo das Layout fest ist. Prüfen Sie die Seitenanzahl, den extrahierten Text und die gerenderten Seiten, bevor eine dieser Dateien ausgeliefert wird.
Wenn Sie Spire.PDF for .NET in einer realen Geschäftsumgebung testen möchten, können Sie eine temporäre Lizenz beantragen.