Eine PDF mit pypdf zu lesen ist eine Sache von zehn Minuten. Die Schwierigkeiten beginnen, wenn dasselbe Skript eine Übersichtstabelle von Seite eins holen, den Anhang entfernen, eine bearbeitbare Word-Kopie zurückgeben und das Archiv mit einem Passwort schützen soll. Für jede Anfrage gibt es eine gute Python-Antwort, aber sie stammen selten aus demselben Paket.
Dieser Leitfaden vergleicht sechs Optionen anhand eines Sets von Testdateien: pypdf, pdfplumber, PyMuPDF, pikepdf, reportlab und Spire.PDF for Python. Offenlegung: Spire.PDF ist ein kommerzielles Produkt von E-iceblue, dem Herausgeber dieses Artikels, und E-iceblue hat die Tests durchgeführt. Fixtures, Versionen und Timing-Methode sind im Abschnitt „So haben wir getestet“ aufgeführt, sodass Sie jedes Ergebnis nachvollziehen können. Jede der unten genannten Bibliotheken ist eine sinnvolle Wahl für die Aufgabe, für die sie entwickelt wurde.
Welche Python-PDF-Bibliothek sollten Sie wählen?
Wenn Ihre Arbeit aus einer einzigen Operation besteht, wählen Sie den Spezialisten dafür. Die Open-Source-Bibliotheken in diesem Vergleich sind stark in ihren jeweiligen Aufgaben. Spire.PDF zielt auf den anderen Fall ab: eine Pipeline, in der ein Dokument Extraktion, Bearbeitung, Konvertierung und Verschlüsselung durchläuft und Sie lieber ein SDK als drei Bibliotheken pflegen möchten.
| Bibliothek | Am besten für | Wichtige Überlegung | Lizenz |
|---|---|---|---|
| pypdf | Zusammenführen, Aufteilen, Drehen und Verschlüsseln von Seiten in reinem Python | AES-Verschlüsselung erfordert das Extra pypdf[crypto]
|
BSD-3 |
| pdfplumber | Layout-Analyse, Tabellenextraktion, visuelles Debugging | Gebaut zum Lesen, nicht zum Ändern von Seiten | MIT |
| PyMuPDF | Schnelle Textextraktion und Seitenrendering | AGPL-3.0 oder kommerziell; prüfen Sie dies im Hinblick darauf, wie Sie vertreiben | AGPL-3.0 oder kommerziell |
| pikepdf | Arbeit auf niedriger Strukturebene, Linearisierung, Verschlüsselung | Keine Textextraktions-API | MPL-2.0 |
| reportlab | Generierung von PDFs aus Code | Nur Generierung | BSD |
| Spire.PDF | Gemischte Aufgaben (Extrahieren, Bearbeiten, Konvertieren, Verschlüsseln) in einem SDK | Kommerzielle Lizenz; kostenlose, Evaluierungs- und temporäre Lizenzoptionen | Kommerziell |
Lesen Sie die Tabelle nach Aufgabe, nicht nach Name. Wenn Ihre Pipeline nur die Operation in der ersten Spalte einer Bibliothek benötigt, ist die dritte Spalte das Einzige, was noch abzuwägen bleibt. Lizenzbedingungen und Installationsgewicht entscheiden tendenziell zwischen nahen Kandidaten, und die folgenden Abschnitte liefern Zahlen zu beidem.
Hinweis zum Umfang: Dies sind fünf ausgewählte Open-Source-Bibliotheken und ein kommerzielles SDK. Es deckt nicht jedes spezialisierte PDF-Tool im Python-Ökosystem ab.
Was ausgewählte Open-Source-Python-PDF-Bibliotheken am besten können
Wer nach einer Python-PDF-Parser-Bibliothek oder einer Python-PDF-Reader-Bibliothek sucht, meint meist eines von zwei Dingen: Text und Tabellen aus vorhandenen Dateien herauszuziehen oder die Dateien selbst umzustrukturieren. Die fünf folgenden Bibliotheken teilen sich entlang dieser Linie auf. pdfplumber und PyMuPDF sind am stärksten auf der Leseseite, pypdf und pikepdf auf der Seitenstrukturseite und reportlab beim Erstellen von Dokumenten von Grund auf. Jeder Eintrag nennt den Schwerpunkt der Bibliothek, was wir gemessen haben und wo ihr Umfang endet.
pypdf
pypdf ist eine reine Python-Bibliothek für Arbeit auf Seitenebene mit einem installierten Fußabdruck von 1,8 MB in unserer sauberen Umgebung. In unseren Läufen extrahierte sie ein 10-seitiges Textdokument in 43,1 ms, drehte eine Seite in 9,2 ms, löschte eine in 8,6 ms, führte zwei Dateien in 14,7 ms zusammen, teilte drei Seiten in 10,2 ms heraus und wandte eine AES-256-Verschlüsselung in 19,6 ms an. AES erfordert das Extra pypdf[crypto], was die Installation auf 13,2 MB erhöht. Sie ist eine natürliche erste Wahl, wenn Sie Seiten neu organisieren und keine kompilierten Abhängigkeiten möchten; AES-Schutz bringt das oben erwähnte crypto-Extra mit sich.
from pypdf import PdfReader, PdfWriter

writer = PdfWriter()
for path in ("report.pdf", "appendix.pdf"):
    writer.append(PdfReader(path))

writer.pages[0].rotate(90)
writer.encrypt("open-password", algorithm="AES-256")
with open("merged.pdf", "wb") as f:
    writer.write(f)
Das Skript führt zwei Dateien zusammen, dreht die erste Seite und schreibt eine AES-256-geschützte Kopie.
pdfplumber
pdfplumber ist das Werkzeug der Wahl, wenn Sie sehen müssen, wie eine Seite aufgebaut ist. Es legt Positionen von Zeichen, Linien und Rechtecken offen, was Tabellenextraktion und visuelles Debugging praktikabel macht. Die umrandete 21 × 4-Tabelle in unserer Fixture kam in 44,6 ms heraus, und die reine Textextraktion über zehn Seiten dauerte 320,4 ms, länger als bei den textfokussierten Readern, während die Bibliothek zugleich das positionelle Detail offenlegt, auf das Layout-Analyse und Tabellenarbeit angewiesen sind. Eine einseitige chinesische Rechnung wurde in 7,7 ms gelesen und lieferte den erwarteten Ausdruck „发票编号“. Sie liest PDFs und verändert sie nicht, daher steht sie meist neben einer zweiten Bibliothek.
import pdfplumber

with pdfplumber.open("report.pdf") as pdf:
    table = pdf.pages[0].extract_tables()[0]

print(len(table), "rows,", len(table[0]), "columns")
Der Aufruf gibt die erste Tabelle auf Seite eins als Liste von Zeilen zurück.
PyMuPDF
PyMuPDF kombiniert Textverarbeitung und Rendering auf einer kompilierten Engine. Es hatte die niedrigste Textextraktionszeit im Test, 7,2 ms für zehn Seiten, löschte eine Seite in 3,0 ms und renderte eine Seite bei 150 DPI in 48,8 ms. Die Standardinstallation umfasst 201,3 MB mit ihren Abhängigkeiten (104,5 MB mit --no-deps), sodass sie die schwerste Option hier ist, und die Lizenz ist AGPL-3.0 oder kommerziell. Wenn Ihr Dienst Miniaturansichten rendert oder viele Seiten durch die Textextraktion schickt, erklären die Zahlen seine Beliebtheit.
import pymupdf

doc = pymupdf.open("report.pdf")
text = doc[0].get_text()
doc[0].get_pixmap(dpi=150).save("page1.png")
Der Ausschnitt liest den Text der ersten Seite und speichert ein PNG davon mit 150 DPI.
pikepdf
pikepdf kapselt die QPDF-Bibliothek und arbeitet an der PDF-Objektstruktur selbst. Das eignet sich für Aufgaben wie das Drehen oder Löschen von Seiten (6,4 ms und 5,8 ms), das Neuanordnen (6,5 ms), das Anwenden von AES-256-Verschlüsselung mit einem Revision-6-Handler (32,0 ms) und das Speichern einer linearisierten Datei für die Webauslieferung (7,8 ms). Es bietet keine Textextraktions-API, daher kombinieren Teams es üblicherweise mit einem Reader. Wählen Sie es, wenn Sie Low-Level-PDF-Objektmanipulation, Seitenumstrukturierung, Verschlüsselung oder Linearisierung benötigen.
import pikepdf

with pikepdf.open("report.pdf") as pdf:
    pdf.pages[0].rotate(90, relative=False)
    pdf.save("rotated.pdf")
Der Code setzt die erste Seite auf eine 90-Grad-Drehung und speichert das Ergebnis.
reportlab
reportlab existiert, um PDFs zu erstellen, und das tut es mit voller Kontrolle über Schriften, Koordinaten und fließende Layouts. Im Test generierte es ein 10-seitiges Dokument mit 40 Zeilen pro Seite in Arial 10 pt in 14,1 ms. Es hat keine Aufgabe beim Lesen oder Bearbeiten vorhandener Dateien, was eine klare Grenze und keine Lücke ist: Rechnungen, Etiketten und generierte Berichte sind der Bereich, in dem es seinen Platz verdient.
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas

c = canvas.Canvas("generated.pdf", pagesize=A4)
c.setFont("Helvetica", 10)  # the benchmark used Arial 10 pt
for page in range(10):
    for line in range(40):
        c.drawString(50, 800 - line * 18, f"Page {page + 1} line {line + 1}")
    c.showPage()
c.save()
Die Schleife erzeugt eine 10-seitige A4-Datei mit 40 Zeilen pro Seite.
Wann ein Multi-Library-PDF-Workflow schwierig zu pflegen wird
Nichts oben Genanntes ist ein Mangel. Die Reibung zeigt sich, wenn eine Anforderung mehrere dieser Bibliotheken nacheinander erfordert, und jedes hinzugefügte Werkzeug bringt Kosten mit sich, die in einer einzelnen Benchmark-Zeile nicht auftauchen:
- Konvertierung erfordert einen separaten Konverter. PDF zu Word ist nicht Teil der Reader und Seitenbearbeiter oben, also fügen Sie einen hinzu, und die Layout-Treue muss Datei für Datei überprüft werden.
- Text direkt zu bearbeiten ist eine eigene Aufgabe. Seitenoperationen verschieben oder entfernen ganze Seiten; Wörter innerhalb einer Seite zu ändern erfordert etwas anderes.
- Komplexe Formulare sind ein separates Thema. Einfache Felder zu lesen ist eine Sache, Formulare zu erstellen und zu flatten ist eine andere, und die Bibliotheken unterscheiden sich darin, wie weit sie gehen.
- Signaturen und PDF/A benötigen zusätzliche Werkzeuge. Archivierungs- und Signatur-Workflows bringen üblicherweise zusätzliche Pakete mit.
- OCR ist konstruktionsbedingt extern. Gescannte Seiten erfordern eine Engine außerhalb all dieser Bibliotheken.
Ein konkretes Bild hilft. Ein typisches Klebe-Skript öffnet die Datei in einer Bibliothek, schreibt eine Zwischendatei, öffnet diese Datei in einer zweiten Bibliothek erneut, speichert erneut und übergibt das Ergebnis dann an einen Konverter, der es ein drittes Mal parst. Jede Übergabe ist eine Stelle, an der sich Schriften, Seitenboxen oder Verschlüsselungsflags ändern können, und jede benötigt einen eigenen Test. Nichts davon ist schwer zu schreiben; es ist der Teil, der mit sich ändernden Anforderungen weiter wächst.
Unter allen fünf liegt derselbe Overhead: eine weitere zu lernende API, ein weiterer Abhängigkeitsbaum, eine weitere Kompatibilitätsmatrix und ein weiterer Fehlerbehandlungspfad, plus eine Dateiübergabe zwischen Werkzeugen.
Lizenzierung verdient eine eigene Zeile. Der gängige Konverter pdf2docx ist MIT-lizenziert und hängt von PyMuPDF ab, das AGPL-3.0 oder kommerziell ist. Das sind zwei getrennte Fakten, und ein vertriebenes Produkt sollte beide bewerten. Für einen tieferen Blick auf die Leseseite des Problems lesen Sie unseren Leitfaden zum Parsen von PDFs in Python.
Was Spire.PDF for Python zu PDF-Workflows beiträgt
Spire.PDF for Python ist ein kommerzielles SDK, das Lesen, Bearbeiten, Konvertierung, Sicherheit und Generierung in einem Paket abdeckt. Vier Bereiche sind für den Vergleich wichtig.
1. Ein gemeinsames Dokumentmodell und eine konsistente API
Ein gemeinsames Dokumentmodell und eine konsistente Python-API ermöglichen Entwicklern, mehrere PDF-Operationen innerhalb eines SDK auszuführen. Spezialisierte Hilfsklassen wie PdfTableExtractor arbeiten mit dem geladenen PdfDocument. Dasselbe geladene PdfDocument kann für mehrere Operationen verwendet werden, ohne Zwischen-PDF-Dateien zwischen separaten Bibliotheken weiterzugeben. Es bedeutet auch ein Fehlerbehandlungsmuster und einen Satz von Versionsbeschränkungen, die beim Upgrade zu verfolgen sind.
2. Leistung bei der Tabellenextraktion in unserem Benchmark
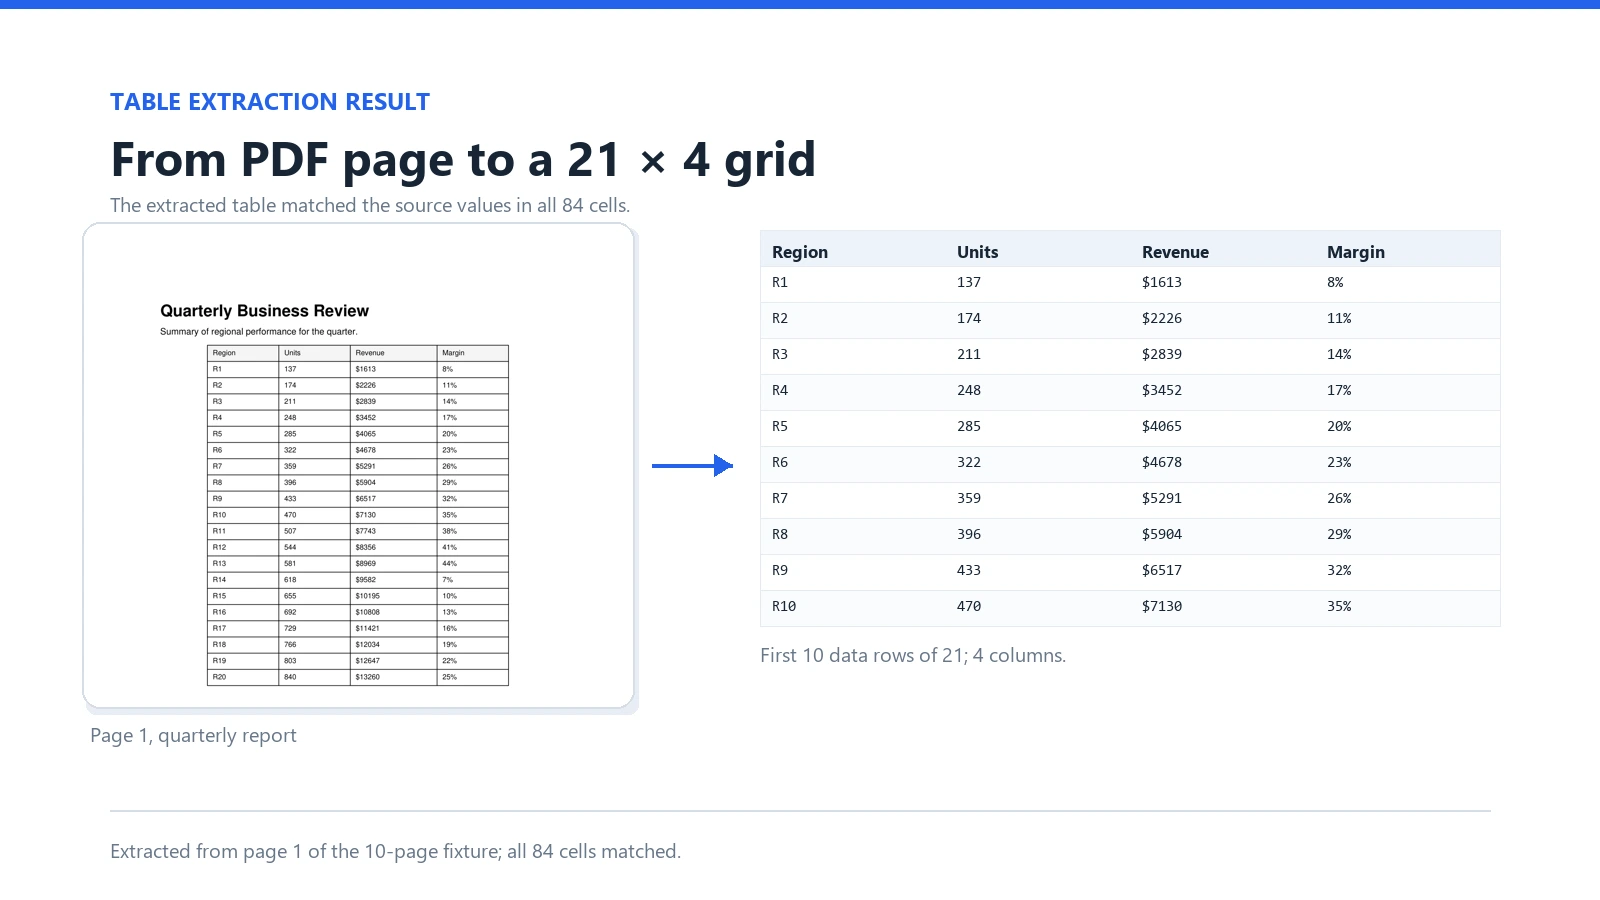
Wir haben dieselbe umrandete Tabelle durch drei Bibliotheken laufen lassen. Die Fixture hat 21 Zeilen und 4 Spalten, hat klar gezeichnete Ränder und keine verbundenen Zellen. Die offizielle Dokumentation besagt, dass die Tabellenextraktion am besten mit klar formatierten Tabellen funktioniert, daher beschreiben diese Ergebnisse nur diese Art von Tabelle.
| Bibliothek | Median | Bereich | Ergebnis |
|---|---|---|---|
| Spire.PDF | 18,9 ms | 16,2 bis 26,4 ms | 21 × 4, alle 84 Zellen korrekt |
| pdfplumber | 44,6 ms | 42,3 bis 53,7 ms | 21 × 4, alle 84 Zellen korrekt |
| PyMuPDF | 363,4 ms | 341,6 bis 385,7 ms | 21 × 4, alle 84 Zellen korrekt |
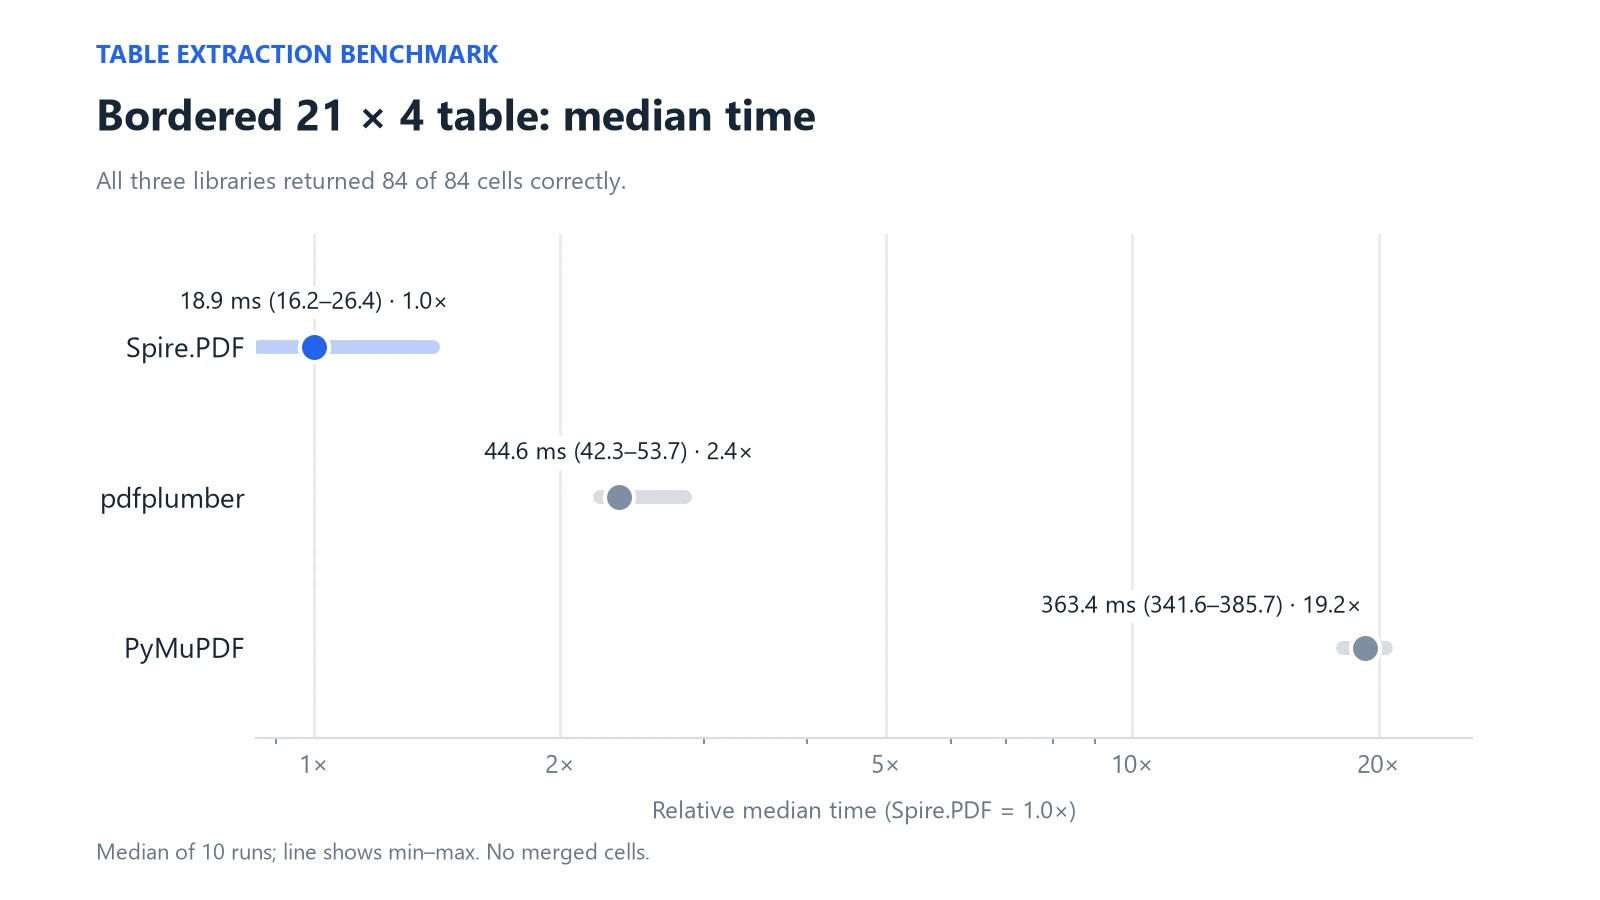
Alle drei lieferten identische Zellinhalte, daher geht es beim Vergleich um die Zeit bei gleicher Korrektheit. Spire.PDF verzeichnete in diesem Test den niedrigsten Median. Tabellen mit verbundenen Zellen, fehlenden Rändern oder gescannten Seiten wurden nicht gemessen und könnten anders abschneiden. Für eine Schritt-für-Schritt-Anleitung derselben API lesen Sie Tabellen aus PDF in Python extrahieren.
3. Formulare
Spire.PDF for Python dokumentiert APIs zum Erstellen und Ausfüllen von Formularfeldern und zum Flatten derselben in statischen Inhalt. Die Formularverarbeitung war nicht Teil unseres Leistungs-Benchmarks, daher beschreibt dieser Abschnitt nur die dokumentierte Funktionalität.
4. Export in andere Formate
Dasselbe geladene Dokument kann in mehreren Formaten gespeichert werden. In unseren Läufen wurden die unten genannten Ausgaben aus einem 10-seitigen Bericht erzeugt.
| Richtung | Verifikationstiefe |
|---|---|
| PDF zu DOCX, HTML, Markdown | Ausgabe erzeugt; Textinhalt geprüft |
| PDF zu XLSX | Ausgabe erzeugt; Zellinhalt vorhanden; Struktur hängt vom Quelllayout ab |
| PDF zu PNG, XPS, SVG, PPTX | Ausgabe erzeugt; visuelle Treue hängt vom Quelllayout ab |
| PDF zu PDF/A-1a und PDF/A-1b | Konvertierungsmethoden verfügbar; Ausgabe erzeugt und XMP-Identifikatoren geprüft; formale PDF/A-Konformität nicht unabhängig validiert |
Die Konvertierungsausgabe hängt vom Quelllayout ab; validieren Sie repräsentative Dateien vor dem Produktionseinsatz. Für den DOCX-Weg im Detail lesen Sie das Tutorial zum Konvertieren von PDF zu Word in Python.
Ein mehrstufiger PDF-Workflow in Python
Um das Wartungsargument im Code zu sehen, haben wir eine realistische Aufgabe gewählt. Ein 40-seitiger Quartalsbericht benötigt die Extraktion seiner Übersichtstabelle und die Entfernung seiner Anhangseiten. Aus der aktualisierten Datei sind zwei Ausgaben erforderlich: ein bearbeitbares DOCX und ein AES-256-verschlüsseltes PDF-Archiv.
Original PDF (40 pages)
   └─ extract table + remove appendix
        └─ Updated PDF
             ├─ DOCX copy      → editable Word document
             └─ encrypt + save → encrypted PDF archive
Die Open-Source-Implementierung verwendet pdfplumber für die Tabelle, pypdf[crypto] für Seitenlöschung und Verschlüsselung sowie pdf2docx für die Word-Kopie. Das sind drei Pakete, die PDFs direkt berühren. Zusammen in einer sauberen Umgebung installiert, kommen sie auf 29 Distributionen und 388,9 MB, gegenüber 70,5 MB für Spire.PDF, auf dieselbe Weise gemessen.
Mit Spire.PDF bleibt der gesamte Ablauf innerhalb eines Dokumentobjekts:
from spire.pdf.common import *
from spire.pdf import *

doc = PdfDocument()
doc.LoadFromFile("report.pdf")

# 1. Extract the summary table from page 1
extractor = PdfTableExtractor(doc)
table = extractor.ExtractTable(0)[0]
rows = [[table.GetText(r, c) for c in range(table.GetColumnCount())]
        for r in range(table.GetRowCount())]

# 2. Remove the last page (appendix)
doc.Pages.RemoveAt(doc.Pages.Count - 1)

# 3. Output one: editable Word copy
doc.SaveToFile("report.docx", FileFormat.DOCX)

# 4. Output two: AES-256 encrypted archive
doc.Security.Encrypt("open-password", "owner-password",
                     PdfPermissionsFlags.Default, PdfEncryptionKeySize.Key256Bit)
doc.SaveToFile("report-archive.pdf")
doc.Close()
Für einen direkten Zeitvergleich wurden beide Implementierungen mit der 10-seitigen Version des Berichts ausgeführt. Die drei Open-Source-Pakete benötigten insgesamt einen Median von 1.346,2 ms und Spire.PDF 267,3 ms. Beide extrahierten alle 84 Tabellenzellen korrekt, und beide erzeugten ein 9-seitiges verschlüsseltes PDF, das sich mit dem Passwort erneut öffnen ließ. Beide Archive verweigerten das Öffnen ohne das Passwort. Beim 40-seitigen Bericht benötigte der Open-Source-Stack 3.241,4 ms und erzeugte 39 Seiten; der Evaluierungs-Build von Spire.PDF verarbeitet nur die ersten 10 Seiten, daher vergleichen wir diesen Lauf nicht (siehe Abschnitt zu den Editionen).
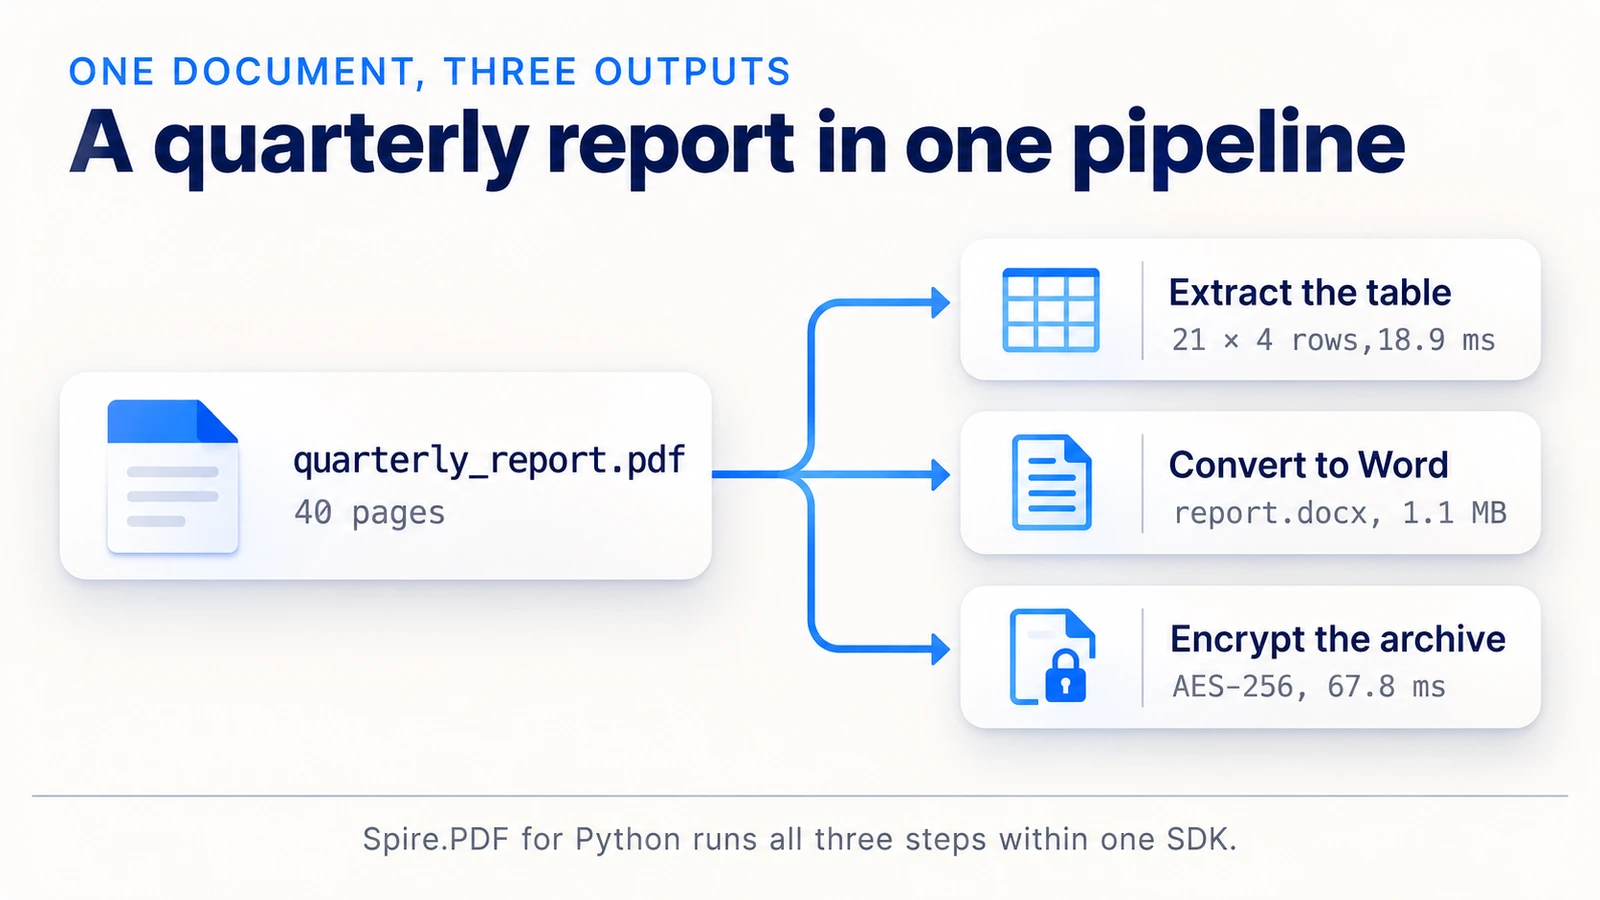
Dieser Vergleich deckt Tabellenextraktion, Seitenlöschung, DOCX- und PDF-Generierung, Verschlüsselung und verstrichene Zeit ab; die DOCX-Layout-Treue liegt außerhalb dieses Zeitvergleichs und sollte an Ihren eigenen Dateien validiert werden. Der Großteil des Zeitunterschieds liegt im DOCX-Schritt, in dem der Open-Source-Konverter etwa 1,3 s benötigte. Der Sinn der Übung ist weniger die Stoppuhr als die Form des Codes: ein Import, ein Dokumentobjekt, keine Dateien, die zwischen Paketen weitergegeben werden. Für genauere Informationen zur Passwortverwaltung lesen Sie PDF-Dokumente in Python schützen oder entschützen.
Leistung und Installationsgröße
Jede Zahl unten ist ein Median aus 10 gemessenen Läufen nach einem Aufwärmlauf, in Millisekunden, mit Minimum und Maximum in Klammern. Jeder Wert ist eine End-to-End-Zeit für die Operation: Das Öffnen der Fixture und das Speichern der Ausgabe sind, wo zutreffend, enthalten. „n/a“ bedeutet, dass die Bibliothek keine solche Operation hat.
| Aufgabe | pypdf | pdfplumber | PyMuPDF | pikepdf | reportlab | Spire.PDF |
|---|---|---|---|---|---|---|
| Text, 10 Seiten | 43,1 (39,9–46,1) | 320,4 (295,5–573,8) | 7,2 (6,7–8,4) | n/a | n/a | 58,2 (53,8–64,6) |
| Tabelle, 84 Zellen | n/a | 44,6 (42,3–53,7) | 363,4 (341,6–385,7) | n/a | n/a | 18,9 (16,2–26,4) |
| Eine Seite drehen | 9,2 (8,5–13,1) | n/a | 3,8 (2,7–11,0) | 6,4 (5,6–7,7) | n/a | 22,4 (20,6–29,9) |
| Eine Seite löschen | 8,6 (8,2–14,7) | n/a | 3,0 (2,8–3,4) | 5,8 (5,5–6,9) | n/a | 23,3 (20,2–27,8) |
| Rendern bei 150 DPI | n/a | n/a | 48,8 (47,2–52,3) | n/a | n/a | 161,4 (153,8–180,3) |
| AES-256-Verschlüsselung | 19,6 (17,2–24,6) | n/a | n/a | 32,0 (30,9–34,4) | n/a | 67,8 (62,1–72,2) |
| 10 Seiten generieren | n/a | n/a | n/a | n/a | 14,1 (13,7–15,3) | 85,3 (79,4–106,9) |
Bei einzelnen Operationen führen die Spezialisten in den meisten Zeilen: PyMuPDF für Text, Drehen, Löschen und Rendern, pypdf für reine Python-Seitenbearbeitungen, pikepdf für strukturelle Arbeit und beide für Verschlüsselung, mit reportlab für die Generierung. Der niedrigste Median von Spire.PDF lag im Tabellentest. Die Generierung verglich 10 Seiten mit je 40 Zeilen, A4, Arial 10 pt. Im Rendering-Test erzeugten PyMuPDF und Spire.PDF beide 1241 × 1754 Pixel große Bilder bei 150 DPI. Der Wert eines einzigen SDK zeigt sich in kombinierten Workflows, nicht in einer einzelnen Zeile.
Installation, gemessen in einer sauberen virtuellen Umgebung und ausschließlich von Interpreter, pip, setuptools, wheel und __pycache__:
| Ziel | Installierte Größe | Pakete | Import in neuem Prozess |
|---|---|---|---|
| pypdf | 1,8 MB | 1 | 219,9 ms |
| pypdf[crypto] | 13,2 MB | 4 | 331,8 ms |
| pdfplumber | 43,9 MB | 8 | 246,5 ms |
| PyMuPDF (Standard) | 201,3 MB | 12 | 223,8 ms |
PyMuPDF (--no-deps) |
104,5 MB | 1 | 217,0 ms |
| pikepdf | 35,2 MB | 4 | 178,4 ms |
| reportlab | 20,4 MB | 3 | 9,0 ms |
| Spire.PDF | 70,5 MB | 2 | 640,6 ms |
| Drei-Paket-Workflow-Stack | 388,9 MB | 29 | n/a |
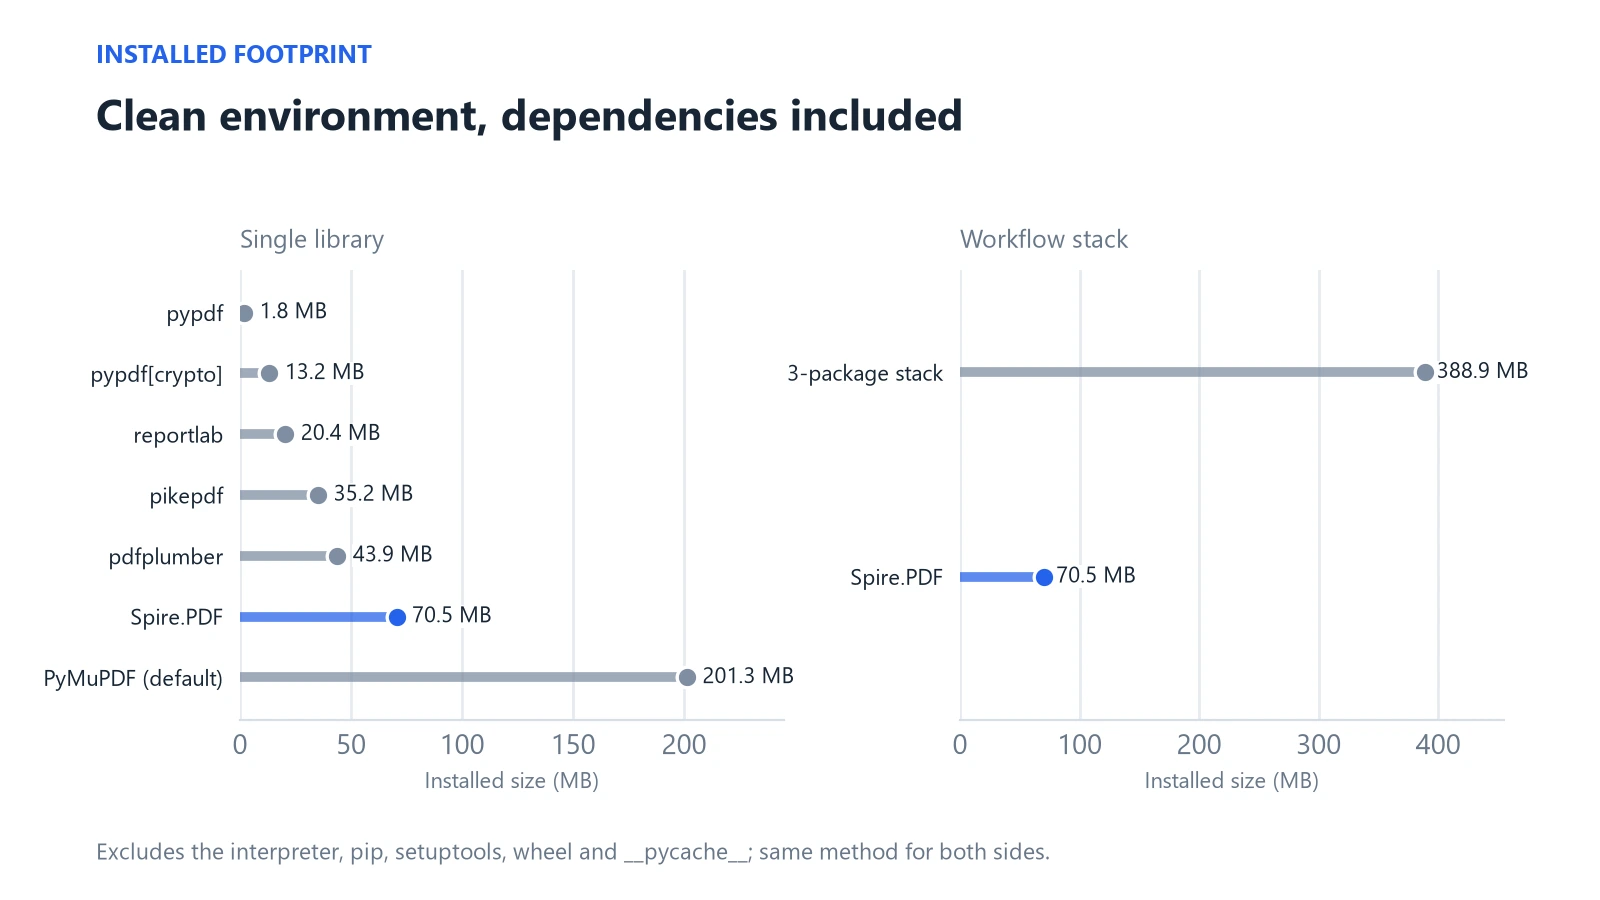
Zwei Details lohnt es sich, aus der Installationstabelle herauszulesen. Die Importzeit ist ein einmaliger Kostenaufwand pro Prozess, daher ist sie für kurzlebige Kommandozeilen-Jobs und serverlose Funktionen wichtiger als für langlaufende Dienste; der Kaltimport von Spire.PDF maß 640,6 ms, immer noch unter einer Sekunde, während der von reportlab mit 9,0 ms der kürzeste war. Die Installationsgröße ist wichtig für Container-Images und Desktop-Packaging, wo die Standardgröße von PyMuPDF mit 201,3 MB und der Drei-Paket-Stack mit 388,9 MB herausstechen.
Lizenzen in jeweils einer Zeile: pypdf BSD-3, pdfplumber MIT, PyMuPDF AGPL-3.0 oder kommerziell, pikepdf MPL-2.0, reportlab BSD, Spire.PDF kommerziell. AGPL-Bedingungen sollten im Hinblick darauf bewertet werden, wie Sie Ihre Software vertreiben.
Kostenlose Edition, Evaluierung, temporär und kommerziell
Spire.PDF ist ein kommerzielles Produkt mit mehreren Editionen, und diese verhalten sich unterschiedlich, prüfen Sie daher, welche installiert ist, bevor Sie Benchmarking betreiben oder ausliefern.
| Paket / Version | Status | Einschränkungen |
|---|---|---|
| Spire.Pdf.Free 10.12.0 (2025-01-16) | Kostenlose Edition | Ausgabe auf 10 Seiten begrenzt; Bild-, XPS-, Word- und HTML-Konvertierung auf die ersten 3 Seiten begrenzt |
| spire-pdf 12.10.0 (2026-10-12) | Evaluierung | Evaluierungswarnung; die ersten 10 Seiten werden verarbeitet |
| spire-pdf 12.10.0 | Temporäre Lizenz (30 Tage) | Evaluierungsbeschränkungen entfernt |
| spire-pdf 12.10.0 | Kommerziell | Keine der oben genannten Einschränkungen |
Über die API hinaus ist eine kommerzielle Lizenz auch eine Wartungsbeziehung. Das Paket liefert Wheels für Windows, Linux und macOS, verzeichnete sieben Releases zwischen Januar und Oktober 2026 (12.1.3 bis 12.10.0), und kommerzielle Lizenzen umfassen Updates und technischen Support über das Forum und per E-Mail des Anbieters, mit Reaktionszielen, die von der Lizenzstufe abhängen.
Die Seitenbegrenzung ist leicht zu überprüfen: Eine in der Evaluierungsversion geladene 40-seitige Datei erzeugt nur 10 verarbeitete Seiten. Das ist eine Eigenschaft der Evaluierungsedition, nicht der Produktfunktionalität, und das ist der Grund, warum unser 40-seitiger Workflow-Lauf nur für den Open-Source-Stack berichtet wird. Evaluierungs-Builds dienen der Bewertung, nicht der Produktion. Für Teams, die neu im Produkt sind, ist eine sinnvolle Reihenfolge, mit dem Evaluierungs-Build an Ihren eigenen Dateien zu beginnen, eine temporäre Lizenz anzufordern, wenn Sie über 10 Seiten hinaus testen müssen, und vor dem Ausliefern auf eine kommerzielle Lizenz umzusteigen.
Die richtige PDF-Bibliothek für Ihr Projekt wählen
Drei Profile decken die meisten Teams ab:
- Eine spezialisierte Aufgabe. Text in großem Umfang extrahieren, Seiten rendern, Dateien zusammenführen oder Berichte generieren: Wählen Sie die Bibliothek, die für diese Operation gebaut wurde, wie PyMuPDF, pypdf oder reportlab. Prüfen Sie die Lizenz, wenn Sie weitergeben.
- Layout-bewusstes Lesen. Wenn Tabellen und Positionen im Fokus stehen, ist pdfplumber das Werkzeug der Wahl, mit pypdf oder pikepdf für Seitenbearbeitungen.
- Verkettete Aufgaben an derselben Datei. Wenn Extraktion, Seitenbearbeitungen, Konvertierung und Verschlüsselung zu einer Pipeline gehören, reduziert ein einziges SDK die Zahl der APIs und Abhängigkeitsbäume, die Sie pflegen. Hierfür ist Spire.PDF konzipiert; eine kommerzielle Lizenz deckt Updates und Support ab.
Ein schneller Test vor der Entscheidung: Schreiben Sie jede Operation auf, die das Projekt im nächsten Jahr benötigt, einschließlich Konvertierung, Verschlüsselung und Archivierung, und markieren Sie, welche Bibliothek welche abdeckt. Wenn eine Bibliothek die ganze Liste abdeckt, sind Sie fertig. Wenn die Liste drei benötigt, vergleichen Sie die Kosten von drei Abhängigkeiten mit einer Lizenz.
Zählen Sie die Aufgaben, nicht die Funktionen. Wenn Sie die Operationen, die Ihr Projekt benötigt, in einem Satz nennen können und es ein oder zwei sind, reicht ein Spezialist wahrscheinlich aus. Wenn die Liste weiter wächst, probieren Sie Spire.PDF for Python an Ihren eigenen Dateien aus.
So haben wir getestet
Offenlegung: Spire.PDF for Python ist ein Produkt von E-iceblue, und dieser Benchmark wurde vom Herausgeber durchgeführt. Wir haben daher Fixtures, Versionen und Methode veröffentlicht, und die Open-Source-Bibliotheken wurden mit genau denselben Dateien getestet.
- Umgebung: Windows 11, Intel Core i3-10105 mit 3,70 GHz (4 Kerne, 8 Threads), 8,4 GB RAM, Python 3.14.6.
- Versionen: pypdf 6.21.4, pdfplumber 0.11.10, PyMuPDF 2.1, pikepdf 10.17.0, reportlab 5.1.0, pdf2docx 0.5.13, python-docx 1.2.0, Spire.PDF 12.10.0.
- Fixtures: ein 10-seitiges Textdokument, eine umrandete 21 × 4-Tabelle auf Seite eins, eine chinesischsprachige Rechnung, eine gemischtinhaltliche Seite für das Rendering und generierte 10- und 40-seitige Quartalsberichte. Seitenzahlen, Größen und SHA-256-Hashes sind in einem Fixture-Manifest festgehalten.
- Timing: ein Aufwärmlauf und 10 gemessene Läufe pro Test, berichtet als Mediane mit Minimum und Maximum. Öffnen, Bearbeiten und Speichern wurden in getrennten Phasen gemessen.
- Korrektheit: Text verglichen nach Abdeckung eindeutiger Token und Sequenzähnlichkeit (nicht nach rohen Zeichenzahlen, da Leerraumkonventionen abweichen); Tabellen Zelle für Zelle verglichen; verschlüsselte Dateien mit dem Passwort erneut geöffnet und auf blockierten Zugriff ohne dieses geprüft.
- Nicht abgedeckt: eine Maschine und eine Workload; gescannte Dokumente, OCR, Signaturen, Formularverarbeitung, Tabellen mit verbundenen Zellen und beliebige beschädigte Dateien wurden nicht gemessen. Die Timings werden sich auf Ihrer Hardware und mit Ihren Dokumenten unterscheiden.
Häufig gestellte Fragen
Welche ist insgesamt die beste Python-PDF-Bibliothek? Es gibt keinen einzelnen Sieger. PyMuPDF führt bei Text- und Rendering-Geschwindigkeit, pypdf ist die einfache Wahl für Seitenoperationen, pdfplumber für Tabellen, reportlab für die Generierung. Für Pipelines, die mehrere Aufgaben verketten, kann ein einziges SDK wie Spire.PDF die Zahl der direkt integrierten PDF-Pakete reduzieren.
pypdf vs. PyMuPDF: Welche sollte ich verwenden? Wählen Sie pypdf für Seitenoperationen in einem kleinen reinen Python-Paket mit BSD-Lizenz. Wählen Sie PyMuPDF für schnellere Textextraktion und Seitenrendering und prüfen Sie zuerst seine AGPL-3.0- oder kommerziellen Bedingungen. In unserem Test benötigte PyMuPDF 7,2 ms für Text gegenüber 43,1 ms.
Wie extrahiere ich eine Tabelle aus einer PDF in Python?
Rufen Sie für umrandete Tabellen extract_tables() in pdfplumber auf oder verwenden Sie einen Tabellenextraktor in PyMuPDF oder Spire.PDF. Bei unserer 21 × 4-Fixture stimmten alle drei bei 84 von 84 Zellen überein. Tabellen ohne Ränder oder mit verbundenen Zellen erfordern separate Tests.
Kann Python eine PDF in Word konvertieren? Ja. pdf2docx ist eine gängige Open-Source-Option, und Spire.PDF kann ein geladenes Dokument als DOCX speichern. Die Konvertierungsausgabe hängt vom Quelllayout ab; validieren Sie repräsentative Dateien vor dem Produktionseinsatz.
Sind diese Bibliotheken für die kommerzielle Nutzung kostenlos? pypdf, pdfplumber, pikepdf und reportlab verwenden permissive oder schwache Copyleft-Lizenzen (BSD-3, MIT, MPL-2.0, BSD). PyMuPDF ist AGPL-3.0 oder kommerziell, bewerten Sie es daher im Hinblick darauf, wie Sie vertreiben. Spire.PDF erfordert für die Produktion eine kommerzielle Lizenz; kommerzielle Lizenzen umfassen Updates und technischen Support, während die kostenlose und die Evaluierungsedition Seitenbegrenzungen haben.
Quellen
- pypdf-Dokumentation
- pdfplumber-Repository
- PyMuPDF-Dokumentation
- pikepdf-Dokumentation
- ReportLab-Dokumentation
- pdf2docx-Dokumentation
- Programmhandbuch für Spire.PDF for Python