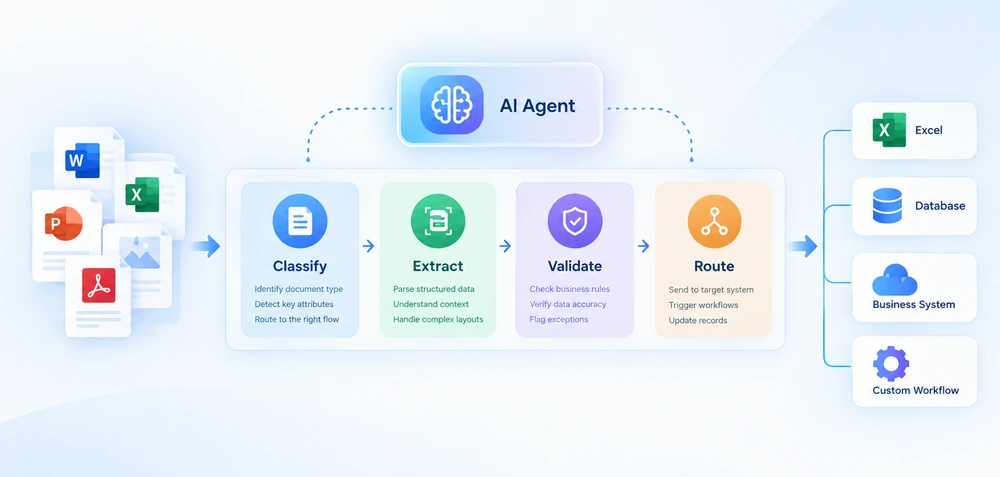
Intelligente Dokumentenverarbeitung (IDP) kombiniert KI-basiertes Dokumentenverständnis mit automatisierter Extraktion, Validierung und nachgelagerter Verarbeitung. Für .NET-Entwickler bedeutet die Implementierung von IDP in der Regel, KI-basiertes Dokumentenverständnis mit deterministischem Code zu verbinden, der Dateien, Geschäftsregeln und Systemintegration handhabt.
Dieser Leitfaden konzentriert sich auf IDP-Workflows für Office- und PDF-Dokumente in .NET. Er behandelt die vierstufige Pipeline-Architektur, zeigt C#-Implementierungsmuster und bietet einen Entscheidungsrahmen für die Wahl zwischen Eigenentwicklung und der Einführung einer Anbieterplattform.
Schnellnavigation
- Die vierstufige IDP-Pipeline
- Erstellen einer IDP-Pipeline in .NET
- Batch- und Multi-Dokumentenverarbeitung
- IDP in der Praxis
- Eigenentwicklung vs. Kauf: Wahl eines IDP-Ansatzes
1. Was ist intelligente Dokumentenverarbeitung?
Intelligente Dokumentenverarbeitung ist ein Automatisierungsansatz, der KI verwendet, um Dokumente zu klassifizieren, strukturierte Daten daraus zu extrahieren, die Ergebnisse anhand von Geschäftsregeln zu validieren und die Ausgabe an nachgelagerte Systeme weiterzuleiten. Im Gegensatz zur traditionellen OCR, die in erster Linie visuelle Inhalte in maschinenlesbaren Text umwandelt, fügt IDP Dokumentenklassifizierung, semantische Extraktion, Validierung und Workflow-Automatisierung hinzu. Es kann unterschiedliche Dokumentenlayouts verarbeiten, ohne sich vollständig auf feste Vorlagen zu verlassen.
Eine praktische IDP-Pipeline kann in vier Stufen organisiert werden: Klassifizierung, Extraktion, Validierung und Routing. Jede Stufe hat unterschiedliche Eingaben, Ausgaben und Fehlerarten. Der KI-Agent übernimmt Klassifizierung und Extraktion durch Natural-Language-Verständnis, während Validierung und Routing deterministischer Code bleiben, der Geschäftsregeln durchsetzt und in nachgelagerte Systeme integriert.
IDP vs. OCR, Dokumentenverarbeitung und Dokumentenintelligenz
Diese Begriffe werden oft synonym verwendet, beschreiben aber unterschiedliche Fähigkeiten:
| Technologie | Hauptrolle |
|---|---|
| OCR | Visuellen Inhalt in Text umwandeln |
| Dokumentenverarbeitung | Dateien lesen, bearbeiten, konvertieren oder generieren |
| Dokumentenintelligenz | Dokumenteninhalt verstehen und Bedeutung extrahieren |
| IDP | Dokumentenverständnis mit automatisierten Workflows kombinieren |
In der Praxis überschneiden sich diese Fähigkeiten oft. Eine IDP-Pipeline kann OCR für gescannte Dokumente, KI für semantisches Verständnis und Dokumentenverarbeitungs-APIs für deterministische Dateioperationen verwenden. Die Unterscheidung ist für die Architektur wichtig: Zu wissen, welche Schicht welche Verantwortung übernimmt, bestimmt, wie Sie das System erstellen und warten.
IDP bedeutet nicht, den gesamten Workflow durch KI zu ersetzen. Die KI übernimmt Verständnis und Extraktion; deterministischer Code übernimmt Validierung, Routing, Dateibearbeitung und Systemintegration. Diese Trennung macht IDP in der Produktion wartbar – Geschäftsregeln ändern sich häufiger als Dokumentformate, und Sie möchten diese Regeln in Code haben, den Sie kontrollieren, nicht in einem Modell-Prompt.
2. Die vierstufige IDP-Pipeline
Eine IDP-Pipeline ist kein einzelner API-Aufruf. Sie ist eine Abfolge von Stufen, jede mit unterschiedlichen Eingaben, Ausgaben und Fehlerarten. Diese Architektur zu verstehen, ist der Unterschied zwischen dem Erstellen einer Pipeline, die echte Dokumentenvielfalt bewältigt, und dem Schreiben eines Skripts, das bei der ersten unerwarteten Eingabe abbricht.
Eine praktische IDP-Pipeline kann in vier Stufen organisiert werden:
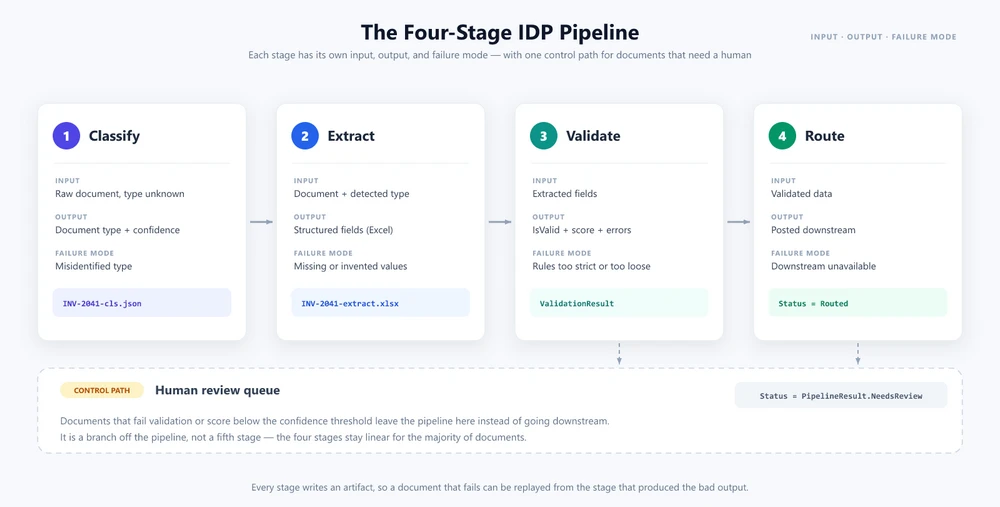
Stufe 1 – Klassifizierung
Die Pipeline erhält ein Dokument unbekannten Typs. Die Klassifizierung bestimmt, um welches Dokument es sich handelt – eine Rechnung, einen Vertrag, eine Bestellung, einen Beleg, einen Kontoauszug – und fügt Metadaten hinzu, die das nachgelagerte Verhalten steuern. In einem traditionellen System stützt sich die Klassifizierung auf Dateibenennungskonventionen, Ordnerpfade oder Vorlagenabgleich. In einer KI-gesteuerten Pipeline verwendet die Klassifizierung Natural-Language-Analyse: Der Agent liest den Dokumenteninhalt und bestimmt den Typ anhand semantischen Verständnisses.
Stufe 2 – Extraktion
Sobald der Dokumenttyp bekannt ist, zieht die Extraktion strukturierte Daten aus dem Dokument. Bei einer Rechnung bedeutet das Lieferantenname, Rechnungsnummer, Positionen, Summen, Steuerbeträge, Zahlungsbedingungen. Bei einem Vertrag bedeutet es Parteien, Wirksamkeitsdaten, Kündigungsklauseln, finanzielle Verpflichtungen. Die Extraktionsstufe wandelt unstrukturierte oder halbstrukturierte Dokumenteninhalte in ein strukturiertes Format (JSON, XML, Datenbankeinträge) um, das nachgelagerte Systeme nutzen können.
Stufe 3 – Validierung
Extrahierte Daten werden anhand von Geschäftsregeln geprüft. Stimmt die Rechnungssumme mit der Summe der Positionen überein? Ist der Lieferant in der Liste der zugelassenen Lieferanten? Ist der Vertrag von einem autorisierten Unterzeichner unterschrieben? Die Validierung erkennt Extraktionsfehler, markiert Anomalien und erzeugt einen Konfidenzwert, der bestimmt, ob das Dokument automatisch weitergeleitet werden kann oder eine menschliche Überprüfung erfordert.
Stufe 4 – Routing
Validierte Daten werden an das entsprechende nachgelagerte System gesendet: ein ERP für Rechnungsdaten, eine Vertragsmanagementplattform für Vertragsdaten, ein Dokumentenarchiv für alles andere. Routing kann auch nachgelagerte Workflows auslösen – Genehmigungsketten, Zahlungsabwicklung, Compliance-Prüfungen.
Menschliche Überprüfung ist ein Kontrollpfad und keine obligatorische Stufe: Dokumente, die die Validierung nicht bestehen oder unter einen Konfidenzschwellenwert fallen, können zur manuellen Prüfung weitergeleitet werden. Dadurch bleibt die vierstufige Pipeline für die Mehrheit der Dokumente linear, bietet aber einen kontrollierten Fallback für Randfälle.
Warum IDP mehr als einen KI-API-Aufruf benötigt
Jede Stufe hat unabhängige Fehlerarten. Die Klassifizierung kann einen Dokumenttyp falsch identifizieren. Die Extraktion kann Felder übersehen oder Werte halluzinieren. Die Validierung kann gültige Daten aufgrund zu strenger Regeln ablehnen. Das Routing kann aufgrund der Nichtverfügbarkeit nachgelagerter Systeme fehlschlagen. Eine robuste IDP-Pipeline behandelt jede Fehlerart unabhängig, mit Wiederholungslogik, Fallback-Verhalten und Audit-Protokollierung auf jeder Stufe.
3. Erstellen einer IDP-Pipeline in .NET
Eine Möglichkeit, diese Architektur in .NET zu implementieren, ist die Verwendung von Spire.Agent.Office, einem KI-Agenten-SDK, das Word-, Excel-, PowerPoint- und PDF-Dokumente über Natural-Language-Anweisungen verarbeitet. Das SDK stellt die AI()-Erweiterungsmethode für Dokumentobjekte (Document, PdfDocument, Workbook, Presentation) bereit, die eine AIOptions-Konfiguration akzeptiert und einen AIDocumentProcessor zurückgibt. Der Aufruf von ExecuteInstruction auf dem Prozessor führt die Anweisung aus und schreibt die Ausgabe in eine Datei, wobei ein AIResult mit den Eigenschaften Success und ErrorMessage zurückgegeben wird.
Voraussetzungen
<!-- NuGet package -->
<PackageReference Include="Spire.Agent.Office" Version="11.8.3" />
Die folgenden Beispiele konzentrieren sich auf die Pipeline-Architektur und die Spire.Agent.Office-Integration. Hilfsmethoden wie Ergebnisanalyse und nachgelagertes Routing werden der Kürze halber weggelassen.
3.1 Das Pipeline-Modell definieren
Die Pipeline benötigt Datenstrukturen, um Ergebnisse zwischen Stufen zu transportieren, und eine gemeinsame Konfiguration für den KI-Agenten.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Doc;
using Spire.Pdf;
using Spire.Xls;
using Spire.Presentation;
using System.Collections.Concurrent;

public class ClassificationResult
{
    public string DocumentType { get; set; } = "Unknown";
    public double Confidence { get; set; }
    public string SourceFile { get; set; } = string.Empty;
}

public class ExtractionResult
{
    public Dictionary<string, string> Fields { get; set; } = new();
    public List<Dictionary<string, string>> LineItems { get; set; } = new();
    public string OutputPath { get; set; } = string.Empty;
}

public class ValidationResult
{
    public bool IsValid { get; set; }
    public List<string> Errors { get; set; } = new();
    public List<string> Warnings { get; set; } = new();
    public double ValidationScore { get; set; }
}

public class PipelineResult
{
    // Stage 4 outcomes. RunPipelineAsync records one of them on every
    // path, and ProcessBatchAsync counts by them, so the batch report
    // always adds up: Successful + Flagged + Errored == Total.
    public const string Routed = "Routed";
    public const string NeedsReview = "Flagged for review";
    public const string Failed = "Failed";

    // Non-null defaults keep a failed result object complete, so the
    // batch aggregator never has to null-check stage outputs.
    public ClassificationResult Classification { get; set; } = new();
    public ExtractionResult Extraction { get; set; } = new();
    public ValidationResult Validation { get; set; } = new();
    public List<string> AuditLog { get; set; } = new();
    public string Status { get; set; } = string.Empty;
}

public class BatchResult
{
    public int Total { get; set; }
    public int Successful { get; set; }
    public int Flagged { get; set; }
    public int Errored { get; set; }
    public List<PipelineResult> Results { get; set; } = new();
}

// Routing policy shared by validation (§3.3) and orchestration (§3.4)
static class RoutingPolicy
{
    // Minimum validation score required for automatic routing.
    public const double AutoRouteThreshold = 0.7;

    // Confidence budget shared across all optional-field warnings.
    // Spending the whole budget must be able to push a valid document
    // below AutoRouteThreshold — otherwise the routing check in §3.4
    // is dead code. Allocating a fixed budget instead of a flat
    // per-field penalty keeps that true when optional fields change.
    public const double OptionalFieldBudget = 0.4;
}

// Shared agent configuration
static AIOptions CreateAgentOptions(string workDir)
{
    string spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN")
        ?? throw new InvalidOperationException("SPIRE_TOKEN not set.");

    AIOptions options = new AIOptions();
    options.SpireToken = spireToken;
    options.WorkDir = workDir;
    options.TimeoutMs = 300000;
    return options;
}
SpireToken wird zur Authentifizierung von Spire.Agent.Office verwendet. Das SDK verwaltet die KI-Serviceverbindung über AIOptions, sodass die Anwendung die zugrunde liegende Modell-API-Integration nicht direkt implementieren muss. WorkDir legt fest, wo der Agent während der Verarbeitung Zwischendateien speichert.
3.2 Dokumente mit einem KI-Agenten klassifizieren und extrahieren
Die Klassifizierung lädt das Dokument, bittet den Agenten, seinen Typ zu identifizieren, und schreibt das Ergebnis in eine JSON-Datei. Dasselbe Muster LoadFromFile → AI(options) → ExecuteInstruction funktioniert für jedes Dokumentformat – nur die Dokumentklasse ändert sich, und diese Zuordnung müssen Sie selbst schreiben. AI() bindet an einen konkreten Dokumenttyp: Ein PDF muss als PdfDocument geladen werden, eine Arbeitsmappe als Workbook, eine Präsentation als Presentation und eine Word-Datei als Document. Eine Datei an die falsche Klasse zu übergeben, fällt nicht auf einen generischen Reader zurück; es wird eine Ausnahme ausgelöst. Wählen Sie daher die Klasse anhand der Dateierweiterung aus, bevor Sie AI() aufrufen.
public ClassificationResult Classify(
    string filePath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string classifyPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-cls.json");

    string instruction =
        "Analyze this document and determine its type. " +
        "Return one of: Invoice, Contract, PurchaseOrder, " +
        "Receipt, BankStatement, Unknown. Include a confidence " +
        "score between 0 and 1. Save the result as JSON.";

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, classifyPath, new string[] { });
        }
    }

    if (result != null && result.Success && File.Exists(classifyPath))
    {
        return ParseClassification(
            File.ReadAllText(classifyPath), filePath);
    }

    return new ClassificationResult
    {
        DocumentType = "Unknown",
        Confidence = 0,
        SourceFile = filePath
    };
}
Die Extraktion verwendet typspezifische Anweisungen, um strukturierte Felder aus dem Dokument zu ziehen:
public ExtractionResult Extract(
    string filePath, string documentType, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);
    string extractPath = Path.Combine(outputDir,
        Path.GetFileNameWithoutExtension(filePath) + "-extract.xlsx");

    string instruction = documentType switch
    {
        "Invoice" =>
            "Extract all invoice fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: VendorName, " +
            "InvoiceNumber, IssueDate, DueDate, Subtotal, Tax, Total, " +
            "PONumber. Extract line items into a sheet named 'LineItems' " +
            "with columns: Description, Quantity, UnitPrice, Amount. " +
            "Write the extracted data to a structured Excel workbook.",

        "Contract" =>
            "Extract all contract fields and write them as key-value " +
            "pairs in a sheet named 'Fields' with columns 'Field' and " +
            "'Value'. Use these exact field names: Party1, Party2, " +
            "EffectiveDate, TerminationDate, ContractValue, " +
            "PaymentTerms, Signatory1, Signatory2. Extract key " +
            "obligations into a sheet named 'Obligations' with " +
            "columns: Description, Party, Deadline. Write the " +
            "extracted data to a structured Excel workbook.",

        "PurchaseOrder" =>
            "Extract all purchase order fields and write them as " +
            "key-value pairs in a sheet named 'Fields' with columns " +
            "'Field' and 'Value'. Use these exact field names: " +
            "PONumber, VendorName, IssueDate, ExpectedDeliveryDate, " +
            "ShippingAddress, Total. Extract requested items into a " +
            "sheet named 'LineItems' with columns: Description, " +
            "Quantity, UnitPrice, Amount. Write the extracted data " +
            "to a structured Excel workbook.",

        _ => "Extract all key fields and values from this document. " +
             "Write the extracted data to a structured Excel workbook."
    };

    string ext = Path.GetExtension(filePath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument doc = new PdfDocument())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".xlsx" || ext == ".xls")
    {
        using (Workbook doc = new Workbook())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation doc = new Presentation())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }
    else
    {
        using (Document doc = new Document())
        {
            doc.LoadFromFile(filePath);
            result = doc.AI(agentOptions).ExecuteInstruction(
                doc, instruction, extractPath, new string[] { });
        }
    }

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Extraction failed: {result?.ErrorMessage}");

    return ReadExtractionResult(extractPath);
}
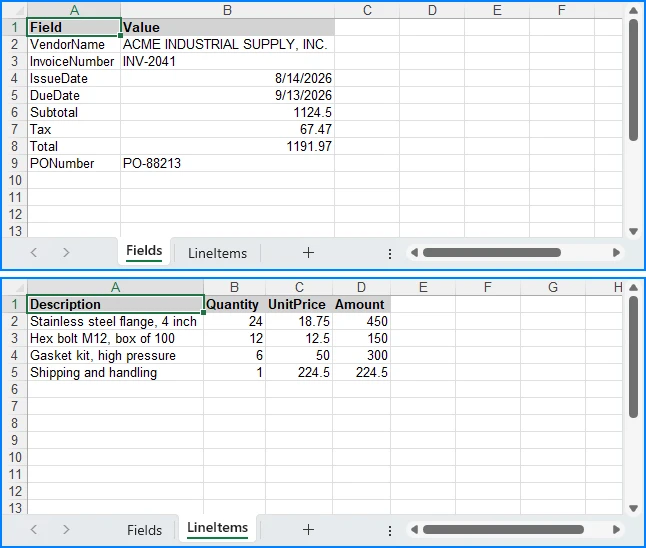
Jeder Dokumenttyp erhält eine eigene Anweisung, die dem Agenten sagt, nach welchen Feldern er suchen und welches Ausgabeformat er erzeugen soll. Der Agent liest das Quelldokument und schreibt eine strukturierte Excel-Arbeitsmappe nach extractPath. Die Anweisung legt die Form dieser Arbeitsmappe fest – die Benennung der Tabellenblätter, der Kopfzeilen und der exakten Feldnamen macht die Ausgabe nachgelagert parsebar. Eine Anweisung, die nur sagt: „Extrahiere die Rechnungsfelder“, kann bei jedem Lauf mit einem anderen Tabellennamen, einer anderen Kopfzeile oder einer anderen Schreibweise für dasselbe Feld zurückkommen, weil der Agent das Layout selbst festlegt. GetField im nächsten Abschnitt deckt die Variationen ab, die trotzdem durchrutschen.
Diese Trennung zwischen Agentenurteil und deterministischem Code wird ausführlicher in KI-Agent für die Dokumentenverarbeitung behandelt.
3.3 Extrahierte Daten mit C# validieren
Die Validierung ist reine C#-Logik – kein KI-Aufruf erforderlich. Der Agent hat bereits strukturierte Daten erzeugt; die Validierung prüft diese Daten anhand von Geschäftsregeln.
// Normalized field lookup: handles key variations like
// "VendorName" vs "Vendor Name" vs "vendor_name", and strips
// trailing qualifier words (e.g., "Total Amount Due" → "Total")
static string? GetField(
    Dictionary<string, string> fields, string key)
{
    string normalized = key.Replace(" ", "").ToLowerInvariant();
    foreach (var kvp in fields)
    {
        if (kvp.Key.Replace(" ", "").ToLowerInvariant() == normalized)
            return kvp.Value;
    }

    // Fallback: strip trailing qualifier words, one at a time, so
    // multi-word labels collapse all the way down to the field name
    // we asked for ("Total Amount Due" → "Total", "Invoice No"
    // → "Invoice"). Stripping is restarted after every match so the
    // result does not depend on the order of the suffix list.
    string[] suffixes = { "due", "amount", "no" };
    foreach (var kvp in fields)
    {
        string candidate = kvp.Key.Replace(" ", "")
            .ToLowerInvariant();

        bool stripped = true;
        while (stripped)
        {
            stripped = false;
            foreach (var suffix in suffixes)
            {
                if (candidate.Length > suffix.Length &&
                    candidate.EndsWith(suffix))
                {
                    candidate = candidate[..^suffix.Length];
                    stripped = true;
                    break;
                }
            }
        }

        if (candidate == normalized)
            return kvp.Value;
    }

    return null;
}

public ValidationResult Validate(
    ExtractionResult extracted, string documentType)
{
    var errors = new List<string>();
    var warnings = new List<string>();
    double confidence = 1.0;

    switch (documentType)
    {
        case "Invoice":
            // Rule 1a: Total must equal Subtotal + Tax. Runs only when
            // all three amounts were extracted — a missing Tax is
            // reported once, as a warning, instead of being turned
            // into a fabricated arithmetic error.
            var totalStr = GetField(extracted.Fields, "Total");
            var subtotalStr = GetField(extracted.Fields, "Subtotal");
            var taxStr = GetField(extracted.Fields, "Tax");

            if (decimal.TryParse(totalStr, out var total) &&
                decimal.TryParse(subtotalStr, out var subtotal) &&
                decimal.TryParse(taxStr, out var tax))
            {
                if (Math.Abs(total - (subtotal + tax)) > 0.01m)
                {
                    errors.Add(
                        $"Total mismatch: stated {total}, " +
                        $"calculated {subtotal + tax}");
                    confidence -= 0.3;
                }
            }

            // Rule 1b: Subtotal must equal the sum of the line items.
            // Line items are pre-tax, so they are checked against
            // Subtotal. Comparing them against the tax-inclusive Total
            // would reject every correctly extracted taxed invoice.
            if (decimal.TryParse(subtotalStr, out var subtotalBase) &&
                extracted.LineItems.Count > 0)
            {
                decimal lineItemSum = 0;
                foreach (var item in extracted.LineItems)
                {
                    var amtStr = GetField(item, "Amount");
                    if (decimal.TryParse(amtStr, out var amt))
                        lineItemSum += amt;
                }

                if (lineItemSum > 0 &&
                    Math.Abs(subtotalBase - lineItemSum) > 0.01m)
                {
                    errors.Add(
                        $"Line item mismatch: subtotal " +
                        $"{subtotalBase}, line items {lineItemSum}");
                    confidence -= 0.3;
                }
            }

            // Rule 2: Required fields must be present
            string[] required = { "VendorName", "InvoiceNumber",
                "IssueDate", "Total" };
            foreach (var field in required)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    errors.Add($"Missing required field: {field}");
                    confidence -= 0.15;
                }
            }

            // Warnings: optional fields reduce confidence
            // but do not invalidate the document
            string[] optional = { "PONumber", "DueDate", "Tax" };
            double optionalPenalty =
                RoutingPolicy.OptionalFieldBudget / optional.Length;
            foreach (var field in optional)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= optionalPenalty;
                }
            }
            break;

        case "Contract":
            var party1 = GetField(extracted.Fields, "Party1");
            var party2 = GetField(extracted.Fields, "Party2");
            if (string.IsNullOrEmpty(party1) ||
                string.IsNullOrEmpty(party2))
            {
                errors.Add(
                    "Contract must identify at least two parties");
                confidence -= 0.25;
            }

            // Warnings: missing optional contract metadata
            string[] optionalContract =
                { "EffectiveDate", "ContractValue", "PaymentTerms" };
            double contractPenalty =
                RoutingPolicy.OptionalFieldBudget / optionalContract.Length;
            foreach (var field in optionalContract)
            {
                var value = GetField(extracted.Fields, field);
                if (string.IsNullOrEmpty(value))
                {
                    warnings.Add(
                        $"Optional field missing: {field}");
                    confidence -= contractPenalty;
                }
            }
            break;

        default:
            // Uncovered document types require human review
            errors.Add(
                $"No validation rules for type '{documentType}'");
            confidence -= 0.5;
            break;
    }

    // Hard guard: zero extracted fields is always invalid
    if (extracted.Fields.Count == 0)
    {
        errors.Add("No fields were extracted from the document");
        confidence -= 0.5;
    }

    return new ValidationResult
    {
        IsValid = errors.Count == 0,
        Errors = errors,
        Warnings = warnings,
        ValidationScore = Math.Max(0, confidence)
    };
}
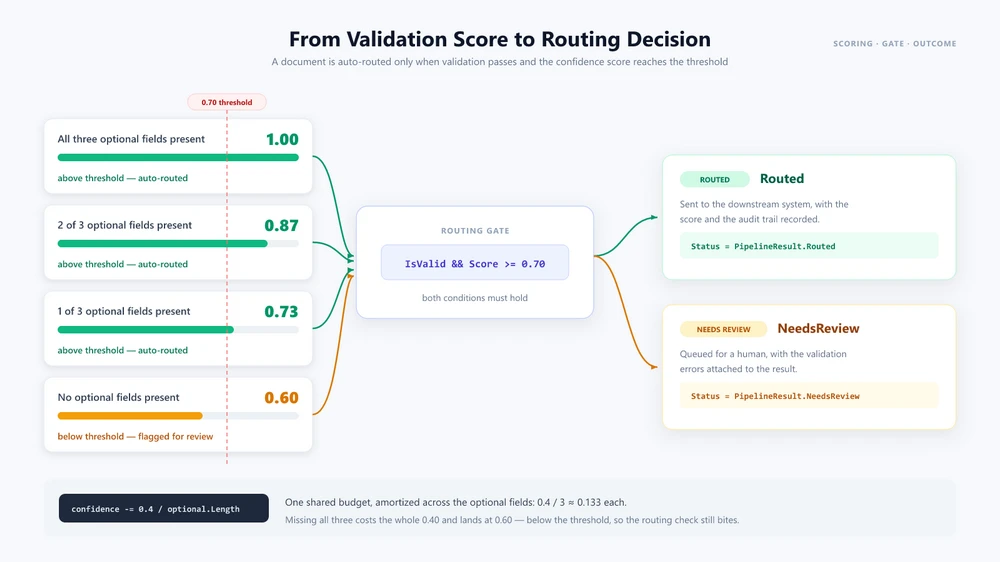
Die Validierung trennt harte Fehler von Qualitätswarnungen. Ein fehlendes Pflichtfeld, eine Summe, die nicht mit den Positionen abgestimmt werden kann, oder ein Dokumenttyp ohne Regeln erzeugt einen Eintrag in Errors, und das Dokument wird als ungültig behandelt. Ein optionales Feld, das nicht extrahiert werden konnte, senkt nur ValidationScore, sodass ein ansonsten einwandfreies Dokument weiterhin weitergeleitet wird. Der Abzug ist ein festes Budget, das über die optionalen Felder verteilt wird, statt einer pauschalen Strafe pro Feld: Bei drei optionalen Feldern und dem Budget von 0,4 im obigen Code hinterlässt ein fehlendes Feld einen Wert von 0,87 und zwei einen Wert von 0,73 – noch über der Auto-Routing-Schwelle von 0,7 –, sodass erst der Verlust aller drei den Wert auf 0,60 senkt und das Dokument zur Prüfung schickt. Diese beiden Signale getrennt zu halten, reserviert die menschliche Überprüfung für Dokumente, die sie tatsächlich benötigen.
3.4 Die Pipeline orchestrieren
Die Orchestrierungsmethode verbindet die Stufen miteinander und trifft Routing-Entscheidungen auf Grundlage der Validierungskonfidenz:
public async Task<PipelineResult> RunPipelineAsync(
    string filePath, string outputDir)
{
    var auditLog = new List<string>();
    string status;

    // Stage 1: Classify
    auditLog.Add($"[{DateTime.Now}] Classifying: {filePath}");
    var classification = Classify(filePath, outputDir);
    auditLog.Add($"  Type: {classification.DocumentType} " +
        $"(confidence: {classification.Confidence:P0})");

    // Stage 2: Extract
    auditLog.Add($"[{DateTime.Now}] Extracting fields...");
    var extraction = Extract(
        filePath, classification.DocumentType, outputDir);
    auditLog.Add($"  Extracted {extraction.Fields.Count} fields, " +
        $"{extraction.LineItems.Count} line items");

    // Stage 3: Validate
    auditLog.Add($"[{DateTime.Now}] Validating...");
    var validation = Validate(
        extraction, classification.DocumentType);
    auditLog.Add($"  Valid: {validation.IsValid}, " +
        $"Confidence: {validation.ValidationScore:P0}");

    if (!validation.IsValid)
    {
        foreach (var error in validation.Errors)
            auditLog.Add($"  ERROR: {error}");
    }

    // Stage 4: Route
    if (validation.IsValid &&
        validation.ValidationScore >= RoutingPolicy.AutoRouteThreshold)
    {
        auditLog.Add(
            $"[{DateTime.Now}] Routing to downstream system...");
        await RouteToDownstreamAsync(
            classification.DocumentType, extraction);
        auditLog.Add($"  Routed successfully");
        status = PipelineResult.Routed;
    }
    else
    {
        auditLog.Add(
            $"[{DateTime.Now}] Flagged for human review " +
            $"(confidence: {validation.ValidationScore:P0})");
        await FlagForReviewAsync(filePath, validation.Errors);
        status = PipelineResult.NeedsReview;
    }

    // Status is the stage-4 outcome the batch report counts by, so it
    // has to be set on every path out of this method.
    return new PipelineResult
    {
        Classification = classification,
        Extraction = extraction,
        Validation = validation,
        AuditLog = auditLog,
        Status = status
    };
}
Jede Stufe ist unabhängig testbar, hat ihre eigene Fehlerbehandlung und erzeugt Audit-Ausgaben. Das zurückgegebene PipelineResult zeichnet außerdem das Ergebnis der Stufe 4 in Status auf, was es dem Batch-Bericht im nächsten Abschnitt ermöglicht, Dokumente nach Ergebnis zu zählen, anstatt es aus der Validierungsnutzlast neu abzuleiten. In diesem Beispiel übernimmt der KI-Agent Klassifizierung und Extraktion durch Natural-Language-Anweisungen, während Validierung und Routing deterministische C#-Logik bleiben.
4. Batch- und Multi-Dokumentenverarbeitung
Eine Pipeline für einzelne Dokumente ist ein Ausgangspunkt. Produktions-IDP-Systeme verarbeiten täglich Hunderte oder Tausende von Dokumenten mit unterschiedlichen Typen, Prioritäten und nachgelagerten Zielen.
Parallele Batch-Verarbeitung
public async Task<BatchResult> ProcessBatchAsync(
    string inputDirectory, string outputDir,
    int maxConcurrency = 5)
{
    var files = Directory.GetFiles(inputDirectory);
    var semaphore = new SemaphoreSlim(maxConcurrency);
    var results = new ConcurrentBag<PipelineResult>();

    var tasks = files.Select(async file =>
    {
        await semaphore.WaitAsync();
        try
        {
            var result = await RunPipelineAsync(file, outputDir);
            results.Add(result);
        }
        catch (Exception ex)
        {
            results.Add(new PipelineResult
            {
                Status = $"{PipelineResult.Failed}: {ex.Message}",
                Validation = new ValidationResult
                {
                    IsValid = false,
                    Errors = new List<string> { ex.Message }
                },
                AuditLog = new List<string>
                    { $"Error processing {file}: {ex}" }
            });
        }
        finally
        {
            semaphore.Release();
        }
    });

    await Task.WhenAll(tasks);

    int successful = results.Count(
        r => r.Status == PipelineResult.Routed);
    int errored = results.Count(r => r.Status.StartsWith(
        PipelineResult.Failed));

    // Flagged is the remainder, so the report stays conserved by
    // construction: Successful + Flagged + Errored == Total. A result
    // that never reached stage 4 is counted as needing review instead
    // of being silently dropped from all three counters.
    return new BatchResult
    {
        Total = files.Length,
        Successful = successful,
        Flagged = results.Count - successful - errored,
        Errored = errored,
        Results = results.ToList()
    };
}
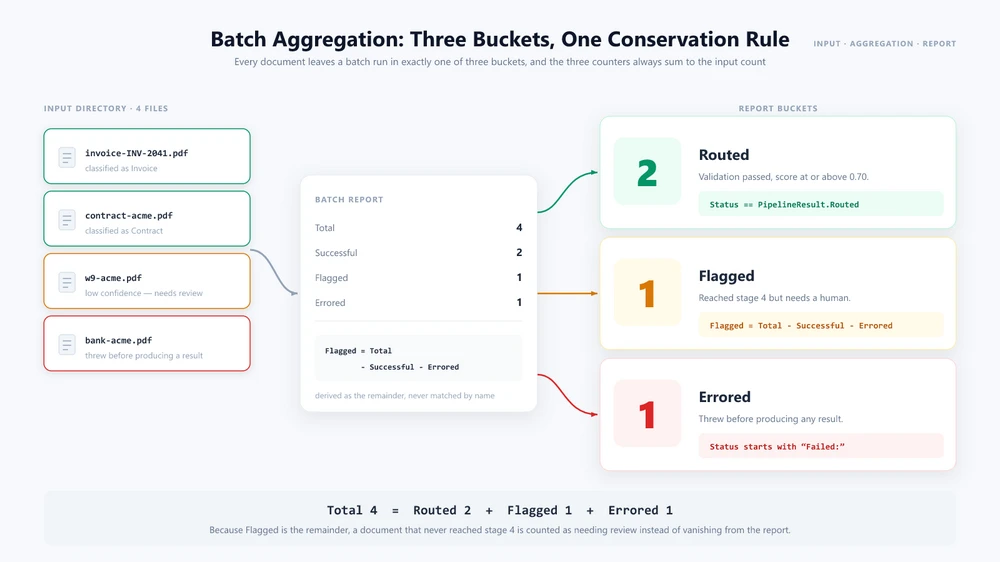
Der SemaphoreSlim begrenzt die Parallelität, um den KI-Service oder nachgelagerte Systeme nicht zu überlasten. Jedes Dokument wird unabhängig durch alle vier Stufen verarbeitet. Der Batch-Bericht sortiert die Ergebnisse in die drei Arten, wie ein Dokument die Pipeline verlassen kann: Routed (validiert und nachgelagert gesendet), Flagged (Stufe 4 erreicht, aber Überprüfung erforderlich) und Errored (Ausnahme vor Erzeugung eines Ergebnisses). Flagged wird als Rest berechnet, anstatt einen Status-String abzugleichen, sodass die drei Zähler immer Total ergeben – ein Dokument, das unerwartet fehlschlägt, wird als überprüfungsbedürftig gemeldet, anstatt aus dem Bericht zu verschwinden. Das angemessene Parallelitätslimit hängt von den Ratenbegrenzungen des KI-Service, der Dokumentgröße und den Anwendungsressourcen ab.
Dokumentübergreifende Workflows
Einige Geschäftsprozesse erfordern, dass mehrere Dokumente zusammen verarbeitet werden. Ein US-amerikanischer Lieferanten-Onboarding-Workflow könnte beispielsweise ein Steuerformular, einen Vertrag und einen Kontoauszug als eine Einheit verarbeiten – Daten aus jedem extrahieren, gegenseitig validieren und eine kombinierte Ausgabe erzeugen.
public async Task<OnboardingResult> ProcessVendorOnboardingAsync(
    string w9Path, string contractPath,
    string bankStatementPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    // Process all three documents in parallel
    var w9Task = RunPipelineAsync(w9Path, outputDir);
    var contractTask = RunPipelineAsync(contractPath, outputDir);
    var bankTask = RunPipelineAsync(bankStatementPath, outputDir);

    try
    {
        await Task.WhenAll(w9Task, contractTask, bankTask);
    }
    catch (Exception ex)
    {
        return new OnboardingResult
        {
            Status = "Failed",
            Issue = $"Document processing failed: {ex.Message}"
        };
    }

    var w9 = w9Task.Result;
    var contract = contractTask.Result;
    var bank = bankTask.Result;

    // Cross-validate: names must match across all documents
    var w9Name = GetField(w9.Extraction.Fields, "VendorName");
    var contractName = GetField(contract.Extraction.Fields, "Party2");
    var bankName = GetField(bank.Extraction.Fields, "AccountHolder");

    if (w9Name == null || contractName == null || bankName == null)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = "Could not extract vendor name from one or more documents"
        };
    }

    if (w9Name != contractName || contractName != bankName)
    {
        return new OnboardingResult
        {
            Status = "Flagged",
            Issue = $"Name mismatch: W-9='{w9Name}', " +
                $"Contract='{contractName}', Bank='{bankName}'"
        };
    }

    // Generate combined onboarding summary using the agent
    string summaryPath = Path.Combine(outputDir,
        $"onboarding-{w9Name}.docx");
    string[] attachments = { w9Path, contractPath, bankStatementPath };

    string summaryInstruction =
        $"Create a vendor onboarding summary for {w9Name}. " +
        "Read the attached W-9, contract, and bank statement. " +
        "Compile the vendor's legal name, tax ID, contract terms, " +
        "and banking details into a formatted Word document. " +
        "Save the summary to the output path.";

    using (Document summary = new Document())
    {
        summary.LoadFromFile(
            Path.Combine(AppContext.BaseDirectory,
                "templates", "onboarding-summary.docx"));

        AIResult result = summary.AI(agentOptions).ExecuteInstruction(
            summary, summaryInstruction, summaryPath, attachments);

        return new OnboardingResult
        {
            Status = result != null && result.Success
                ? "Complete" : "Failed",
            SummaryPath = result != null && result.Success
                ? summaryPath : null,
            Error = result?.ErrorMessage
        };
    }
}
Der Parameter attachments übergibt mehrere Dokumentpfade an den Agenten in einem einzigen Aufruf. Der Agent liest alle angehängten Dateien, schließt daraus und erzeugt eine kombinierte Ausgabe. Dies geht über die Texterkennungsrolle traditioneller OCR hinaus, indem es einem KI-Modell ermöglicht, über mehrere Dokumenteingaben zu schließen.
Wiederholung und menschliche Überprüfung
public async Task<PipelineResult> RunPipelineWithRetryAsync(
    string filePath, string outputDir, int maxRetries = 3)
{
    string lastError = "unknown";

    for (int attempt = 1; attempt <= maxRetries; attempt++)
    {
        try
        {
            var result = await RunPipelineAsync(filePath, outputDir);

            if (result.Validation.IsValid)
                return result;

            // Borderline confidence: retry in case the next pass
            // classifies or extracts the document differently
            if (result.Validation.ValidationScore >= 0.5 &&
                attempt < maxRetries)
            {
                continue;
            }

            return result;
        }
        catch (Exception ex)
        {
            lastError = ex.Message;

            if (attempt < maxRetries)
            {
                await Task.Delay(
                    TimeSpan.FromSeconds(Math.Pow(2, attempt)));
            }
        }
    }

    // Every attempt threw, so the loop ran out instead of returning.
    return new PipelineResult
    {
        Status = $"{PipelineResult.Failed} after {maxRetries} retries: " +
            lastError
    };
}
Dokumente, die die Validierung nicht bestehen oder unter den Konfidenzschwellenwert fallen, werden für die menschliche Überprüfung markiert, anstatt stillschweigend fehlzuschlagen. Die Wiederholungsstrategie verwendet exponentielles Backoff für vorübergehende Fehler und unternimmt erneute Versuche bei Grenzfällen, falls ein zweiter Durchlauf sie anders klassifiziert oder extrahiert.
5. IDP in der Praxis
Dieser Abschnitt zeigt, wie die Pipeline reale Geschäftsszenarien verarbeitet, die mehrere Dokumenttypen in einem einzigen Workflow umfassen.
Automatisierung der Kreditorenbuchhaltung
Eine Kreditorenbuchhaltungsabteilung erhält Rechnungen in gemischten Formaten – PDF, Excel, Word, gescannte Bilder. Jede Rechnung muss klassifiziert, extrahiert, gegen eine Bestellung validiert und an das ERP-System weitergeleitet werden.
public async Task<APResult> ProcessInvoiceAsync(
    string invoicePath, string outputDir)
{
    // Stages 1-3: Standard pipeline
    var pipeline = await RunPipelineAsync(invoicePath, outputDir);

    if (!pipeline.Validation.IsValid)
        return new APResult
        {
            Status = "Requires review",
            Errors = pipeline.Validation.Errors
        };

    // Cross-reference with purchase order
    var poNumber = GetField(pipeline.Extraction.Fields, "PONumber");
    if (string.IsNullOrEmpty(poNumber))
        return new APResult { Status = "No PO reference" };

    var poData = await _erpService.GetPurchaseOrderAsync(poNumber);
    if (poData == null)
        return new APResult { Status = "PO not found in ERP" };

    // Three-way match: invoice vs PO vs goods receipt
    var grData = await _erpService.GetGoodsReceiptAsync(poNumber);
    var matchResult = ThreeWayMatch(
        pipeline.Extraction, poData, grData);

    if (matchResult.IsMatch)
    {
        await _erpService.PostInvoiceForPaymentAsync(
            pipeline.Extraction);
        return new APResult { Status = "Posted for payment" };
    }

    return new APResult
    {
        Status = "Three-way match failed",
        Discrepancies = matchResult.Discrepancies
    };
}
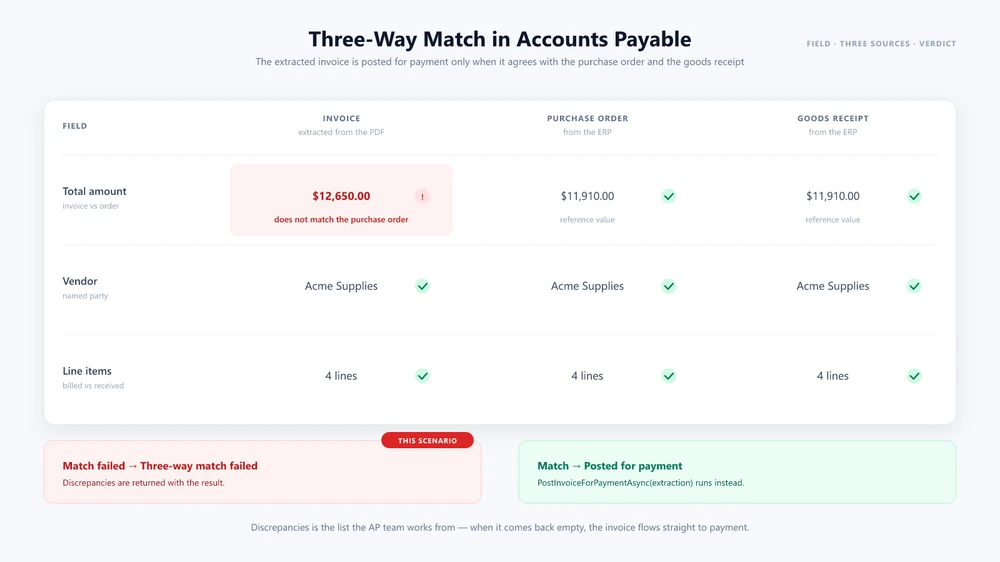
Das Tutorial zur Rechnungsverarbeitung behandelt dieses Szenario end-to-end: die Extraktionsanweisung, den Bestellvergleich und den Bericht, den das Finanzsystem konsumiert.
Vertragsanalyse
Ein Rechtsteam erhält Verträge von externen Parteien. Jeder Vertrag muss analysiert, Schlüsselbegriffe extrahiert, mit der Standardvorlage des Unternehmens verglichen und zur Überprüfung weitergeleitet werden, wenn nicht standardmäßige Klauseln gefunden werden. Der Agent verarbeitet den eingehenden Vertrag mit der angehängten Standardvorlage als Referenzdokument.
public async Task<ContractAnalysisResult> AnalyzeContractAsync(
    string contractPath, string outputDir)
{
    AIOptions agentOptions = CreateAgentOptions(outputDir);

    string analysisPath = Path.Combine(outputDir,
        $"contract-analysis-{DateTime.Now:yyyyMMdd}.docx");

    string[] attachments =
        { Path.Combine(AppContext.BaseDirectory,
            "templates", "standard-contract.docx") };

    string instruction =
        "Analyze this contract and compare it to the attached " +
        "standard template. Identify non-standard clauses, unusual " +
        "risk terms, or missing provisions. Generate a redline " +
        "summary document highlighting the differences and save " +
        "it to the output path.";

    string ext = Path.GetExtension(contractPath).ToLowerInvariant();
    AIResult? result = null;

    if (ext == ".pdf")
    {
        using (PdfDocument contract = new PdfDocument())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else if (ext == ".pptx" || ext == ".ppt")
    {
        using (Presentation contract = new Presentation())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }
    else
    {
        using (Document contract = new Document())
        {
            contract.LoadFromFile(contractPath);
            result = contract.AI(agentOptions).ExecuteInstruction(
                contract, instruction, analysisPath, attachments);
        }
    }

    return new ContractAnalysisResult
    {
        Success = result != null && result.Success,
        AnalysisPath = result != null && result.Success
            ? analysisPath : null,
        Error = result?.ErrorMessage
    };
}
Dieser Workflow kombiniert Extraktion, dokumentübergreifenden Vergleich und Dokumentenerzeugung in einem Prozess und veranschaulicht, wie ein KI-Agent eine traditionelle IDP-Pipeline über die strukturierte Feldextraktion hinaus erweitern kann. Vertragsspezifische Muster – Überprüfung, Extraktion und Generierung aus einer Vorlage – werden im Leitfaden zur KI-Vertragsprüfung behandelt.
6. Eigenentwicklung vs. Kauf: Wahl eines IDP-Ansatzes
Der IDP-Markt wird von SaaS-Plattformen dominiert. Dieser Abschnitt hilft Entwicklern zu entscheiden, wann das Erstellen einer Pipeline in .NET die richtige Wahl ist und wann die Einführung einer Anbieterplattform praktischer ist.
Eigenentwicklung, wenn Sie eine enge Integration mit einer vorhandenen .NET-Anwendung, benutzerdefinierte Validierungsregeln oder Dokumentenerzeugung und -transformation neben der Extraktion benötigen. Das Erstellen der Orchestrierungsschicht in .NET gibt Ihnen mehr Kontrolle darüber, wo Dokumente gespeichert und wie sie verarbeitet werden. Die tatsächliche Datenresidenz hängt vom KI-Modell und der Servicekonfiguration ab.
Kauf, wenn OCR-intensive Workloads, vorgefertigte Extraktionsmodelle, verwaltete Infrastruktur oder schnelle Bereitstellung Priorität haben. Wenn Ihr Team keine .NET-Expertise hat oder sich auf andere Prioritäten konzentriert, nimmt eine verwaltete Plattform die Implementierungslast ab.
Entscheidungsrahmen:
| Faktor | Eigenentwicklung (.NET + KI-Agent) | Kauf (SaaS-IDP) |
|---|---|---|
| Integration | In-Process, .NET-nativ | Externer API-Aufruf |
| Datenresidenz | Abhängig von der Modellkonfiguration | Anbieter-Cloud |
| Dokumentoperationen | Extrahieren + Generieren + Transformieren + Konvertieren | Abhängig von der Plattform |
| Benutzerdefinierte Validierung | Volle Code-Kontrolle | Plattformkonfiguration |
| Benutzerdefinierter Workflow | Volle Code-Kontrolle | Plattformabhängig |
| Zeit bis zur Produktion | Wochen bis Monate | Tage bis Wochen |
| Kostenmodell | Feste API-Kosten + SDK-Lizenz | Preis pro Dokument |
Die richtige Wahl hängt von den Anforderungen Ihrer Anwendung, den Fähigkeiten Ihres Teams und den Dokumenttypen ab, die Sie verarbeiten. Viele Teams verwenden einen hybriden Ansatz: eine Anbieterplattform für die Massenextraktion standardisierter Formulare und eine benutzerdefinierte .NET-Pipeline für komplexe Workflows, die Dokumentenerzeugung, dokumentübergreifendes Schließen oder enge Systemintegration erfordern.
7. Häufig gestellte Fragen
Was ist intelligente Dokumentenverarbeitung (IDP)?
Intelligente Dokumentenverarbeitung ist ein Automatisierungsansatz, der KI und maschinelles Lernen verwendet, um Dokumente zu klassifizieren, strukturierte Daten zu extrahieren, die Ergebnisse anhand von Geschäftsregeln zu validieren und die Ausgabe an nachgelagerte Systeme weiterzuleiten. Im Gegensatz zur traditionellen OCR, die in erster Linie visuelle Inhalte in maschinenlesbaren Text umwandelt, fügt IDP Dokumentenklassifizierung, semantische Extraktion, Validierung und Workflow-Automatisierung hinzu. Es kann unterschiedliche Dokumentenlayouts verarbeiten, ohne sich vollständig auf feste Vorlagen zu verlassen.
Wie unterscheidet sich eine IDP-Pipeline von einem einzelnen LLM-API-Aufruf?
Ein einzelner LLM-Aufruf verarbeitet Text, behandelt aber keine Dateiformate, führt keine Dokumentoperationen aus und verwaltet keinen Pipeline-Zustand. Eine IDP-Pipeline orchestriert mehrere Stufen – Klassifizierung, Extraktion, Validierung, Routing –, jede mit unabhängiger Fehlerbehandlung, Wiederholungslogik und Audit-Protokollierung. Die Pipeline überbrückt außerdem KI-Schlussfolgerungen mit deterministischer Dateibearbeitung und stellt sicher, dass die Ausgabe die korrekte Formatierung beibehält.
Kann ich eine IDP-Pipeline ohne eine Anbieterplattform erstellen?
Ja. Mit einem .NET-KI-Agenten-SDK wie Spire.Agent.Office können Sie alle vier Pipeline-Stufen in C# implementieren. Das SDK bietet Natural-Language-Dokumentenverarbeitung für Word-, Excel-, PowerPoint- und PDF-Dateien mit deterministischer Dateiausgabe. Dieser Ansatz gibt volle Kontrolle über Validierungslogik und Routing-Regeln.
Welche Dokumentformate verarbeitet eine IDP-Pipeline?
Mit Spire.Agent.Office verarbeitet die Pipeline Word- (.docx, .doc), Excel- (.xlsx, .xls), PowerPoint- (.pptx, .ppt) und PDF-Dateien. Gescannte Dokumente können je nach Dokument und Verarbeitungs-Workflow einen OCR-Schritt vor der KI-basierten Extraktion erfordern. Die Pipeline kann im Rahmen der Routing-Stufe auch zwischen Formaten konvertieren.
Wie verbindet sich der KI-Agent mit dem Sprachmodell?
Spire.Agent.Office verwendet eine SpireToken-Eigenschaft in AIOptions, um sich beim KI-Service zu authentifizieren. Das SDK verwaltet die KI-Serviceverbindung über AIOptions, sodass die Anwendung die zugrunde liegende Modell-API-Integration nicht direkt implementieren muss. Dieses Design trennt Dokumentenverarbeitung von Modellkonfiguration, sodass Ihr Pipeline-Code unabhängig davon gleich bleibt, welches Modell den Agenten antreibt.
Wie genau ist die KI-basierte Dokumentenextraktion?
Die Extraktionsgenauigkeit hängt stark von der Dokumentqualität, Layoutvariabilität, OCR-Qualität, dem Modellverhalten und den Extraktionsanweisungen ab. Produktionssysteme sollten extrahierte Werte anhand deterministischer Geschäftsregeln validieren und unsichere Fälle zur menschlichen Überprüfung weiterleiten. Die Validierungsstufe trägt dazu bei, KI-basierte Extraktion in der Produktion zuverlässiger zu machen, indem sie extrahierte Werte gegen deterministische Regeln prüft und unsichere Ergebnisse zur Überprüfung weiterleitet.
Was ist der Unterschied zwischen IDP und OCR?
OCR (Optical Character Recognition) wandelt visuellen Dokumenteninhalt in maschinenlesbaren Text um. IDP baut auf dieser Fähigkeit auf, fügt aber KI-gesteuertes Verständnis, Validierung und Workflow-Automatisierung hinzu. Eine IDP-Pipeline kann OCR intern für gescannte Dokumente verwenden, aber OCR allein klassifiziert keine Dokumente, validiert keine extrahierten Daten und leitet keine Ergebnisse an nachgelagerte Systeme weiter.
Wie funktioniert die Batch-Verarbeitung in einer IDP-Pipeline?
Die Batch-Verarbeitung führt die Pipeline gleichzeitig über mehrere Dokumente aus, mit konfigurierbaren Parallelitätslimits zur Verwaltung der Ressourcennutzung. Jedes Dokument wird unabhängig durch alle vier Stufen verarbeitet, wobei die Ergebnisse in einem Batch-Bericht aggregiert werden. Fehlgeschlagene Dokumente werden zur Überprüfung markiert, ohne den Rest des Batches zu blockieren.
Bereit, eine IDP-Pipeline zu erstellen?
Wenn Sie intelligente Dokumentenverarbeitung in einer .NET-Anwendung erstellen, beginnen Sie mit dem Erste-Schritte-Leitfaden für Spire.Agent.Office, der die Installation des SDK und die Ausführung Ihrer ersten Anweisung in .NET behandelt.
Weiterführende Lektüre
- KI-Agent vs. reine LLM-API: Dokumentenschicht in .NET — was eine Dokumentenschicht gegenüber einem reinen LLM-API-Aufruf hinzufügt und wann welcher Ansatz passt
- Dokumente mit KI in C# in PowerPoint-Präsentationen umwandeln — dasselbe anweisungsgesteuerte Muster, angewendet auf Folienausgabe