Dokumente, die im Kundenservice, im Finanzwesen, im Personalwesen und in rechtlichen Arbeitsabläufen verwendet werden, enthalten häufig Namen, E-Mail-Adressen, Telefonnummern, Wohnadressen, Kontonummern und andere sensible Informationen. Bevor diese Dateien weitergegeben, archiviert oder für Analysen verwendet werden können, müssen die identifizierenden Inhalte möglicherweise entfernt oder ersetzt werden.
Traditionelle Schwärzungsprogramme basieren auf vordefinierten Suchregeln und separater Verarbeitungslogik für jedes Dokumentformat. Ein KI-Agent-SDK bietet einen anderen Ansatz: Entwickler können die Schwärzungsanforderung in natürlicher Sprache beschreiben, sodass der Agent sensible Informationen identifizieren und die entsprechenden Office-Dokumentelemente ändern kann. Dieser Artikel zeigt, wie Sie Word-, Excel- und PowerPoint-Dateien in C# schwärzen und dabei ihre ursprüngliche Struktur und Formatierung beibehalten.
Was ist Dokumentenschwärzung?
Dokumentenschwärzung ist der Prozess des Entfernens oder Ersetzens von Informationen, die nicht offengelegt werden dürfen. Häufige Ziele einer Schwärzung sind:
- Persönliche Namen
- E-Mail-Adressen
- Telefon- und Faxnummern
- Wohn- oder Postanschriften
- Geburtsdaten
- Kunden- und Mitarbeiterkennungen
- Bank- und Kontonummern
- Sonstige vertrauliche oder personenbezogene Informationen
Bei bearbeitbaren Office-Dateien umfasst die Schwärzung mehr als nur das Ändern von reinem Text. Sensible Inhalte können in Word-Absätzen und -Tabellen, Excel-Zellen, PowerPoint-Formen, Kopf- und Fußzeilen oder anderen Dokumentelementen vorkommen. Ein brauchbarer Schwärzungs-Workflow sollte den erkannten Wert entfernen, ohne das umgebende Layout, die Formatvorlagen, Bilder, Diagramme oder die Dokumentstruktur unnötig zu verändern.
Drei Möglichkeiten, Office-Dokumente in C# zu schwärzen
Es gibt drei allgemeine Implementierungsansätze: traditionelle Dokument-APIs, eine direkte LLM-Integration und ein KI-Agent-SDK.
Traditionelle API-basierte Schwärzung
Eine traditionelle Implementierung beginnt normalerweise mit exaktem Textersatz oder regulären Ausdrücken. Beispielsweise bietet Spire.Doc for .NET APIs zum Suchen und Ersetzen von Text in Word-Dokumenten.
Der folgende vereinfachte Pseudocode veranschaulicht einen regelbasierten Schwärzungs-Workflow. Er ist absichtlich unvollständig und zeigt nur die wesentlichen Aufgaben, die die Anwendung übernehmen müsste.
Document document = new Document();
document.LoadFromFile("Input.docx");

// Patterns must be defined and maintained by the developer.
Regex emailPattern = new Regex("...");
Regex phonePattern = new Regex("...");
Regex accountPattern = new Regex("...");

document.Replace(emailPattern, "[REDACTED]");
document.Replace(phonePattern, "[REDACTED]");
document.Replace(accountPattern, "[REDACTED]");

// Additional logic may still be required for different content containers.
foreach (Section section in document.Sections)
{
    ProcessParagraphs(section);
    ProcessTables(section.Tables);
    ProcessHeadersAndFooters(section.HeadersFooters);
    ProcessTextBoxes(section);
}

document.SaveToFile("Redacted.docx", FileFormat.Docx);
Dieser Ansatz funktioniert gut, wenn die sensiblen Werte vorhersehbaren Mustern folgen. E-Mail-Adressen, Telefonnummern und standardisierte Identifikationsnummern lassen sich oft mit regulären Ausdrücken finden.
Die Schwierigkeit nimmt zu, wenn die Informationen vom Kontext abhängen. Ein Programm muss möglicherweise feststellen, ob ein Wort ein Personenname ist, ob eine Zahl eine Kontonummer oder eine Rechnungsnummer ist und ob ein Ort eine private Adresse oder eine öffentliche Firmenadresse ist. Entwickler müssen außerdem unterschiedliche Durchlauf- und Ersetzungslogik für Word, Excel und PowerPoint hinzufügen.
Direkte LLM-Integration
Ein großes Sprachmodell kann Kontexte effektiver verstehen als eine Sammlung regulärer Ausdrücke. Beispielsweise kann es einen Personennamen in einem Satz erkennen, auch wenn der Name keinem vorhersehbaren Muster folgt.
Ein LLM bietet jedoch nicht automatisch eine vollständige Verarbeitung von Office-Dokumenten. Eine direkte Integration erfordert in der Regel, dass die Anwendung:
- Text aus jedem relevanten Dokumentelement extrahiert.
- Den Inhalt in geeignete Anfragen aufteilt.
- Den extrahierten Text an das Modell sendet.
- Die Ergebnisse des Modells den ursprünglichen Absätzen, Zellen oder Formen zuordnet.
- Die sensiblen Inhalte ersetzt, ohne deren Formatierung zu verlieren.
- Die geänderte Datei im ursprünglichen Format speichert.
Wenn das Dokument vor dem Senden an das Modell in reinen Text umgewandelt wird, können Informationen über Tabellen, Textbereiche, Schriftarten, Ausrichtung und andere Layout-Eigenschaften verloren gehen. Der Entwickler bleibt daher dafür verantwortlich, die semantischen Ergebnisse des Modells mit dem Office-Dokumentobjektmodell zu verbinden.
KI-Agent-SDK
Ein KI-Agent-SDK kombiniert natürlichsprachliches Verständnis mit Dokumentverarbeitungsfunktionen. Anstatt jede Erkennungsregel zu definieren und jeden Ersetzungsschritt manuell zu koordinieren, stellt der Entwickler das Dokument bereit und beschreibt das gewünschte Ergebnis.
Spire.Agent.Office nutzt die zugrunde liegenden Funktionen von Spire.Office for .NET, um mit Word-, Excel- und PowerPoint-Objekten zu arbeiten. In einem Word-Dokument kann die Verarbeitungsschicht beispielsweise auf Abschnitte, Absätze, Textbereiche, Tabellen, Zellen, Kopf- und Fußzeilen, Bilder, Hyperlinks und deren Formatierung zugreifen. Das Modell identifiziert die sensiblen Inhalte, während die Dokument-APIs die entsprechenden Elemente ändern.
Diese Verarbeitung auf Objektebene ermöglicht es, Text zu ersetzen und gleichzeitig die umgebende Struktur und die Formatvorlagen des Dokuments beizubehalten.
Traditionelle API vs. LLM vs. KI-Agent-SDK
| Ansatz | Kontextbezogene Erkennung | Formaterhalt | Implementierung für mehrere Formate | Entwicklungsaufwand | Am besten geeignet für |
|---|---|---|---|---|---|
| Traditionelle API und reguläre Ausdrücke | Begrenzt, sofern keine zusätzliche NLP-Logik hinzugefügt wird | Stark und kontrollierbar | In der Regel ist eine separate Logik erforderlich | Hoch | Feste Muster und hochgradig deterministische Regeln |
| Office-API mit direkten LLM-Aufrufen | Stark | Muss vom Entwickler implementiert werden | Extraktions- und Rückschreiblogik ist für jedes Format erforderlich | Sehr hoch | Vollständig angepasste KI-Pipelines |
| KI-Agent-SDK | Stark | Wird durch dokumentbewusste Verarbeitung gehandhabt | Eine gemeinsame Anweisung kann auf mehrere Office-Formate angewendet werden | Geringer | Kontextbewusste Schwärzung mit weniger Orchestrierungscode |
Der traditionelle Ansatz bleibt nützlich, wenn jedes Schwärzungsziel einem bekannten Muster folgt und die Anwendung ein streng deterministisches Verhalten erfordert. Der Ansatz mit dem Agent-SDK wird attraktiver, wenn Dokumente vielfältige, kontextabhängige Informationen enthalten oder wenn derselbe Workflow mehrere Office-Formate unterstützen muss.
Einrichten des C#-Projekts
Erstellen Sie eine C#-Konsolenanwendung und fügen Sie dem Projekt Spire.Agent.Office sowie die erforderlichen Abhängigkeiten hinzu. Außerdem benötigen Sie ein gültiges SpireToken für die KI-Verarbeitung.
Das folgende Beispiel unterstützt die folgenden Formate:
- Word: DOC und DOCX
- Excel: XLS und XLSX
- PowerPoint: PPT und PPTX
PDF ist in diesem Beispiel nicht enthalten.
Word-, Excel- und PowerPoint-Dokumente mit einem KI-Agenten schwärzen
Der folgende Code ermittelt das Quellformat anhand seiner Dateiendung, lädt das entsprechende Office-Dokumentobjekt und übergibt dieselbe Schwärzungsanweisung an den KI-Prozessor.
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Presentation;
using Spire.Doc;
using Spire.Xls;

string inputPath = @"E:\Documents\Input.docx";
string outputPath = @"E:\Documents\Redacted.docx";
string spireToken = "your spireToken";

string instruction = """
Find personal information such as names, email addresses, phone numbers, addresses,
account numbers, and other sensitive information. Replace the detected content with
“[REDACTED]” while preserving the original document structure and formatting.
""";

// Configure the AI processing options
AIOptions options = new AIOptions();
options.SpireToken = spireToken;

// Select the appropriate document object according to the file extension
string extension = Path.GetExtension(inputPath).ToLower();

if (extension == ".doc" || extension == ".docx")
{
    using (Document document = new Document())
    {
        document.LoadFromFile(inputPath);
        AIDocumentProcessor processor = document.AI(options);
        processor.ExecuteInstruction(
            document,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".xls" || extension == ".xlsx")
{
    using (Workbook workbook = new Workbook())
    {
        workbook.LoadFromFile(inputPath);
        AIDocumentProcessor processor = workbook.AI(options);
        processor.ExecuteInstruction(
            workbook,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
else if (extension == ".ppt" || extension == ".pptx")
{
    using (Presentation presentation = new Presentation())
    {
        presentation.LoadFromFile(inputPath);
        AIDocumentProcessor processor = presentation.AI(options);
        processor.ExecuteInstruction(
            presentation,
            instruction,
            outputPath,
            Array.Empty<string>());
    }
}
Wenn implizite globale using-Direktiven in Ihrem Projekt deaktiviert sind, fügen Sie außerdem using System; und using System.IO; für Array und Path hinzu.
Eingabe, Ausgabe und Anweisung definieren
inputPath gibt das Quelldokument an, während outputPath angibt, wo die geschwärzte Datei gespeichert wird. Die Dateiendungen von Ein- und Ausgabe sollten übereinstimmen, damit das Ergebnis im ursprünglichen Format bleibt.
Die Anweisung in natürlicher Sprache legt sowohl den Erkennungsumfang als auch die erforderliche Änderung fest. In diesem Beispiel sucht der Agent nach gängigen Arten personenbezogener Informationen und ersetzt sie durch [REDACTED].
Sie können die Anweisung für einen enger gefassten Workflow anpassen. Zum Beispiel:
Find email addresses, phone numbers, and customer account numbers. Replace each detected value with “[REDACTED]”. Do not redact company names, product names, invoice numbers, or dates. Preserve the original layout and formatting.
Das Hinzufügen ausdrücklicher Ausschlüsse kann Fehlalarme reduzieren, wenn ein Dokument Geschäftskennungen enthält, die personenbezogenen Kontonummern ähneln.
KI-Verarbeitung konfigurieren
AIOptions speichert das SpireToken, das vom KI-Verarbeitungsdienst verwendet wird:
AIOptions options = new AIOptions();
options.SpireToken = spireToken;
Dasselbe Optionsobjekt kann mit der Word-, Excel- oder PowerPoint-Dokumentinstanz verwendet werden.
Den passenden Dokumenttyp auswählen
Das Programm liest die Dateiendung und erstellt das entsprechende Objekt:
-
Documentfür Word-Dateien -
Workbookfür Excel-Dateien -
Presentationfür PowerPoint-Dateien
Jedes Objekt stellt die Erweiterungsmethode AI() bereit. Diese gibt einen AIDocumentProcessor zurück, der die Anweisung in natürlicher Sprache auf das geladene Dokument anwendet.
Das leere Anlagen-Array zeigt an, dass die Anweisung keine unterstützenden Dateien erfordert:
processor.ExecuteInstruction(
    document,
    instruction,
    outputPath,
    Array.Empty<string>());
Ergebnis der Schwärzung
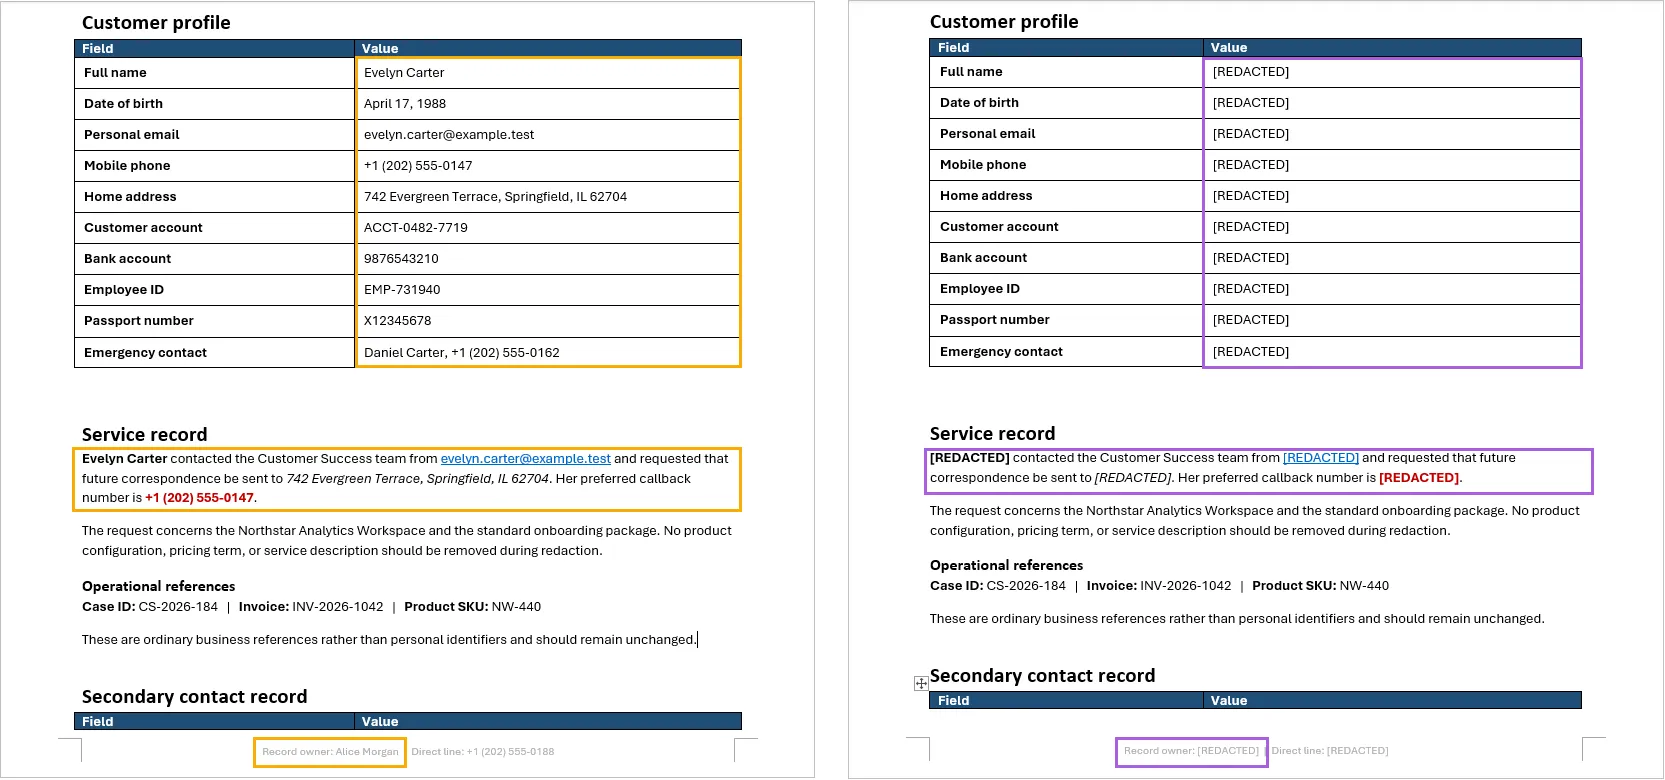
Im Word-Testdokument erschienen sensible Informationen in normalen Absätzen, einer Kundendaten-Tabelle und der Seitenfußzeile. Nach der Verarbeitung wurden die Namen, E-Mail-Adressen, Telefonnummern, Adressen und Kontoinformationen durch [REDACTED] ersetzt.
Die Tabellenstruktur, die Absatzformatierung, die Überschriften, die Farben und das Layout der Fußzeile blieben erhalten. Dieses Ergebnis ist wichtig, weil es zeigt, dass der Workflow das Dokument nicht einfach als reinen Text extrahiert und von Grund auf neu aufbaut. Er ändert die relevanten Dokumentelemente und behält dabei deren umgebende Struktur bei.
Wichtige Überlegungen zur KI-Schwärzung
Ergebnis vor der Weitergabe prüfen
Die KI-Schwärzung ist nicht vollkommen deterministisch. Ein Modell kann eine ungewöhnliche Kennung übersehen oder gewöhnliche Inhalte fälschlicherweise als sensibel einstufen. Dokumente, die für die externe Weitergabe bestimmt sind, sollten nach der Verarbeitung geprüft werden, insbesondere in rechtlichen, finanziellen, gesundheitsbezogenen oder compliance-sensiblen Workflows.
Die Anweisung präzise formulieren
Die Anweisung sollte sowohl beschreiben, was entfernt werden muss, als auch, was erhalten bleiben muss. Wenn Rechnungsnummern, Firmennamen, Produktcodes oder öffentliche Büroadressen nicht geschwärzt werden sollen, geben Sie diese Ausschlüsse ausdrücklich an.
Sichtbarer Ersatz ist nicht immer eine vollständige Bereinigung
Das Ersetzen von sichtbarem Text entfernt nicht unbedingt jede Kopie der Information aus der Datei. Sensible Daten können auch vorkommen in:
- Kommentaren und nachverfolgten Änderungen
- Dokumenteigenschaften und Metadaten
- Ausgeblendeten Arbeitsblättern oder ausgeblendeten Folien
- Notizen des PowerPoint-Referenten
- Eingebetteten Dateien und Objekten
- Bildern, die Text enthalten
- Früheren Versionen oder Sicherungskopien
Bei Workflows mit hohen Sicherheitsanforderungen sollten diese Stellen separat geprüft werden. Wenn ein Dokument gescannte Seiten oder Screenshots enthält, ist möglicherweise OCR erforderlich, bevor der Text in den Bildern ausgewertet werden kann.
Die Originaldatei erhalten
Speichern Sie das geschwärzte Ergebnis unter einem neuen Pfad, anstatt das Quelldokument zu überschreiben. Wenn die Dateien getrennt bleiben, ist es einfacher, die Ausgabe zu vergleichen, übersehene Inhalte zu untersuchen und den Vorgang mit einer verbesserten Anweisung zu wiederholen.
Fazit
Die traditionelle API-basierte Schwärzung bietet präzise Kontrolle, aber Entwickler müssen Erkennungsregeln definieren und eine separate Durchlauflogik für verschiedene Dokumentformate und Inhaltscontainer pflegen. Die direkte LLM-Integration verbessert die kontextbezogene Erkennung, erfordert jedoch weiterhin eine umfangreiche Ebene für Extraktion, Zuordnung und Rückschreiben, um die Office-Formatierung zu erhalten.
Ein KI-Agent-SDK führt diese Fähigkeiten zusammen. Mit einer Anweisung in natürlicher Sprache und wenig C#-Code kann derselbe Workflow Word-, Excel- und PowerPoint-Dateien verarbeiten, kontextbezogene sensible Informationen identifizieren und sie innerhalb der ursprünglichen Dokumentstruktur ersetzen. Das Ergebnis sollte dennoch geprüft werden, aber die Implementierung ist erheblich einfacher, als die gesamte Erkennungs- und Dokumentorchestrierungs-Pipeline manuell aufzubauen.
FAQs
Kann derselbe Code Word-, Excel- und PowerPoint-Dateien schwärzen?
Ja. Das Beispiel wählt je nach Dateiendung der Eingabe Document, Workbook oder Presentation aus und wendet auf jedes Format dieselbe Anweisung in natürlicher Sprache an.
Behält der KI-Agent die ursprüngliche Formatierung bei?
Der Agent arbeitet mit den zugrunde liegenden Office-Dokumentobjekten, sodass sensibler Text in Absätzen, Zellen, Tabellen und Formen ersetzt werden kann, während die umgebende Struktur und Formatierung erhalten bleibt. Die endgültige Ausgabe sollte dennoch überprüft werden, da ungewöhnlich komplexe Layouts eine zusätzliche Verifizierung erfordern können.
Kann ich eine andere Schwärzungsbezeichnung verwenden?
Ja. Ändern Sie [REDACTED] in der Anweisung in eine andere Bezeichnung, z. B. [PRIVATE], [REMOVED] oder einen kategoriespezifischen Wert wie [EMAIL REDACTED].
Wann ist eine traditionelle API besser als eine KI-Schwärzung?
Eine traditionelle API kann vorzuziehen sein, wenn jeder sensible Wert einem festen Muster folgt, sich die Regeln selten ändern und das Ergebnis vollständig deterministisch sein muss. Der Ersatz durch reguläre Ausdrücke ist für standardisierte E-Mail-Adressen, Telefonnummern oder Identifikationsnummern oft ausreichend.
Garantiert das Ersetzen von Text, dass das Dokument sicher veröffentlicht werden kann?
Nein. Das Ersetzen von sichtbarem Text entfernt nicht automatisch Kommentare, nachverfolgte Änderungen, Metadaten, ausgeblendete Inhalte, eingebettete Objekte, Text innerhalb von Bildern oder frühere Dateiversionen. Sicherheitssensible Dokumente erfordern vor der Veröffentlichung eine zusätzliche Prüfung und Validierung.