Одно целое число — общее количество страниц в PDF — стоит за удивительно большим числом реальных решений: ограничения на загрузку, оценка бумаги для печати, операции разделения, индикаторы выполнения. Большинство библиотек отрисовки PDF только отрисовывают страницы и не предоставляют простого счётчика, а отправка файла на серверную часть только для чтения количества страниц добавляет задержку и вызывает вопросы конфиденциальности.
Spire.PDF для JavaScript загружает и анализирует PDF-документы непосредственно в браузере через WebAssembly, поэтому файл никогда не покидает клиент. Количество страниц доступно как одно свойство — никаких циклов, никаких обращений к серверу, никаких обходных путей отрисовки. В этой статье рассматривается получение этого количества и три практических вопроса: отличие физического количества страниц от отображаемых меток, обработка файлов, защищённых паролем, и избежание ошибок на единицу при переборе страниц.
Для установки и настройки проекта см. Интеграция Spire.PDF для JavaScript в проект React. Примеры ниже предполагают, что Spire.PDF установлен и модуль WebAssembly инициализирован.
Получение количества страниц PDF-документа
После того как объект PdfDocument загрузил файл, его свойство Pages предоставляет коллекцию страниц, а свойство Count этой коллекции возвращает общее количество страниц. Нет необходимости перебирать страницы по отдельности — количество доступно сразу после загрузки.
Следующий компонент React демонстрирует полный рабочий процесс: получение PDF в виртуальную файловую систему, создание PdfDocument, загрузка файла, чтение Pages.Count и запись результата в текстовый файл для скачивания.
function App() {
  const getPageCount = async () => {
    // Get the Spire.PDF WASM module
    const pdfModule = window.wasmModule?.spirepdf;

    // Check whether the module is ready
    if (!pdfModule) {
      alert('Spire.PDF is not ready yet');
      return;
    }

    // Load the PDF file to be counted into the VFS
    const inputFileName = 'Multipage_Document.pdf';
    await window.spire.FetchFileToVFS(inputFileName, '', `${process.env.PUBLIC_URL}/data/`);

    // Create a PdfDocument object and load the PDF document
    const doc = new pdfModule.PdfDocument();
    doc.LoadFromFile(inputFileName);

    // Pages is the document's page collection; Count is the total page count
    const pageCount = doc.Pages.Count;

    // Write the result to the VFS
    const outputFileName = 'PageCountResult.txt';
    const report = `Document: ${inputFileName}\r\nTotal pages: ${pageCount}`;
    window.dotnetRuntime.Module.FS.writeFile(outputFileName, report);
    doc.Close();

    // Read the generated file from the VFS and trigger the download
    const fileArray = window.dotnetRuntime.Module.FS.readFile(outputFileName);
    const blob = new Blob([fileArray], { type: 'text/plain' });
    const url = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = url;
    a.download = outputFileName;
    a.click();
    URL.revokeObjectURL(url);
  };

  return (
    <div style={{ textAlign: 'center', height: '300px' }}>
      <h1>Get PDF Page Count</h1>
      <button onClick={getPageCount}>
        Count Pages
      </button>
    </div>
  );
}

export default App;
Результат записывается в текстовый файл, в котором фиксируется общее количество страниц документа:
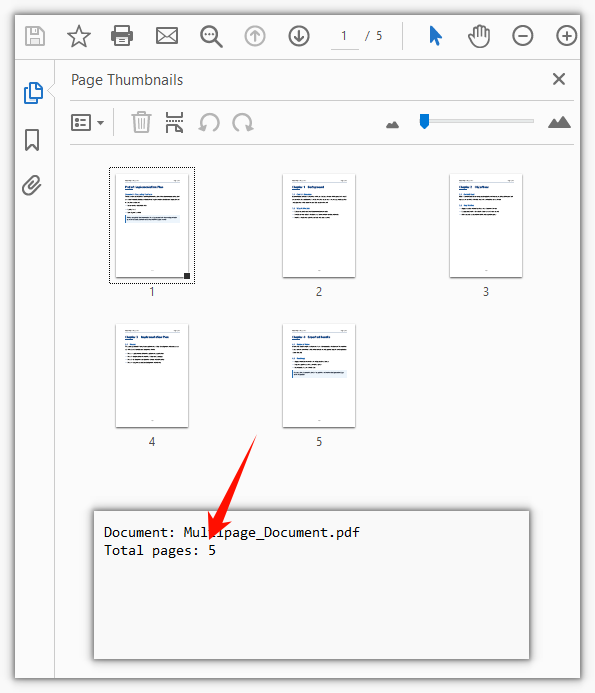
В производственном приложении вы обычно использовали бы значение pageCount напрямую, а не записывали его в файл — например, для проверки загрузки, установки границы цикла или отображения метаданных в интерфейсе. Показанный здесь подход с выводом в файл полезен для тестирования и демонстрации.
Физическое количество страниц и метки страниц
Вот ситуация, которая застаёт разработчиков врасплох: вы читаете Pages.Count и получаете 12, но PDF-ридер на экране пользователя показывает последнюю страницу как «страница 8». Какое число правильное?
Оба — они измеряют разные вещи. Pages.Count возвращает количество физических страниц в документе, и ничего больше. Однако число, отображаемое ридером, происходит от меток страниц (запись /PageLabels в спецификации PDF). Метки страниц — это слой представления, который издатели используют для управления тем, как номера страниц отображаются читателю. Издатель книги может исключить обложку из нумерации, использовать римские цифры (i, ii, iii) для вводной части и начать основную часть заново с 1. В результате пятая физическая страница может отображаться как iii или 1 в зависимости от того, как настроены метки.
Это различие имеет значение, когда ваше приложение должно показывать пользователям номер страницы, совпадающий с тем, что они видят в своём ридере. Если вы отображаете Pages.Count как «текущую страницу», оно не будет совпадать с нумерацией ридера всякий раз, когда используются метки страниц.
Когда вам нужна отображаемая метка, а не физический индекс, прочитайте свойство PageLabel у отдельного объекта страницы:
// What label the 5th physical page displays in a reader
const page = doc.Pages.get_Item(4);
console.log(page.PageLabel);
Обратите внимание на индекс с отсчётом от нуля: get_Item(4) извлекает пятую физическую страницу. Когда в документе не настроены метки страниц, PageLabel возвращает пустую строку. В этом распространённом случае отображаемое число совпадает с порядком физических страниц, поэтому Count — это нужное вам значение.
Практичный способ обработки обоих сценариев — сначала проверить PageLabel и вернуться к физическому индексу, когда оно пустое. Это даёт вашему приложению номер страницы, который всегда совпадает с тем, что видит пользователь, независимо от того, использует ли документ пользовательские метки.
Подсчёт страниц в зашифрованном PDF
Многие PDF-файлы в бизнес-среде защищены паролем на открытие — мерой безопасности, которая не позволяет прочитать документ без правильных учётных данных. Если вы попытаетесь загрузить такой файл обычным вызовом LoadFromFile, среда выполнения WASM выдаст ошибку ещё до того, как будет достигнуто Pages.Count:
Не удаётся открыть зашифрованный документ. Пароль неверен.
Это происходит во время загрузки, а не в тот момент, когда вы читаете количество страниц. Содержимое документа — включая его структуру страниц — зашифровано, поэтому библиотека не может его разобрать без пароля. Невозможно подсчитать страницы, не разблокировав документ.
Решение простое: передайте пароль на открытие вторым аргументом в LoadFromFile. Как только документ разблокирован, количество страниц доступно так же, как и для незашифрованного файла:
// The second argument is the open password
doc.LoadFromFile(inputFileName, 'spire123');
const pageCount = doc.Pages.Count;
В реальном приложении вы обычно собирали бы пароль у пользователя через поле формы и передавали бы его динамически, а не жёстко зашивали. Если пользователь введёт неправильный пароль, будет выброшена та же ошибка — поэтому обернуть вызов LoadFromFile в блок try/catch и показать дружественное сообщение «неверный пароль» — хорошая практика.
Ещё одна вещь, которую стоит отметить: этот пароль — пароль на открытие (также называемый паролем пользователя), который определяет, кто может просматривать документ. PDF также может иметь пароль разрешений (пароль владельца), который ограничивает редактирование, печать или копирование, не блокируя просмотр. Для подсчёта страниц важен только пароль на открытие — как только документ открыт, Pages.Count работает независимо от ограничений разрешений.
Использование количества страниц в качестве границы цикла
Получив количество страниц, естественный следующий шаг — перебрать каждую страницу: извлечь текст, отрисовать миниатюры, разделить документ или применить какое-либо преобразование. Именно здесь появляется тонкая, но распространённая ошибка: использование Count в качестве включающей верхней границы.
Коллекция Pages имеет индексацию с нуля, то есть допустимые индексы идут от 0 до Count - 1. Если условие цикла записано с <= вместо <, последняя итерация попытается обратиться к странице с индексом Count, которой не существует. Среда выполнения WASM оборачивает базовое исключение .NET ArgumentOutOfRangeException в JavaScript Error с сообщением вроде:
ArgumentOutOfRange_IndexMustBeLess Arg_ParamName_Name, index
Поскольку свойство name этой ошибки — просто общее Error, вы не можете отличить её только по имени — вам придётся сопоставлять строку сообщения, если вы хотите обработать её особым образом.
Правильный цикл использует <, поэтому последний используемый индекс — Count - 1:
// The upper bound is Count - 1, so use < rather than <=
for (let i = 0; i < doc.Pages.Count; i++) {
  const page = doc.Pages.get_Item(i);
}
Эта ошибка на единицу — один из наиболее частых источников ошибок времени выполнения при работе с коллекциями страниц. Её легко пропустить при тестировании, если ваши образцы документов содержат только одну или две страницы — ошибка проявляется только на последней итерации, поэтому документ с одной страницей её вообще не вызовет. Всегда тестируйте логику цикла на документе, содержащем как минимум три страницы, чтобы убедиться, что граничное условие верно.
См. также
- Интеграция Spire.PDF для JavaScript в проект React — Руководство по настройке установки Spire.PDF и инициализации модуля WebAssembly в приложении React.
- Страница продукта Spire.PDF для JavaScript — Обзор функций, поддерживаемых операций и возможностей обработки PDF в браузере.
- spire.pdf на npm — Страница пакета для установки библиотеки через npm.