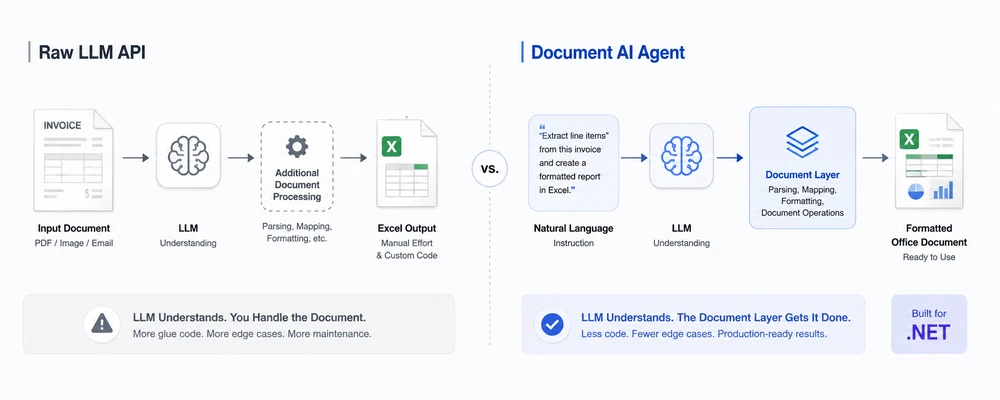
Пользователь загружает PDF-счёт и спрашивает:
«Извлеките позиции, рассчитайте итог и создайте форматированный отчёт Excel».
Современная LLM может понять счёт и определить нужную вам информацию. Но это лишь половина проблемы. Ваше приложение всё равно должно превратить это понимание в реальный форматированный файл .xlsx с требуемой структурой документа.
Это разрыв между пониманием документа и работой с документом. Прямой LLM API предоставляет языковые и аналитические способности, но сам по себе не обеспечивает полный рабочий процесс обработки документов Office. ИИ-агент для документов соединяет LLM с детерминированным SDK обработки документов, поэтому LLM определяет что должно произойти, а уровень работы с документами выполняет файловые операции.
Быстрая навигация
- Проблема: прямые LLM API и файлы документов
- Что даёт ИИ-агент для документов
- Сравнение подходов
- Когда использовать каждый подход
- Простой пример на C#
- Почему Spire.Agent.Office для .NET-команд
- Часто задаваемые вопросы
1. Проблема: прямые LLM API и файлы документов
Прямой вызов gpt-4 или claude с задачей «обработать этот документ» не срабатывает по трём важным для продакшена причинам. Эти проблемы становятся существенными, как только рабочий процесс с документами выходит за рамки простого извлечения текста и требует надёжной работы с файлами, их проверки и форматирования.
1.1 LLM не могут надёжно читать и записывать файлы Office
Большие языковые модели могут понимать содержимое документов, если модель и API поддерживают соответствующий файловый или мультимодальный ввод, но это не обеспечивает детерминированных операций с документами. Модель может анализировать текст, таблицы или визуальное содержимое PDF, но это не значит, что она может детерминированно изменять рабочую книгу, сохранять все специфические для Office свойства и через сам LLM API сохранять результат в виде готового к использованию в производстве файла .xlsx. Когда файл Office передаётся напрямую в LLM API, модель может получить извлечённое или преобразованное содержимое, а не нативный редактируемый объект рабочей книги. Даже если модель понимает содержимое рабочей книги, сам по себе API не предоставляет детерминированных операций для сохранения и изменения нативной структуры рабочей книги (листы, именованные диапазоны, формулы, условное форматирование, объединённые ячейки, числовые форматы).
Синтаксический разбор документов с помощью прямого LLM может извлекать полезную семантическую информацию, но семантический разбор отличается от сохранения и изменения нативной структуры документа.
С записью та же проблема, только наоборот. Прямой LLM API сам по себе не предоставляет детерминированного слоя для работы с документами Office. LLM может описать, что должно содержаться в отчёте, но создание корректного файла .docx или .xlsx требует дополнительных инструментов. Чтобы получить реальный вывод Office от прямого LLM, приходится строить конвейер восстановления: разбирать текстовый ответ модели, сопоставлять поля с ячейками или абзацами, применять форматирование и записывать файл самостоятельно. Такой конвейер нетривиален — и именно он ломается в продакшене.
1.2 Форматирование не гарантируется
Рабочие процессы с документами включают значимое форматирование: заголовки столбцов в счёте-отчёте, числовые форматы в финансовой таблице, условные заливки, отмечающие расхождения, стили таблиц в управленческом отчёте. Прямой LLM API возвращает содержимое, сгенерированное моделью, например текст, JSON или вызовы инструментов; он не предоставляет по своей природе форматированный документ Office на выходе. Форматирование сложно сохранить, когда ответ модели нужно восстановить в файл Office: лист Excel без числовых форматов придётся вручную исправлять, прежде чем он попадёт в бухгалтерию.
Даже когда LLM выдаёт структурированный вывод (JSON, таблицы Markdown), структурированный вывод — это не структурированный документ. JSON даёт вам структурированные данные, а не структурированный документ Office. JSON-ответ может описывать ячейки, абзацы, таблицы или инструкции по форматированию, но для применения этих инструкций к реальному файлу .xlsx, .docx, .pptx или .pdf всё равно требуется дополнительный слой обработки документов. В итоге вы сопровождаете форматтер, сопоставитель полей и модуль применения стилей — ни в одном из которых LLM не помогает.
1.3 Вы заново реализуете всю оркестрацию
Конвейер обработки документов на основе прямого LLM — это не один вызов API. Это целый стек:
- Проектирование промптов — шаблонные промпты, которые ломаются при изменении макета документа
- Извлечение — могут потребоваться дополнительные инструменты обработки документов для извлечения структурированного содержимого из PDF, Word и Excel до передачи его LLM
- Разбор — логика разбора JSON для преобразования ответа LLM в структурированные данные
- Логика повторов — обработка галлюцинированных ответов, ограничений скорости и отклонений из-за фильтра содержимого
- Файловый ввод-вывод — чтение входных данных, запись результатов, управление временными файлами
- Проверка результата — проверка того, что созданный файл корректен и хорошо сформирован, перед возвратом его пользователю
К этому моменту вы создаёте решение для обработки документов, где LLM — лишь один из компонентов, а не само решение. Каждый новый тип документов, изменение схемы или формат вывода означает перенастройку промптов и повторное тестирование специфических особенностей модели. Затраты на сопровождение растут линейно с количеством поддерживаемых типов документов.
2. Что даёт ИИ-агент для документов
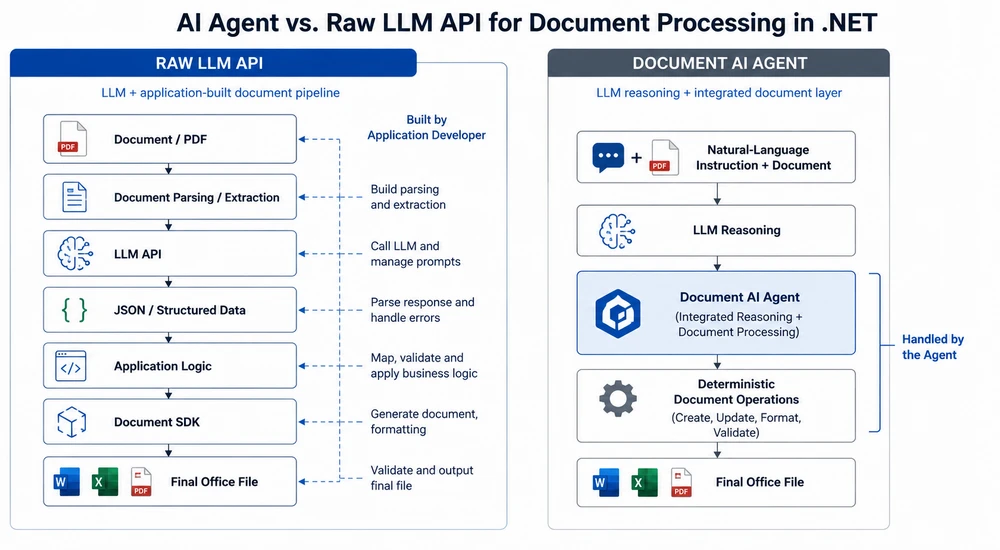
ИИ-агент для документов решает три описанные выше проблемы, объединяя LLM с детерминированным слоем обработки документов. Разделение труда здесь чёткое:
- LLM отвечает за понимание. Он читает инструкцию на естественном языке, решает, что извлечь или сгенерировать, и определяет структуру вывода.
- Слой документов отвечает за исполнение. Он читает и записывает реальные файлы Office и PDF, сохраняет форматирование, применяет стили и использует детерминированные операции с документами для создания структурно корректного файла.
Вместо того чтобы просить LLM «разобраться» со структурой документа, агент выполняет детерминированные операции с документами. Модели не нужно самой формировать формат файла Office; она формирует намерение, а слой документов выполняет соответствующие файловые операции.
Две архитектуры рядом:
Как это выглядит на практике
| Проблема прямого LLM | Как агент решает её |
|---|---|
Нет нативной работы с .xlsx
|
Слой документов читает и изменяет рабочую книгу нативно |
| Нет детерминированной генерации файлов Office | Слой документов создаёт выходной файл |
| Форматирование может теряться при восстановлении | Слой документов обрабатывает стили и числовые форматы |
| Структура, сгенерированная моделью, может быть непоследовательной | Операции с документами детерминированы |
| Вы создаёте окружающий конвейер | SDK агента предоставляет рабочий процесс обработки документов |
Ключевая мысль: LLM — это мозг, а слой документов — руки. Прямой LLM API даёт вам мозг и ожидает, что руки вы построите сами. ИИ-агент для документов даёт и то и другое, в интегрированном виде, одним вызовом SDK.
Сам по себе SDK документов может выполнять операции с файлами, но не понимает намерение, выраженное на естественном языке. ИИ-агент объединяет этот детерминированный слой документов с LLM, чтобы пользователи могли описывать нужный рабочий процесс вместо реализации каждой операции с документами вручную. Ценность не в «SDK документов + ИИ», а в конвейере: инструкция на естественном языке → рассуждение LLM → детерминированные операции с документами.
Рекомендуем почитать: ИИ-агент для обработки документов: что это такое и как работает — объяснение концепции ИИ-агента для документов.
3. Сравнение подходов
| Характеристика | Прямой LLM API | ИИ-агент для документов |
|---|---|---|
| Понимание файлов | Зависит от модели/API и типа файла | Слой документов обеспечивает нативный доступ к документам |
| Работа с файлами | Требует инструментов или дополнительных библиотек для работы с документами | Встроено в слой обработки документов |
| Точность форматирования | Зависит от логики восстановления | Обеспечивается детерминированными API документов |
| Обработка вывода | Ответ LLM нужно разобрать и преобразовать в файл | Слой документов выполняет детерминированное создание файлов |
| Объём кода | Больше оркестрации на стороне приложения | Инструкция на естественном языке + настройка SDK |
| Сопровождение | Промпты, парсеры, сопоставления и файловая логика | Больше поведения рабочего процесса можно выражать в инструкциях |
| Обработка нескольких форматов | Требует поддержки каждого формата отдельно | Единый рабочий процесс обработки документов |
| Семантическая точность | Зависит от модели и промпта | По-прежнему зависит от модели и инструкции |
| Проверка файлов | Ответственность приложения | SDK сообщает об успехе/ошибке обработки |
| .NET-интеграция | .NET SDK или HTTP-интеграция плюс библиотеки обработки документов по необходимости | Нативный C# SDK с обработкой документов |
| Лучше всего подходит для | Текстовых ИИ-задач | Управляемых ИИ рабочих процессов с документами |
4. Когда использовать каждый подход
Сравнение не означает, что «агент всегда лучше». Прямые LLM API и ИИ-агенты для документов служат разным целям, и выбор правильного инструмента зависит от того, что создаёт рабочий процесс.
Используйте прямой LLM API, когда
- Результат — это текст, а не файл. Суммаризация, ответы на вопросы, классификация и черновики — это задачи «текст на входе, текст на выходе». Слой документов здесь не нужен.
- У вас уже есть LLM-стек. Если ваша команда вложила силы в инженерию промптов, RAG и инфраструктуру оркестрации, добавление SDK документов может быть излишним для чисто текстовых рабочих процессов.
-
Входные данные — это обычный текст или Markdown. Если исходный материал уже является текстом, а не
.pdfили.xlsx, проблема извлечения исчезает, и прямой вызов LLM — самый простой путь.
Используйте ИИ-агент для документов, когда
-
Результатом должен быть реальный файл Office или PDF. Если итогом должен быть файл
.xlsxдля бухгалтерии, отчёт.docxдля руководства или.pdfдля распространения, слой обработки документов становится важным, когда рабочий процесс должен надёжно создавать корректный форматированный файл Office. - Входные данные включают несколько форматов. В одном процессе встречаются PDF, документы Word, файлы Excel и отсканированные изображения. Прямому LLM нужна отдельная библиотека извлечения для каждого формата; агент обрабатывает их все одной инструкцией.
- Форматирование имеет значение. Заголовки столбцов, числовые форматы, условная заливка, стили таблиц, шрифты — если бизнес-команде важно, как выглядит файл, именно слой документов сохраняет это.
- Вы работаете в .NET. Нативный C# SDK, сочетающий ИИ-оркестрацию с обработкой документов, может уменьшить объём интеграции на стороне приложения по сравнению с комбинированием LLM SDK с отдельными библиотеками обработки документов.
- Рабочий процесс часто меняется. Новые поставщики, новые макеты отчётов, новые правила проверки — когда узким местом становится переписывание кода под каждое изменение, редактирование инструкции быстрее и дешевле.
Сводное решение
| Вопрос | Прямой LLM API | ИИ-агент для документов |
|---|---|---|
| Результат — реальный файл (Excel, Word, PDF)? | Требует дополнительных инструментов | Да |
| Нужно ли сохранить форматирование? | Зависит от вашего конвейера восстановления | Обеспечивается слоем документов |
| Входные данные представлены в нескольких форматах Office? | Требует извлечения для каждого формата | Да |
| Это чисто текстовая задача (суммаризация, вопросы и ответы)? | Да | Возможно, но излишне |
| Нужна ли нативная работа с документами в .NET? | Требует дополнительной библиотеки документов | Встроено в рабочий процесс |
| Будут ли правила рабочего процесса часто меняться? | Промпты и парсеры нужно перенастраивать | Изменяйте поведение, редактируя инструкцию |
5. Простой пример на C#
Разница наиболее наглядна в коде. Ниже одна и та же задача — извлечь данные из PDF-счёта и создать форматированный отчёт Excel — реализована двумя способами.
Подход с прямым LLM API
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
Иллюстративный конвейер: вызовы API и библиотек документов упрощены, чтобы сосредоточиться на архитектуре, а не на конкретном SDK поставщика.
Подход с ИИ-агентом для документов
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
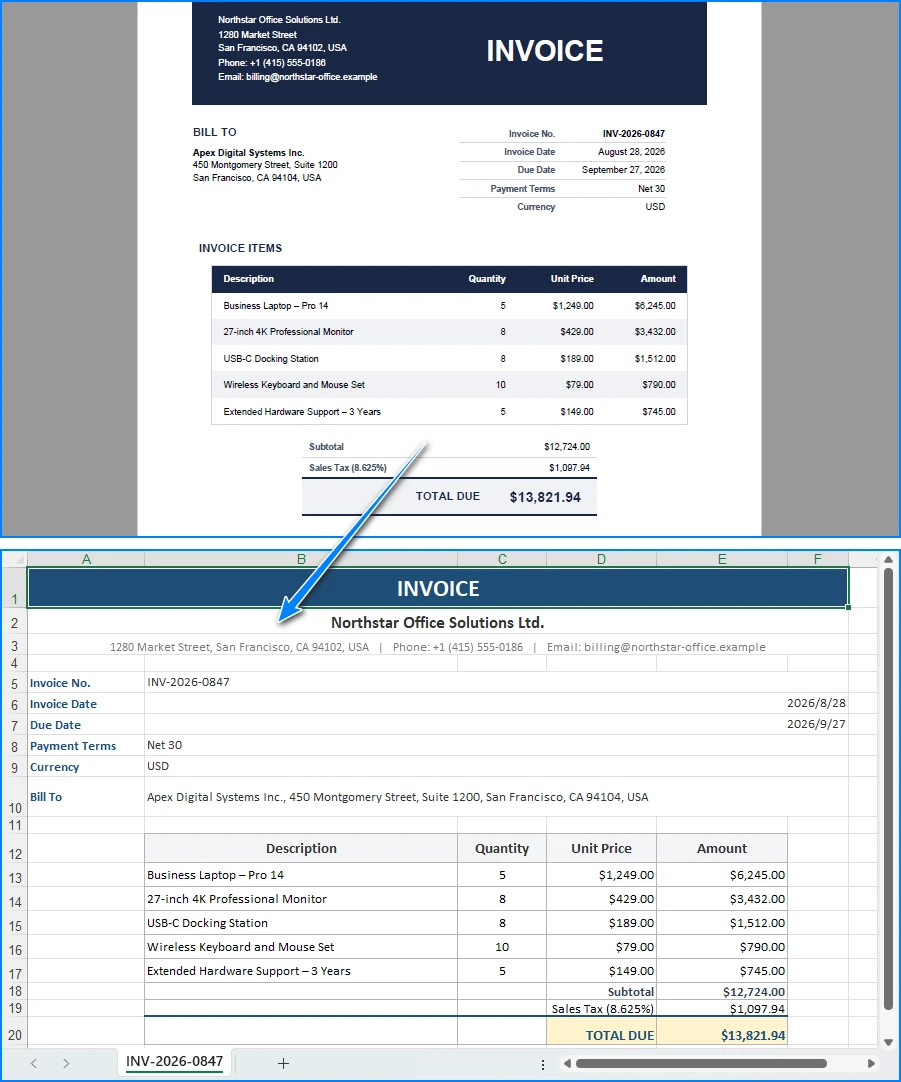
Агент читает PDF-счёт и создаёт форматированный отчёт Excel:
Ключевые вызовы API
-
Workbook.AI(agentOptions)— подключает ИИ-процессор документов к объекту рабочей книги -
ExecuteInstruction(doc, instruction, savePath, attachments)— выполняет инструкцию и записывает выходной файл -
AIResult.Success/AIResult.ErrorMessage— проверяет результат и возвращает ошибки
Подход с прямым LLM — это четыре отдельные проблемы (извлечение, промптинг, разбор, запись файла), соединённые вместе. Подход с агентом — одна инструкция и одна проверка результата. Оба подхода в конечном итоге могут создать файл .xlsx, но подход с прямым LLM требует, чтобы вы сами разрабатывали и сопровождали слой генерации документов. Агент встраивает этот слой обработки документов в рабочий процесс, поэтому LLM сосредоточен на интерпретации инструкции, а SDK выполняет операции с документами.
Вам также может понравиться: Автоматизация обработки счетов с помощью ИИ-агента в .NET — полный процесс извлечения, проверки и формирования отчётов.
6. Почему Spire.Agent.Office для .NET-команд
Приведённое выше сравнение намеренно нейтрально к продуктам; та же архитектура (LLM + слой документов) работает с любой подходящей моделью и любым SDK документов. Spire.Agent.Office занимает своё место для .NET-команд в трёх конкретных областях:
-
Нативная обработка нескольких форматов. PDF, документы Word, файлы Excel и рабочие процессы на основе изображений могут быть включены в рабочий процесс агента. Агент читает, извлекает и создаёт файлы в этих форматах по одной инструкции — без отдельной библиотеки извлечения и отдельного форматтера вывода для каждого формата.
-
Форматирование документов может сохраняться с помощью детерминированных операций с документами. Слой документов сохраняет заголовки столбцов, числовые форматы, условную заливку, стили таблиц и шрифты. При работе с существующим шаблоном явно укажите агенту сохранить исходный макет и оформление — и результат будет соответствовать шаблону без дополнительного кода.
-
Нативная интеграция с .NET. Это C# SDK, который легко встраивается в существующее .NET-приложение. Не нужно создавать и поддерживать отдельный сервис обработки документов, соединять сервисы между собой или организовывать HTTP-оркестрацию. Пример выше показывает основную поверхность интеграции: настройка SDK, одна инструкция и одна проверка результата.
Если вы уже используете Spire.Office для обработки документов, агент — это естественный следующий слой: тот же объект Workbook получает процессор AI(), который превращает инструкции в выполняемые рабочие процессы. Знакомый вам детерминированный SDK становится слоем документов, который вызывает агент.
7. Часто задаваемые вопросы
Разве нельзя просто отправить PDF напрямую в LLM API?
Можно. Современные LLM API могут принимать некоторые типы документов напрямую, включая PDF. Важное отличие в том, что файловый ввод даёт модели доступ к содержимому документа, но не даёт вашему приложению автоматически детерминированный API для изменения исходной структуры Office и сохранения готового к использованию выходного файла. Например, модель может правильно определить таблицы счёта в PDF, но для превращения этого понимания в форматированный файл .xlsx всё равно потребуется логика генерации документов.
Что именно представляет собой «слой документов»?
Слой документов — это детерминированный SDK, который читает и записывает файлы Office и PDF, работая с их нативными структурами. Он выполняет операции, которые LLM не может: открыть .xlsx, сохранив его листы и формулы, создать .docx с корректными стилями и заголовками, объединить ячейки, применить условное форматирование и создать структурно корректный файл Office/PDF через детерминированные API документов. В Spire.Agent.Office слой документов — это Spire.Office SDK; LLM решает, что сделать, а слой документов выполняет это.
Разве это не RAG с дополнительными шагами?
Нет. RAG (генерация с дополнением на основе поиска) в первую очередь сосредоточен на поиске релевантной информации для обоснования ответов модели. ИИ-агент для документов берёт на себя ещё одну задачу: выполнение операций с документами и создание или изменение реальных файлов. Документный агент читает и записывает настоящие файлы, сохраняет форматирование и создаёт структурированный вывод, который является корректным документом Office, а не текстовым ответом.
Какие ИИ-модели поддерживает Spire.Agent.Office?
Spire.Agent.Office подключается к большой языковой модели с использованием ключа SpireToken и поддерживает как размещённые модельные API, так и пользовательские конечные точки моделей. По вопросам о том, какие провайдеры и модельные протоколы поддерживаются в вашем развёртывании, обращайтесь в отдел продаж.
Остаются ли мои данные в моей среде?
SDK, шаблоны и обработка документов выполняются внутри вашего приложения — файлы не загружаются в сторонний сервис документов для хранения или конвертации. Для анализа содержимого ИИ нужен соответствующий текст, и он отправляется модели для обработки. Если конечная точка модели развёрнута в вашей собственной сети и ваша конфигурация не отправляет содержимое документов наружу, содержимое документов может оставаться в вашей инфраструктуре. Если вы подключаетесь через размещённый модельный API, например OpenAI или Azure OpenAI, соответствующее содержимое передаётся этому поставщику в соответствии с вашей конфигурацией.
Когда правильный выбор — прямой LLM API?
Для чисто текстовых задач, где файловый вывод не нужен: суммаризация документа, ответы на вопросы по его содержимому, классификация по категориям или подготовка черновика ответа по электронной почте. Если входные данные уже являются обычным текстом и выход также обычный текст, слой документов добавляет сложность без пользы. Агент оправдывает себя, когда рабочий процесс создаёт реальные файлы, которые должны быть корректными и форматированными.
Готовы добавить слой документов в свои LLM-процессы?
Если ваше приложение обрабатывает счета, договоры, отчёты или любые рабочие процессы с документами Office, ИИ-агент для документов превращает одну инструкцию на естественном языке в реальный форматированный файл — без создания конвейера извлечения и восстановления. Пройдите учебное руководство Начало работы, чтобы запустить свой первый рабочий процесс в .NET.
Дополнительные материалы
- Создание документов Word из данных Excel на C# — создание документов на основе данных с помощью детерминированного SDK
- Создание ИИ-ассистента для Excel-отчётов на C# — автоматизированная генерация и анализ отчётов
- Обзор продукта Spire.Agent.Office — SDK ИИ-агентов для всех форматов документов Office