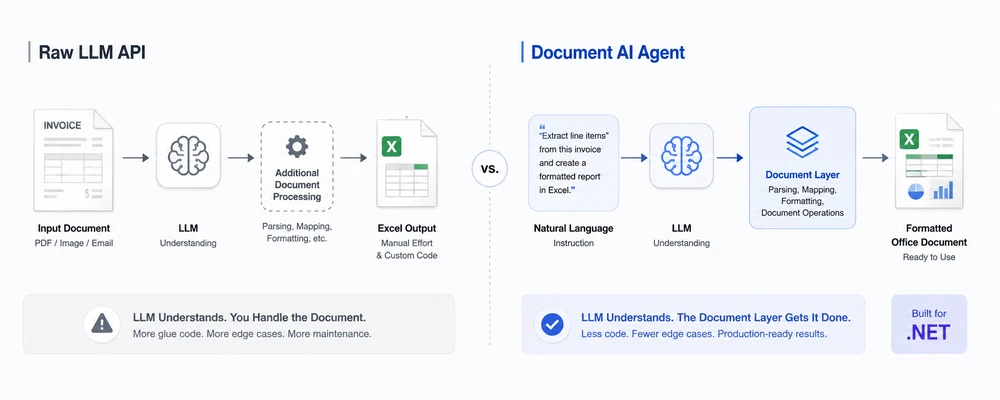
Um usuário envia um PDF de fatura e pergunta:
"Extraia os itens de linha, calcule o total e crie um relatório Excel formatado."
Um LLM moderno consegue entender a fatura e identificar as informações de que você precisa. Mas isso é apenas metade do problema. Sua aplicação ainda precisa transformar esse entendimento em um arquivo .xlsx real e formatado, com a estrutura documental necessária.
Esta é a lacuna entre entender um documento e operar sobre um documento. Uma API LLM bruta fornece capacidades de linguagem e raciocínio, mas não oferece, por si só, um fluxo de trabalho completo de manipulação de documentos do Office. Um agente de IA para documentos conecta o LLM a um SDK determinístico de processamento de documentos, de modo que o LLM determina o que deve acontecer e a camada de documentos realiza as operações de arquivo.
Navegação rápida
- O Problema: APIs de LLM brutas e arquivos de documento
- O que um agente de IA para documentos agrega
- Comparação lado a lado
- Quando usar cada abordagem
- Um exemplo mínimo em C#
- Por que usar o Spire.Agent.Office para equipes .NET
- Perguntas frequentes
1. O Problema: APIs de LLM brutas e arquivos de documento
Chamar gpt-4 ou claude diretamente para "processar este documento" falha de três maneiras que importam em produção. Essas preocupações tornam-se importantes assim que um fluxo de trabalho documental vai além da simples extração de texto e exige manipulação, validação e formatação confiáveis de arquivos.
1.1 LLMs não conseguem ler ou gravar arquivos do Office de forma confiável
Modelos de linguagem de grande porte conseguem entender o conteúdo de um documento quando o modelo e a API suportam o arquivo relevante ou a entrada multimodal, mas isso não fornece manipulação determinística de documentos. Um modelo pode ser capaz de analisar o texto, as tabelas ou o conteúdo visual de um PDF, mas isso não significa que ele possa modificar deterministicamente uma pasta de trabalho, preservar cada propriedade específica do Office e salvar o resultado como um arquivo .xlsx pronto para produção através da própria API do LLM. Quando um arquivo do Office é fornecido a uma API LLM bruta, o modelo pode receber conteúdo extraído ou transformado em vez de um objeto de pasta de trabalho nativo e editável. Mesmo quando o modelo consegue entender o conteúdo da pasta de trabalho, a API não oferece, por si só, operações determinísticas para preservar e modificar a estrutura nativa da pasta de trabalho (planilhas, intervalos nomeados, fórmulas, formatação condicional, células mescladas, formatos numéricos).
A análise de documentos por LLM bruto pode extrair informações semânticas úteis, mas a análise semântica é diferente de preservar e manipular a estrutura nativa do documento.
Escrever é o mesmo problema ao contrário. Uma API LLM bruta não fornece, por si só, uma camada determinística de manipulação de documentos do Office. Um LLM pode descrever o que um relatório deve conter, mas produzir um arquivo .docx ou .xlsx válido exige ferramentas adicionais. Para gerar saída real do Office a partir de um LLM bruto, você precisa construir um pipeline de reconstrução: interpretar a resposta de texto do modelo, mapear campos para células ou parágrafos, aplicar formatação e gravar o arquivo você mesmo. Esse pipeline não é trivial — e é a parte que quebra em produção.
1.2 A formatação não é garantida
Os fluxos de trabalho documentais carregam formatação que importa: cabeçalhos de coluna em um relatório de fatura, formatos numéricos em uma planilha financeira, preenchimentos condicionais que sinalizam discrepâncias, estilos de tabela em um relatório gerencial. Uma API LLM bruta retorna conteúdo gerado pelo modelo, como texto, JSON ou chamadas de ferramenta; ela não fornece, inerentemente, um documento do Office formatado como saída. A formatação pode ser difícil de preservar quando a resposta do modelo precisa ser reconstruída em um arquivo do Office — uma planilha do Excel sem formatos numéricos é uma planilha que alguém precisa corrigir manualmente antes que possa seguir para a contabilidade.
Mesmo quando o LLM produz saída estruturada (JSON, tabelas Markdown), saída estruturada não é saída de documento estruturado. JSON fornece dados estruturados, não um documento do Office estruturado. Uma resposta JSON pode descrever células, parágrafos, tabelas ou instruções de formatação, mas ainda é necessária uma camada adicional de processamento de documentos para aplicar essas instruções a um arquivo .xlsx, .docx, .pptx ou .pdf real. Você agora mantém um formatador, um mapeador de campos e um aplicador de estilos — nenhum dos quais o LLM ajuda.
1.3 Você reimplementa toda a orquestração
Um pipeline de documentos com LLM bruto não é uma única chamada de API. É uma pilha:
- Design de prompt — prompts modelados por templates que quebram quando o layout do documento muda
- Extração — ferramentas adicionais de processamento de documentos podem ser necessárias para extrair conteúdo estruturado de arquivos PDF, Word e Excel antes que o LLM o veja
- Análise (parsing) — lógica de análise de JSON para transformar a resposta do LLM em dados estruturados
- Lógica de nova tentativa — lidar com saídas alucinadas, limites de taxa e rejeições do filtro de conteúdo
- E/S de arquivos — ler entradas, gravar saídas, gerenciar arquivos temporários
- Validação de saída — verificar se o arquivo produzido é válido e bem formado antes de devolvê-lo ao usuário
Nesse ponto, você está construindo uma solução de processamento de documentos — com um LLM como um componente, não a solução em si. Cada novo tipo de documento, mudança de esquema ou formato de saída significa reajustar prompts e retestar peculiaridades específicas do modelo. A carga de manutenção cresce linearmente com o número de tipos de documento que você suporta.
2. O que um agente de IA para documentos agrega
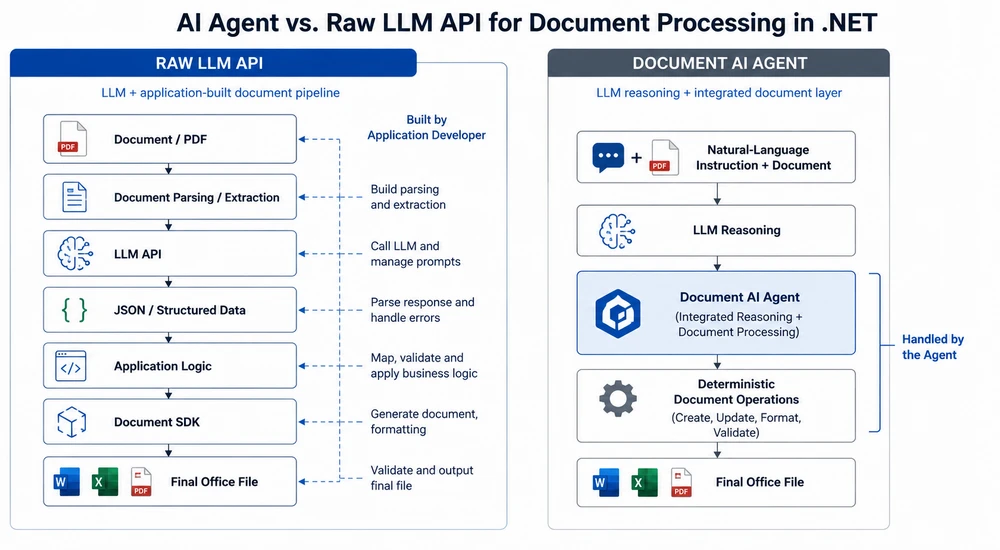
Um agente de IA para documentos resolve os três problemas acima ao combinar o LLM com uma camada determinística de processamento de documentos. A divisão de trabalho é clara:
- O LLM cuida do entendimento. Ele lê a instrução em linguagem natural, decide o que extrair ou gerar e determina a estrutura da saída.
- A camada de documentos cuida da execução. Ela lê e grava arquivos reais do Office e PDF, preserva a formatação, aplica estilos e usa operações documentais determinísticas para produzir um arquivo estruturalmente válido.
Em vez de pedir ao LLM para "descobrir" a estrutura do documento, o agente invoca operações documentais determinísticas. O modelo não precisa construir o formato do arquivo do Office por conta própria; ele produz a intenção, e a camada de documentos executa as operações de arquivo correspondentes.
As duas arquiteturas lado a lado:
Como isso se parece na prática
| Problema com LLM bruto | Como o agente resolve |
|---|---|
Sem manipulação nativa de .xlsx
|
A camada de documentos lê e manipula a pasta de trabalho nativamente |
| Sem geração determinística de arquivos do Office | A camada de documentos cria o arquivo de saída |
| A formatação pode ser perdida durante a reconstrução | A camada de documentos lida com estilos e formatos numéricos |
| A estrutura gerada pelo modelo pode ser inconsistente | As operações documentais são determinísticas |
| Você constrói o pipeline ao redor | O SDK do agente fornece o fluxo de trabalho de processamento de documentos |
A principal percepção: o LLM é o cérebro, a camada de documentos é as mãos. Uma API LLM bruta oferece o cérebro e espera que você construa as mãos. Um agente de IA para documentos oferece ambos, integrados, em uma única chamada de SDK.
Um SDK de documentos sozinho pode manipular arquivos, mas não entende a intenção em linguagem natural. Um agente de IA combina essa camada documental determinística com um LLM para que os usuários possam descrever o fluxo de trabalho desejado em vez de implementar cada operação documental manualmente. O valor não é "SDK de documentos + IA" — é o pipeline: instrução em linguagem natural → raciocínio do LLM → operações documentais determinísticas.
Leitura recomendada: Agente de IA para Processamento de Documentos: O Que É e Como Funciona — o conceito de agente de IA para documentos explicado.
3. Comparação lado a lado
| Dimensão | API LLM bruta | Agente de IA para documentos |
|---|---|---|
| Entendimento de arquivo | Depende do modelo/API e do tipo de arquivo | A camada de documentos fornece acesso nativo ao documento |
| Manipulação de arquivo | Exige ferramentas ou bibliotecas documentais adicionais | Integrada à camada de processamento de documentos |
| Fidelidade de formatação | Depende da lógica de reconstrução | Tratada por APIs documentais determinísticas |
| Tratamento da saída | A resposta do LLM deve ser analisada e convertida em um arquivo | A camada de documentos realiza criação determinística de arquivos |
| Volume de código | Mais orquestração no lado da aplicação | Instrução em linguagem natural + configuração do SDK |
| Manutenção | Prompts, analisadores, mapeamentos e lógica de arquivos | Mais comportamento do fluxo de trabalho pode ser expresso em instruções |
| Processamento multiformato | Exige suporte específico por formato | Fluxo de trabalho unificado de processamento de documentos |
| Precisão semântica | Depende do modelo e do prompt | Ainda depende do modelo e da instrução |
| Validação de arquivo | Responsabilidade da aplicação | O SDK informa sucesso/falha do processamento |
| Integração .NET | SDK .NET ou integração HTTP, além de bibliotecas de processamento de documentos conforme necessário | SDK C# nativo com processamento de documentos |
| Melhor para | Tarefas de IA centradas em texto | Fluxos de trabalho documentais orientados por IA |
4. Quando usar cada abordagem
A comparação não é "o agente é sempre melhor". APIs LLM brutas e agentes de IA para documentos atendem a intenções diferentes, e escolher a ferramenta certa depende do que o fluxo de trabalho produz.
Use uma API LLM bruta quando
- A saída é texto, não um arquivo. Resumo, perguntas e respostas, classificação e redação são tarefas de texto para texto. Nenhuma camada de documentos é necessária.
- Você já tem uma pilha de LLM. Se sua equipe investiu em engenharia de prompts, RAG e infraestrutura de orquestração, adicionar um SDK de documentos pode ser desnecessário para fluxos de trabalho somente de texto.
-
A entrada é texto simples ou Markdown. Se o material de origem já é texto — não
.pdfou.xlsx— o problema de extração desaparece, e uma chamada de LLM bruto é o caminho mais simples.
Use um agente de IA para documentos quando
-
A saída deve ser um arquivo real do Office ou PDF. Se a entrega for uma pasta de trabalho
.xlsxpara contabilidade, um relatório.docxpara a gerência ou um.pdfpara distribuição, uma camada de processamento de documentos torna-se importante quando o fluxo de trabalho precisa produzir um arquivo do Office válido e formatado de forma confiável. - A entrada abrange vários formatos. PDFs, documentos do Word, arquivos do Excel e imagens digitalizadas chegando no mesmo fluxo de trabalho. Um LLM bruto precisa de uma biblioteca de extração separada por formato; um agente lida com todos eles em uma única instrução.
- A formatação é importante. Cabeçalhos de coluna, formatos numéricos, preenchimentos condicionais, estilos de tabela, fontes — se a equipe de negócios se preocupa com a aparência do arquivo, a camada de documentos é o que a preserva.
- Você está em .NET. Um SDK C# nativo que combina orquestração de IA com processamento de documentos pode reduzir a quantidade de integração no lado da aplicação em comparação com combinar um SDK de LLM com bibliotecas separadas de processamento de documentos.
- O fluxo de trabalho muda com frequência. Novos fornecedores, novos layouts de relatório, novas regras de validação — quando o gargalo é recodificar a cada mudança, editar uma instrução é mais rápido e mais barato.
Resumo da decisão
| Pergunta | API LLM bruta | Agente de IA para documentos |
|---|---|---|
| A saída é um arquivo real (Excel, Word, PDF)? | Exige ferramentas adicionais | Sim |
| A formatação precisa ser preservada? | Depende do seu pipeline de reconstrução | Tratada pela camada de documentos |
| As entradas estão em vários formatos do Office? | Exige extração específica por formato | Sim |
| É uma tarefa somente de texto (resumir, perguntas e respostas)? | Sim | Possível, mas desnecessário |
| Você precisa de manipulação nativa de documentos em .NET? | Exige uma biblioteca documental adicional | Integrada ao fluxo de trabalho |
| As regras do fluxo de trabalho mudarão com frequência? | Prompts e analisadores precisam ser reajustados | Mude o comportamento editando a instrução |
5. Um exemplo mínimo em C#
A diferença fica mais clara no código. Abaixo está a mesma tarefa — extrair dados de um PDF de fatura e produzir um relatório Excel formatado — implementada das duas maneiras.
Abordagem com API LLM bruta
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
Pipeline ilustrativo: as chamadas de API e de biblioteca documental foram simplificadas para focar na arquitetura, em vez de um SDK específico de fornecedor.
Abordagem com agente de IA para documentos
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
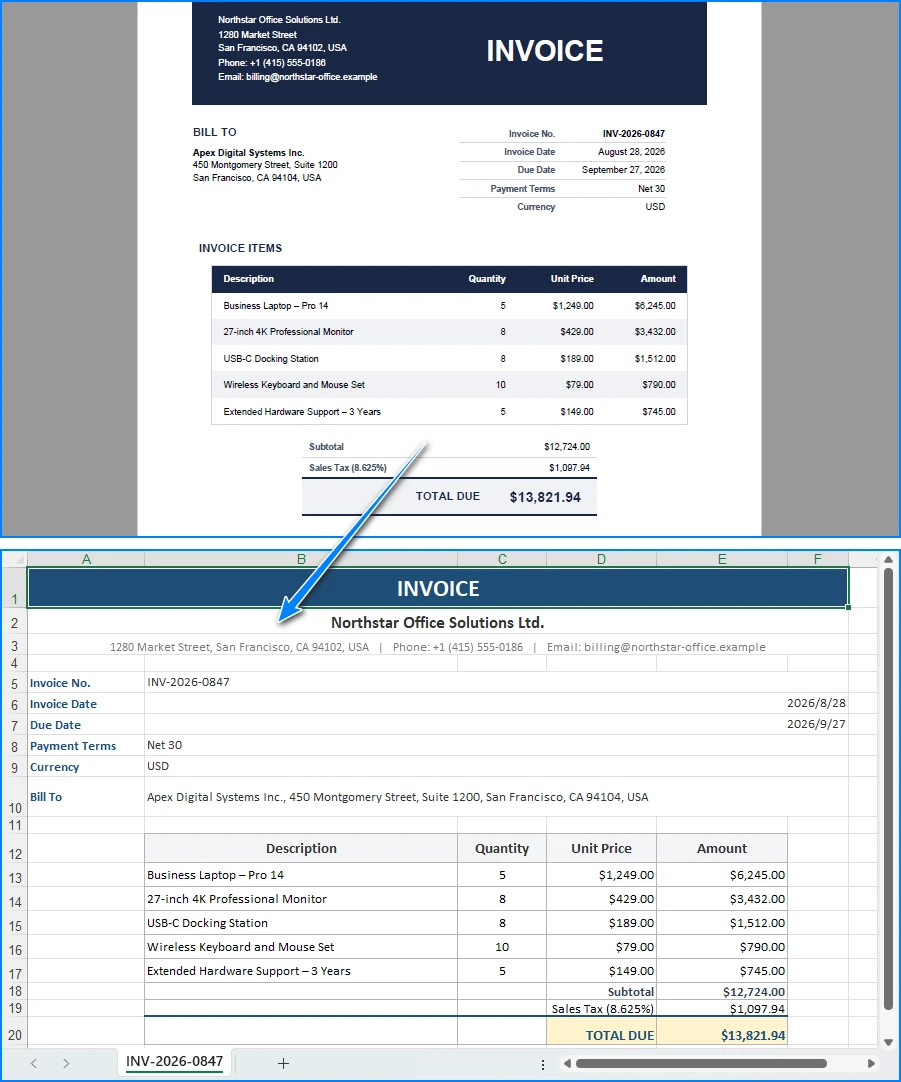
O agente lê o PDF da fatura e produz um relatório Excel formatado:
Principais chamadas de API
-
Workbook.AI(agentOptions)— anexa o processador de documentos de IA a um objeto de pasta de trabalho -
ExecuteInstruction(doc, instruction, savePath, attachments)— executa a instrução e grava o arquivo de saída -
AIResult.Success/AIResult.ErrorMessage— verifica o resultado e expõe erros
A abordagem com LLM bruto são quatro problemas separados (extração, prompts, análise e gravação de arquivo) costurados. A abordagem com agente é uma instrução e uma verificação de resultado. Ambas as abordagens podem, em última análise, produzir um arquivo .xlsx, mas a abordagem com LLM bruto exige que você construa e mantenha a camada de geração de documentos por conta própria. O agente integra essa camada de processamento de documentos ao fluxo de trabalho, de modo que o LLM se concentra em interpretar a instrução enquanto o SDK cuida das operações documentais.
Você também pode gostar: Automatize o Processamento de Faturas com um Agente de IA em .NET — um fluxo de trabalho completo de extração, validação e geração de relatórios.
6. Por que usar o Spire.Agent.Office para equipes .NET
A comparação acima é deliberadamente neutra em relação a produtos; a mesma arquitetura (LLM + camada de documentos) funciona com qualquer modelo capaz e qualquer SDK de documentos. Onde o Spire.Agent.Office conquista seu lugar para equipes .NET é em três áreas específicas:
-
Processamento nativo multiformato. PDFs, documentos do Word, arquivos do Excel e fluxos de trabalho documentais baseados em imagens podem ser incorporados ao fluxo de trabalho do agente. O agente lê, extrai e gera nesses formatos em uma única instrução — sem biblioteca de extração por formato, sem formatador de saída por formato.
-
A formatação de documentos pode ser preservada por meio de operações documentais determinísticas. A camada de documentos mantém cabeçalhos de coluna, formatos numéricos, preenchimentos condicionais, estilos de tabela e fontes intactos. Ao trabalhar a partir de um modelo existente, instrua explicitamente o agente a preservar o layout e o estilo originais, e a saída permanecerá fiel ao modelo sem código extra.
-
Integração nativa com .NET. É um SDK C# que se encaixa em uma aplicação .NET existente. Sem serviço separado de processamento de documentos para construir ou manter, sem integração entre serviços, sem camada de orquestração HTTP. O exemplo acima captura a superfície principal de integração: configuração do SDK, uma instrução e uma verificação de resultado.
Se você já usa o Spire.Office para processamento de documentos, o agente é a próxima camada natural: o mesmo objeto Workbook ganha um processador AI() que transforma instruções em fluxos de trabalho executados. O SDK determinístico que você já conhece torna-se a camada de documentos que o agente chama.
7. Perguntas frequentes
Não posso simplesmente enviar o PDF diretamente para a API do LLM?
Pode. APIs modernas de LLM conseguem aceitar alguns tipos de documento diretamente, incluindo PDFs. A distinção importante é que a entrada de arquivo dá ao modelo acesso ao conteúdo do documento; ela não dá automaticamente à sua aplicação uma API determinística para modificar a estrutura original do Office e salvar um arquivo de saída pronto para produção. Por exemplo, um modelo pode identificar corretamente as tabelas de uma fatura em PDF, mas transformar esse entendimento em um .xlsx formatado ainda exige lógica de geração de documentos.
O que exatamente é uma "camada de documentos"?
Uma camada de documentos é um SDK determinístico que lê e grava arquivos do Office e PDF enquanto trabalha com suas estruturas documentais nativas. Ela cuida das operações que um LLM não consegue: abrir um .xlsx e preservar suas planilhas e fórmulas, gravar um .docx com estilos e cabeçalhos corretos, mesclar células, aplicar formatação condicional e criar saídas do Office/PDF estruturalmente válidas por meio de APIs documentais determinísticas. No Spire.Agent.Office, a camada de documentos é o SDK do Spire.Office; o LLM decide o que fazer, e a camada de documentos executa.
Isso é apenas RAG com etapas extras?
Não. RAG (geração aumentada por recuperação) concentra-se principalmente em recuperar informações relevantes para fundamentar as respostas do modelo. Um agente de IA para documentos adiciona outra responsabilidade: executar operações documentais e produzir ou modificar arquivos reais. Um agente de documentos lê e grava arquivos reais, preserva a formatação e produz saída estruturada que é um documento do Office válido, não uma resposta de texto.
Quais modelos de IA o Spire.Agent.Office suporta?
O Spire.Agent.Office conecta-se a um modelo de linguagem de grande porte por trás de uma chave SpireToken e suporta APIs de modelo hospedadas, bem como endpoints de modelo personalizados. Para dúvidas sobre quais provedores e protocolos de modelo são suportados em sua implantação, entre em contato com vendas.
Meus dados permanecem dentro do meu ambiente?
O SDK, os modelos e o processamento de documentos são executados dentro da sua aplicação — os arquivos não são enviados a um serviço documental de terceiros para armazenamento ou conversão. Para analisar o conteúdo, a IA precisa do texto relevante, e ele é enviado ao modelo para processamento. Se o endpoint do modelo estiver implantado dentro da sua própria rede e sua configuração não enviar conteúdo documental externamente, o conteúdo documental pode permanecer dentro da sua infraestrutura. Se você se conectar por meio de uma API de modelo hospedada, como OpenAI ou Azure OpenAI, o conteúdo relevante é transmitido a esse provedor de acordo com sua configuração.
Quando uma API LLM bruta é a escolha certa?
Para tarefas somente de texto em que nenhuma saída de arquivo é necessária: resumir um documento, responder perguntas sobre seu conteúdo, classificá-lo em uma categoria ou redigir uma resposta de e-mail. Se a entrada já é texto simples e a saída é texto simples, uma camada de documentos adiciona complexidade sem valor. O agente conquista seu lugar quando o fluxo de trabalho produz arquivos reais que precisam ser válidos e formatados.
Pronto para adicionar uma camada de documentos aos seus fluxos de trabalho com LLM?
Se sua aplicação processa faturas, contratos, relatórios ou qualquer fluxo de trabalho com documentos do Office, um agente de IA para documentos transforma uma instrução em linguagem natural em um arquivo real e formatado — sem construir um pipeline de extração e reconstrução. Siga o tutorial Introdução para executar seu primeiro fluxo de trabalho em .NET.
Leitura adicional
- Gerar documentos do Word a partir de dados do Excel em C# — geração de documentos orientada por dados com o SDK determinístico
- Crie um assistente de relatórios Excel com IA em C# — geração e análise automatizadas de relatórios
- Visão geral do produto Spire.Agent.Office — SDKs de agente de IA para cada formato de documento do Office