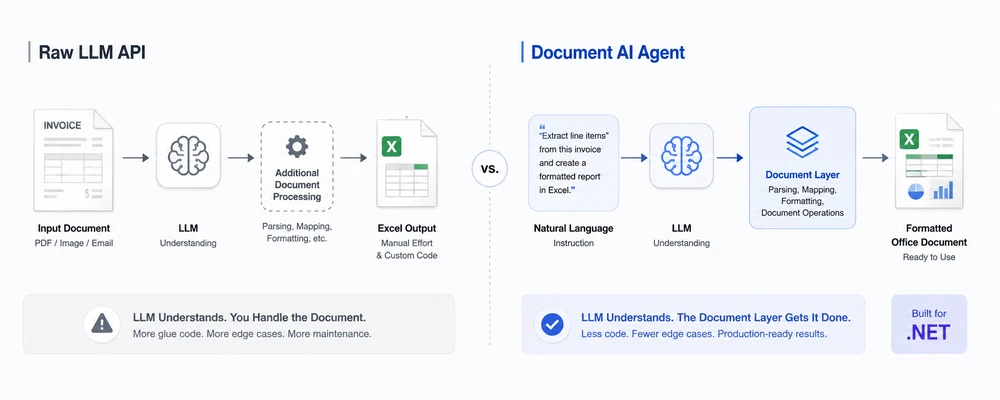
사용자가 인보이스 PDF를 업로드하고 다음과 같이 요청합니다.
"품목을 추출하고 합계를 계산한 다음 서식이 지정된 Excel 보고서를 만들어 주세요."
최신 LLM은 인보이스를 이해하고 필요한 정보를 식별할 수 있습니다. 하지만 그것은 문제의 절반에 불과합니다. 응용 프로그램은 여전히 그 이해를 실제 서식이 지정된 .xlsx 파일로 변환해야 하며, 요구되는 문서 구조를 갖추어야 합니다.
이것이 문서를 이해하는 것과 문서를 조작하는 것 사이의 차이입니다. 원시 LLM API는 언어 및 추론 기능을 제공하지만, 그 자체만으로 완전한 Office 문서 조작 워크플로우를 제공하지는 않습니다. 문서 AI 에이전트는 LLM을 결정론적 문서 처리 SDK에 연결하여, LLM이 무엇이 발생해야 하는지 결정하고 문서 레이어가 파일 작업을 수행하도록 합니다.
빠른 탐색
- 문제: 원시 LLM API와 문서 파일
- Document AI 에이전트가 추가하는 기능
- 나란히 비교
- 각 접근 방식을 사용해야 하는 경우
- C# 최소 예제
- .NET 팀을 위한 Spire.Agent.Office의 장점
- FAQ
1. 문제: 원시 LLM API와 문서 파일
gpt-4 또는 claude를 직접 호출하여 "이 문서를 처리하라"고 하는 방식은 운영 환경에서 중요한 세 가지 측면에서 실패합니다. 문서 워크플로우가 단순한 텍스트 추출을 넘어 안정적인 파일 조작, 검증, 서식 지정을 요구하게 되면 이러한 문제가 중요해집니다.
1.1 LLM은 Office 파일을 안정적으로 읽거나 쓸 수 없음
대규모 언어 모델은 모델과 API가 관련 파일 또는 다중 모달 입력을 지원할 때 문서 콘텐츠를 이해할 수 있지만, 그렇다고 해서 결정론적 문서 조작이 가능한 것은 아닙니다. 모델이 PDF의 텍스트, 표 또는 시각적 콘텐츠를 분석할 수는 있지만, 워크북을 결정론적으로 수정하고 모든 Office 고유 속성을 보존하며 결과를 프로덕션에 사용할 수 있는 .xlsx 파일로 LLM API 자체를 통해 저장할 수 있다는 뜻은 아닙니다. Office 파일이 원시 LLM API에 제공되면 모델은 네이티브 편집 가능한 워크북 객체 대신 추출되거나 변환된 콘텐츠를 받을 수 있습니다. 모델이 워크북의 콘텐츠를 이해할 수 있더라도 API 자체만으로는 워크북의 네이티브 구조(시트, 명명된 범위, 수식, 조건부 서식, 병합된 셀, 숫자 서식)를 보존하고 수정하기 위한 결정론적 작업을 제공하지 않습니다.
원시 LLM 문서 파싱은 유용한 의미 정보를 추출할 수 있지만, 의미 파싱은 네이티브 문서 구조를 보존하고 조작하는 것과는 다릅니다.
쓰기는 그 반대 방향의 동일한 문제입니다. 원시 LLM API는 그 자체만으로 결정론적 Office 문서 조작 레이어를 제공하지 않습니다. LLM은 보고서에 무엇이 포함되어야 하는지 설명할 수 있지만, 유효한 .docx 또는 .xlsx 파일을 생성하려면 추가 도구가 필요합니다. 원시 LLM에서 실제 Office 출력을 만들려면 재구성 파이프라인을 직접 구축해야 합니다. 모델의 텍스트 응답을 파싱하고, 필드를 셀이나 문단에 매핑하고, 서식을 적용하고, 파일을 직접 작성해야 합니다. 이 파이프라인은 간단하지 않으며, 운영 환경에서 문제가 되는 부분이기도 합니다.
1.2 서식이 보장되지 않음
문서 워크플로우에는 중요한 서식이 포함됩니다. 인보이스 보고서의 열 머리글, 재무 스프레드시트의 숫자 서식, 불일치를 표시하는 조건부 채우기, 관리 보고서의 테이블 스타일 등이 그 예입니다. 원시 LLM API는 텍스트, JSON 또는 도구 호출과 같은 모델 생성 콘텐츠를 반환하며, 본질적으로 서식이 지정된 Office 문서를 출력으로 제공하지는 않습니다. 모델의 응답을 Office 파일로 재구성해야 할 때 서식은 보존하기 어려울 수 있습니다. 숫자 서식이 없는 Excel 시트는 회계 부서로 보내기 전에 누군가 수동으로 고쳐야 하는 시트입니다.
LLM이 구조화된 출력(JSON, Markdown 테이블)을 생성하더라도 구조화된 출력은 구조화된 문서 출력이 아닙니다. JSON은 구조화된 Office 문서가 아닌 구조화된 데이터를 제공합니다. JSON 응답은 셀, 문단, 표 또는 서식 지침을 설명할 수 있지만, 실제 .xlsx, .docx, .pptx 또는 .pdf 파일에 이러한 지침을 적용하려면 여전히 추가 문서 처리 레이어가 필요합니다. 이제 서식 지정기, 필드 매퍼, 스타일 적용기를 유지 관리해야 하며, LLM은 그중 어느 것도 도와주지 않습니다.
1.3 전체 오케스트레이션을 직접 다시 구현해야 함
원시 LLM 문서 파이프라인은 단일 API 호출이 아닙니다. 그것은 스택입니다:
- 프롬프트 설계 — 문서 레이아웃이 변경되면 깨지는 템플릿 프롬프트
- 추출 — LLM이 콘텐츠를 보기 전에 PDF, Word, Excel 파일에서 구조화된 콘텐츠를 추출하기 위해 추가 문서 처리 도구가 필요할 수 있음
- 파싱 — LLM의 응답을 구조화된 데이터로 변환하는 JSON 파싱 로직
- 재시도 로직 — 환각 출력, 속도 제한, 콘텐츠 필터 거부 처리
- 파일 I/O — 입력 읽기, 출력 쓰기, 임시 파일 관리
- 출력 검증 — 생성된 파일이 사용자에게 반환되기 전에 유효하고 올바르게 구성되었는지 확인
이 시점에서 문서 처리 솔루션을 구축하고 있는 것입니다. LLM은 솔루션 자체가 아니라 한 구성 요소일 뿐입니다. 새로운 문서 유형, 스키마 변경 또는 출력 형식이 생길 때마다 프롬프트를 재조정하고 모델별 특성을 다시 테스트해야 합니다. 유지 관리 부담은 지원하는 문서 유형 수에 비례하여 증가합니다.
2. Document AI 에이전트가 추가하는 기능
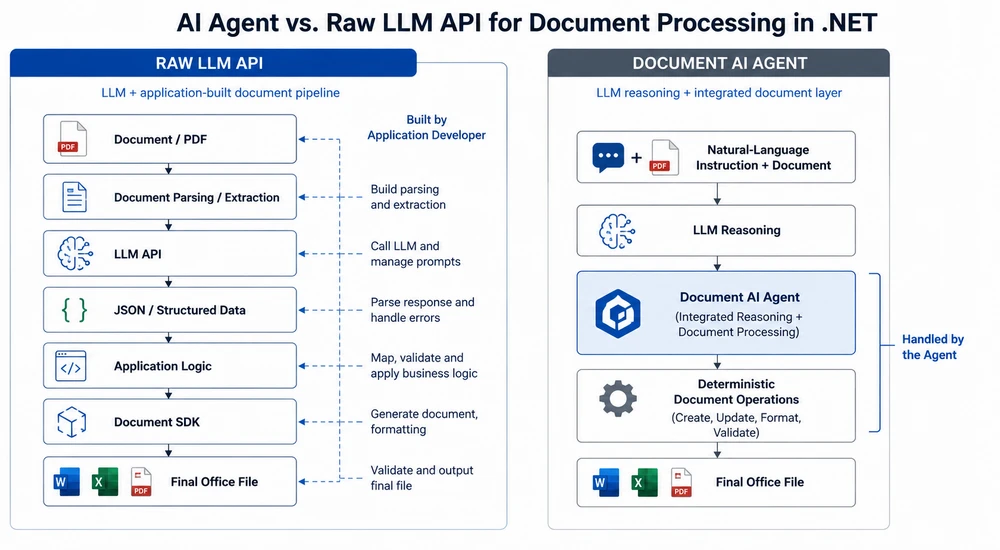
문서 AI 에이전트는 LLM을 결정론적 문서 처리 레이어와 결합하여 위의 세 가지 문제를 해결합니다. 작업 분담은 명확합니다:
- LLM은 이해를 담당합니다. 자연어 지시문을 읽고, 무엇을 추출하거나 생성할지 결정하며, 출력 구조를 결정합니다.
- 문서 레이어는 실행을 담당합니다. 실제 Office 및 PDF 파일을 읽고 쓰고, 서식을 보존하고, 스타일을 적용하며, 결정론적 문서 작업을 사용하여 구조적으로 유효한 파일을 생성합니다.
LLM에게 문서 구조를 "스스로 파악"하도록 요청하는 대신, 에이전트는 결정론적 문서 작업을 호출합니다. 모델이 Office 파일 형식 자체를 구성할 필요는 없습니다. 모델은 의도를 생성하고, 문서 레이어가 해당 파일 작업을 수행합니다.
두 아키텍처를 나란히 비교하면 다음과 같습니다:
실제 적용 예시
| 원시 LLM의 문제 | 에이전트가 해결하는 방법 |
|---|---|
네이티브 .xlsx 조작 없음 |
문서 레이어가 워크북을 네이티브로 읽고 조작함 |
| 결정론적 Office 파일 생성 없음 | 문서 레이어가 출력 파일을 생성함 |
| 재구성 중 서식이 손실될 수 있음 | 문서 레이어가 스타일과 숫자 서식을 처리함 |
| 모델 생성 구조가 일관되지 않을 수 있음 | 문서 작업은 결정론적임 |
| 주변 파이프라인을 직접 구축해야 함 | 에이전트 SDK가 문서 처리 워크플로우를 제공함 |
핵심 통찰력: LLM은 두뇌이고, 문서 레이어는 손입니다. 원시 LLM API는 두뇌를 제공하고 손은 직접 만들기를 기대합니다. 문서 AI 에이전트는 하나의 SDK 호출로 통합된 둘 모두를 제공합니다.
문서 SDK 단독으로는 파일을 조작할 수 있지만 자연어 의도는 이해하지 못합니다. AI 에이전트는 결정론적 문서 레이어를 LLM과 결합하여 사용자가 모든 문서 작업을 수동으로 구현하는 대신 원하는 워크플로우를 설명할 수 있게 합니다. 가치는 "문서 SDK + AI"가 아니라 파이프라인, 즉 자연어 지시문 → LLM 추론 → 결정론적 문서 작업입니다.
추천 자료: AI 에이전트를 이용한 문서 처리: 개념 및 작동 방식 — 문서 AI 에이전트 개념 설명
3. 나란히 비교
| 기준 | 원시 LLM API | Document AI 에이전트 |
|---|---|---|
| 파일 이해 | 모델/API 및 파일 형식에 따라 다름 | 문서 레이어가 네이티브 문서 액세스를 제공함 |
| 파일 조작 | 도구 또는 추가 문서 라이브러리 필요 | 문서 처리 레이어에 내장됨 |
| 서식 충실도 | 재구성 로직에 따라 다름 | 결정론적 문서 API에 의해 처리됨 |
| 출력 처리 | LLM 응답을 파싱하여 파일로 변환해야 함 | 문서 레이어가 결정론적 파일 생성을 수행함 |
| 코드 규모 | 애플리케이션 측 오케스트레이션 증가 | 자연어 지시문 + SDK 설정 |
| 유지관리 | 프롬프트, 파서, 매핑 및 파일 로직 | 더 많은 워크플로우 동작을 지시문으로 표현 가능 |
| 다중 형식 처리 | 형식별 지원 필요 | 통합 문서 처리 워크플로우 |
| 의미론적 정확도 | 모델과 프롬프트에 따라 다름 | 여전히 모델과 지시문에 따라 다름 |
| 파일 검증 | 애플리케이션 책임 | SDK가 처리 성공/실패를 보고함 |
| .NET 통합 | .NET SDK 또는 HTTP 통합, 필요에 따라 문서 처리 라이브러리 추가 | 문서 처리가 포함된 네이티브 C# SDK |
| 적합한 용도 | 텍스트 중심 AI 작업 | AI 기반 문서 워크플로우 |
4. 각 접근 방식을 사용해야 하는 경우
"에이전트가 항상 더 낫다"는 의미는 아닙니다. 원시 LLM API와 문서 AI 에이전트는 서로 다른 목적을 위해 사용되며, 올바른 도구를 선택하는 것은 워크플로우가 무엇을 생성하는지에 따라 달라집니다.
원시 LLM API를 사용해야 하는 경우
- 출력이 텍스트이고 파일이 아닌 경우. 요약, 질문 응답, 분류, 초안 작성은 텍스트 입력-텍스트 출력 작업입니다. 문서 레이어가 필요 없습니다.
- 이미 LLM 스택을 보유한 경우. 팀이 프롬프트 엔지니어링, RAG, 오케스트레이션 인프라에 투자했다면 텍스트 전용 워크플로우에는 문서 SDK를 추가할 필요가 없을 수 있습니다.
-
입력이 일반 텍스트 또는 Markdown인 경우. 원본 자료가 이미 텍스트(
.pdf또는.xlsx가 아닌)라면 추출 문제는 사라지고 원시 LLM 호출이 가장 간단한 방법입니다.
Document AI 에이전트를 사용해야 하는 경우
-
출력이 실제 Office 또는 PDF 파일이어야 하는 경우. 산출물이 회계용
.xlsx워크북, 경영진용.docx보고서 또는 배포용.pdf인 경우, 워크플로우가 유효하고 서식이 지정된 Office 파일을 안정적으로 생성해야 할 때 문서 처리 레이어가 중요해집니다. - 입력이 여러 형식에 걸쳐 있는 경우. 동일한 워크플로우에 PDF, Word 문서, Excel 파일, 스캔 이미지가 함께 들어옵니다. 원시 LLM은 형식별로 별도의 추출 라이브러리가 필요하지만, 에이전트는 하나의 지시문으로 모두 처리합니다.
- 서식이 중요한 경우. 열 머리글, 숫자 서식, 조건부 채우기, 테이블 스타일, 글꼴 — 비즈니스 팀이 파일이 어떻게 보이는지 신경 쓴다면, 이를 보존하는 것은 문서 레이어의 역할입니다.
- .NET을 사용하는 경우. AI 오케스트레이션과 문서 처리를 결합한 네이티브 C# SDK는 LLM SDK를 별도의 문서 처리 라이브러리와 결합하는 것보다 애플리케이션 측 통합을 줄일 수 있습니다.
- 워크플로우가 자주 변경되는 경우. 새 공급업체, 새 보고서 레이아웃, 새 검증 규칙 — 변경 시마다 재코딩이 병목이라면 지시문을 편집하는 것이 더 빠르고 저렴합니다.
결정 요약
| 질문 | 원시 LLM API | Document AI 에이전트 |
|---|---|---|
| 출력이 실제 파일(Excel, Word, PDF)인가? | 추가 도구 필요 | 예 |
| 서식이 유지되어야 하는가? | 재구성 파이프라인에 따라 다름 | 문서 레이어가 처리함 |
| 입력이 여러 Office 형식인가? | 형식별 추출 필요 | 예 |
| 텍스트 전용 작업(요약, Q&A)인가? | 예 | 가능하지만 불필요함 |
| .NET에서 네이티브 문서 조작이 필요한가? | 추가 문서 라이브러리 필요 | 워크플로우에 내장됨 |
| 워크플로우 규칙이 자주 변경될 것인가? | 프롬프트와 파서 재조정 필요 | 지시문 편집으로 동작 변경 |
5. C# 최소 예제
차이는 코드에서 가장 명확합니다. 아래는 PDF 인보이스에서 데이터를 추출하여 서식이 지정된 Excel 보고서를 생성하는 동일한 작업을 두 가지 방식으로 구현한 것입니다.
원시 LLM API 방식
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
설명용 파이프라인: 특정 공급업체 SDK가 아닌 아키텍처에 초점을 맞추기 위해 API 및 문서 라이브러리 호출을 단순화했습니다.
Document AI 에이전트 방식
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
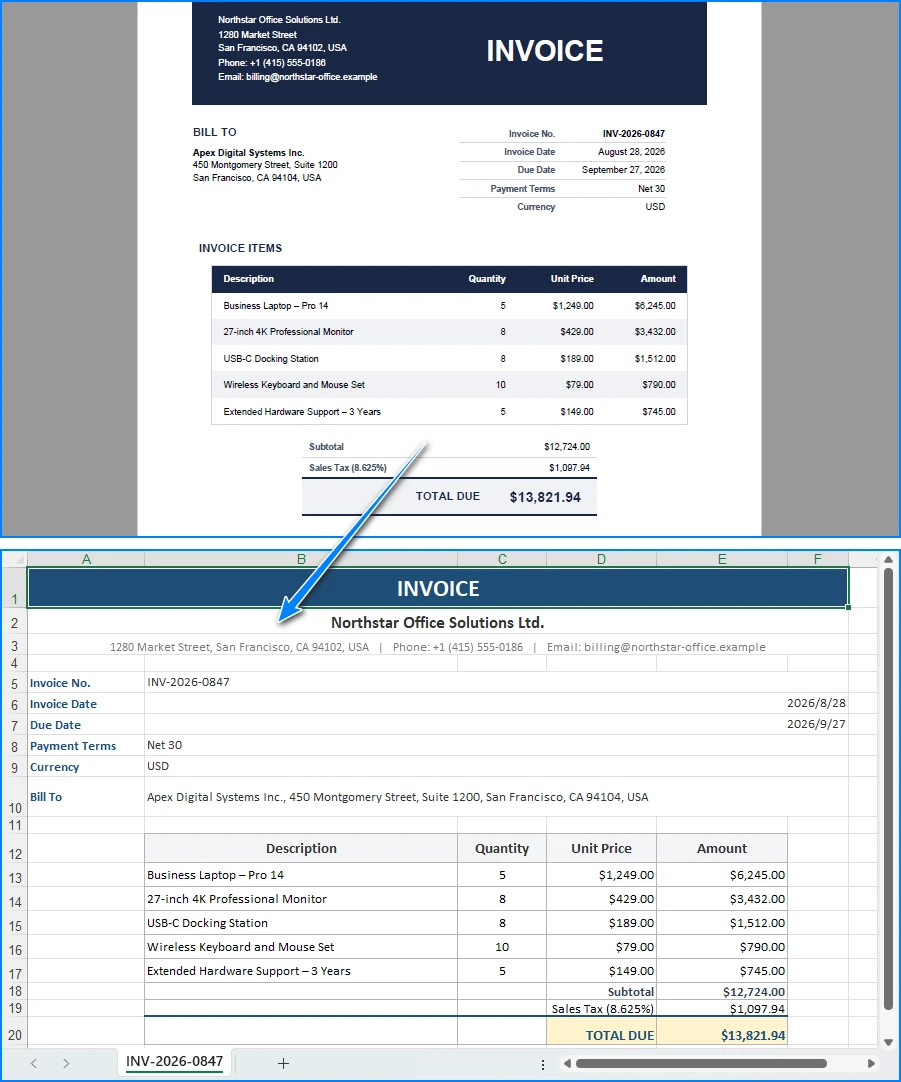
에이전트는 PDF 인보이스를 읽고 서식이 지정된 Excel 보고서를 생성합니다:
주요 API 호출
-
Workbook.AI(agentOptions)— AI 문서 프로세서를 워크북 객체에 연결 -
ExecuteInstruction(doc, instruction, savePath, attachments)— 지시문을 실행하고 출력 파일을 작성 -
AIResult.Success/AIResult.ErrorMessage— 결과 확인 및 오류 표시
원시 LLM 방식은 추출, 프롬프팅, 파싱, 파일 작성이라는 네 가지 개별 문제를 이어 붙인 것입니다. 에이전트 방식은 지시문 하나와 결과 확인 하나입니다. 두 방식 모두 궁극적으로 .xlsx 파일을 생성할 수 있지만, 원시 LLM 방식은 문서 생성 레이어를 직접 구축하고 유지 관리해야 합니다. 에이전트는 문서 처리 레이어를 워크플로우에 통합하므로, LLM은 지시문 해석에 집중하고 SDK는 문서 작업을 처리합니다.
관련 자료: .NET에서 AI 에이전트로 인보이스 처리 자동화 — 전체 추출, 검증 및 보고 워크플로우
6. .NET 팀을 위한 Spire.Agent.Office의 장점
위의 비교는 의도적으로 제품 중립적입니다. 동일한 아키텍처(LLM + 문서 레이어)는 모든 유능한 모델과 모든 문서 SDK에서 작동합니다. .NET 팀을 위해 Spire.Agent.Office가 자리잡는 이유는 세 가지 특정 영역입니다:
-
네이티브 다중 형식 처리. PDF, Word 문서, Excel 파일 및 이미지 기반 문서 워크플로우를 에이전트 워크플로우에 통합할 수 있습니다. 에이전트는 단일 지시문으로 이러한 형식을 읽고, 추출하고, 생성합니다. 형식별 추출 라이브러리도, 형식별 출력 포맷터도 필요 없습니다.
-
결정론적 문서 작업을 통한 문서 서식 보존. 문서 레이어는 열 머리글, 숫자 서식, 조건부 채우기, 테이블 스타일 및 글꼴을 그대로 유지합니다. 기존 템플릿에서 작업할 때 에이전트에게 원본 레이아웃과 스타일을 보존하도록 명시적으로 지시하면 추가 코드 없이 출력이 템플릿을 따릅니다.
-
네이티브 .NET 통합. 기존 .NET 응용 프로그램에 바로 통합되는 C# SDK입니다. 구축하거나 유지 관리할 별도의 문서 처리 서비스도, 서비스 간 연결 코드도, HTTP 오케스트레이션 레이어도 없습니다. 위의 예제는 SDK 설정, 지시문 하나, 결과 확인 하나라는 핵심 통합 지점을 보여줍니다.
이미 문서 처리용 Spire.Office를 사용하고 있다면 에이전트는 자연스러운 다음 레이어입니다. 익숙한 Workbook 객체에 지시문을 실행된 워크플로우로 변환하는 AI() 프로세서가 추가됩니다. 이미 알고 있는 결정론적 SDK가 에이전트가 호출하는 문서 레이어가 됩니다.
7. FAQ
PDF를 LLM API에 직접 보내면 안 되나요?
보낼 수 있습니다. 최신 LLM API는 PDF를 포함한 일부 문서 유형을 직접 수용할 수 있습니다. 중요한 차이점은 파일 입력이 모델에게 문서 콘텐츠에 대한 접근을 제공한다는 것이지, 원본 Office 구조를 수정하고 프로덕션에 사용할 수 있는 출력 파일을 저장하기 위한 결정론적 API를 응용 프로그램에 자동으로 제공하는 것은 아니라는 점입니다. 예를 들어 모델이 PDF에서 인보이스 테이블을 올바르게 식별할 수 있지만, 그 이해를 서식 있는 .xlsx 파일로 변환하려면 여전히 문서 생성 로직이 필요합니다.
"문서 레이어"란 정확히 무엇인가요?
문서 레이어는 Office 및 PDF 파일을 네이티브 문서 구조로 읽고 쓰는 결정론적 SDK입니다. LLM이 수행할 수 없는 작업을 처리합니다. .xlsx 파일을 열어 시트와 수식을 보존하고, 올바른 스타일과 머리글로 .docx를 작성하고, 셀을 병합하고, 조건부 서식을 적용하고, 결정론적 문서 API를 통해 구조적으로 유효한 Office/PDF 출력을 생성합니다. Spire.Agent.Office에서 문서 레이어는 Spire.Office SDK입니다. LLM이 무엇을 할지 결정하고 문서 레이어가 실행합니다.
단지 RAG에 단계만 추가된 것 아닌가요?
아닙니다. RAG(검색 증강 생성)는 주로 모델 응답의 근거가 될 관련 정보를 검색하는 데 중점을 둡니다. 문서 AI 에이전트는 문서 작업을 실행하고 실제 파일을 생성하거나 수정하는 또 다른 책임을 추가합니다. 문서 에이전트는 실제 파일을 읽고 쓰고, 서식을 보존하며, 텍스트 응답이 아닌 유효한 Office 문서인 구조화된 출력을 생성합니다.
Spire.Agent.Office는 어떤 AI 모델을 지원하나요?
Spire.Agent.Office는 SpireToken 키 뒤의 대규모 언어 모델에 연결되며 호스팅 모델 API와 사용자 지정 모델 엔드포인트를 지원합니다. 배포 환경에서 지원되는 공급자 및 모델 프로토콜에 대한 질문은 영업팀에 문의하세요.
내 데이터가 내 환경 안에 유지되나요?
SDK, 템플릿 및 문서 처리는 응용 프로그램 내부에서 실행됩니다. 파일이 저장 또는 변환을 위해 타사 문서 서비스에 업로드되지는 않습니다. 콘텐츠를 분석하려면 AI가 관련 텍스트가 필요하며, 해당 텍스트는 처리를 위해 모델로 전송됩니다. 모델 엔드포인트가 자체 네트워크 내에 배포되어 있고 구성이 문서 콘텐츠를 외부로 전송하지 않는다면 문서 콘텐츠는 인프라 내에 유지될 수 있습니다. OpenAI 또는 Azure OpenAI와 같은 호스팅 모델 API를 통해 연결하는 경우 관련 콘텐츠는 구성에 따라 해당 공급자에게 전송됩니다.
원시 LLM API가 적합한 경우는 언제인가요?
파일 출력이 필요 없는 텍스트 전용 작업의 경우입니다. 문서 요약, 콘텐츠에 대한 질문 응답, 범주 분류, 이메일 응답 초안 작성 등입니다. 입력이 이미 일반 텍스트이고 출력도 일반 텍스트라면 문서 레이어는 가치 없이 복잡성만 추가합니다. 에이전트는 워크플로우가 유효하고 서식이 지정된 실제 파일을 생성할 때 그 가치를 발휘합니다.
LLM 워크플로우에 문서 레이어를 추가할 준비가 되셨나요?
응용 프로그램이 인보이스, 계약서, 보고서 또는 기타 Office 문서 워크플로우를 처리한다면, 문서 AI 에이전트는 추출 및 재구성 파이프라인을 구축하지 않고도 하나의 자연어 지시문을 실제 서식 있는 파일로 변환합니다. 시작하기 튜토리얼을 따라 .NET에서 첫 워크플로우를 실행해 보세요.
추가 자료
- C#에서 Excel 데이터로 Word 문서 생성 — 결정론적 SDK를 사용한 데이터 기반 문서 생성
- C#에서 AI 기반 Excel 보고서 어시스턴트 만들기 — 자동화된 보고서 생성 및 분석
- Spire.Agent.Office 제품 개요 — 모든 Office 문서 형식을 위한 AI 에이전트 SDK