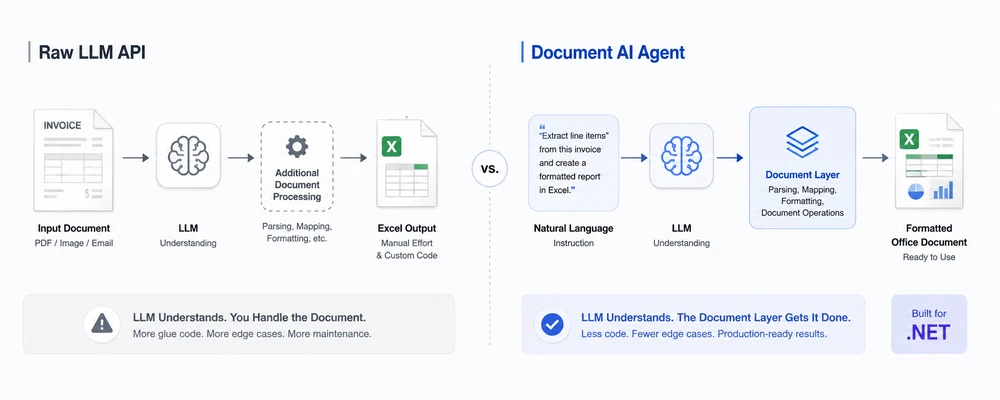
Un utente carica un PDF di fattura e chiede:
"Estrai le voci, calcola il totale e crea un report Excel formattato."
Un moderno LLM può comprendere la fattura e identificare le informazioni necessarie. Ma questa è solo metà del problema. La tua applicazione deve comunque trasformare quella comprensione in un vero file .xlsx formattato con la struttura documentale richiesta.
Questo è il divario tra comprendere un documento e operare su un documento. Un'API LLM grezza fornisce capacità linguistiche e di ragionamento, ma non offre da sola un flusso di lavoro completo per la manipolazione di documenti Office. Un agente AI per documenti collega l'LLM a un SDK deterministico di elaborazione documentale, così l'LLM determina cosa dovrebbe accadere e il livello documentale esegue le operazioni sui file.
Navigazione rapida
- Il problema: API LLM grezze e file di documenti
- Cosa aggiunge un agente AI per documenti
- Confronto affiancato
- Quando usare ciascun approccio
- Un esempio minimale in C#
- Perché Spire.Agent.Office per i team .NET
- FAQ
1. Il problema: API LLM grezze e file di documenti
Chiamare gpt-4 o claude direttamente per "elaborare questo documento" fallisce in tre modi che contano in produzione. Queste criticità diventano importanti non appena un flusso di lavoro documentale va oltre la semplice estrazione di testo e richiede manipolazione affidabile dei file, validazione e formattazione.
1.1 Gli LLM non possono leggere o scrivere in modo affidabile i file Office
I modelli linguistici di grandi dimensioni possono comprendere il contenuto di un documento quando il modello e l'API supportano il tipo di file o l'input multimodale pertinente, ma questo non fornisce una manipolazione deterministica del documento. Un modello può essere in grado di analizzare testo, tabelle o contenuti visivi di un PDF, ma ciò non significa che possa modificare in modo deterministico una cartella di lavoro, preservare ogni proprietà specifica di Office e salvare il risultato come file .xlsx pronto per la produzione attraverso l'API LLM stessa. Quando un file Office viene fornito a un'API LLM grezza, il modello può ricevere contenuti estratti o trasformati anziché un oggetto cartella di lavoro nativo e modificabile. Anche quando il modello riesce a comprendere il contenuto della cartella di lavoro, l'API da sola non fornisce operazioni deterministiche per preservare e modificare la struttura nativa della cartella di lavoro (fogli, intervalli denominati, formule, formattazione condizionale, celle unite, formati numerici).
L'analisi dei documenti tramite LLM grezzi può estrarre informazioni semantiche utili, ma l'analisi semantica è diversa dalla conservazione e dalla manipolazione della struttura nativa del documento.
La scrittura è lo stesso problema al contrario. Un'API LLM grezza non fornisce, da sola, un livello deterministico di manipolazione dei documenti Office. Un LLM può descrivere cosa dovrebbe contenere un report, ma produrre un file .docx o .xlsx valido richiede strumenti aggiuntivi. Per ottenere un output Office reale da un LLM grezzo, devi costruire una pipeline di ricostruzione: analizzare la risposta testuale del modello, mappare i campi su celle o paragrafi, applicare la formattazione e scrivere tu stesso il file. Questa pipeline non è banale — ed è la parte che si rompe in produzione.
1.2 La formattazione non è garantita
I flussi di lavoro documentali portano con sé una formattazione importante: intestazioni di colonna in un report di fatturazione, formati numerici in un foglio elettronico finanziario, riempimenti condizionali che evidenziano discrepanze, stili di tabella in un report direzionale. Un'API LLM grezza restituisce contenuti generati dal modello, come testo, JSON o chiamate di strumenti; non fornisce intrinsecamente un documento Office formattato come output. La formattazione può essere difficile da preservare quando la risposta del modello deve essere ricostruita in un file Office — un foglio Excel senza formati numerici è un foglio che qualcuno deve correggere a mano prima che possa arrivare alla contabilità.
Anche quando l'LLM produce output strutturato (JSON, tabelle Markdown), l'output strutturato non è output di documento strutturato. Il JSON fornisce dati strutturati, non un documento Office strutturato. Una risposta JSON può descrivere celle, paragrafi, tabelle o istruzioni di formattazione, ma è comunque necessario un ulteriore livello di elaborazione documentale per applicare tali istruzioni a un file .xlsx, .docx, .pptx o .pdf reale. A questo punto devi mantenere un formattatore, un mapper di campi e un applicatore di stili — nessuno dei quali riceve aiuto dall'LLM.
1.3 Reimplementi l'intera orchestrazione
Una pipeline documentale basata su LLM grezzo non è una singola chiamata API. È uno stack:
- Progettazione del prompt — prompt basati su modelli che si rompono quando cambia il layout del documento
- Estrazione — potrebbero essere necessari strumenti aggiuntivi di elaborazione documenti per estrarre contenuti strutturati da file PDF, Word ed Excel prima che l'LLM li veda
- Parsing — logica di parsing JSON per trasformare la risposta dell'LLM in dati strutturati
- Logica di retry — gestione di output allucinati, limiti di velocità e rifiuti del filtro contenuti
- I/O dei file — lettura degli input, scrittura degli output, gestione dei file temporanei
- Validazione dell'output — verifica che il file prodotto sia valido e ben formato prima di restituirlo all'utente
A quel punto, stai costruendo una soluzione di elaborazione documenti — con un LLM come componente, non come soluzione stessa. Ogni nuovo tipo di documento, modifica dello schema o formato di output significa ritoccare i prompt e ricontrollare le peculiarità specifiche del modello. Il carico di manutenzione cresce linearmente con il numero di tipi di documento supportati.
2. Cosa aggiunge un agente AI per documenti
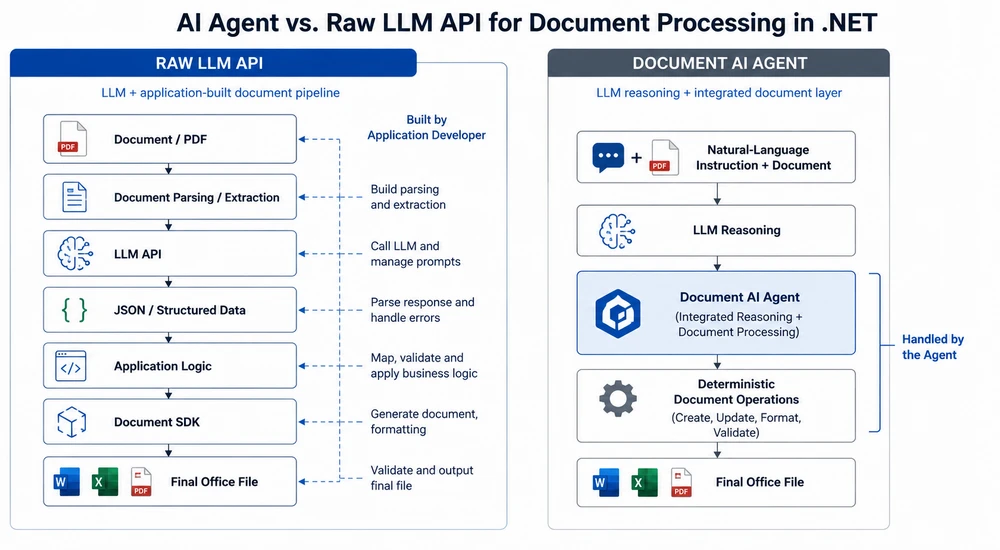
Un agente AI per documenti risolve i tre problemi sopra descritti accoppiando l'LLM a un livello deterministico di elaborazione documentale. La divisione del lavoro è chiara:
- L'LLM gestisce la comprensione. Legge l'istruzione in linguaggio naturale, decide cosa estrarre o generare e determina la struttura dell'output.
- Il livello documentale gestisce l'esecuzione. Legge e scrive file Office e PDF reali, preserva la formattazione, applica stili e utilizza operazioni documentali deterministiche per produrre un file strutturalmente valido.
Invece di chiedere all'LLM di "capire da solo" la struttura del documento, l'agente invoca operazioni documentali deterministiche. Il modello non deve costruire da sé il formato del file Office; produce l'intenzione e il livello documentale esegue le corrispondenti operazioni sui file.
Le due architetture affiancate:
Come appare in pratica
| Problema con LLM grezzo | Come lo risolve l'agente |
|---|---|
Nessuna manipolazione nativa dei file .xlsx
|
Il livello documentale legge e manipola la cartella di lavoro in modo nativo |
| Nessuna generazione deterministica di file Office | Il livello documentale crea il file di output |
| La formattazione può essere persa durante la ricostruzione | Il livello documentale gestisce stili e formati numerici |
| La struttura generata dal modello può essere incoerente | Le operazioni documentali sono deterministiche |
| Devi costruire tu la pipeline circostante | L'SDK dell'agente fornisce il flusso di elaborazione documentale |
Il punto chiave: l'LLM è il cervello, il livello documentale sono le mani. Un'API LLM grezza ti dà il cervello e si aspetta che costruisca tu le mani. Un agente AI per documenti ti dà entrambi, integrati, in un'unica chiamata SDK.
Un SDK documentale da solo può manipolare file, ma non comprende l'intento in linguaggio naturale. Un agente AI combina quel livello documentale deterministico con un LLM, così gli utenti possono descrivere il flusso di lavoro desiderato invece di implementare manualmente ogni operazione documentale. Il valore non è "SDK documentale + AI" — è la pipeline: istruzione in linguaggio naturale → ragionamento LLM → operazioni documentali deterministiche.
Lettura consigliata: AI Agent per l'elaborazione documentale: cos'è e come funziona — il concetto di agente AI per documenti spiegato.
3. Confronto affiancato
| Dimensione | API LLM grezza | Agente AI per documenti |
|---|---|---|
| Comprensione dei file | Dipende dal modello/API e dal tipo di file | Il livello documentale fornisce accesso nativo ai documenti |
| Manipolazione dei file | Richiede strumenti o librerie documentali aggiuntive | Integrata nel livello di elaborazione documentale |
| Fedeltà della formattazione | Dipende dalla logica di ricostruzione | Gestita da API documentali deterministiche |
| Gestione dell'output | La risposta dell'LLM deve essere analizzata e convertita in un file | Il livello documentale esegue la creazione deterministica del file |
| Volume di codice | Maggiore orchestrazione lato applicazione | Istruzione in linguaggio naturale + configurazione SDK |
| Manutenzione | Prompt, parser, mapping e logica dei file | Più aspetti del flusso possono essere espressi nelle istruzioni |
| Elaborazione multiformato | Richiede supporto specifico per formato | Flusso di elaborazione documentale unificato |
| Accuratezza semantica | Dipende dal modello e dal prompt | Dipende comunque dal modello e dall'istruzione |
| Validazione dei file | Responsabilità dell'applicazione | L'SDK segnala successo/fallimento dell'elaborazione |
| Integrazione .NET | SDK .NET o integrazione HTTP, oltre a librerie di elaborazione documentale aggiuntive se necessario | SDK C# nativo con elaborazione documentale |
| Ideale per | Attività AI incentrate sul testo | Flussi di lavoro documentali basati sull'AI |
4. Quando usare ciascun approccio
Il confronto non è "l'agente è sempre migliore". Le API LLM grezze e gli agenti AI per documenti servono intenti diversi e scegliere lo strumento giusto dipende da ciò che il flusso di lavoro produce.
Usa un'API LLM grezza quando
- L'output è testo, non un file. Riepilogo, risposta a domande, classificazione e bozze sono attività da testo a testo. Non serve alcun livello documentale.
- Hai già uno stack LLM. Se il tuo team ha investito in prompt engineering, RAG e infrastruttura di orchestrazione, aggiungere un SDK documentale potrebbe essere superfluo per flussi di lavoro solo testo.
-
L'input è testo semplice o Markdown. Se il materiale sorgente è già testo — non
.pdfo.xlsx— il problema dell'estrazione scompare e una chiamata LLM grezza è il percorso più semplice.
Usa un agente AI per documenti quando
-
L'output deve essere un file Office o PDF reale. Se il risultato finale è una cartella di lavoro
.xlsxper la contabilità, un report.docxper la direzione o un.pdfper la distribuzione, un livello di elaborazione documentale diventa importante quando il flusso deve produrre in modo affidabile un file Office valido e formattato. - L'input copre più formati. PDF, documenti Word, file Excel e immagini scannerizzate che arrivano nello stesso flusso. Un LLM grezzo necessita di una libreria di estrazione separata per ogni formato; un agente gestisce tutti i formati con un'unica istruzione.
- La formattazione è importante. Intestazioni di colonna, formati numerici, riempimenti condizionali, stili di tabella, caratteri — se il team aziendale tiene a come appare il file, è il livello documentale a preservarlo.
- Sei in .NET. Un SDK C# nativo che combina orchestrazione AI ed elaborazione documentale può ridurre l'integrazione lato applicazione rispetto alla combinazione di un SDK LLM con librerie di elaborazione documentale separate.
- Il flusso di lavoro cambia spesso. Nuovi fornitori, nuovi layout di report, nuove regole di validazione — quando il collo di bottiglia è riscrivere il codice a ogni modifica, modificare un'istruzione è più veloce ed economico.
Riepilogo delle decisioni
| Domanda | API LLM grezza | Agente AI per documenti |
|---|---|---|
| L'output è un file reale (Excel, Word, PDF)? | Richiede strumenti aggiuntivi | Sì |
| La formattazione deve essere preservata? | Dipende dalla tua pipeline di ricostruzione | Gestita dal livello documentale |
| Gli input sono in più formati Office? | Richiede estrazione specifica per formato | Sì |
| È un'attività solo testo (riepilogo, Q&A)? | Sì | Possibile, ma non necessario |
| Hai bisogno di manipolazione nativa dei documenti in .NET? | Richiede una libreria documentale aggiuntiva | Integrato nel flusso di lavoro |
| Le regole del flusso cambieranno frequentemente? | Prompt e parser devono essere ritoccati | Modifica il comportamento modificando l'istruzione |
5. Un esempio minimale in C#
La differenza è più chiara nel codice. Di seguito lo stesso compito — estrarre dati da una fattura PDF e produrre un report Excel formattato — implementato in entrambi i modi.
Approccio con API LLM grezza
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
Pipeline illustrativa: le chiamate API e della libreria documentale sono semplificate per concentrarsi sull'architettura piuttosto che su un SDK specifico del fornitore.
Approccio con agente AI per documenti
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
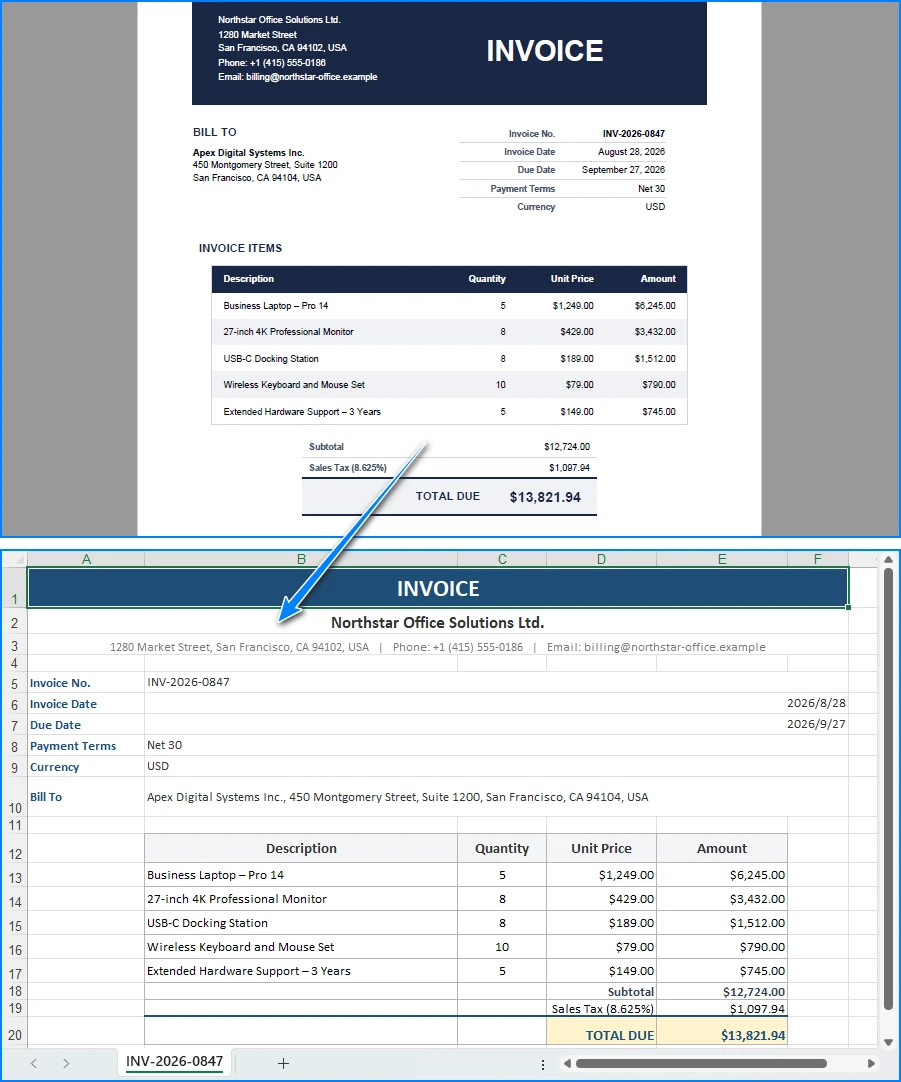
L'agente legge la fattura PDF e produce un report Excel formattato:
Principali chiamate API
-
Workbook.AI(agentOptions)— collega il processore AI di documenti a un oggetto cartella di lavoro -
ExecuteInstruction(doc, instruction, savePath, attachments)— esegue l'istruzione e scrive il file di output -
AIResult.Success/AIResult.ErrorMessage— verifica il risultato e segnala gli errori
L'approccio con LLM grezzo è composto da quattro problemi separati (estrazione, prompt, parsing, scrittura del file) cuciti insieme. L'approccio agente è un'istruzione e un controllo del risultato. Entrambi gli approcci possono alla fine produrre un file .xlsx, ma l'approccio con LLM grezzo richiede di costruire e mantenere da soli il livello di generazione dei documenti. L'agente integra quel livello di elaborazione documentale nel flusso di lavoro, così l'LLM si concentra sull'interpretazione dell'istruzione mentre l'SDK gestisce le operazioni documentali.
Potrebbe interessarti anche: Automatizza l'elaborazione delle fatture con un agente AI in .NET — un flusso completo di estrazione, validazione e reporting.
6. Perché Spire.Agent.Office per i team .NET
Il confronto qui sopra è volutamente neutrale rispetto al prodotto; la stessa architettura (LLM + livello documentale) funziona con qualsiasi modello capace e qualsiasi SDK documentale. Dove Spire.Agent.Office trova il suo posto per i team .NET è in tre aree specifiche:
-
Elaborazione multiformato nativa. PDF, documenti Word, file Excel e flussi di lavoro documentali basati su immagini possono essere incorporati nel flusso dell'agente. L'agente legge, estrae e genera in questi formati con una singola istruzione — nessuna libreria di estrazione per formato, nessun formattatore di output per formato.
-
La formattazione dei documenti può essere preservata tramite operazioni documentali deterministiche. Il livello documentale mantiene intatte intestazioni di colonna, formati numerici, riempimenti condizionali, stili di tabella e caratteri. Quando si parte da un template esistente, istruisci esplicitamente l'agente a preservare il layout e lo stile originali e l'output rimane fedele al template senza codice aggiuntivo.
-
Integrazione nativa .NET. È un SDK C# che si inserisce in un'applicazione .NET esistente. Nessun servizio di elaborazione documentale separato da costruire o mantenere, nessuna infrastruttura tra servizi, nessun livello di orchestrazione HTTP. L'esempio precedente rappresenta la superficie di integrazione principale: configurazione SDK, un'istruzione e un controllo del risultato.
Se utilizzi già Spire.Office per l'elaborazione documentale, l'agente è il livello successivo naturale: lo stesso oggetto Workbook acquisisce un processore AI() che trasforma le istruzioni in flussi di lavoro eseguiti. L'SDK deterministico che già conosci diventa il livello documentale chiamato dall'agente.
7. FAQ
Non posso semplicemente inviare il PDF direttamente all'API LLM?
Puoi. Le API LLM moderne possono accettare direttamente alcuni tipi di documento, inclusi i PDF. La distinzione importante è che l'input di file dà al modello accesso al contenuto del documento; non dà automaticamente alla tua applicazione un'API deterministica per modificare la struttura Office originale e salvare un file di output pronto per la produzione. Ad esempio, un modello può identificare correttamente le tabelle di una fattura in un PDF, ma trasformare quella comprensione in un .xlsx formattato richiede comunque una logica di generazione del documento.
Che cos'è esattamente un "livello documentale"?
Un livello documentale è un SDK deterministico che legge e scrive file Office e PDF lavorando con le loro strutture documentali native. Gestisce le operazioni che un LLM non può fare: aprire un .xlsx e preservarne fogli e formule, scrivere un .docx con stili e intestazioni corretti, unire celle, applicare formattazione condizionale e creare output Office/PDF strutturalmente validi tramite API documentali deterministiche. In Spire.Agent.Office, il livello documentale è l'SDK Spire.Office; l'LLM decide cosa fare e il livello documentale lo esegue.
È solo RAG con passaggi in più?
No. La RAG (generazione aumentata da recupero) si concentra principalmente sul recupero di informazioni rilevanti per ancorare le risposte del modello. Un agente AI per documenti aggiunge un'altra responsabilità: eseguire operazioni documentali e produrre o modificare file reali. Un agente documentale legge e scrive file reali, preserva la formattazione e produce un output strutturato che è un documento Office valido, non una risposta testuale.
Quali modelli AI supporta Spire.Agent.Office?
Spire.Agent.Office si connette a un modello linguistico di grandi dimensioni tramite una chiave SpireToken e supporta API di modelli ospitati oltre a endpoint di modelli personalizzati. Per domande su quali provider e protocolli di modelli siano supportati nella tua implementazione, contatta le vendite.
I miei dati restano all'interno del mio ambiente?
L'SDK, i template e l'elaborazione documentale vengono eseguiti all'interno della tua applicazione — i file non vengono caricati su un servizio documentale di terze parti per l'archiviazione o la conversione. Per analizzare il contenuto, l'AI ha bisogno del testo pertinente e questo viene inviato al modello per l'elaborazione. Se l'endpoint del modello è distribuito all'interno della tua rete e la tua configurazione non invia contenuti documentali all'esterno, il contenuto dei documenti può rimanere nella tua infrastruttura. Se ti connetti tramite un'API di modello ospitato come OpenAI o Azure OpenAI, il contenuto pertinente viene trasmesso a quel fornitore secondo la tua configurazione.
Quando è giusto scegliere un'API LLM grezza?
Per attività esclusivamente testuali in cui non è richiesto alcun output di file: riassumere un documento, rispondere a domande sul suo contenuto, classificarlo in una categoria o redigere una bozza di risposta via email. Se l'input è già testo semplice e anche l'output è testo semplice, un livello documentale aggiunge complessità senza valore. L'agente trova la sua ragion d'essere quando il flusso produce file reali che devono essere validi e formattati.
Pronto ad aggiungere un livello documentale ai tuoi flussi di lavoro LLM?
Se la tua applicazione elabora fatture, contratti, report o qualsiasi flusso di documenti Office, un agente AI per documenti trasforma un'istruzione in linguaggio naturale in un file reale e formattato — senza dover costruire una pipeline di estrazione e ricostruzione. Segui il tutorial Per iniziare per eseguire il tuo primo flusso di lavoro in .NET.
Per approfondire
- Generare documenti Word da dati Excel in C# — generazione documentale guidata dai dati con l'SDK deterministico
- Creare un assistente per report Excel basato sull'AI in C# — automazione della generazione e dell'analisi dei report
- Panoramica del prodotto Spire.Agent.Office — SDK agente AI per ogni formato di documento Office