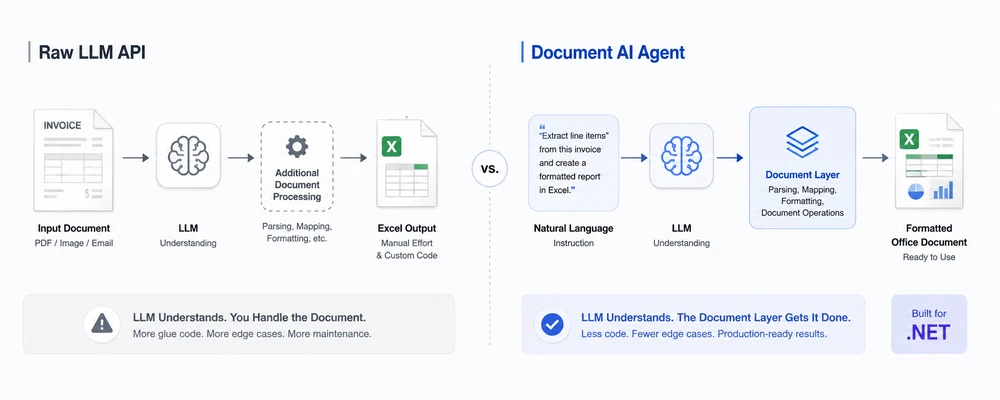
Un utilisateur télécharge une facture PDF et demande :
« Extrayez les lignes de facture, calculez le total et créez un rapport Excel formaté. »
Un LLM moderne peut comprendre la facture et identifier les informations dont vous avez besoin. Mais ce n'est que la moitié du problème. Votre application doit encore transformer cette compréhension en un véritable fichier .xlsx formaté avec la structure documentaire requise.
C'est l'écart entre comprendre un document et opérer sur un document. Une API LLM brute offre des capacités de langage et de raisonnement, mais elle ne fournit pas à elle seule un flux de travail complet de manipulation de documents Office. Un agent IA documentaire connecte le LLM à un SDK déterministe de traitement de documents, afin que le LLM détermine ce qui doit se passer et que la couche documentaire exécute les opérations sur les fichiers.
Navigation rapide
- Le problème : les API LLM brutes et les fichiers documentaires
- Ce qu'apporte un agent IA documentaire
- Comparaison côte à côte
- Quand utiliser chaque approche
- Un exemple minimal en C#
- Pourquoi Spire.Agent.Office pour les équipes .NET
- FAQ
1. Le problème : les API LLM brutes et les fichiers documentaires
Appeler gpt-4 ou claude directement pour « traiter ce document » échoue de trois manières qui comptent en production. Ces préoccupations deviennent importantes dès qu'un flux de travail documentaire dépasse la simple extraction de texte et exige une manipulation fiable des fichiers, une validation et une mise en forme.
1.1 Les LLM ne peuvent pas lire ni écrire les fichiers Office de manière fiable
Les grands modèles de langage peuvent comprendre le contenu d'un document lorsque le modèle et l'API prennent en charge le fichier concerné ou une entrée multimodale, mais cela ne fournit pas une manipulation documentaire déterministe. Un modèle peut être capable d'analyser le texte, les tableaux ou le contenu visuel d'un PDF, mais cela ne signifie pas qu'il peut modifier de manière déterministe un classeur, préserver chaque propriété spécifique à Office et enregistrer le résultat comme un fichier .xlsx prêt pour la production via l'API LLM elle-même. Lorsqu'un fichier Office est fourni à une API LLM brute, le modèle peut recevoir un contenu extrait ou transformé plutôt qu'un objet classeur natif et modifiable. Même lorsque le modèle peut comprendre le contenu du classeur, l'API ne fournit pas à elle seule des opérations déterministes pour préserver et modifier la structure native du classeur (feuilles, plages nommées, formules, mise en forme conditionnelle, cellules fusionnées, formats de nombres).
L'analyse documentaire par LLM brut peut extraire des informations sémantiques utiles, mais l'analyse sémantique est différente de la préservation et de la manipulation de la structure documentaire native.
L'écriture est le même problème en sens inverse. Une API LLM brute ne fournit pas, par elle-même, une couche déterministe de manipulation de documents Office. Un LLM peut décrire ce qu'un rapport devrait contenir, mais produire un fichier .docx ou .xlsx valide nécessite des outils supplémentaires. Pour produire une véritable sortie Office à partir d'un LLM brut, vous devez construire un pipeline de reconstruction : analyser la réponse textuelle du modèle, mapper les champs vers des cellules ou des paragraphes, appliquer la mise en forme et écrire le fichier vous-même. Ce pipeline est non trivial — et c'est la partie qui casse en production.
1.2 La mise en forme n'est pas garantie
Les flux de travail documentaires portent une mise en forme qui importe : les en-têtes de colonnes dans un rapport de factures, les formats de nombres dans une feuille de calcul financière, les remplissages conditionnels qui signalent les écarts, les styles de tableaux dans un rapport de gestion. Une API LLM brute renvoie un contenu généré par le modèle, tel que du texte, du JSON ou des appels d'outils ; elle ne fournit pas intrinsèquement un document Office formaté en sortie. La mise en forme peut être difficile à préserver lorsque la réponse du modèle doit être reconstruite dans un fichier Office — une feuille Excel sans formats de nombres est une feuille que quelqu'un doit corriger à la main avant qu'elle puisse être envoyée à la comptabilité.
Même lorsque le LLM produit une sortie structurée (JSON, tableaux Markdown), une sortie structurée n'est pas une sortie documentaire structurée. Le JSON vous donne des données structurées, pas un document Office structuré. Une réponse JSON peut décrire des cellules, des paragraphes, des tableaux ou des instructions de mise en forme, mais une couche supplémentaire de traitement de documents est toujours requise pour appliquer ces instructions à un véritable fichier .xlsx, .docx, .pptx ou .pdf. Vous devez alors maintenir un formateur, un mappeur de champs et un applicateur de styles — autant d'éléments que le LLM ne vous aide pas à gérer.
1.3 Vous réimplémentez toute l'orchestration
Un pipeline documentaire basé sur un LLM brut n'est pas un seul appel API. C'est une pile :
- Conception des invites — des invites basées sur des modèles qui cassent lorsque la disposition du document change
- Extraction — des outils supplémentaires de traitement de documents peuvent être nécessaires pour extraire le contenu structuré des fichiers PDF, Word et Excel avant que le LLM ne le voie
- Analyse — une logique d'analyse JSON pour transformer la réponse du LLM en données structurées
- Logique de nouvelle tentative — gestion des sorties hallucinées, des limites de débit et des rejets du filtre de contenu
- Entrées/sorties de fichiers — lecture des entrées, écriture des sorties, gestion des fichiers temporaires
- Validation de la sortie — vérification que le fichier produit est valide et bien formé avant de le renvoyer à l'utilisateur
À ce stade, vous construisez une solution de traitement de documents — avec un LLM comme composant, pas comme la solution elle-même. Chaque nouveau type de document, changement de schéma ou format de sortie signifie réajuster les invites et re-tester les particularités propres au modèle. La charge de maintenance croît linéairement avec le nombre de types de documents que vous prenez en charge.
2. Ce qu'apporte un agent IA documentaire
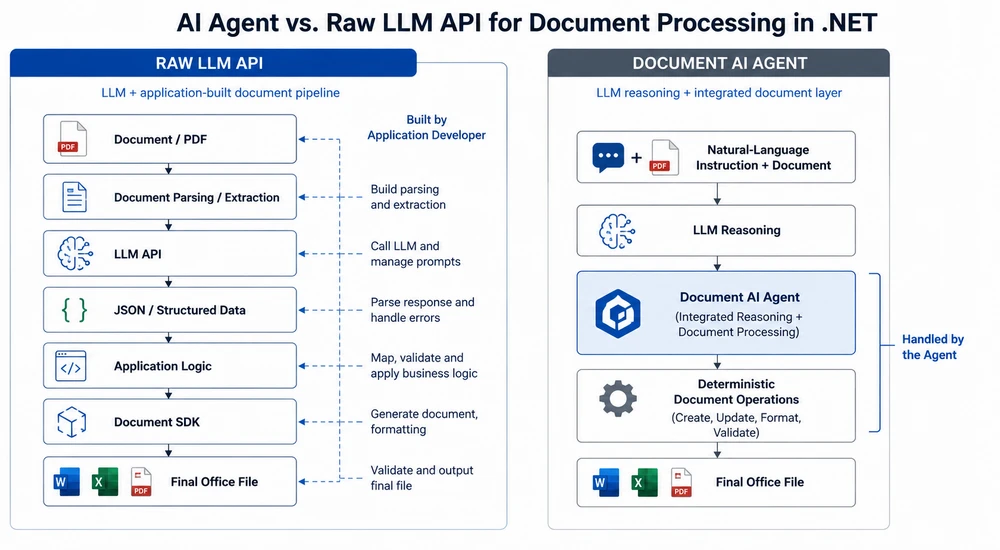
Un agent IA documentaire résout les trois problèmes ci-dessus en associant le LLM à une couche déterministe de traitement de documents. La répartition des tâches est claire :
- Le LLM gère la compréhension. Il lit l'instruction en langage naturel, décide quoi extraire ou générer et détermine la structure de la sortie.
- La couche documentaire gère l'exécution. Elle lit et écrit de véritables fichiers Office et PDF, préserve la mise en forme, applique les styles et utilise des opérations documentaires déterministes pour produire un fichier structurellement valide.
Au lieu de demander au LLM de « comprendre » la structure du document, l'agent invoque des opérations documentaires déterministes. Le modèle n'a pas besoin de construire lui-même le format de fichier Office ; il produit l'intention, et la couche documentaire exécute les opérations correspondantes sur les fichiers.
Les deux architectures côte à côte :
Ce que cela donne en pratique
| Problème avec un LLM brut | Comment l'agent le résout |
|---|---|
Pas de manipulation native du .xlsx
|
La couche documentaire lit et manipule le classeur nativement |
| Pas de génération déterministe de fichiers Office | La couche documentaire crée le fichier de sortie |
| La mise en forme peut être perdue lors de la reconstruction | La couche documentaire gère les styles et les formats de nombres |
| La structure générée par le modèle peut être incohérente | Les opérations documentaires sont déterministes |
| Vous construisez le pipeline environnant | Le SDK de l'agent fournit le flux de travail de traitement de documents |
Le point clé : le LLM est le cerveau, la couche documentaire est les mains. Une API LLM brute vous donne le cerveau et attend que vous construisiez les mains. Un agent IA documentaire vous donne les deux, intégrés, en un seul appel SDK.
Un SDK documentaire seul peut manipuler des fichiers, mais il ne comprend pas l'intention exprimée en langage naturel. Un agent IA combine cette couche documentaire déterministe avec un LLM, afin que les utilisateurs puissent décrire le flux de travail souhaité au lieu d'implémenter manuellement chaque opération documentaire. La valeur ne réside pas dans « SDK documentaire + IA » — elle réside dans le pipeline : instruction en langage naturel → raisonnement du LLM → opérations documentaires déterministes.
Lecture recommandée : Agent IA pour le traitement de documents : ce que c'est et comment cela fonctionne — le concept d'agent IA documentaire expliqué.
3. Comparaison côte à côte
| Dimension | API LLM brute | Agent IA documentaire |
|---|---|---|
| Compréhension des fichiers | Dépend du modèle/de l'API et du type de fichier | La couche documentaire fournit un accès natif aux documents |
| Manipulation des fichiers | Nécessite des outils ou des bibliothèques documentaires supplémentaires | Intégrée dans la couche de traitement de documents |
| Fidélité de la mise en forme | Dépend de la logique de reconstruction | Gérée par des API documentaires déterministes |
| Gestion de la sortie | La réponse du LLM doit être analysée et convertie en fichier | La couche documentaire effectue la création déterministe du fichier |
| Volume de code | Plus d'orchestration côté application | Instruction en langage naturel + configuration du SDK |
| Maintenance | Invites, analyseurs, mappages et logique de fichiers | Une plus grande partie du comportement du flux de travail peut être exprimée dans les instructions |
| Traitement multi-format | Exige un support spécifique au format | Flux de travail unifié de traitement de documents |
| Précision sémantique | Dépend du modèle et de l'invite | Dépend toujours du modèle et de l'instruction |
| Validation des fichiers | Responsabilité de l'application | Le SDK rapporte le succès ou l'échec du traitement |
| Intégration .NET | SDK .NET ou intégration HTTP, plus bibliothèques de traitement de documents selon les besoins | SDK C# natif avec traitement de documents |
| Idéal pour | Tâches d'IA centrées sur le texte | Flux de travail documentaires pilotés par l'IA |
4. Quand utiliser chaque approche
La comparaison ne signifie pas que « l'agent est toujours meilleur ». Les API LLM brutes et les agents IA documentaires servent des intentions différentes, et le choix du bon outil dépend de ce que le flux de travail produit.
Utilisez une API LLM brute lorsque
- La sortie est du texte, pas un fichier. Le résumé, la réponse aux questions, la classification et la rédaction sont des tâches texte-entrée, texte-sortie. Aucune couche documentaire n'est nécessaire.
- Vous disposez déjà d'une pile LLM. Si votre équipe a investi dans l'ingénierie d'invites, le RAG et l'infrastructure d'orchestration, l'ajout d'un SDK documentaire peut être inutile pour des flux de travail uniquement textuels.
-
L'entrée est du texte brut ou du Markdown. Si le matériau source est déjà du texte — pas du
.pdfou du.xlsx— le problème d'extraction disparaît, et un appel LLM brut est le chemin le plus simple.
Utilisez un agent IA documentaire lorsque
-
La sortie doit être un véritable fichier Office ou PDF. Si le livrable est un classeur
.xlsxpour la comptabilité, un rapport.docxpour la direction ou un.pdfpour la distribution, une couche de traitement de documents devient importante lorsque le flux de travail doit produire de manière fiable un fichier Office valide et formaté. - L'entrée couvre plusieurs formats. Des PDF, des documents Word, des fichiers Excel et des images numérisées arrivent dans le même flux de travail. Un LLM brut a besoin d'une bibliothèque d'extraction distincte pour chaque format ; un agent les gère tous en une seule instruction.
- La mise en forme importe. En-têtes de colonnes, formats de nombres, remplissages conditionnels, styles de tableaux, polices — si l'équipe métier se soucie de l'apparence du fichier, c'est la couche documentaire qui la préserve.
- Vous êtes dans .NET. Un SDK C# natif qui combine l'orchestration IA avec le traitement de documents peut réduire la quantité d'intégration côté application par rapport à la combinaison d'un SDK LLM avec des bibliothèques de traitement de documents séparées.
- Le flux de travail change souvent. Nouveaux fournisseurs, nouvelles maquettes de rapports, nouvelles règles de validation — lorsque le goulot d'étranglement est le recodage à chaque changement, modifier une instruction est plus rapide et moins coûteux.
Résumé de la décision
| Question | API LLM brute | Agent IA documentaire |
|---|---|---|
| La sortie est-elle un vrai fichier (Excel, Word, PDF) ? | Nécessite des outils supplémentaires | Oui |
| La mise en forme doit-elle être préservée ? | Dépend de votre pipeline de reconstruction | Gérée par la couche documentaire |
| Les entrées sont-elles dans plusieurs formats Office ? | Nécessite une extraction spécifique au format | Oui |
| Est-ce une tâche uniquement textuelle (résumé, Q&R) ? | Oui | Possible, mais inutile |
| Avez-vous besoin d'une manipulation documentaire native dans .NET ? | Nécessite une bibliothèque documentaire supplémentaire | Intégrée au flux de travail |
| Les règles du flux de travail changeront-elles fréquemment ? | Les invites et les analyseurs doivent être réajustés | Modifiez le comportement en éditant l'instruction |
5. Un exemple minimal en C#
La différence est plus claire dans le code. Voici la même tâche — extraire des données d'une facture PDF et produire un rapport Excel formaté — implémentée des deux manières.
Approche avec une API LLM brute
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
Pipeline illustratif : les appels API et de bibliothèque documentaire sont simplifiés pour se concentrer sur l'architecture plutôt que sur un SDK spécifique d'un fournisseur.
Approche avec un agent IA documentaire
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
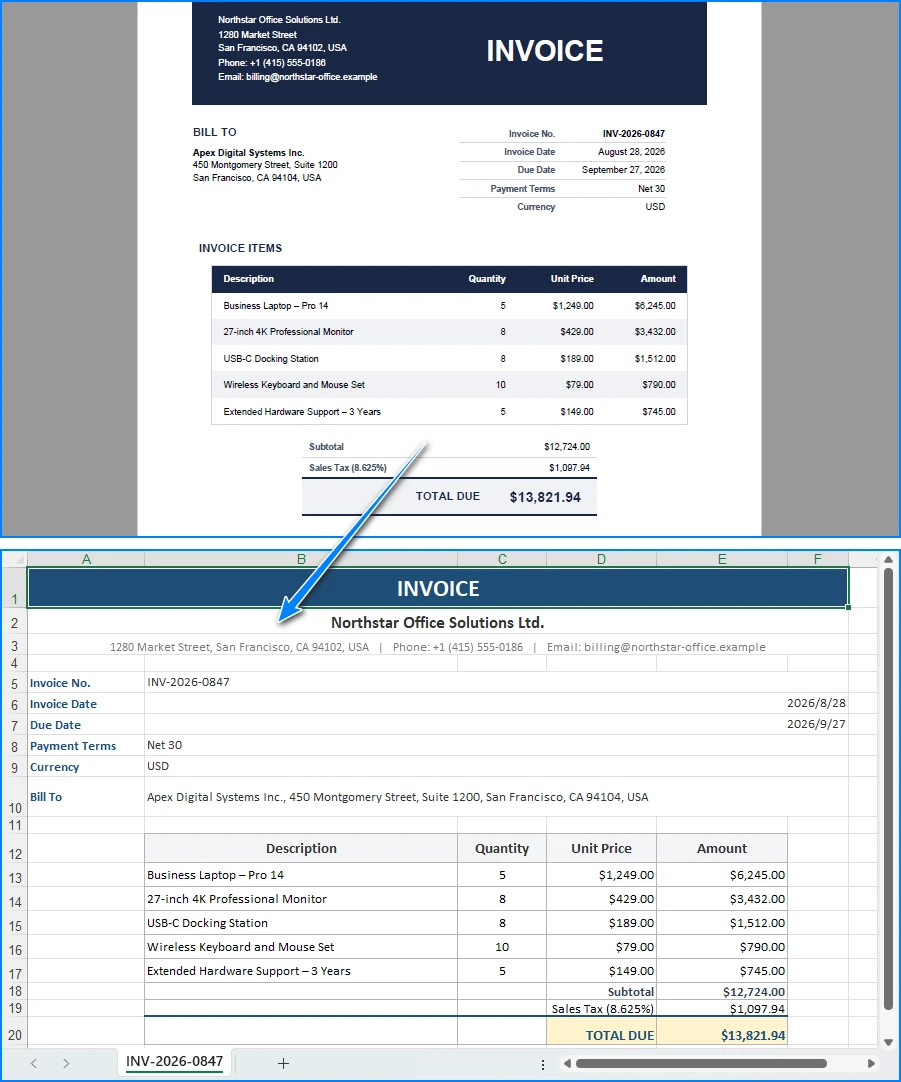
L'agent lit la facture PDF et produit un rapport Excel formaté :
Appels API clés
-
Workbook.AI(agentOptions)— attache le processeur de documents IA à un objet classeur -
ExecuteInstruction(doc, instruction, savePath, attachments)— exécute l'instruction et écrit le fichier de sortie -
AIResult.Success/AIResult.ErrorMessage— vérifie le résultat et fait remonter les erreurs
L'approche avec LLM brut représente quatre problèmes distincts (extraction, invites, analyse, écriture de fichiers) reliés entre eux. L'approche agent est une seule instruction et une seule vérification du résultat. Les deux approches peuvent finalement produire un fichier .xlsx, mais l'approche avec LLM brut vous oblige à construire et à maintenir vous-même la couche de génération de documents. L'agent intègre cette couche de traitement de documents dans le flux de travail, de sorte que le LLM se concentre sur l'interprétation de l'instruction pendant que le SDK gère les opérations documentaires.
Vous aimerez peut-être aussi : Automatiser le traitement des factures avec un agent IA dans .NET — un flux de travail complet d'extraction, de validation et de génération de rapports.
6. Pourquoi Spire.Agent.Office pour les équipes .NET
La comparaison ci-dessus est délibérément neutre vis-à-vis des produits ; la même architecture (LLM + couche documentaire) fonctionne avec n'importe quel modèle compétent et n'importe quel SDK documentaire. Là où Spire.Agent.Office gagne sa place auprès des équipes .NET, c'est dans trois domaines spécifiques :
-
Traitement natif multi-format. Les PDF, les documents Word, les fichiers Excel et les flux de travail documentaires basés sur des images peuvent être intégrés dans le flux de travail de l'agent. L'agent lit, extrait et génère dans tous ces formats en une seule instruction — pas de bibliothèque d'extraction par format, pas de formateur de sortie par format.
-
La mise en forme des documents peut être préservée grâce à des opérations documentaires déterministes. La couche documentaire garde intacts les en-têtes de colonnes, les formats de nombres, les remplissages conditionnels, les styles de tableaux et les polices. Lorsque vous travaillez à partir d'un modèle existant, demandez explicitement à l'agent de préserver la mise en page et le style d'origine, et la sortie restera fidèle au modèle sans code supplémentaire.
-
Intégration .NET native. C'est un SDK C# qui s'intègre directement dans une application .NET existante. Pas de service de traitement de documents séparé à construire ou à maintenir, pas de connectique interservice, pas de couche d'orchestration HTTP. L'exemple ci-dessus capture la surface d'intégration essentielle : configuration du SDK, une instruction et une vérification du résultat.
Si vous utilisez déjà Spire.Office pour le traitement de documents, l'agent est la couche naturelle suivante : le même objet Workbook gagne un processeur AI() qui transforme les instructions en flux de travail exécutés. Le SDK déterministe que vous connaissez déjà devient la couche documentaire appelée par l'agent.
7. FAQ
Ne puis-je pas simplement envoyer le PDF directement à l'API LLM ?
Vous le pouvez. Les API LLM modernes peuvent accepter directement certains types de documents, y compris les PDF. La distinction importante est que l'entrée d'un fichier donne au modèle accès au contenu du document ; elle ne donne pas automatiquement à votre application une API déterministe pour modifier la structure Office d'origine et enregistrer un fichier de sortie prêt pour la production. Par exemple, un modèle peut identifier correctement les tableaux de factures dans un PDF, mais transformer cette compréhension en un .xlsx formaté nécessite toujours une logique de génération de documents.
Qu'est-ce qu'une « couche documentaire » exactement ?
Une couche documentaire est un SDK déterministe qui lit et écrit des fichiers Office et PDF en travaillant avec leurs structures documentaires natives. Elle gère les opérations qu'un LLM ne peut pas effectuer : ouvrir un .xlsx et préserver ses feuilles et formules, écrire un .docx avec des styles et des en-têtes corrects, fusionner des cellules, appliquer une mise en forme conditionnelle et créer une sortie Office/PDF structurellement valide grâce à des API documentaires déterministes. Dans Spire.Agent.Office, la couche documentaire est le SDK Spire.Office ; le LLM décide quoi faire, et la couche documentaire l'exécute.
Est-ce simplement du RAG avec des étapes supplémentaires ?
Non. Le RAG (génération augmentée par récupération) se concentre principalement sur la récupération d'informations pertinentes pour ancrer les réponses du modèle. Un agent IA documentaire ajoute une autre responsabilité : exécuter des opérations documentaires et produire ou modifier de véritables fichiers. Un agent documentaire lit et écrit de vrais fichiers, préserve la mise en forme et produit une sortie structurée qui est un document Office valide, et non une réponse textuelle.
Quels modèles d'IA Spire.Agent.Office prend-il en charge ?
Spire.Agent.Office se connecte à un grand modèle de langage derrière une clé SpireToken et prend en charge les API de modèles hébergés ainsi que les points de terminaison de modèles personnalisés. Pour toute question sur les fournisseurs et les protocoles de modèles pris en charge dans votre déploiement, contactez le service commercial.
Mes données restent-elles dans mon environnement ?
Le SDK, les modèles et le traitement des documents s'exécutent dans votre application — les fichiers ne sont pas téléchargés vers un service documentaire tiers pour stockage ou conversion. Pour analyser le contenu, l'IA a besoin du texte pertinent, et celui-ci est envoyé au modèle pour traitement. Si le point de terminaison du modèle est déployé dans votre propre réseau et que votre configuration n'envoie pas le contenu documentaire à l'extérieur, le contenu documentaire peut rester dans votre infrastructure. Si vous vous connectez via une API de modèle hébergée telle qu'OpenAI ou Azure OpenAI, le contenu pertinent est transmis à ce fournisseur conformément à votre configuration.
Quand une API LLM brute est-elle le bon choix ?
Pour les tâches uniquement textuelles où aucune sortie de fichier n'est nécessaire : résumer un document, répondre à des questions sur son contenu, le classer dans une catégorie ou rédiger une réponse par e-mail. Si l'entrée est déjà du texte brut et que la sortie est du texte brut, une couche documentaire ajoute de la complexité sans apporter de valeur. L'agent gagne sa place lorsque le flux de travail produit de véritables fichiers qui doivent être valides et formatés.
Prêt à ajouter une couche documentaire à vos flux de travail LLM ?
Si votre application traite des factures, des contrats, des rapports ou tout flux de travail de documents Office, un agent IA documentaire transforme une instruction en langage naturel en un fichier réel et formaté — sans construire de pipeline d'extraction et de reconstruction. Suivez le tutoriel Démarrage rapide pour exécuter votre premier flux de travail dans .NET.
Pour aller plus loin
- Générer des documents Word à partir de données Excel en C# — génération de documents pilotée par les données avec le SDK déterministe
- Créer un assistant de rapports Excel propulsé par l'IA en C# — génération et analyse automatisées de rapports
- Présentation du produit Spire.Agent.Office — SDK d'agents IA pour chaque format de document Office