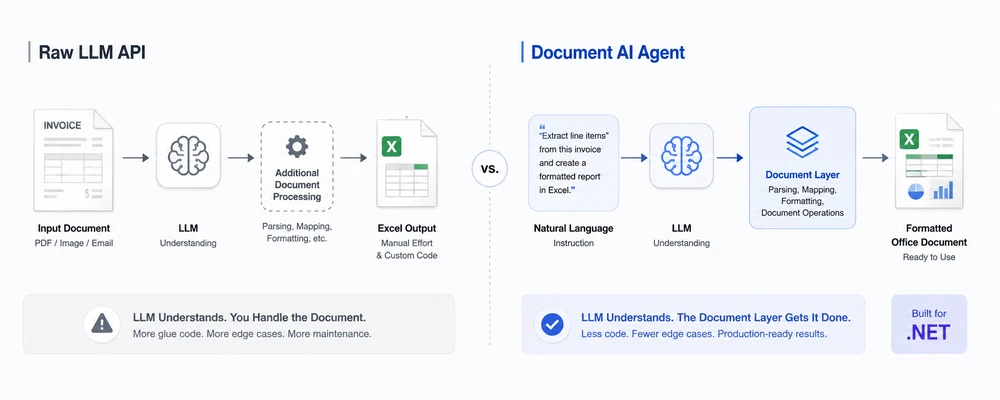
Un usuario sube un PDF de factura y pregunta:
"Extrae las líneas de la factura, calcula el total y crea un informe de Excel con formato."
Un LLM moderno puede entender la factura e identificar la información que necesitas. Pero eso es solo la mitad del problema. Tu aplicación todavía tiene que convertir esa comprensión en un archivo .xlsx real y con formato, con la estructura de documento requerida.
Esta es la brecha entre entender un documento y operar sobre un documento. Una API de LLM directa proporciona capacidades de lenguaje y razonamiento, pero no ofrece por sí misma un flujo de trabajo completo de manipulación de documentos de Office. Un agente de IA de documentos conecta el LLM con un SDK determinista de procesamiento de documentos, de modo que el LLM determina qué debe ocurrir y la capa de documentos ejecuta las operaciones de archivo.
Navegación rápida
- El problema: las API de LLM directas y los archivos de documentos
- Qué aporta un agente de IA de documentos
- Comparación lado a lado
- Cuándo usar cada enfoque
- Un ejemplo mínimo en C#
- Por qué Spire.Agent.Office para equipos de .NET
- Preguntas frecuentes
1. El problema: las API de LLM directas y los archivos de documentos
Llamar directamente a gpt-4 o claude para "procesar este documento" falla de tres maneras que importan en producción. Estas preocupaciones se vuelven importantes en cuanto un flujo de trabajo documental va más allá de la extracción de texto simple y requiere una manipulación de archivos fiable, validación y formato.
1.1 Los LLM no pueden leer ni escribir archivos de Office de forma fiable
Los modelos de lenguaje de gran tamaño pueden comprender el contenido de un documento cuando el modelo y la API admiten el archivo correspondiente o una entrada multimodal, pero eso no proporciona una manipulación determinista de documentos. Un modelo puede ser capaz de analizar el texto, las tablas o el contenido visual de un PDF, pero eso no significa que pueda modificar de forma determinista un libro de trabajo, conservar cada propiedad específica de Office y guardar el resultado como un archivo .xlsx listo para producción a través de la propia API del LLM. Cuando un archivo de Office se proporciona a una API de LLM directa, el modelo puede recibir contenido extraído o transformado en lugar de un objeto de libro de trabajo nativo y editable. Incluso cuando el modelo puede comprender el contenido del libro de trabajo, la API no proporciona por sí misma operaciones deterministas para conservar y modificar la estructura nativa del libro (hojas, rangos con nombre, fórmulas, formato condicional, celdas combinadas, formatos de número).
El análisis de documentos mediante una API de LLM directa puede extraer información semántica útil, pero el análisis semántico es diferente de conservar y manipular la estructura nativa del documento.
Escribir el archivo es el mismo problema a la inversa. Una API de LLM directa no ofrece, por sí misma, una capa determinista de manipulación de documentos de Office. Un LLM puede describir lo que debería contener un informe, pero producir un archivo .docx o .xlsx válido requiere herramientas adicionales. Para generar una salida real de Office a partir de una API de LLM directa, tienes que construir un pipeline de reconstrucción: analizar la respuesta de texto del modelo, asignar campos a celdas o párrafos, aplicar formato y escribir el archivo tú mismo. Ese pipeline no es trivial, y es la parte que falla en producción.
1.2 El formato no está garantizado
Los flujos de trabajo documentales llevan un formato que importa: encabezados de columnas en un informe de factura, formatos de número en una hoja de cálculo financiera, rellenos condicionales que marcan discrepancias, estilos de tabla en un informe gerencial. Una API de LLM directa devuelve contenido generado por el modelo, como texto, JSON o llamadas a herramientas; no proporciona de forma inherente un documento de Office con formato como salida. El formato puede ser difícil de conservar cuando la respuesta del modelo debe reconstruirse en un archivo de Office: una hoja de Excel sin formatos de número es una hoja que alguien tiene que corregir a mano antes de que pueda ir a contabilidad.
Incluso cuando el LLM produce salida estructurada (JSON, tablas Markdown), la salida estructurada no es una salida de documento estructurado. JSON te da datos estructurados, no un documento de Office estructurado. Una respuesta JSON puede describir celdas, párrafos, tablas o instrucciones de formato, pero se sigue necesitando una capa adicional de procesamiento de documentos para aplicar esas instrucciones a un archivo .xlsx, .docx, .pptx o .pdf real. Ahora estás manteniendo un formateador, un mapeador de campos y un aplicador de estilos, y en nada de eso te ayuda el LLM.
1.3 Reimplementas toda la orquestación
Un pipeline de documentos con una API de LLM directa no es una sola llamada a la API. Es una pila:
- Diseño de indicaciones (prompts) — plantillas de indicaciones que se rompen cuando cambia el diseño del documento
- Extracción — pueden ser necesarias herramientas adicionales de procesamiento de documentos para extraer contenido estructurado de archivos PDF, Word y Excel antes de que el LLM lo vea
- Análisis sintáctico — lógica de análisis de JSON para convertir la respuesta del LLM en datos estructurados
- Lógica de reintentos — manejo de salidas alucinadas, límites de velocidad y rechazos del filtro de contenido
- E/S de archivos — leer entradas, escribir salidas, gestionar archivos temporales
- Validación de salida — comprobar que el archivo producido es válido y está bien formado antes de devolverlo al usuario
En ese punto, estás creando una solución de procesamiento de documentos, con un LLM como un componente, no como la solución en sí. Cada nuevo tipo de documento, cambio de esquema o formato de salida significa reajustar las indicaciones y volver a probar peculiaridades específicas del modelo. La carga de mantenimiento crece linealmente con el número de tipos de documento que soportas.
2. Qué aporta un agente de IA de documentos
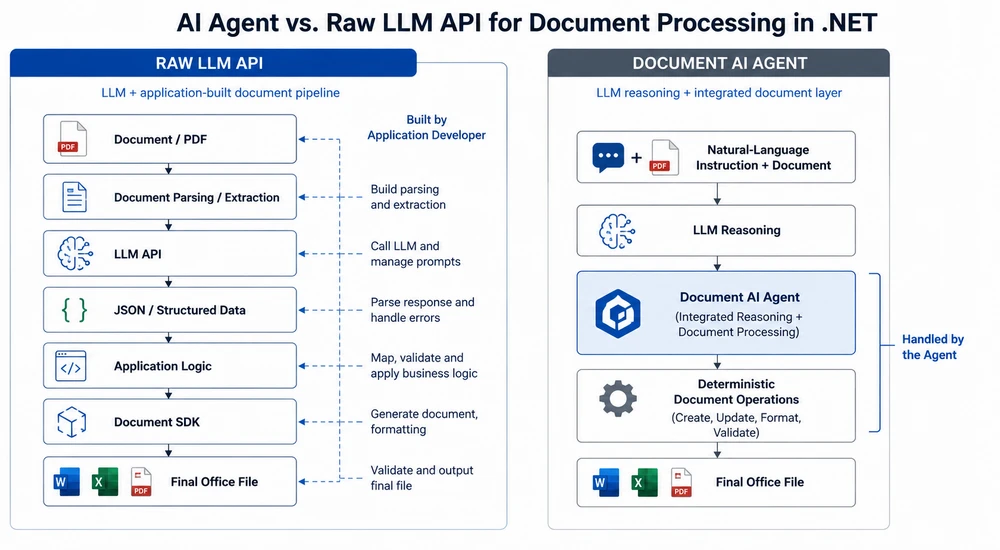
Un agente de IA de documentos resuelve los tres problemas anteriores al combinar el LLM con una capa determinista de procesamiento de documentos. La división del trabajo es clara:
- El LLM se encarga de la comprensión. Lee la instrucción en lenguaje natural, decide qué extraer o generar y determina la estructura de la salida.
- La capa de documentos se encarga de la ejecución. Lee y escribe archivos reales de Office y PDF, conserva el formato, aplica estilos y utiliza operaciones deterministas de documentos para producir un archivo estructuralmente válido.
En lugar de pedirle al LLM que "deduzca" la estructura del documento, el agente invoca operaciones deterministas de documentos. El modelo no necesita construir por sí mismo el formato de archivo de Office; produce la intención, y la capa de documentos realiza las operaciones de archivo correspondientes.
Las dos arquitecturas lado a lado:
Así se ve en la práctica
| Problema con una API de LLM directa | Cómo lo resuelve el agente |
|---|---|
Sin manipulación nativa de .xlsx
|
La capa de documentos lee y manipula el libro de trabajo de forma nativa |
| Sin generación determinista de archivos de Office | La capa de documentos crea el archivo de salida |
| El formato puede perderse durante la reconstrucción | La capa de documentos gestiona estilos y formatos de número |
| La estructura generada por el modelo puede ser inconsistente | Las operaciones de documentos son deterministas |
| Tú construyes todo el pipeline circundante | El SDK del agente proporciona el flujo de trabajo de procesamiento de documentos |
La idea clave: el LLM es el cerebro, la capa de documentos es las manos. Una API de LLM directa te da el cerebro y espera que construyas las manos. Un agente de IA de documentos te ofrece ambos, integrados, en una sola llamada al SDK.
Un SDK de documentos por sí solo puede manipular archivos, pero no entiende la intención en lenguaje natural. Un agente de IA combina esa capa determinista de documentos con un LLM para que los usuarios puedan describir el flujo de trabajo deseado en lugar de implementar manualmente cada operación de documento. El valor no es "SDK de documentos + IA", sino el pipeline: instrucción en lenguaje natural → razonamiento del LLM → operaciones deterministas de documentos.
Lectura recomendada: Agente de IA para procesamiento de documentos: qué es y cómo funciona — el concepto del agente de IA de documentos explicado.
3. Comparación lado a lado
| Dimensión | API de LLM directa | Agente de IA de documentos |
|---|---|---|
| Comprensión de archivos | Depende del modelo/API y del tipo de archivo | La capa de documentos proporciona acceso nativo al documento |
| Manipulación de archivos | Requiere herramientas o bibliotecas de documentos adicionales | Integrada en la capa de procesamiento de documentos |
| Fidelidad del formato | Depende de la lógica de reconstrucción | Gestionada por API deterministas de documentos |
| Manejo de la salida | La respuesta del LLM debe analizarse y convertirse en un archivo | La capa de documentos realiza la creación determinista de archivos |
| Volumen de código | Más orquestación en el lado de la aplicación | Instrucción en lenguaje natural + configuración del SDK |
| Mantenimiento | Indicaciones, analizadores, asignaciones y lógica de archivos | Más comportamiento del flujo de trabajo se puede expresar en instrucciones |
| Procesamiento multi-formato | Requiere soporte específico por formato | Flujo de procesamiento de documentos unificado |
| Precisión semántica | Depende del modelo y de la indicación | Sigue dependiendo del modelo y de la instrucción |
| Validación de archivos | Responsabilidad de la aplicación | El SDK informa del éxito o del fracaso del procesamiento |
| Integración con .NET | SDK de .NET o integración HTTP, más bibliotecas de procesamiento de documentos según sea necesario | SDK nativo de C# con procesamiento de documentos |
| Ideal para | Tareas de IA centradas en texto | Flujos de trabajo documentales impulsados por IA |
4. Cuándo usar cada enfoque
La comparación no significa que "el agente siempre es mejor". Las API de LLM directas y los agentes de IA de documentos sirven para intenciones diferentes, y elegir la herramienta adecuada depende de lo que produce el flujo de trabajo.
Usa una API de LLM directa cuando:
- La salida es texto, no un archivo. Resumir, responder preguntas, clasificar y redactar son tareas de texto de entrada y texto de salida. No se necesita ninguna capa de documentos.
- Ya tienes una pila de LLM. Si tu equipo ha invertido en ingeniería de indicaciones, RAG e infraestructura de orquestación, añadir un SDK de documentos puede ser innecesario para flujos de trabajo solo de texto.
-
La entrada es texto plano o Markdown. Si el material de origen ya es texto (no
.pdfni.xlsx), el problema de extracción desaparece y una llamada directa a una API de LLM es el camino más sencillo.
Usa un agente de IA de documentos cuando:
-
La salida debe ser un archivo real de Office o PDF. Si el entregable es un libro de
.xlsxpara contabilidad, un informe.docxpara la dirección o un.pdfpara distribución, una capa de procesamiento de documentos adquiere importancia cuando el flujo debe producir de forma fiable un archivo de Office válido y con formato. - La entrada abarca múltiples formatos. PDF, documentos de Word, archivos de Excel e imágenes escaneadas llegan en el mismo flujo de trabajo. Una API de LLM directa necesita una biblioteca de extracción separada por formato; un agente los maneja todos con una sola instrucción.
- El formato importa. Encabezados de columna, formatos de número, rellenos condicionales, estilos de tabla, fuentes: si al equipo de negocio le importa cómo se ve el archivo, la capa de documentos es lo que lo conserva.
- Estás en .NET. Un SDK nativo de C# que combina orquestación de IA con procesamiento de documentos puede reducir la cantidad de integración en la aplicación en comparación con combinar un SDK de LLM con bibliotecas separadas de procesamiento de documentos.
- El flujo de trabajo cambia a menudo. Nuevos proveedores, nuevos diseños de informes, nuevas reglas de validación: cuando el cuello de botella es volver a codificar en cada cambio, editar una instrucción es más rápido y más económico.
Resumen de decisión
| Pregunta | API de LLM directa | Agente de IA de documentos |
|---|---|---|
| ¿La salida es un archivo real (Excel, Word, PDF)? | Requiere herramientas adicionales | Sí |
| ¿El formato debe conservarse? | Depende de tu pipeline de reconstrucción | Lo gestiona la capa de documentos |
| ¿Las entradas están en múltiples formatos de Office? | Requiere extracción específica por formato | Sí |
| ¿Es una tarea solo de texto (resumir, preguntas y respuestas)? | Sí | Posible, pero innecesario |
| ¿Necesitas manipulación nativa de documentos en .NET? | Requiere una biblioteca de documentos adicional | Integrado en el flujo de trabajo |
| ¿Las reglas del flujo de trabajo cambiarán con frecuencia? | Las indicaciones y los analizadores necesitan reajustes | Cambia el comportamiento editando la instrucción |
5. Un ejemplo mínimo en C#
La diferencia se ve más claramente en el código. A continuación se muestra la misma tarea (extraer datos de una factura en PDF y producir un informe de Excel con formato) implementada de las dos maneras.
Enfoque con API de LLM directa
// Simplified raw LLM pipeline — illustrative architecture, not production code.

// 1. Obtain document content using a document-processing tool
//    (This example uses extracted text to illustrate one common raw-LLM architecture;
//    some modern LLM APIs can also accept PDFs directly.)
string documentText = ExtractTextFromPdf(@"C:\invoices\supplier-a.pdf");

// 2. Send the extracted content to the LLM
string json = await CallLlmAsync(
    "Extract vendor, invoice date, line items, and total as JSON.",
    documentText);

// 3. Deserialize and validate the model response
InvoiceData data = JsonSerializer.Deserialize<InvoiceData>(json)
    ?? throw new InvalidOperationException("Invalid LLM response.");

// 4. Create the Excel file using a document library
using var workbook = new Workbook();
var sheet = workbook.AddWorksheet("Invoice");

// ... map data to cells and apply formatting
workbook.SaveToFile(@"C:\output\report.xlsx");
Pipeline ilustrativo: las llamadas a la API y a la biblioteca de documentos están simplificadas para centrarse en la arquitectura en lugar de en un SDK de un proveedor específico.
Enfoque con agente de IA de documentos
// Document AI agent: one instruction, real file output
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Xls;

string? spireToken = Environment.GetEnvironmentVariable("SPIRE_TOKEN");
if (string.IsNullOrEmpty(spireToken))
    throw new InvalidOperationException("SPIRE_TOKEN is not set.");

AIOptions agentOptions = new AIOptions();
agentOptions.WorkDir = @"C:\output";
agentOptions.SpireToken = spireToken;

string instruction =
    "Read the attached invoice PDF, extract vendor name, invoice date, " +
    "line items (description, quantity, unit price, amount), and total. " +
    "Create a workbook with formatted headers, number formats for currency " +
    "columns, and a summary row. Save as a .xlsx file.";

string[] attachments = { @"C:\invoices\supplier-a.pdf" };

using (Workbook wb = new Workbook())
{
    AIResult result = wb.AI(agentOptions).ExecuteInstruction(
        wb,
        instruction,
        @"C:\output\report.xlsx",
        attachments);

    if (result == null || !result.Success)
        throw new InvalidOperationException(
            $"Processing failed: {result?.ErrorMessage}");
}
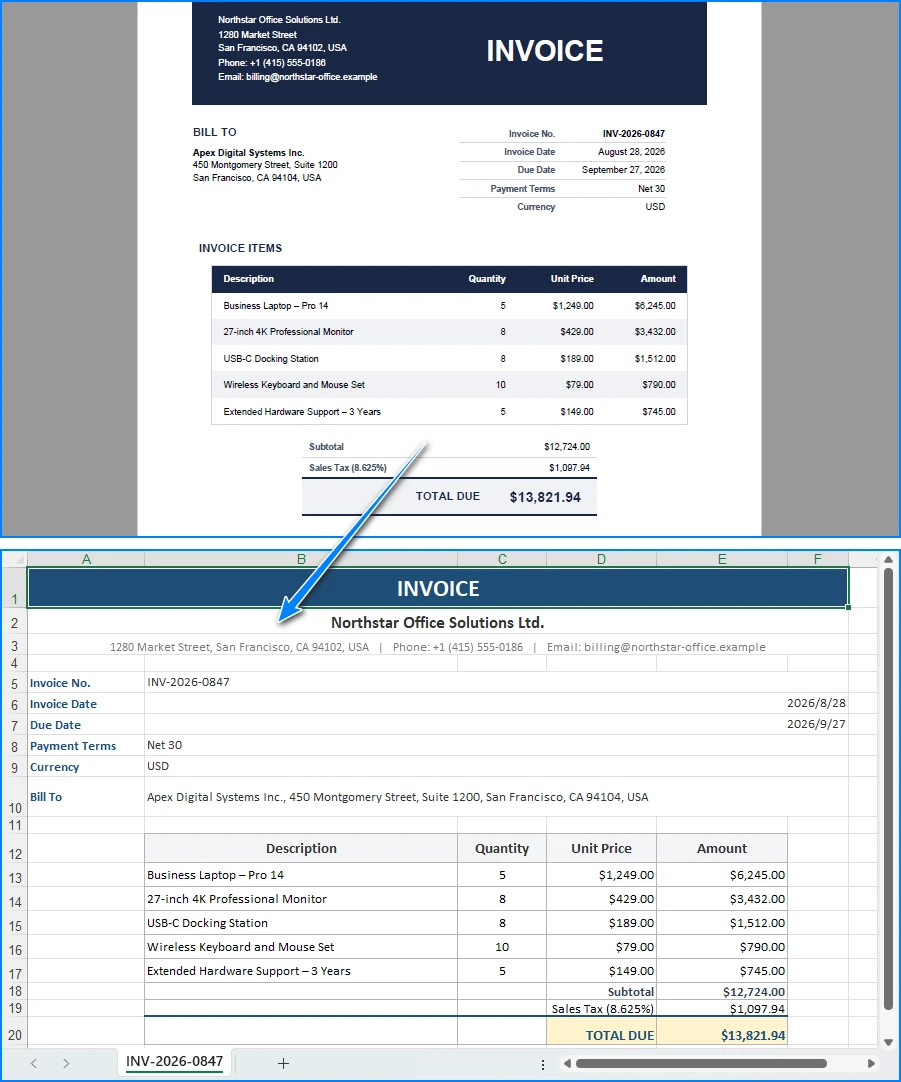
El agente lee la factura en PDF y produce un informe de Excel con formato:
Llamadas clave de la API
-
Workbook.AI(agentOptions)— adjunta el procesador de documentos de IA a un objeto de libro de trabajo -
ExecuteInstruction(doc, instruction, savePath, attachments)— ejecuta la instrucción y escribe el archivo de salida -
AIResult.Success/AIResult.ErrorMessage— verifica el resultado y muestra los errores
El enfoque con una API de LLM directa son cuatro problemas separados (extracción, indicaciones, análisis sintáctico y escritura de archivos) unidos. El enfoque con agente es una instrucción y una comprobación del resultado. Ambos enfoques pueden acabar produciendo un archivo .xlsx, pero el enfoque con API de LLM directa requiere que tú mismo construyas y mantengas la capa de generación de documentos. El agente integra esa capa de procesamiento de documentos en el flujo de trabajo, de modo que el LLM se centra en interpretar la instrucción mientras el SDK gestiona las operaciones de documentos.
También te puede interesar: Automatiza el procesamiento de facturas con un agente de IA en .NET — un flujo completo de extracción, validación y generación de informes.
6. Por qué Spire.Agent.Office para equipos de .NET
La comparación anterior es deliberadamente neutra respecto a productos; la misma arquitectura (LLM + capa de documentos) funciona con cualquier modelo capaz y cualquier SDK de documentos. Donde Spire.Agent.Office se gana un lugar para los equipos de .NET es en tres áreas específicas:
-
Procesamiento nativo multi-formato. Los PDF, documentos de Word, archivos de Excel y flujos de trabajo basados en imágenes pueden incorporarse al flujo de trabajo del agente. El agente lee, extrae y genera en todos estos formatos con una sola instrucción: sin biblioteca de extracción por formato, sin formateador de salida por formato.
-
El formato de los documentos se puede conservar mediante operaciones deterministas de documentos. La capa de documentos mantiene intactos los encabezados de columna, formatos de número, rellenos condicionales, estilos de tabla y fuentes. Cuando se trabaja a partir de una plantilla existente, indícale explícitamente al agente que conserve el diseño y el estilo originales, y la salida será fiel a la plantilla sin código adicional.
-
Integración nativa con .NET. Es un SDK de C# que se integra directamente en una aplicación .NET existente. No hay que crear ni mantener un servicio separado de procesamiento de documentos, ni conexiones entre servicios, ni capa de orquestación HTTP. El ejemplo anterior muestra la superficie de integración principal: configuración del SDK, una instrucción y una comprobación del resultado.
Si ya usas Spire.Office para el procesamiento de documentos, el agente es la siguiente capa natural: el mismo objeto Workbook gana un procesador AI() que convierte instrucciones en flujos de trabajo ejecutados. El SDK determinista que ya conoces se convierte en la capa de documentos a la que llama el agente.
7. Preguntas frecuentes
¿No puedo simplemente enviar el PDF directamente a la API del LLM?
Sí puedes. Las API de LLM modernas pueden aceptar directamente algunos tipos de documentos, incluidos los PDF. La distinción importante es que la entrada de archivos da al modelo acceso al contenido del documento; no le da automáticamente a tu aplicación una API determinista para modificar la estructura original de Office y guardar un archivo de salida listo para producción. Por ejemplo, un modelo puede identificar correctamente las tablas de una factura en un PDF, pero convertir esa comprensión en un .xlsx con formato sigue requiriendo lógica de generación de documentos.
¿Qué es exactamente una "capa de documentos"?
Una capa de documentos es un SDK determinista que lee y escribe archivos de Office y PDF trabajando con sus estructuras nativas de documento. Gestiona las operaciones que un LLM no puede hacer: abrir un .xlsx y conservar sus hojas y fórmulas, escribir un .docx con estilos y encabezados correctos, combinar celdas, aplicar formato condicional y crear una salida de Office/PDF estructuralmente válida mediante API deterministas de documentos. En Spire.Agent.Office, la capa de documentos es el SDK de Spire.Office; el LLM decide qué hacer y la capa de documentos lo hace.
¿Esto es solo RAG con pasos adicionales?
No. El RAG (generación aumentada por recuperación) se centra principalmente en recuperar información relevante para fundamentar las respuestas del modelo. Un agente de IA de documentos añade otra responsabilidad: ejecutar operaciones de documentos y producir o modificar archivos reales. Un agente de documentos lee y escribe archivos reales, conserva el formato y produce una salida estructurada que es un documento de Office válido, no una respuesta de texto.
¿Qué modelos de IA soporta Spire.Agent.Office?
Spire.Agent.Office se conecta a un modelo de lenguaje de gran tamaño mediante una clave SpireToken y admite API de modelos alojados, así como endpoints de modelos personalizados. Para preguntas sobre qué proveedores y protocolos de modelos se admiten en tu implementación, contacta con ventas.
¿Mis datos permanecen dentro de mi entorno?
El SDK, las plantillas y el procesamiento de documentos se ejecutan dentro de tu aplicación: los archivos no se cargan a un servicio de documentos de terceros para su almacenamiento o conversión. Para analizar el contenido, la IA necesita el texto relevante, y ese texto se envía al modelo para su procesamiento. Si el endpoint del modelo está implementado dentro de tu propia red y tu configuración no envía contenido de documentos al exterior, el contenido de los documentos puede permanecer dentro de tu infraestructura. Si te conectas a través de una API de modelo alojado como OpenAI o Azure OpenAI, el contenido relevante se transmite a ese proveedor según tu configuración.
¿Cuándo es una API de LLM directa la opción correcta?
Para tareas solo de texto en las que no se necesita salida de archivos: resumir un documento, responder preguntas sobre su contenido, clasificarlo en una categoría o redactar una respuesta de correo electrónico. Si la entrada ya es texto plano y la salida es texto plano, una capa de documentos añade complejidad sin valor. El agente se gana su lugar cuando el flujo de trabajo produce archivos reales que deben ser válidos y tener formato.
¿Listo para añadir una capa de documentos a tus flujos de trabajo con LLM?
Si tu aplicación procesa facturas, contratos, informes o cualquier flujo de trabajo con documentos de Office, un agente de IA de documentos convierte una sola instrucción en lenguaje natural en un archivo real y con formato, sin necesidad de crear un pipeline de extracción y reconstrucción. Sigue el tutorial de Introducción para ejecutar tu primer flujo de trabajo en .NET.
Lecturas adicionales
- Generar documentos de Word a partir de datos de Excel en C# — generación de documentos basada en datos con el SDK determinista
- Crea un asistente de informes de Excel con IA en C# — generación y análisis automatizados de informes
- Descripción general del producto Spire.Agent.Office — SDK de agentes de IA para cada formato de documento de Office