Come convertire una tabella in testo in Word: guida passo dopo passo
Le tabelle di Word sono utili per organizzare i dati, ma possono diventare scomode quando è necessario modificarne il contenuto come testo normale. Se non hai più bisogno della struttura della tabella, puoi convertire una tabella in testo utilizzando lo strumento integrato di Word o automatizzare il processo con Python. Questa guida illustra i passaggi dettagliati per entrambi i metodi, diamo un'occhiata.
- Convertire una tabella in testo in Word con uno strumento integrato
- Convertire tabelle Word in testo con Python
- Esportare i dati della tabella in un file TXT esterno
- Domande frequenti (FAQ)
Convertire una tabella in testo in Word con uno strumento integrato
Microsoft Word fornisce uno strumento integrato per convertire le tabelle in testo. Se devi convertire solo una o due tabelle, lo strumento integrato è solitamente l'opzione più rapida. Rimuove la struttura della tabella e converte il contenuto delle celle in testo normale.
Come trasformare una tabella in testo in MS Word:
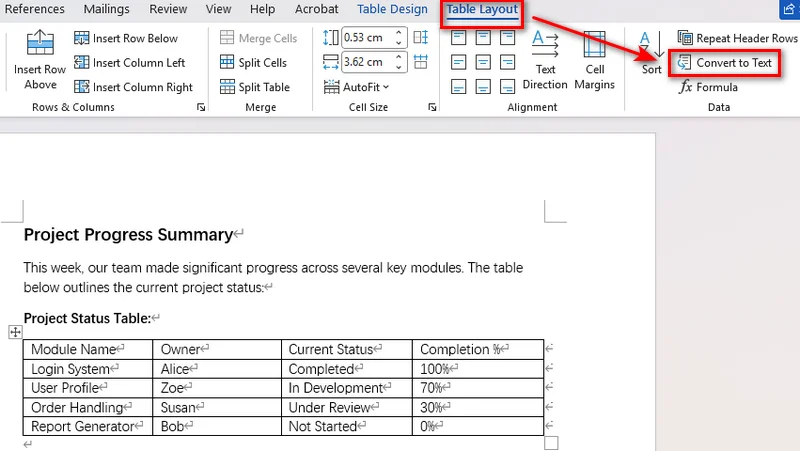
- Passaggio 1: Fai clic in un punto qualsiasi all'interno della tabella per visualizzare la scheda contestuale Layout tabella sulla barra multifunzione in alto.
- Passaggio 2: Vai alla scheda Layout tabella nel menu in alto e fai clic sul pulsante Converti in testo nel gruppo Dati.
- Passaggio 3: Seleziona il delimitatore preferito (tabulazioni, virgole, segni di paragrafo o un carattere personalizzato) per separare i valori delle colonne.
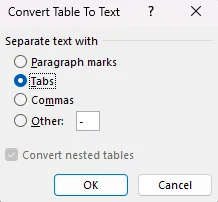
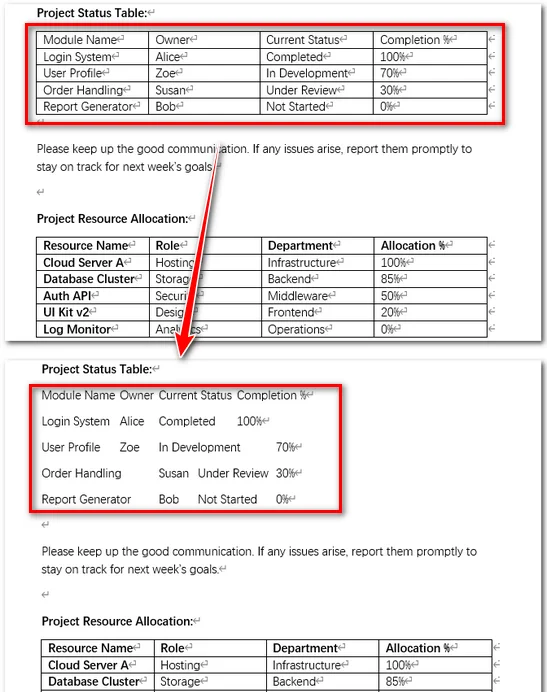
- Passaggio 4: Fai clic su OK per trasformare istantaneamente la tabella in normali paragrafi di testo.
Conversione in testo vs. Nascondere i bordi
Nascondere i bordi della tabella cambia solo l'aspetto della tabella. Le celle, le colonne e la struttura della tabella rimangono al loro posto, quindi il contenuto è ancora vincolato dal layout della tabella.
Convertire la tabella in testo rimuove la struttura della tabella e trasforma il contenuto delle celle in normali paragrafi. È quindi possibile modificare e formattare il contenuto senza il layout della tabella.
Convertire tabelle Word in testo con Python
Lo strumento integrato di Word è comodo per convertire singole tabelle, ma diventa meno pratico quando è necessario elaborare molti documenti o tabelle. Per gli sviluppatori Python, Free Spire.Doc for Python offre un modo per automatizzare la conversione da tabella a testo senza richiedere l'installazione di Microsoft Word.
Convertire una tabella in testo
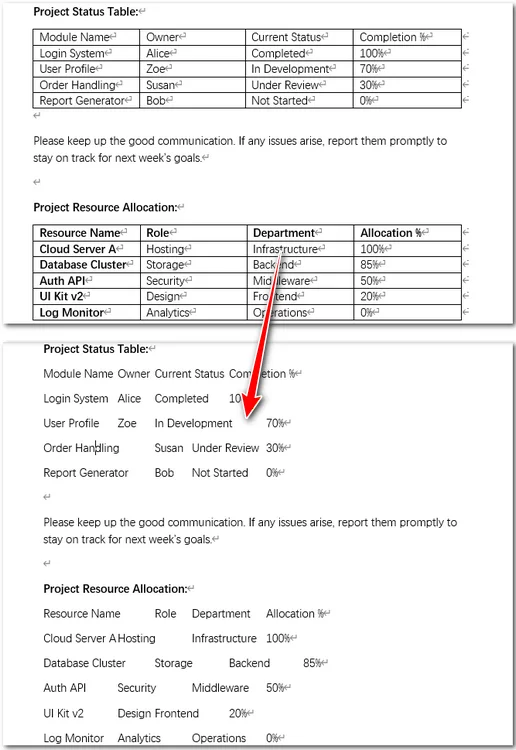
Lo script legge il testo da ogni cella, unisce le celle nella stessa riga con caratteri di tabulazione, inserisce i paragrafi risultanti dove si trovava la tabella e quindi rimuove la tabella originale.
from spire.doc import *
from spire.doc.documents import *

# Inizializza l'istanza del documento e carica il file di destinazione
doc = Document()
doc.LoadFromFile("input.docx")

# Ottieni la prima sezione e la tabella di destinazione
section = doc.Sections[0]
if section.Tables.Count > 0:
    table = section.Tables[0]

    # Estrai il testo dalle celle riga per riga
    text_lines = []
    for j in range(table.Rows.Count):
        row = table.Rows.get_Item(j)
        row_cells_text = []
        for k in range(row.Cells.Count):
            cell = row.Cells.get_Item(k)

            # Estrai il testo dai paragrafi della cella
            cell_text_pieces = []
            for p in range(cell.Paragraphs.Count):
                para_obj = cell.Paragraphs.get_Item(p)
                if para_obj.Text:
                    cell_text_pieces.append(para_obj.Text.strip())

            row_cells_text.append(" ".join(cell_text_pieces))

        # Unisci il testo delle celle usando i separatori di tabulazione
        text_lines.append("\t".join(row_cells_text))

    # Individua la tabella all'interno del suo blocco padre
    owner_block = table.OwnerTextBody
    table_index = owner_block.ChildObjects.IndexOf(table)

    # Inserisci nuovi paragrafi di testo nell'esatta posizione della tabella
    for line in reversed(text_lines):
        temp_para = section.AddParagraph()
        temp_para.Text = line
        section.Paragraphs.Remove(temp_para)
        owner_block.ChildObjects.Insert(table_index, temp_para)

    # Rimuovi completamente la struttura della tabella dalla struttura del documento
    owner_block.ChildObjects.Remove(table)

# Salva il documento aggiornato
doc.SaveToFile("1st table to text.docx", FileFormat.Docx2016)
doc.Close()
Nota: Più paragrafi all'interno della stessa cella vengono combinati in un'unica riga separata da spazi.
Elaborazione in batch di tutte le tabelle
Per convertire tutte le tabelle in un documento in testo, riutilizza la logica di conversione dell'esempio precedente e applicala a ogni tabella in ogni sezione. Poiché ogni tabella viene rimossa dopo la conversione, le tabelle dovrebbero essere elaborate in ordine inverso. In caso contrario, l'eliminazione di una tabella sposta gli indici delle tabelle rimanenti, il che potrebbe causare il salto di tabelle o errori di indice.
from spire.doc import *
from spire.doc.documents import *

# Crea un oggetto Document e carica un file Word
doc = Document()
doc.LoadFromFile("input.docx")

# Itera attraverso ogni sezione nel documento
for s_idx in range(doc.Sections.Count):
    section = doc.Sections[s_idx]

    # Itera all'indietro attraverso le tabelle per evitare problemi di spostamento dell'indice
    table_count = section.Tables.Count
    for t_idx in range(table_count - 1, -1, -1):
        table = section.Tables.get_Item(t_idx)

        # Raccogli il testo da tutte le righe e celle
        text_lines = []
        for j in range(table.Rows.Count):
            row = table.Rows.get_Item(j)
            row_cells_text = []
            for k in range(row.Cells.Count):
                cell = row.Cells.get_Item(k)
                cell_text_pieces = []
                for p in range(cell.Paragraphs.Count):
                    para_obj = cell.Paragraphs.get_Item(p)
                    if para_obj.Text:
                        cell_text_pieces.append(para_obj.Text.strip())
                row_cells_text.append(" ".join(cell_text_pieces))
            text_lines.append("\t".join(row_cells_text))

        # Sostituisci il nodo della tabella con paragrafi semplici sul posto
        owner_block = table.OwnerTextBody
        table_index = owner_block.ChildObjects.IndexOf(table)

        for line in reversed(text_lines):
            temp_para = section.AddParagraph()
            temp_para.Text = line
            section.Paragraphs.Remove(temp_para)
            owner_block.ChildObjects.Insert(table_index, temp_para)

        # Rimuovi in sicurezza la tabella corrente
        owner_block.ChildObjects.Remove(table)

# Salva il file finale
doc.SaveToFile("all tables to text.docx", FileFormat.Docx2016)
doc.Close()
Suggerimento: Esportare i dati della tabella in un file TXT esterno
In molti flussi di lavoro di pipeline di dati, l'obiettivo è ottenere informazioni piuttosto che modificare i file di layout originali. Se hai bisogno solo di testo tabulare per l'inserimento in database, la registrazione o l'archiviazione in testo semplice, è ancora più semplice. Puoi estrarre rapidamente il contenuto grezzo delle celle e scriverlo direttamente in un file di testo esterno con Free Spire.Doc.
Esempio di codice
from spire.doc import *
from spire.doc.common import *

# Crea un'istanza Document
doc = Document()

# Carica un documento Word
doc.LoadFromFile("input.docx")

# Ottieni la prima tabella
table = doc.Sections[0].Tables[0]

# Estrai il testo della tabella
tableData = ''
for j in range(table.Rows.Count):
    row = table.Rows.get_Item(j)

    for k in range(row.Cells.Count):
        cell = row.Cells.get_Item(k)

        for p in range(cell.Paragraphs.Count):
            tableData += cell.Paragraphs.get_Item(p).Text + ' '

        if k < row.Cells.Count - 1:
            tableData += '\t'

    tableData += '\n'

# Salva il testo estratto in un file TXT
with open("/table_text.txt", "w", encoding="utf-8") as f:
    f.write(tableData)

doc.Close()
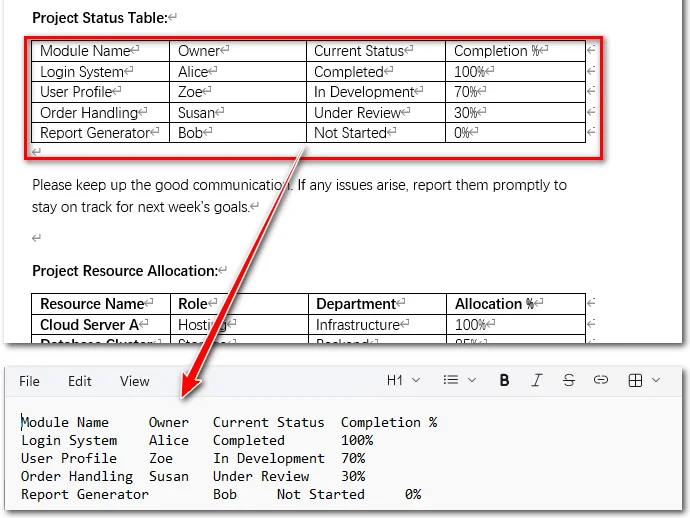
Suggerimento: Per dati tabulari strutturati, puoi anche convertire le tabelle Word in CSV per l'uso in fogli di calcolo, database e altri flussi di lavoro di elaborazione dati.
Domande frequenti (FAQ)
D1: Cosa devo fare se il testo convertito appare disallineato?
L'uso delle tabulazioni (\t) preserva al meglio la spaziatura strutturale. Se l'allineamento delle colonne appare ancora irregolare in Word, seleziona i paragrafi convertiti e regola le Tabulazioni sul righello orizzontale.
D2: Come posso riconvertire il testo in una tabella in Word?
Per invertire il processo, evidenzia il testo, vai su Inserisci > Tabella e fai clic su Converti testo in tabella. Seleziona il delimitatore corrispondente (ad esempio, tabulazioni o virgole) per ricostruire la tabella.
D3: Qual è il tasto di scelta rapida per convertire una tabella in testo in Word?
Microsoft Word non fornisce una scorciatoia da tastiera dedicata per Converti in testo. Puoi accedere al comando tramite la barra multifunzione o personalizzare una scorciatoia tramite le impostazioni della tastiera di Word.
Riepilogo
Questo articolo ha introdotto due modi per convertire le tabelle nei documenti Word in testo. Lo strumento integrato di Word funziona bene per singole tabelle o un numero limitato di documenti, mentre Free Spire.Doc for Python è più adatto all'elaborazione automatizzata di più tabelle. Puoi anche estrarre il contenuto della tabella in un file TXT per l'archiviazione in testo semplice o per un'ulteriore elaborazione.
Leggi anche:
Comment convertir un tableau en texte dans Word : guide étape par étape
Les tableaux Word sont utiles pour organiser les données, mais ils peuvent devenir gênants lorsque vous devez modifier leur contenu sous forme de texte brut. Si vous n'avez plus besoin de la structure du tableau, vous pouvez convertir un tableau en texte en utilisant l'outil intégré de Word ou automatiser le processus avec Python. Ce guide détaille les deux méthodes, découvrons-les.
- Convertir un tableau en texte dans Word avec un outil intégré
- Convertir des tableaux Word en texte avec Python
- Exporter les données d'un tableau vers un fichier TXT externe
- FAQ
Convertir un tableau en texte dans Word avec un outil intégré
Microsoft Word fournit un outil intégré pour convertir les tableaux en texte. Si vous n'avez besoin de convertir qu'un ou deux tableaux, l'outil intégré est généralement l'option la plus rapide. Il supprime la structure du tableau et convertit le contenu des cellules en texte brut.
Comment transformer un tableau en texte dans MS Word :
- Étape 1 : Cliquez n'importe où à l'intérieur du tableau pour faire apparaître l'onglet contextuel Disposition (ou Mise en page) dans le ruban supérieur.
- Étape 2 : Allez dans l'onglet Disposition du menu supérieur et cliquez sur le bouton Convertir en texte dans le groupe Données.
- Étape 3 : Sélectionnez le délimiteur de votre choix (tabulations, virgules, marques de paragraphe ou un caractère personnalisé) pour séparer les valeurs des colonnes.
- Étape 4 : Cliquez sur OK pour transformer instantanément le tableau en paragraphes de texte brut.
Conversion en texte vs Masquage des bordures
Masquer les bordures d'un tableau modifie uniquement l'apparence du tableau. Les cellules, les colonnes et la structure du tableau restent en place, de sorte que le contenu est toujours contraint par la mise en page du tableau.
La conversion du tableau en texte supprime la structure du tableau et transforme le contenu des cellules en paragraphes ordinaires. Vous pouvez ensuite modifier et mettre en forme le contenu sans la contrainte de la mise en page du tableau.
Convertir des tableaux Word en texte avec Python
L'outil intégré de Word est pratique pour convertir des tableaux individuels, mais il devient moins efficace lorsque vous devez traiter de nombreux documents ou tableaux. Pour les développeurs Python, Free Spire.Doc for Python offre un moyen d'automatiser la conversion de tableau en texte sans avoir besoin d'installer Microsoft Word.
Convertir un tableau en texte
Le script lit le texte de chaque cellule, joint les cellules d'une même ligne avec des tabulations, insère les paragraphes résultants là où se trouvait le tableau, puis supprime le tableau d'origine.
from spire.doc import *
from spire.doc.documents import *

# Initialiser l'instance Document et charger le fichier cible
doc = Document()
doc.LoadFromFile("input.docx")

# Obtenir la première section et le tableau cible
section = doc.Sections[0]
if section.Tables.Count > 0:
    table = section.Tables[0]

    # Extraire le texte des cellules ligne par ligne
    text_lines = []
    for j in range(table.Rows.Count):
        row = table.Rows.get_Item(j)
        row_cells_text = []
        for k in range(row.Cells.Count):
            cell = row.Cells.get_Item(k)

            # Extraire le texte des paragraphes de la cellule
            cell_text_pieces = []
            for p in range(cell.Paragraphs.Count):
                para_obj = cell.Paragraphs.get_Item(p)
                if para_obj.Text:
                    cell_text_pieces.append(para_obj.Text.strip())

            row_cells_text.append(" ".join(cell_text_pieces))

        # Joindre le texte des cellules en utilisant des tabulations
        text_lines.append("\t".join(row_cells_text))

    # Localiser le tableau dans son bloc parent
    owner_block = table.OwnerTextBody
    table_index = owner_block.ChildObjects.IndexOf(table)

    # Insérer de nouveaux paragraphes de texte à la position exacte du tableau
    for line in reversed(text_lines):
        temp_para = section.AddParagraph()
        temp_para.Text = line
        section.Paragraphs.Remove(temp_para)
        owner_block.ChildObjects.Insert(table_index, temp_para)

    # Supprimer complètement la structure du tableau de la structure du document
    owner_block.ChildObjects.Remove(table)

# Enregistrer le document mis à jour
doc.SaveToFile("1st table to text.docx", FileFormat.Docx2016)
doc.Close()
Remarque : Les paragraphes multiples au sein d'une même cellule sont combinés en une seule ligne séparée par des espaces.
Traitement par lots de tous les tableaux
Pour convertir tous les tableaux d'un document en texte, réutilisez la logique de conversion de l'exemple précédent et appliquez-la à chaque tableau de chaque section. Comme chaque tableau est supprimé après la conversion, les tableaux doivent être traités dans l'ordre inverse. Sinon, la suppression d'un tableau décale les index des tableaux restants, ce qui peut entraîner l'omission de tableaux ou des erreurs d'index.
from spire.doc import *
from spire.doc.documents import *

# Créer un objet Document et charger un fichier Word
doc = Document()
doc.LoadFromFile("input.docx")

# Parcourir chaque section du document
for s_idx in range(doc.Sections.Count):
    section = doc.Sections[s_idx]

    # Parcourir les tableaux à l'envers pour éviter les problèmes de décalage d'index
    table_count = section.Tables.Count
    for t_idx in range(table_count - 1, -1, -1):
        table = section.Tables.get_Item(t_idx)

        # Collecter le texte de toutes les lignes et cellules
        text_lines = []
        for j in range(table.Rows.Count):
            row = table.Rows.get_Item(j)
            row_cells_text = []
            for k in range(row.Cells.Count):
                cell = row.Cells.get_Item(k)
                cell_text_pieces = []
                for p in range(cell.Paragraphs.Count):
                    para_obj = cell.Paragraphs.get_Item(p)
                    if para_obj.Text:
                        cell_text_pieces.append(para_obj.Text.strip())
                row_cells_text.append(" ".join(cell_text_pieces))
            text_lines.append("\t".join(row_cells_text))

        # Remplacer le nœud du tableau par des paragraphes simples sur place
        owner_block = table.OwnerTextBody
        table_index = owner_block.ChildObjects.IndexOf(table)

        for line in reversed(text_lines):
            temp_para = section.AddParagraph()
            temp_para.Text = line
            section.Paragraphs.Remove(temp_para)
            owner_block.ChildObjects.Insert(table_index, temp_para)

        # Supprimer le tableau actuel en toute sécurité
        owner_block.ChildObjects.Remove(table)

# Enregistrer le fichier final
doc.SaveToFile("all tables to text.docx", FileFormat.Docx2016)
doc.Close()
Astuce : Exporter les données d'un tableau vers un fichier TXT externe
Dans de nombreux flux de travail de données, l'objectif est d'obtenir des informations plutôt que de modifier les fichiers de mise en page d'origine. Si vous n'avez besoin que de texte tabulaire pour l'ingestion dans une base de données, la journalisation ou l'archivage en texte brut, c'est encore plus simple. Vous pouvez rapidement extraire le contenu brut des cellules et l'écrire directement dans un fichier texte externe avec Free Spire.Doc.
Exemple de code
from spire.doc import *
from spire.doc.common import *

# Créer une instance Document
doc = Document()

# Charger un document Word
doc.LoadFromFile("input.docx")

# Obtenir le premier tableau
table = doc.Sections[0].Tables[0]

# Extraire le texte du tableau
tableData = ''
for j in range(table.Rows.Count):
    row = table.Rows.get_Item(j)

    for k in range(row.Cells.Count):
        cell = row.Cells.get_Item(k)

        for p in range(cell.Paragraphs.Count):
            tableData += cell.Paragraphs.get_Item(p).Text + ' '

        if k < row.Cells.Count - 1:
            tableData += '\t'

    tableData += '\n'

# Enregistrer le texte extrait dans un fichier TXT
with open("/table_text.txt", "w", encoding="utf-8") as f:
    f.write(tableData)

doc.Close()
Astuce : Pour des données tabulaires structurées, vous pouvez également convertir les tableaux Word en CSV pour les utiliser dans des feuilles de calcul, des bases de données et d'autres flux de traitement de données.
Foire aux questions
Q1 : Que faire si le texte converti semble mal aligné ?
L'utilisation de tabulations (\t) préserve au mieux l'espacement structurel. Si l'alignement des colonnes semble toujours irrégulier dans Word, sélectionnez les paragraphes convertis et ajustez les tabulations sur la règle horizontale.
Q2 : Comment convertir du texte en tableau dans Word ?
Pour inverser le processus, mettez votre texte en surbrillance, allez dans Insertion > Tableau, et cliquez sur Convertir le texte en tableau. Sélectionnez le délimiteur correspondant (par exemple, tabulations ou virgules) pour reconstruire votre tableau.
Q3 : Quel est le raccourci clavier pour convertir un tableau en texte dans Word ?
Microsoft Word ne fournit pas de raccourci clavier dédié pour Convertir en texte. Vous pouvez accéder à la commande via le ruban ou personnaliser un raccourci via les paramètres clavier de Word.
Résumé
Cet article a présenté deux façons de convertir des tableaux dans des documents Word en texte. L'outil intégré de Word fonctionne bien pour les tableaux individuels ou un petit nombre de documents, tandis que Free Spire.Doc for Python est mieux adapté au traitement automatisé de plusieurs tableaux. Vous pouvez également extraire le contenu des tableaux vers un fichier TXT pour un stockage en texte brut ou un traitement ultérieur.
À lire également :
Cómo convertir una tabla a texto en Word: guía paso a paso
Las tablas de Word son útiles para organizar datos, pero pueden resultar incómodas cuando necesitas editar su contenido como texto normal. Si ya no necesitas la estructura de tabla, puedes convertir una tabla a texto usando la herramienta integrada de Word o automatizar el proceso con Python. Esta guía cubre los pasos detallados para ambos métodos, vamos a verlos.
- Convertir tabla a texto en Word con una herramienta integrada
- Convertir tablas de Word a texto con Python
- Exportar datos de tabla a un archivo TXT externo
- Preguntas frecuentes
Convertir tabla a texto en Word con una herramienta integrada
Microsoft Word proporciona una herramienta integrada para convertir tablas a texto. Si solo necesitas convertir una o dos tablas, la herramienta integrada suele ser la opción más rápida. Elimina la estructura de la tabla y convierte el contenido de las celdas en texto normal.
Cómo cambiar una tabla a texto en MS Word:
- Paso 1: Haz clic en cualquier lugar dentro de la tabla para mostrar la pestaña contextual Disposición de tabla en la cinta superior.
- Paso 2: Ve a la pestaña Disposición de tabla en el menú superior y haz clic en el botón Convertir a texto en el grupo Datos.
- Paso 3: Selecciona tu delimitador preferido (tabulaciones, comas, marcas de párrafo o un carácter personalizado) para separar los valores de las columnas.
- Paso 4: Haz clic en Aceptar para transformar la tabla en párrafos de texto normal al instante.
Convertir a texto frente a ocultar bordes
Ocultar los bordes de la tabla solo cambia el aspecto de la tabla. Las celdas, columnas y la estructura de la tabla permanecen en su lugar, por lo que el contenido sigue estando restringido por el diseño de la tabla.
Convertir la tabla a texto elimina la estructura de la tabla y convierte el contenido de las celdas en párrafos normales. Luego puedes editar y dar formato al contenido sin el diseño de la tabla.
Convertir tablas de Word a texto con Python
La herramienta integrada de Word es conveniente para convertir tablas individuales, pero resulta menos práctica cuando necesitas procesar muchos documentos o tablas. Para los desarrolladores de Python, Free Spire.Doc for Python proporciona una forma de automatizar la conversión de tabla a texto sin necesidad de tener instalado Microsoft Word.
Convertir una tabla a texto
El script lee el texto de cada celda, une las celdas de la misma fila con caracteres de tabulación, inserta los párrafos resultantes donde estaba ubicada la tabla y luego elimina la tabla original.
from spire.doc import *
from spire.doc.documents import *

# Inicializar la instancia del documento y cargar el archivo de destino
doc = Document()
doc.LoadFromFile("input.docx")

# Obtener la primera sección y la tabla de destino
section = doc.Sections[0]
if section.Tables.Count > 0:
    table = section.Tables[0]

    # Extraer texto de las celdas línea por línea
    text_lines = []
    for j in range(table.Rows.Count):
        row = table.Rows.get_Item(j)
        row_cells_text = []
        for k in range(row.Cells.Count):
            cell = row.Cells.get_Item(k)

            # Extraer texto de los párrafos de la celda
            cell_text_pieces = []
            for p in range(cell.Paragraphs.Count):
                para_obj = cell.Paragraphs.get_Item(p)
                if para_obj.Text:
                    cell_text_pieces.append(para_obj.Text.strip())

            row_cells_text.append(" ".join(cell_text_pieces))

        # Unir el texto de la celda usando separadores de tabulación
        text_lines.append("\t".join(row_cells_text))

    # Localizar la tabla dentro de su bloque principal
    owner_block = table.OwnerTextBody
    table_index = owner_block.ChildObjects.IndexOf(table)

    # Insertar nuevos párrafos de texto en la posición exacta de la tabla
    for line in reversed(text_lines):
        temp_para = section.AddParagraph()
        temp_para.Text = line
        section.Paragraphs.Remove(temp_para)
        owner_block.ChildObjects.Insert(table_index, temp_para)

    # Eliminar completamente la estructura de la tabla de la estructura del documento
    owner_block.ChildObjects.Remove(table)

# Guardar el documento actualizado
doc.SaveToFile("1st table to text.docx", FileFormat.Docx2016)
doc.Close()
Nota: Los párrafos múltiples dentro de la misma celda se combinan en una sola línea separada por espacios.
Procesamiento por lotes de todas las tablas
Para convertir todas las tablas de un documento en texto, reutiliza la lógica de conversión del ejemplo anterior y aplícala a cada tabla en cada sección. Dado que cada tabla se elimina después de la conversión, las tablas deben procesarse en orden inverso. De lo contrario, eliminar una tabla desplaza los índices de las tablas restantes, lo que puede causar que se omitan tablas o provocar errores de índice.
from spire.doc import *
from spire.doc.documents import *

# Crear un objeto Document y cargar un archivo de Word
doc = Document()
doc.LoadFromFile("input.docx")

# Iterar a través de cada sección en el documento
for s_idx in range(doc.Sections.Count):
    section = doc.Sections[s_idx]

    # Iterar hacia atrás a través de las tablas para evitar problemas de desplazamiento de índice
    table_count = section.Tables.Count
    for t_idx in range(table_count - 1, -1, -1):
        table = section.Tables.get_Item(t_idx)

        # Recopilar texto de todas las filas y celdas
        text_lines = []
        for j in range(table.Rows.Count):
            row = table.Rows.get_Item(j)
            row_cells_text = []
            for k in range(row.Cells.Count):
                cell = row.Cells.get_Item(k)
                cell_text_pieces = []
                for p in range(cell.Paragraphs.Count):
                    para_obj = cell.Paragraphs.get_Item(p)
                    if para_obj.Text:
                        cell_text_pieces.append(para_obj.Text.strip())
                row_cells_text.append(" ".join(cell_text_pieces))
            text_lines.append("\t".join(row_cells_text))

        # Reemplazar el nodo de la tabla con párrafos simples en el lugar
        owner_block = table.OwnerTextBody
        table_index = owner_block.ChildObjects.IndexOf(table)

        for line in reversed(text_lines):
            temp_para = section.AddParagraph()
            temp_para.Text = line
            section.Paragraphs.Remove(temp_para)
            owner_block.ChildObjects.Insert(table_index, temp_para)

        # Eliminar de forma segura la tabla actual
        owner_block.ChildObjects.Remove(table)

# Guardar el archivo final
doc.SaveToFile("all tables to text.docx", FileFormat.Docx2016)
doc.Close()
Consejo: Exportar datos de tabla a un archivo TXT externo
En muchos flujos de trabajo de canalización de datos, el objetivo es obtener información en lugar de modificar los archivos de diseño originales. Si solo necesitas texto tabular para la ingesta de bases de datos, registro o archivo de texto sin formato, es aún más fácil. Puedes extraer rápidamente el contenido sin procesar de las celdas y escribirlo directamente en un archivo de texto externo con Free Spire.Doc.
Ejemplo de código
from spire.doc import *
from spire.doc.common import *

# Crear una instancia de Document
doc = Document()

# Cargar un documento de Word
doc.LoadFromFile("input.docx")

# Obtener la primera tabla
table = doc.Sections[0].Tables[0]

# Extraer texto de la tabla
tableData = ''
for j in range(table.Rows.Count):
    row = table.Rows.get_Item(j)

    for k in range(row.Cells.Count):
        cell = row.Cells.get_Item(k)

        for p in range(cell.Paragraphs.Count):
            tableData += cell.Paragraphs.get_Item(p).Text + ' '

        if k < row.Cells.Count - 1:
            tableData += '\t'

    tableData += '\n'

# Guardar el texto extraído en un archivo TXT
with open("/table_text.txt", "w", encoding="utf-8") as f:
    f.write(tableData)

doc.Close()
Consejo: Para datos tabulares estructurados, también puedes convertir tablas de Word a CSV para su uso en hojas de cálculo, bases de datos y otros flujos de trabajo de procesamiento de datos.
Preguntas frecuentes
P1: ¿Qué debo hacer si el texto convertido parece desalineado?
El uso de tabulaciones (\t) es lo que mejor conserva el espaciado estructural. Si la alineación de las columnas sigue pareciendo desigual en Word, selecciona los párrafos convertidos y ajusta las tabulaciones en la regla horizontal.
P2: ¿Cómo puedo volver a convertir texto en una tabla en Word?
Para revertir el proceso, resalta tu texto, ve a Insertar > Tabla y haz clic en Convertir texto en tabla. Selecciona el delimitador coincidente (por ejemplo, tabulaciones o comas) para reconstruir tu tabla.
P3: ¿Cuál es la tecla de acceso directo para convertir una tabla a texto en Word?
Microsoft Word no proporciona un atajo de teclado dedicado para Convertir a texto. Puedes acceder al comando a través de la cinta de opciones o personalizar un atajo a través de la configuración de teclado de Word.
Resumen
Este artículo presentó dos formas de convertir tablas en documentos de Word a texto. La herramienta integrada de Word funciona bien para tablas individuales o un pequeño número de documentos, mientras que Free Spire.Doc for Python es más adecuado para el procesamiento automatizado de múltiples tablas. También puedes extraer el contenido de la tabla a un archivo TXT para almacenamiento en texto sin formato o procesamiento posterior.
Leer también:
So konvertieren Sie eine Tabelle in Text in Word: Schritt-für-Schritt-Anleitung
Word-Tabellen sind nützlich, um Daten zu organisieren, können jedoch unpraktisch werden, wenn Sie deren Inhalte als normalen Text bearbeiten müssen. Wenn Sie die Tabellenstruktur nicht mehr benötigen, können Sie eine Tabelle in Text umwandeln, indem Sie das integrierte Tool von Word verwenden oder den Vorgang mit Python automatisieren. Dieser Leitfaden behandelt detaillierte Schritte für beide Methoden – schauen wir sie uns an.
- Konvertieren von Tabellen in Text in Word mit einem integrierten Tool
- Konvertieren von Word-Tabellen in Text mit Python
- Exportieren von Tabellendaten in eine externe TXT-Datei
- FAQs
Konvertieren von Tabellen in Text in Word mit einem integrierten Tool
Microsoft Word bietet ein integriertes Tool zum Konvertieren von Tabellen in Text. Wenn Sie nur eine oder zwei Tabellen konvertieren müssen, ist das integrierte Tool normalerweise die schnellste Option. Es entfernt die Tabellenstruktur und wandelt den Zelleninhalt in normalen Text um.
So ändern Sie eine Tabelle in Text in MS Word:
- Schritt 1: Klicken Sie irgendwo in die Tabelle, um die kontextbezogene Registerkarte Tabellenlayout im oberen Menüband anzuzeigen.
- Schritt 2: Gehen Sie zur Registerkarte Tabellenlayout im oberen Menü und klicken Sie auf die Schaltfläche In Text konvertieren in der Gruppe Daten.
- Schritt 3: Wählen Sie das gewünschte Trennzeichen (Tabstopps, Kommas, Absatzmarken oder ein benutzerdefiniertes Zeichen), um die Spaltenwerte zu trennen.
- Schritt 4: Klicken Sie auf OK, um die Tabelle sofort in normale Textabsätze umzuwandeln.
Konvertieren in Text vs. Ausblenden von Rahmen
Das Ausblenden von Tabellenrahmen ändert nur das Aussehen der Tabelle. Die Zellen, Spalten und die Tabellenstruktur bleiben erhalten, sodass der Inhalt weiterhin durch das Tabellenlayout eingeschränkt ist.
Das Konvertieren der Tabelle in Text entfernt die Tabellenstruktur und verwandelt den Zelleninhalt in normale Absätze. Sie können den Inhalt dann ohne das Tabellenlayout bearbeiten und formatieren.
Konvertieren von Word-Tabellen in Text mit Python
Das integrierte Tool von Word ist praktisch für die Konvertierung einzelner Tabellen, wird jedoch unpraktisch, wenn Sie viele Dokumente oder Tabellen verarbeiten müssen. Für Python-Entwickler bietet Free Spire.Doc for Python eine Möglichkeit, die Tabellen-zu-Text-Konvertierung zu automatisieren, ohne dass Microsoft Word installiert sein muss.
Konvertieren einer Tabelle in Text
Das Skript liest den Text aus jeder Zelle, verbindet Zellen in derselben Zeile mit Tabstopp-Zeichen, fügt die resultierenden Absätze dort ein, wo sich die Tabelle befand, und entfernt dann die ursprüngliche Tabelle.
from spire.doc import *
from spire.doc.documents import *

# Initialisieren der Document-Instanz und Laden der Zieldatei
doc = Document()
doc.LoadFromFile("input.docx")

# Abrufen des ersten Abschnitts und der Ziel-Tabelle
section = doc.Sections[0]
if section.Tables.Count > 0:
    table = section.Tables[0]

    # Extrahieren von Text aus Zellen Zeile für Zeile
    text_lines = []
    for j in range(table.Rows.Count):
        row = table.Rows.get_Item(j)
        row_cells_text = []
        for k in range(row.Cells.Count):
            cell = row.Cells.get_Item(k)

            # Extrahieren von Text aus Zellenabsätzen
            cell_text_pieces = []
            for p in range(cell.Paragraphs.Count):
                para_obj = cell.Paragraphs.get_Item(p)
                if para_obj.Text:
                    cell_text_pieces.append(para_obj.Text.strip())

            row_cells_text.append(" ".join(cell_text_pieces))

        # Verbinden des Zellentextes mit Tab-Trennzeichen
        text_lines.append("\t".join(row_cells_text))

    # Suchen der Tabelle innerhalb ihres übergeordneten Blocks
    owner_block = table.OwnerTextBody
    table_index = owner_block.ChildObjects.IndexOf(table)

    # Einfügen neuer Textabsätze an der exakten Tabellenposition
    for line in reversed(text_lines):
        temp_para = section.AddParagraph()
        temp_para.Text = line
        section.Paragraphs.Remove(temp_para)
        owner_block.ChildObjects.Insert(table_index, temp_para)

    # Vollständiges Entfernen der Tabellenstruktur aus der Dokumentstruktur
    owner_block.ChildObjects.Remove(table)

# Speichern des aktualisierten Dokuments
doc.SaveToFile("1st table to text.docx", FileFormat.Docx2016)
doc.Close()
Hinweis: Mehrere Absätze innerhalb derselben Zelle werden zu einer einzigen Zeile zusammengefasst, die durch Leerzeichen getrennt ist.
Stapelverarbeitung aller Tabellen
Um alle Tabellen in einem Dokument in Text umzuwandeln, verwenden Sie die Konvertierungslogik aus dem vorherigen Beispiel erneut und wenden Sie sie auf jede Tabelle in jedem Abschnitt an. Da jede Tabelle nach der Konvertierung entfernt wird, sollten die Tabellen in umgekehrter Reihenfolge verarbeitet werden. Andernfalls verschiebt das Löschen einer Tabelle die Indizes der verbleibenden Tabellen, was dazu führen kann, dass Tabellen übersprungen werden oder Indexfehler auftreten.
from spire.doc import *
from spire.doc.documents import *

# Erstellen eines Document-Objekts und Laden einer Word-Datei
doc = Document()
doc.LoadFromFile("input.docx")

# Iterieren durch jeden Abschnitt im Dokument
for s_idx in range(doc.Sections.Count):
    section = doc.Sections[s_idx]

    # Rückwärts durch Tabellen iterieren, um Indexverschiebungen zu vermeiden
    table_count = section.Tables.Count
    for t_idx in range(table_count - 1, -1, -1):
        table = section.Tables.get_Item(t_idx)

        # Sammeln von Text aus allen Zeilen und Zellen
        text_lines = []
        for j in range(table.Rows.Count):
            row = table.Rows.get_Item(j)
            row_cells_text = []
            for k in range(row.Cells.Count):
                cell = row.Cells.get_Item(k)
                cell_text_pieces = []
                for p in range(cell.Paragraphs.Count):
                    para_obj = cell.Paragraphs.get_Item(p)
                    if para_obj.Text:
                        cell_text_pieces.append(para_obj.Text.strip())
                row_cells_text.append(" ".join(cell_text_pieces))
            text_lines.append("\t".join(row_cells_text))

        # Ersetzen des Tabellenknotens durch einfache Absätze an Ort und Stelle
        owner_block = table.OwnerTextBody
        table_index = owner_block.ChildObjects.IndexOf(table)

        for line in reversed(text_lines):
            temp_para = section.AddParagraph()
            temp_para.Text = line
            section.Paragraphs.Remove(temp_para)
            owner_block.ChildObjects.Insert(table_index, temp_para)

        # Sicheres Entfernen der aktuellen Tabelle
        owner_block.ChildObjects.Remove(table)

# Speichern der finalen Datei
doc.SaveToFile("all tables to text.docx", FileFormat.Docx2016)
doc.Close()
Tipp: Exportieren von Tabellendaten in eine externe TXT-Datei
In vielen Daten-Pipelines besteht das Ziel darin, Informationen zu erhalten, anstatt die ursprünglichen Layout-Dateien zu ändern. Wenn Sie tabellarischen Text nur für die Datenbankaufnahme, Protokollierung oder Archivierung als Klartext benötigen, ist dies noch einfacher. Sie können schnell rohe Zelleninhalte extrahieren und diese mit Free Spire.Doc direkt in eine externe Textdatei schreiben.
Codebeispiel
from spire.doc import *
from spire.doc.common import *

# Erstellen einer Document-Instanz
doc = Document()

# Laden eines Word-Dokuments
doc.LoadFromFile("input.docx")

# Abrufen der ersten Tabelle
table = doc.Sections[0].Tables[0]

# Extrahieren von Tabellentext
tableData = ''
for j in range(table.Rows.Count):
    row = table.Rows.get_Item(j)

    for k in range(row.Cells.Count):
        cell = row.Cells.get_Item(k)

        for p in range(cell.Paragraphs.Count):
            tableData += cell.Paragraphs.get_Item(p).Text + ' '

        if k < row.Cells.Count - 1:
            tableData += '\t'

    tableData += '\n'

# Speichern des extrahierten Textes in einer TXT-Datei
with open("/table_text.txt", "w", encoding="utf-8") as f:
    f.write(tableData)

doc.Close()
Tipp: Für strukturierte tabellarische Daten können Sie auch Word-Tabellen in CSV konvertieren, um sie in Tabellenkalkulationen, Datenbanken und anderen Datenverarbeitungs-Workflows zu verwenden.
Häufig gestellte Fragen (FAQs)
F1: Was soll ich tun, wenn der konvertierte Text falsch ausgerichtet aussieht?
Die Verwendung von Tabstopps (\t) bewahrt die strukturelle Abstände am besten. Wenn die Spaltenausrichtung in Word immer noch ungleichmäßig aussieht, markieren Sie die konvertierten Absätze und passen Sie die Tabstopps auf dem horizontalen Lineal an.
F2: Wie kann ich Text in Word wieder in eine Tabelle umwandeln?
Um den Vorgang umzukehren, markieren Sie Ihren Text, gehen Sie zu Einfügen > Tabelle und klicken Sie auf Text in Tabelle konvertieren. Wählen Sie das passende Trennzeichen (z. B. Tabstopps oder Kommas), um Ihre Tabelle neu aufzubauen.
F3: Was ist das Tastenkürzel zum Konvertieren einer Tabelle in Text in Word?
Microsoft Word bietet kein dediziertes Tastenkürzel für In Text konvertieren. Sie können den Befehl über das Menüband aufrufen oder ein Tastenkürzel über die Tastatureinstellungen von Word anpassen.
Zusammenfassung
Dieser Artikel hat zwei Möglichkeiten vorgestellt, Tabellen in Word-Dokumenten in Text umzuwandeln. Das integrierte Tool von Word eignet sich gut für einzelne Tabellen oder eine kleine Anzahl von Dokumenten, während Free Spire.Doc for Python besser für die automatisierte Verarbeitung mehrerer Tabellen geeignet ist. Sie können Tabelleninhalte auch in eine TXT-Datei extrahieren, um sie als Klartext zu speichern oder weiterzuverarbeiten.
Ebenfalls lesen:
Как преобразовать таблицу в текст в Word: пошаговое руководство
Таблицы в Word полезны для организации данных, но они могут стать неудобными, когда вам нужно редактировать их содержимое как обычный текст. Если вам больше не нужна структура таблицы, вы можете преобразовать таблицу в текст, используя встроенный инструмент Word, или автоматизировать этот процесс с помощью Python. В этом руководстве подробно описаны оба метода, давайте рассмотрим их.
- Преобразование таблицы в текст в Word с помощью встроенного инструмента
- Преобразование таблиц Word в текст с помощью Python
- Экспорт данных таблицы в внешний TXT-файл
- Часто задаваемые вопросы
Преобразование таблицы в текст в Word с помощью встроенного инструмента
Microsoft Word предоставляет встроенный инструмент для преобразования таблиц в текст. Если вам нужно преобразовать всего одну или две таблицы, встроенный инструмент обычно является самым быстрым вариантом. Он удаляет структуру таблицы и преобразует содержимое ячеек в обычный текст.
Как преобразовать таблицу в текст в MS Word:
- Шаг 1: Щелкните в любом месте внутри таблицы, чтобы отобразить контекстную вкладку Макет таблицы (Table Layout) на верхней ленте.
- Шаг 2: Перейдите на вкладку Макет таблицы в верхнем меню и нажмите кнопку Преобразовать в текст (Convert to Text) в группе Данные (Data).
- Шаг 3: Выберите предпочтительный разделитель (знаки табуляции, запятые, знаки абзаца или пользовательский символ) для разделения значений столбцов.
- Шаг 4: Нажмите ОК, чтобы мгновенно преобразовать таблицу в обычные текстовые абзацы.
Преобразование в текст против скрытия границ
Скрытие границ таблицы меняет только внешний вид таблицы. Ячейки, столбцы и структура таблицы остаются на месте, поэтому содержимое по-прежнему ограничено макетом таблицы.
Преобразование таблицы в текст удаляет структуру таблицы и превращает содержимое ячеек в обычные абзацы. После этого вы можете редактировать и форматировать содержимое без ограничений макета таблицы.
Преобразование таблиц Word в текст с помощью Python
Встроенный инструмент Word удобен для преобразования отдельных таблиц, но он становится менее практичным, когда нужно обработать много документов или таблиц. Для разработчиков на Python библиотека Free Spire.Doc for Python предоставляет способ автоматизации преобразования таблицы в текст без необходимости установки Microsoft Word.
Преобразование таблицы в текст
Скрипт считывает текст из каждой ячейки, объединяет ячейки в одной строке с помощью символов табуляции, вставляет полученные абзацы туда, где находилась таблица, а затем удаляет исходную таблицу.
from spire.doc import *
from spire.doc.documents import *

# Инициализация экземпляра документа и загрузка целевого файла
doc = Document()
doc.LoadFromFile("input.docx")

# Получение первого раздела и целевой таблицы
section = doc.Sections[0]
if section.Tables.Count > 0:
    table = section.Tables[0]

    # Извлечение текста из ячеек построчно
    text_lines = []
    for j in range(table.Rows.Count):
        row = table.Rows.get_Item(j)
        row_cells_text = []
        for k in range(row.Cells.Count):
            cell = row.Cells.get_Item(k)

            # Извлечение текста из абзацев ячейки
            cell_text_pieces = []
            for p in range(cell.Paragraphs.Count):
                para_obj = cell.Paragraphs.get_Item(p)
                if para_obj.Text:
                    cell_text_pieces.append(para_obj.Text.strip())

            row_cells_text.append(" ".join(cell_text_pieces))

        # Объединение текста ячеек с использованием разделителей табуляции
        text_lines.append("\t".join(row_cells_text))

    # Определение местоположения таблицы внутри родительского блока
    owner_block = table.OwnerTextBody
    table_index = owner_block.ChildObjects.IndexOf(table)

    # Вставка новых текстовых абзацев точно на место таблицы
    for line in reversed(text_lines):
        temp_para = section.AddParagraph()
        temp_para.Text = line
        section.Paragraphs.Remove(temp_para)
        owner_block.ChildObjects.Insert(table_index, temp_para)

    # Полное удаление структуры таблицы из структуры документа
    owner_block.ChildObjects.Remove(table)

# Сохранение обновленного документа
doc.SaveToFile("1st table to text.docx", FileFormat.Docx2016)
doc.Close()
Примечание: Несколько абзацев внутри одной ячейки объединяются в одну строку, разделенную пробелами.
Пакетная обработка всех таблиц
Чтобы преобразовать все таблицы в документе в текст, используйте логику преобразования из предыдущего примера и примените ее к каждой таблице в каждом разделе. Поскольку каждая таблица удаляется после преобразования, таблицы следует обрабатывать в обратном порядке. В противном случае удаление таблицы смещает индексы оставшихся таблиц, что может привести к пропуску таблиц или ошибкам индексации.
from spire.doc import *
from spire.doc.documents import *

# Создание объекта Document и загрузка файла Word
doc = Document()
doc.LoadFromFile("input.docx")

# Итерация по каждому разделу в документе
for s_idx in range(doc.Sections.Count):
    section = doc.Sections[s_idx]

    # Итерация по таблицам в обратном порядке, чтобы избежать проблем со смещением индексов
    table_count = section.Tables.Count
    for t_idx in range(table_count - 1, -1, -1):
        table = section.Tables.get_Item(t_idx)

        # Сбор текста из всех строк и ячеек
        text_lines = []
        for j in range(table.Rows.Count):
            row = table.Rows.get_Item(j)
            row_cells_text = []
            for k in range(row.Cells.Count):
                cell = row.Cells.get_Item(k)
                cell_text_pieces = []
                for p in range(cell.Paragraphs.Count):
                    para_obj = cell.Paragraphs.get_Item(p)
                    if para_obj.Text:
                        cell_text_pieces.append(para_obj.Text.strip())
                row_cells_text.append(" ".join(cell_text_pieces))
            text_lines.append("\t".join(row_cells_text))

        # Замена узла таблицы на обычные абзацы на месте
        owner_block = table.OwnerTextBody
        table_index = owner_block.ChildObjects.IndexOf(table)

        for line in reversed(text_lines):
            temp_para = section.AddParagraph()
            temp_para.Text = line
            section.Paragraphs.Remove(temp_para)
            owner_block.ChildObjects.Insert(table_index, temp_para)

        # Безопасное удаление текущей таблицы
        owner_block.ChildObjects.Remove(table)

# Сохранение итогового файла
doc.SaveToFile("all tables to text.docx", FileFormat.Docx2016)
doc.Close()
Совет: Экспорт данных таблицы в внешний TXT-файл
Во многих рабочих процессах обработки данных цель состоит в том, чтобы получить информацию, а не изменять исходные файлы макета. Если вам нужен только табличный текст для загрузки в базу данных, ведения журналов или архивирования в виде простого текста, это еще проще. Вы можете быстро извлечь необработанное содержимое ячеек и записать его прямо во внешний текстовый файл с помощью Free Spire.Doc.
Пример кода
from spire.doc import *
from spire.doc.common import *

# Создание экземпляра Document
doc = Document()

# Загрузка документа Word
doc.LoadFromFile("input.docx")

# Получение первой таблицы
table = doc.Sections[0].Tables[0]

# Извлечение текста таблицы
tableData = ''
for j in range(table.Rows.Count):
    row = table.Rows.get_Item(j)

    for k in range(row.Cells.Count):
        cell = row.Cells.get_Item(k)

        for p in range(cell.Paragraphs.Count):
            tableData += cell.Paragraphs.get_Item(p).Text + ' '

        if k < row.Cells.Count - 1:
            tableData += '\t'

    tableData += '\n'

# Сохранение извлеченного текста в TXT-файл
with open("/table_text.txt", "w", encoding="utf-8") as f:
    f.write(tableData)

doc.Close()
Совет: Для структурированных табличных данных вы также можете преобразовать таблицы Word в CSV для использования в электронных таблицах, базах данных и других рабочих процессах обработки данных.
Часто задаваемые вопросы
В1: Что делать, если преобразованный текст выглядит неровно?
Использование табуляции (\t) лучше всего сохраняет структурные интервалы. Если выравнивание столбцов в Word все равно выглядит неровным, выделите преобразованные абзацы и настройте позиции табуляции на горизонтальной линейке.
В2: Как преобразовать текст обратно в таблицу в Word?
Чтобы обратить процесс, выделите текст, перейдите в Вставка > Таблица и нажмите Преобразовать текст в таблицу. Выберите соответствующий разделитель (например, табуляцию или запятые), чтобы восстановить таблицу.
В3: Какая клавиша быстрого доступа для преобразования таблицы в текст в Word?
Microsoft Word не предоставляет специальной клавиши быстрого доступа для команды Преобразовать в текст. Вы можете получить доступ к команде через ленту или настроить сочетание клавиш через настройки клавиатуры Word.
Резюме
В этой статье представлены два способа преобразования таблиц в документах Word в текст. Встроенный инструмент Word хорошо работает для отдельных таблиц или небольшого количества документов, в то время как Free Spire.Doc for Python лучше подходит для автоматизированной обработки нескольких таблиц. Вы также можете извлечь содержимое таблицы в TXT-файл для хранения в виде простого текста или дальнейшей обработки.
Читайте также:
Gerar documentos do Word a partir de dados do Excel em C#
Sumário
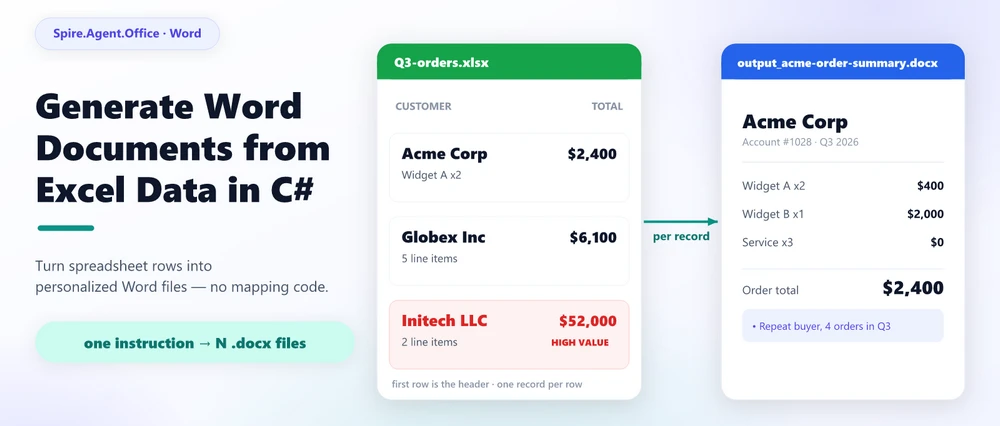
Gerar documentos Word a partir de dados do Excel significa usar linhas de uma planilha como fonte para um ou mais arquivos Word estruturados, geralmente seguindo um modelo ou um fluxo de trabalho de geração de documentos. Tradicionalmente, esse trabalho é feito com a Mala Direta do Word: você mapeia colunas do Excel para campos em um modelo .docx e deixa o Word emitir um documento por linha. A mesma tarefa pode ser automatizada em C# com um SDK de documentos, ou levada adiante com um agente de documentos de IA que processa o requisito como uma instrução em linguagem natural. Este artigo compara as rotas, mostra onde a mala direta deixa de ser eficiente e apresenta um exemplo prático em C# construído sobre o Spire.Agent.Office, um SDK de agente de IA para documentos Office.
Navegação Rápida
- O que significa gerar documentos Word a partir de dados do Excel?
- Mala Direta do Excel para o Word
- Três formas de automatizar a geração de Word a partir do Excel no .NET
- Gerar documentos Word personalizados a partir do Excel em C#
- Perguntas Frequentes
1. O que significa gerar documentos Word a partir de dados do Excel?
A frase soa próxima a "converter Excel para Word", mas a intenção é diferente. Converter .xlsx para .docx altera o formato de um arquivo e mantém seu conteúdo aproximadamente igual. Gerar documentos Word a partir de dados do Excel cria novos documentos cujo conteúdo é derivado de células em uma planilha: uma folha de pedido por cliente, um relatório mensal por região, um lote de cartas ou etiquetas a partir de uma lista de endereços, um conjunto de faturas a partir de uma planilha de pedidos.
O formato recorrente do requisito é quase sempre o mesmo:
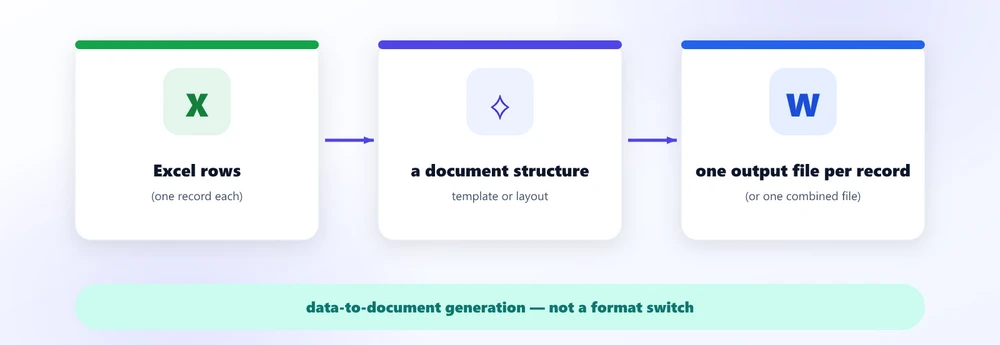
Como uma frase real, soa assim: "Tenho uma lista de clientes e seus pedidos no Excel; preciso de um documento Word para cada um com suas informações, seus itens e um total." A palavra que importa é derivado: o conteúdo do documento vem dos dados, portanto, trata-se de geração de dados para documento, não de uma simples troca de formato.
Essa é a demanda que este artigo aborda. Tudo abaixo trata das diferentes maneiras de satisfazê-la e do ponto em que você deve parar de vincular campos manualmente.
2. O método tradicional: Mala Direta do Excel para o Word
No nível da interface, a resposta padrão para "transformar esta lista do Excel em vários documentos Word" é a Mala Direta do Word. É o recurso que a maioria das pessoas pensa ao pesquisar a tarefa, e a Microsoft oferece um guia passo a passo para isso. O mecanismo é simples e bem compreendido:
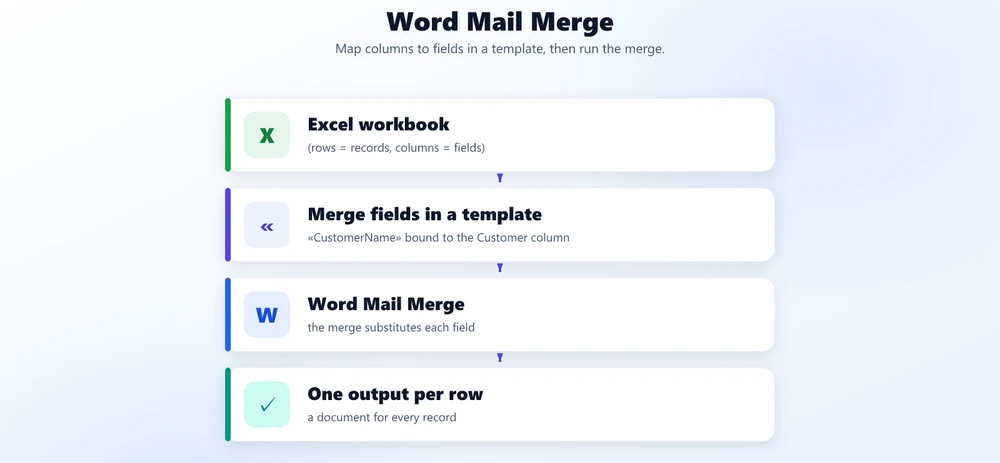
Você coloca um campo como «NomeDoCliente» dentro de um modelo de carta, vincula-o à coluna Cliente da fonte Excel, executa a mesclagem e o Word escreve um documento por linha com esse valor substituído. Como a contagem de linhas pode chegar a milhares, isso transforma "abrir um arquivo, copiar o texto, alterar o nome" em uma operação em lote sem código.
A mala direta é boa em exatamente um tipo de trabalho: colocar esta coluna naquele campo, muitas vezes. Cartas, envelopes, etiquetas e avisos com um layout fixo são sua especialidade. Ela roda dentro do Office, não precisa de programação e, para esses documentos estáveis e baseados apenas em campos, é genuinamente a ferramenta certa.
3. Limites da Mala Direta
O limite chega no momento em que o documento deixa de ser um formulário fixo com espaços em branco e se torna algo que deve depender dos dados. A mala direta substitui valores; ela não decide a estrutura, não raciocina sobre o conteúdo nem compõe nada novo.
Compare dois pedidos. O primeiro é o que a mala direta lida:
"Coloque o nome do cliente no local do nome, o endereço no local do endereço e o pedido nos detalhes do pedido."
O segundo é o pedido que a maioria dos relatórios reais acaba sendo:
"Leia esta pasta de trabalho do Excel, analise os dados de cada cliente, crie um relatório personalizado com seus itens e totais, adicione um resumo de seu padrão de compra e salve cada resultado como um documento Word separado."
O segundo pedido falha em todas as três premissas da mala direta:
- A estrutura varia. Um cliente com três itens de linha precisa de um corpo de documento diferente de um com trinta. Os campos de mesclagem assumem um layout fixo com espaços em branco fixos; eles não aumentam uma tabela com tantas linhas quanto os dados exigem.
- O conteúdo deve ser calculado, não copiado. "Resumir o padrão de compra" e "marcar clientes de alto valor" produzem texto e decisões que nenhuma coluna contém. Não há campo de origem para vinculá-los.
- A saída é um lote de arquivos reais. Cada registro deve ser seu próprio documento Word com seu próprio nome, e o fluxo de trabalho deve ser executado sem supervisão dentro de um aplicativo, não a partir de um assistente do Office.
Essa é a posição honesta da mala direta: ela é excelente no mapeamento de campos, mas torna-se menos adequada quando a estrutura do documento, o conteúdo ou a lógica de saída precisam variar com os dados. O requisito mais profundo — transformar dados em documentos — é um problema de geração, e é onde as rotas de automação abaixo começam.
4. Transformar o requisito em uma instrução: a abordagem via Agente
A alternativa que se ajusta à versão correta do problema é um agente de documentos de IA: uma camada de linguagem natural sobre um motor de documentos determinístico. Em vez de enumerar campos de modelo e código por campo, você descreve a saída, e o agente pode lidar com requisitos difíceis de expressar com a mala direta tradicional — lendo os dados, moldando a estrutura, escrevendo a análise — enquanto o motor de documentos garante que um .docx (ou PDF) real e bem formado seja gerado.
O valor é mais fácil de ver como uma cadeia:
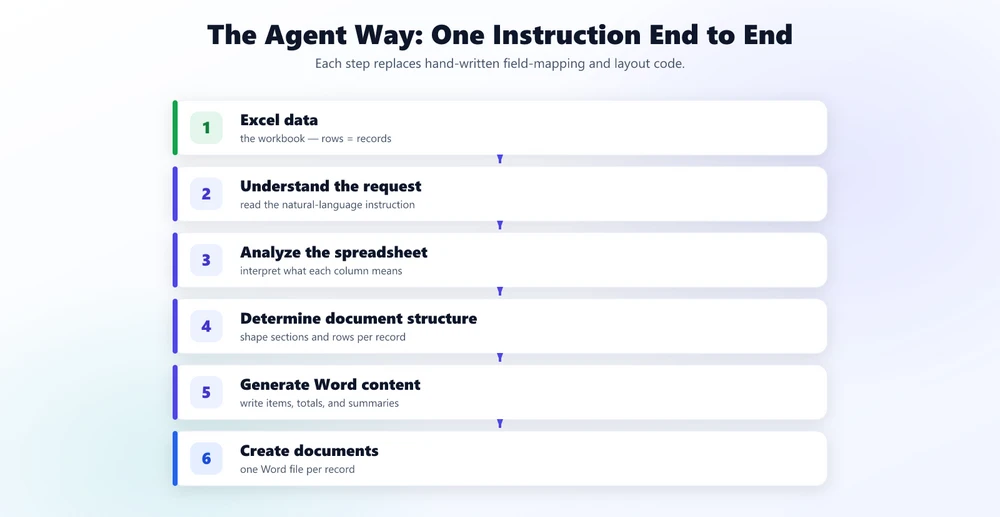
Passos que são difíceis de expressar com a mala direta tradicional — especialmente os três do meio — são exatamente onde um agente pode se destacar. Ele pode interpretar o que uma coluna significa ("Valor Total", "Vendas" e "Líquido" podem nomear o mesmo conceito sob três cabeçalhos), moldar uma estrutura de documento para cada registro e compor os parágrafos de resumo. O que você fornece é uma frase, não um mapa de campos.
A mensagem para levar para o restante deste artigo: a mala direta mapeia colunas do Excel para campos do Word; um agente de IA gera documentos a partir de um requisito. O primeiro é um passo de substituição de valor, o segundo é o que o pedido realmente era.
5. Três formas de automatizar a geração de Word a partir do Excel no .NET
Decidir pela rota certa importa mais do que o código, porque cada rota tem uma curva de custo diferente. Para um aplicativo .NET que precisa deste fluxo de trabalho, as escolhas realistas são:
| Abordagem | O que é necessário | Flexibilidade | Melhor para |
|---|---|---|---|
| Mala Direta do Word | Um modelo .docx com campos de mesclagem + uma fonte Excel; executar a mesclagem (ou script) | Mapeia uma coluna para um campo; trava em estrutura variável, conteúdo condicional, análise | Cartas, etiquetas, envelopes, avisos com formato fixo |
| Vinculação de campos via SDK | Carregar o modelo no código, abrir a pasta de trabalho, percorrer linhas, vincular/localizar-substituir por registro, salvar cada arquivo | Determinístico e testável; você mantém manualmente o mapa de colunas e o layout, cada alteração recompila | Repetir um formato de documento estável em escala |
| Agente de IA em linguagem natural | Passar a pasta de trabalho como anexo, descrever a saída, ler o resultado | Lida com estrutura variável, análise por registro, seções condicionais, resumos | Documentos que variam com os dados ou fluxos de trabalho que mudam mês a mês |
Um atalho que decide a maioria dos casos:
- O formato nunca muda, um campo por coluna, cartas em massa — mala direta é difícil de superar.
- O formato nunca muda, mas você precisa dele no código, determinístico e testável — use um loop de vinculação de campos via SDK.
- O documento deve variar com os dados, incluir análise ou mudar frequentemente — é aí que um agente de IA se paga, porque o custo de uma alteração muitas vezes pode ser reduzido à atualização da instrução, em vez de alterar a lógica de mapeamento e layout no código.
6. Gerar documentos Word personalizados a partir do Excel em C#
Uma versão concreta e funcional do requisito "um documento Word por registro" é um resumo de pedido de cliente. As entradas são uma pasta de trabalho de pedidos de clientes e um modelo Word leve; a saída é um documento personalizado por cliente. A configuração completa — token, pacote e fiação do projeto — está documentada no tutorial de Introdução; aqui focamos na chamada de geração em si.
using Spire.Doc;
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;

AIOptions options = new AIOptions
{
    SpireToken = spireToken,
    WorkDir = @"C:\order-ops\output",   // pasta onde os documentos gerados são gravados
    TimeoutMs = 300000
};

using (Document doc = new Document())
{
    // O modelo fornece âncoras por registro; a pasta de trabalho é a fonte de dados.
    doc.LoadFromFile(@"C:\order-ops\templates\order-summary-template.docx");

    // savePath = null: uma instrução produz um documento por registro,
    // gravado na pasta de saída WorkDir. Nenhum loop C# sobre as linhas.
    AIResult result = doc.AI(options).ExecuteInstruction(
        doc,
        "Leia os dados de pedidos de clientes em Q3-orders.xlsx. Gere um resumo " +
        "de pedido Word independente por cliente, linha por linha. Inclua suas informações " +
        "de contato, cada item de linha com quantidade e valor, os totais do pedido, " +
        "e um resumo de um parágrafo de seu padrão de compra. Marque clientes " +
        "cujo total exceda 50.000 como alto valor. Salve cada documento como seu próprio " +
        "arquivo chamado output_ seguido pelo nome do cliente (por exemplo " +
        "output_acme-order-summary.docx).",
        null,
        new[] { @"C:\order-ops\input\Q3-orders.xlsx" });

    if (result == null || !result.Success)
        throw new InvalidOperationException($"A geração falhou: {result?.ErrorMessage}");
}
Três detalhes importam ao executar isso. Primeiro, a instrução é onde a lógica de geração reside: a análise ("resumo de seu padrão de compra"), a lógica condicional ("marcar clientes acima de 50.000") e a estrutura por registro ("cada item de linha"). Segundo, a pasta de trabalho deve estar organizada: a primeira linha é o cabeçalho, um registro por linha, sem linhas vazias ou células de cabeçalho mescladas — as mesmas regras que a fonte de dados do Word espera. Terceiro, o documento base ancora o layout de saída; um documento levemente estruturado pode dar ao agente um ponto de partida útil para a estrutura de cada registro. Com um documento base totalmente vazio, a mesma instrução produz um único documento composto.
Uma regra de nomenclatura importa aqui: os documentos que o agente grava em WorkDir devem começar com o prefixo output_, ou o SDK não os conta como arquivos gerados. É por isso que a instrução acima pede arquivos como output_acme-order-summary.docx em vez de apenas nomes de clientes.
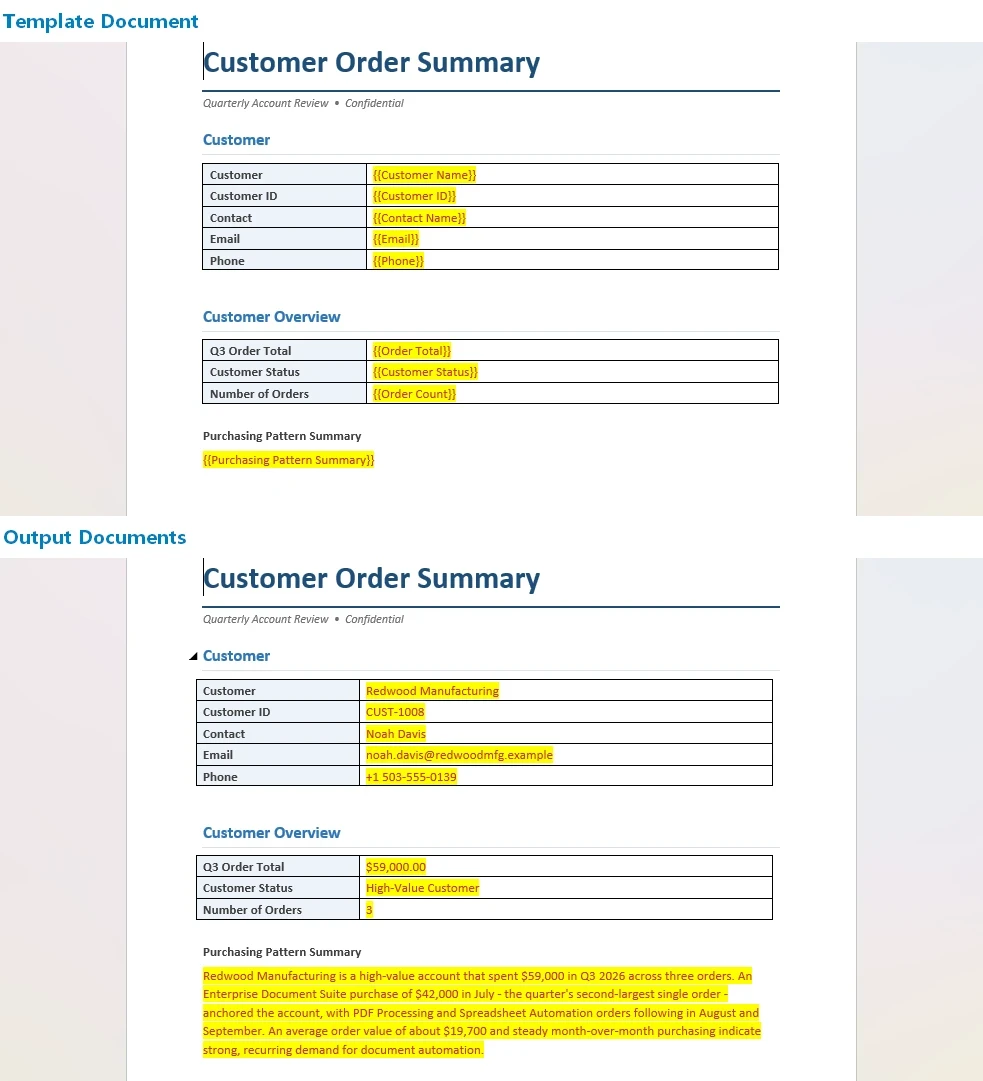
A extensão .docx no seu destino de salvamento ou padrão de arquivo escolhe o formato de saída; aponte a mesma instrução para .pdf e o agente exporta os documentos idênticos para distribuição, sem etapa de renderização separada.
Principais Chamadas de API
Document.AI(options)-- anexa o processador de documentos de IA a um objeto de documento WordExecuteInstruction(doc, instruction, savePath, attachments)-- executa a geração;nullem savePath significa "gravar emWorkDir", e a pasta de trabalho acompanha emattachmentPathsAIResult.Success/AIResult.ErrorMessage-- verifica a execução e revela falhas
7. O que você escreveria sem um Agente
Para contraste, a rota de vinculação de campos via SDK para o mesmo trabalho faz tudo explicitamente. O seguinte é intencionalmente simplificado para mostrar a quantidade de lógica de aplicativo envolvida; uma implementação de produção também precisaria carregar e agrupar os dados da pasta de trabalho:
using Spire.Doc;
using Spire.Xls;

// Um formato fixo é bom; cada variação é mais fiação.
foreach (DataRow row in customersTable.Rows)
{
    using (Document doc = new Document())
    {
        doc.LoadFromFile(@"templates\order-summary-template.docx");

        // Localizar-e-substituir por âncora...
        doc.Replace("{{CustomerName}}", row["Customer"].ToString(), true, true);
        doc.Replace("{{TotalAmount}}", row["Amount"].ToString("C"), true, true);

        // Itens de linha vivem em uma segunda planilha: você une manualmente por cliente,
        // constrói uma tabela e insere em um marcador...
        // A regra "marcar clientes de alto valor" é um if/else que você mantém,
        // e o parágrafo de resumo por cliente é um modelo que você escreve à mão.
        doc.SaveToFile($@"out\{row["Customer"]}-order-summary.docx");
    }
    // ... e cada nova regra, coluna ou mudança de layout significa editar isso e recompilar.
}
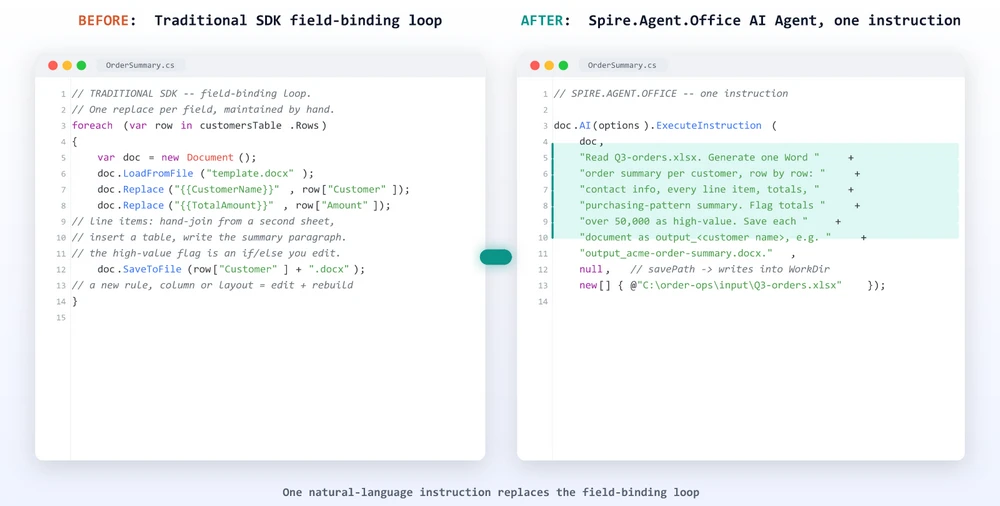
O agente não remove a necessidade de código — ele remove a necessidade de código de mapeamento e layout. A diferença é onde a lógica reside: em um índice de coluna e um localizar-e-substituir, ou em uma frase que o negócio pode ler e editar. Quando regras de negócio ou estruturas de documento mudam frequentemente, a abordagem de linguagem natural pode reduzir a quantidade de código de mapeamento e layout que deve ser mantida.
8. Onde a IA termina e a lógica de aplicativo começa
Um limite útil não é "o que a IA pode ou não fazer", mas o que o aplicativo deve continuar possuindo. Um agente de geração de documentos fica em cima de código determinístico; ele não o substitui.
Seu aplicativo ainda possui as partes que não têm nada a ver com a compreensão da planilha:
- Descoberta e acesso a arquivos -- encontrar a pasta de trabalho, verificar permissões, preparar entradas
- Agendamento de fluxo de trabalho -- quando o trabalho é executado, em que gatilho, em que ordem
- Controle de fonte de dados -- qual pasta de trabalho é uma entrada autorizada e de onde veio
- Tratamento de erros e novas tentativas -- o que acontece quando um arquivo está faltando ou uma execução falha
- Aprovação final -- um humano revisa os documentos gerados antes que sejam enviados
O agente lida com os passos semânticos:
- Compreensão -- ler o que cada coluna significa de diferentes pastas de trabalho
- Planejamento de estrutura -- determinar quantas seções e linhas o documento precisa
- Análise -- transformar dados de pedidos em um resumo e um sinalizador de alto valor
- Composição -- montar documentos Word personalizados a partir do requisito
Mantenha o encanamento determinístico no código, onde é testável e auditável, e entregue a geração semântica ao agente.
9. Perguntas Frequentes
Isso é um substituto para a mala direta do Word?
Não é um substituto direto; é o mesmo trabalho levado adiante. A mala direta mapeia colunas do Excel em campos fixos do Word, o que é suficiente para uma carta com um formato estável. Um agente de IA pode fazer isso também, e pode ler a pasta de trabalho por conteúdo, moldar a estrutura por registro, adicionar análise e compor texto. Para saídas simples de formato fixo, a mala direta continua sendo uma boa ferramenta; quando o documento deve variar com os dados, o agente carrega mais do trabalho.
Como gero vários documentos Word a partir de dados do Excel?
Passe a pasta de trabalho como anexo, defina o caminho de salvamento como null e aponte AIOptions.WorkDir para uma pasta de saída. Uma ExecuteInstruction com uma instrução linha por linha faz com que o agente produza um documento independente por registro, cada um salvo nessa pasta. Nenhum loop C# sobre as linhas é necessário para o lote por registro.
Posso gerar documentos Word a partir do Excel sem usar a Mala Direta?
Sim. Em C# você pode vincular um modelo com o SDK diretamente, ou entregar a pasta de trabalho a um agente de IA que a lê a partir de uma instrução em linguagem natural, e receber um .docx ou PDF real em troca. A mala direta é uma rota, não a única, e é a menos flexível quando o documento precisa de análise ou seções condicionais.
Qual é a diferença entre Mala Direta e geração de documentos por IA?
A mala direta vincula campos definidos a colunas definidas: coluna do Excel entra, campo do Word sai. A geração de documentos por IA interpreta o pedido e os dados juntos, para que possa interpretar o que cada coluna significa e moldar a estrutura do documento de acordo, produzir conteúdo condicional ou analítico e montar vários documentos a partir de uma instrução.
Posso gerar documentos Word personalizados a partir de um arquivo Excel em C#?
Sim. Carregue um modelo Word ou um documento em branco no Spire.Doc, anexe a pasta de trabalho do Excel e chame ExecuteInstruction com uma descrição da saída personalizada. O agente lê cada registro e compõe um documento ajustado a ele, salvo por registro ou como um arquivo combinado, tudo dentro do seu próprio aplicativo .NET.
Um agente de IA pode usar dados do Excel para gerar documentos Word?
Sim. O Spire.Agent.Office combina um modelo de linguagem com uma camada determinística de Word e Excel, para que a instrução seja compreendida e o resultado ainda seja um arquivo Word real que sua equipe pode abrir, formatar e distribuir.
Pronto para automatizar sua geração de Word?
Se o seu fluxo de trabalho é "dados do Excel tornam-se documentos Word personalizados", o caminho mais rápido é descrever a saída e deixar o agente lidar com o resto. Siga o tutorial de Introdução para executar seu primeiro fluxo de trabalho Word orientado por instruções no .NET.
Leitura Adicional
- Gerar Vários Modelos Word com Spire.Agent.Office -- o mesmo padrão de geração aplicado a diferentes modelos Word
- Automatizando a Análise e Classificação de Notas de Alunos com Spire.Agent.Office -- um fluxo de trabalho do lado do Excel que alimenta os documentos que este artigo gera
- Visão geral do produto Spire.Agent.Office -- SDKs de agente de IA para cada formato de documento Office
C#에서 Excel 데이터로 Word 문서 생성하기
Excel 데이터로 Word 문서 생성하기란 스프레드시트의 행을 하나 이상의 구조화된 Word 파일의 소스로 사용하는 것을 의미하며, 일반적으로 템플릿이나 문서 생성 워크플로우를 따릅니다. 전통적으로 이 작업은 Word의 '메일 머지(Mail Merge)' 기능을 통해 처리됩니다. 즉, Excel 열을 .docx 템플릿의 필드에 매핑하여 행당 하나의 문서를 생성하는 방식입니다. 동일한 작업을 C#에서 문서 SDK를 사용하여 자동화하거나, 요구사항을 자연어 지시사항으로 처리하는 AI 문서 에이전트를 활용하여 한 단계 더 발전시킬 수 있습니다. 이 기사에서는 이러한 경로들을 비교하고, 메일 머지의 한계점을 살펴본 뒤, Office 문서용 AI 에이전트 SDK인 Spire.Agent.Office를 기반으로 한 실용적인 C# 예제를 소개합니다.
빠른 탐색
- Excel 데이터로 Word 문서를 생성한다는 것은 무엇인가?
- Excel에서 Word로 메일 머지하기
- .NET에서 Word 생성을 자동화하는 세 가지 방법
- C#에서 Excel로 개인화된 Word 문서 생성하기
- 자주 묻는 질문(FAQ)
1. Excel 데이터로 Word 문서를 생성한다는 것은 무엇인가?
이 문구는 "Excel을 Word로 변환"하는 것과 비슷하게 들리지만, 의도는 다릅니다. .xlsx를 .docx로 변환하는 것은 파일 형식을 바꾸고 내용을 거의 그대로 유지하는 것입니다. 반면, Excel 데이터로 Word 문서를 생성하는 것은 스프레드시트의 셀에서 파생된 콘텐츠로 새로운 문서를 만드는 것입니다. 예를 들어 고객별 주문서, 지역별 월간 보고서, 주소록을 기반으로 한 편지나 라벨 배치, 주문 시트에서 생성된 송장 세트 등이 이에 해당합니다.
이 요구사항의 반복적인 형태는 거의 항상 동일합니다:
실제 문장으로 표현하면 다음과 같습니다: "Excel에 고객 목록과 주문 내역이 있습니다. 각 고객의 정보, 주문 품목, 총액이 포함된 Word 문서를 각각 만들어야 합니다." 여기서 중요한 단어는 파생된(derived)입니다. 문서 콘텐츠가 데이터에서 나오므로, 이는 단순한 형식 전환이 아닌 '데이터 기반 문서 생성'입니다.
이 기사는 바로 이러한 요구를 다룹니다. 아래 내용은 이를 충족하는 다양한 방법과, 더 이상 수동으로 필드를 연결해서는 안 되는 시점에 대해 설명합니다.
2. 전통적인 방식: 메일 머지(Mail Merge)
UI 수준에서 "이 Excel 목록을 여러 개의 Word 문서로 바꾸기"에 대한 기본 답변은 Word 메일 머지입니다. 이 작업을 검색할 때 대부분의 사람들이 생각하는 기능이며, Microsoft에서도 단계별 가이드를 제공합니다. 메커니즘은 간단하고 잘 알려져 있습니다:
편지 템플릿 안에 «CustomerName»과 같은 필드를 배치하고 Excel 소스의 Customer 열에 바인딩한 뒤 머지를 실행하면, Word가 각 행의 값을 대입하여 문서를 작성합니다. 행 수가 수천 개가 될 수 있기 때문에, "파일을 열고 텍스트를 복사하고 이름을 바꾸는" 작업을 코딩 없이 일괄 처리로 바꿔줍니다.
메일 머지는 "이 열을 저 필드에 여러 번 넣는" 작업에 최적화되어 있습니다. 고정된 레이아웃을 가진 편지, 봉투, 라벨, 통지서가 주 영역입니다. Office 내에서 실행되며 프로그래밍이 필요 없고, 필드만 사용하는 안정적인 문서에는 확실히 올바른 도구입니다.
3. 메일 머지의 한계
문서가 빈칸이 있는 고정된 양식에서 벗어나 데이터에 따라 달라져야 하는 순간 한계가 찾아옵니다. 메일 머지는 값을 대체할 뿐, 구조를 결정하거나 내용을 추론하거나 새로운 것을 구성하지 못합니다.
두 가지 요청을 비교해 보겠습니다. 첫 번째는 메일 머지가 처리하는 방식입니다:
"고객 이름을 이름 칸에, 주소를 주소 칸에, 주문 내역을 주문 상세 칸에 넣으세요."
두 번째는 실제 보고서에서 흔히 요구되는 방식입니다:
"이 Excel 통합 문서를 읽고, 각 고객의 데이터를 분석하여 품목과 총액이 포함된 개인화된 보고서를 만들고, 구매 패턴 요약을 추가한 뒤, 각 결과를 별도의 Word 문서로 저장하세요."
두 번째 요청은 메일 머지의 세 가지 가정 때문에 실패합니다:
- 구조가 가변적입니다. 품목이 3개인 고객과 30개인 고객은 문서 본문이 달라야 합니다. 머지 필드는 고정된 레이아웃과 빈칸을 가정하므로, 데이터가 요구하는 만큼 표의 행을 늘릴 수 없습니다.
- 내용은 복사가 아닌 계산이 필요합니다. "구매 패턴 요약"이나 "우수 고객 표시"는 어떤 열에도 존재하지 않는 텍스트와 판단을 생성합니다. 바인딩할 소스 필드가 없습니다.
- 출력물은 실제 파일들의 배치입니다. 각 레코드는 고유한 이름을 가진 별도의 Word 문서여야 하며, 워크플로우는 Office 마법사가 아닌 애플리케이션 내에서 무인으로 실행되어야 합니다.
이것이 메일 머지의 솔직한 위치입니다. 필드 매핑에는 탁월하지만, 문서 구조, 내용, 출력 로직이 데이터에 따라 달라져야 할 때는 적합하지 않습니다. 더 깊은 요구사항인 데이터를 문서로 바꾸는 것은 생성(Generation)의 문제이며, 아래의 자동화 경로가 시작되는 지점입니다.
4. 요구사항을 지시사항으로: 에이전트 방식
이 문제의 올바른 버전에 맞는 대안은 AI 문서 에이전트입니다. 이는 결정론적 문서 엔진 위에 자연어 레이어를 얹은 것입니다. 템플릿 필드와 필드별 코드를 일일이 나열하는 대신, 출력물을 설명하면 에이전트가 데이터 읽기, 구조 형성, 분석 작성 등 메일 머지로 표현하기 어려운 요구사항을 처리합니다. 동시에 문서 엔진은 잘 구성된 .docx(또는 PDF) 파일이 생성되도록 보장합니다.
그 가치는 체인 형태로 보면 더 쉽게 이해됩니다:
전통적인 메일 머지로 표현하기 어려운 단계들, 특히 중간의 세 단계는 에이전트가 제 역할을 하는 곳입니다. 에이전트는 열이 무엇을 의미하는지 해석하고("총액", "매출", "순액"이 같은 개념일 수 있음), 각 레코드에 맞게 문서 구조를 형성하며, 요약 단락을 구성할 수 있습니다. 여러분이 제공하는 것은 필드 맵이 아니라 문장입니다.
이 기사의 핵심 메시지는 다음과 같습니다: 메일 머지는 Excel 열을 Word 필드에 매핑하고, AI 에이전트는 요구사항으로부터 문서를 생성합니다. 전자는 값 대체 단계이고, 후자는 실제 요청사항을 수행하는 것입니다.
5. .NET에서 Word 생성을 자동화하는 세 가지 방법
각 경로마다 비용 곡선이 다르기 때문에 코드보다 올바른 경로를 선택하는 것이 더 중요합니다. 이 워크플로우가 필요한 .NET 애플리케이션의 현실적인 선택지는 다음과 같습니다:
| 접근 방식 | 필요한 것 | 유연성 | 최적의 용도 |
|---|---|---|---|
| Word 메일 머지 | 머지 필드가 포함된 .docx 템플릿 + Excel 소스; 머지 실행(또는 스크립트) | 열 하나를 필드 하나에 매핑; 가변 구조, 조건부 콘텐츠, 분석 불가 | 고정된 형태의 편지, 라벨, 봉투, 통지서 |
| SDK 필드 바인딩 | 코드에서 템플릿 로드, 통합 문서 열기, 행 루프, 레코드별 바인딩/찾기-바꾸기, 파일 저장 | 결정론적이고 테스트 가능; 열 맵과 레이아웃을 직접 유지 관리, 변경 시 재컴파일 필요 | 안정적인 문서 형태를 대규모로 반복 생성 |
| 자연어 AI 에이전트 | 통합 문서를 첨부 파일로 전달, 출력물 설명, 결과 읽기 | 가변 구조, 레코드별 분석, 조건부 섹션, 요약 처리 가능 | 데이터에 따라 달라지는 문서, 또는 매달 변경되는 워크플로우 |
대부분의 경우를 결정하는 지름길:
- 형태가 절대 변하지 않고, 열당 필드 하나, 대량 편지 발송 -- 메일 머지가 최고입니다.
- 형태는 변하지 않지만 코드로 제어해야 하고, 결정론적이며 테스트 가능해야 함 -- SDK 필드 바인딩 루프를 사용하세요.
- 문서가 데이터에 따라 달라져야 하거나, 분석이 포함되거나, 자주 변경됨 -- AI 에이전트가 비용 효율적입니다. 코드의 매핑 및 레이아웃 로직을 변경하는 대신 지시사항만 업데이트하면 되기 때문입니다.
6. C#에서 Excel로 개인화된 Word 문서 생성하기
"레코드당 하나의 Word 문서"라는 요구사항에 대한 구체적이고 작동하는 예시는 고객 주문 요약입니다. 입력값은 고객 주문 통합 문서와 가벼운 Word 템플릿이며, 출력값은 고객별 개인화된 문서입니다. 전체 설정(토큰, 패키지, 프로젝트 연결)은 시작하기(Getting Started) 튜토리얼에 문서화되어 있으며, 여기서는 생성 호출 자체에 집중합니다.
using Spire.Doc;
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;

AIOptions options = new AIOptions
{
    SpireToken = spireToken,
    WorkDir = @"C:\order-ops\output",   // 생성된 문서가 저장될 폴더
    TimeoutMs = 300000
};

using (Document doc = new Document())
{
    // 템플릿은 레코드별 앵커를 제공하고, 통합 문서는 데이터 소스입니다.
    doc.LoadFromFile(@"C:\order-ops\templates\order-summary-template.docx");

    // savePath = null: 하나의 지시사항이 레코드당 하나의 문서를 생성하여
    // WorkDir 출력 폴더에 저장합니다. 행에 대한 C# 루프가 필요 없습니다.
    AIResult result = doc.AI(options).ExecuteInstruction(
        doc,
        "Q3-orders.xlsx의 고객 주문 데이터를 읽으세요. 고객별로 독립적인 " +
        "Word 주문 요약서를 행 단위로 생성하세요. 연락처 정보, 수량과 금액이 포함된 " +
        "모든 품목, 주문 총액, 그리고 구매 패턴에 대한 한 단락의 요약을 포함하세요. " +
        "총액이 50,000을 초과하는 고객은 우수 고객으로 표시하세요. 각 문서를 " +
        "output_ 뒤에 고객 이름을 붙인 파일로 저장하세요 (예: " +
        "output_acme-order-summary.docx).",
        null,
        new[] { @"C:\order-ops\input\Q3-orders.xlsx" });

    if (result == null || !result.Success)
        throw new InvalidOperationException($"생성 실패: {result?.ErrorMessage}");
}
직접 실행할 때 세 가지 세부 사항이 중요합니다. 첫째, 지시사항에 생성 로직이 포함됩니다(분석, 조건부 로직, 레코드별 구조). 둘째, 통합 문서는 깔끔해야 합니다(첫 행은 헤더, 행당 하나의 레코드, 빈 행이나 병합된 헤더 셀 없음). 셋째, 기본 문서는 출력 레이아웃의 기준이 됩니다. 완전히 빈 기본 문서를 사용하면 동일한 지시사항으로 단일 구성 문서를 생성할 수 있습니다.
명명 규칙도 중요합니다. 에이전트가 WorkDir에 작성하는 문서는 output_ 접두사로 시작해야 하며, 그렇지 않으면 SDK는 이를 생성된 파일로 간주하지 않습니다.
저장 대상이나 파일 패턴의 .docx 확장자가 출력 형식을 결정합니다. 동일한 지시사항을 .pdf로 지정하면 에이전트가 별도의 렌더링 단계 없이 배포용으로 동일한 문서를 내보냅니다.
주요 API 호출
Document.AI(options)-- AI 문서 프로세서를 Word 문서 객체에 연결ExecuteInstruction(doc, instruction, savePath, attachments)-- 생성 실행;savePath가null이면WorkDir에 저장하며, 통합 문서는attachmentPaths에 포함됨AIResult.Success/AIResult.ErrorMessage-- 실행 확인 및 실패 처리
7. 에이전트 없이 구현할 경우
대조적으로, 동일한 작업에 대한 SDK 필드 바인딩 경로는 모든 것을 명시적으로 수행합니다. 다음은 애플리케이션 로직의 양을 보여주기 위해 의도적으로 단순화된 예시입니다:
using Spire.Doc;
using Spire.Xls;

// 고정된 형태는 괜찮지만, 변경될 때마다 더 많은 코딩이 필요합니다.
foreach (DataRow row in customersTable.Rows)
{
    using (Document doc = new Document())
    {
        doc.LoadFromFile(@"templates\order-summary-template.docx");

        // 앵커별 찾기-바꾸기...
        doc.Replace("{{CustomerName}}", row["Customer"].ToString(), true, true);
        doc.Replace("{{TotalAmount}}", row["Amount"].ToString("C"), true, true);

        // 품목은 두 번째 시트에 있음: 고객별로 직접 조인하고,
        // 표를 만들고, 책갈피에 삽입해야 함...
        // "우수 고객 표시" 규칙은 직접 유지 관리하는 if/else이며,
        // 고객별 요약 단락은 직접 작성해야 하는 템플릿임.
        doc.SaveToFile($@"out\{row["Customer"]}-order-summary.docx");
    }
    // ... 새로운 규칙, 열, 레이아웃 변경마다 이 코드를 수정하고 재컴파일해야 함.
}
에이전트가 코드의 필요성을 없애는 것은 아니지만, 매핑 및 레이아웃 코드의 필요성을 없애줍니다. 차이점은 로직이 어디에 있느냐입니다. 비즈니스 규칙이나 문서 구조가 자주 변경될 때, 자연어 접근 방식은 유지 관리해야 할 매핑 및 레이아웃 코드의 양을 줄일 수 있습니다.
8. AI의 역할과 애플리케이션 로직의 경계
유용한 경계는 "AI가 할 수 있는 것과 없는 것"이 아니라 애플리케이션이 계속 소유해야 할 것입니다. 문서 생성 에이전트는 결정론적 코드 위에 위치하며, 이를 대체하지 않습니다.
애플리케이션은 여전히 스프레드시트 이해와 관련 없는 부분을 소유합니다:
- 파일 탐색 및 액세스 -- 통합 문서 찾기, 권한 확인, 입력 준비
- 워크플로우 스케줄링 -- 작업 실행 시점, 트리거, 순서
- 데이터 소스 제어 -- 승인된 입력 통합 문서가 무엇인지 확인
- 오류 처리 및 재시도 -- 파일이 없거나 실행 실패 시 처리
- 최종 승인 -- 배포 전 사람이 생성된 문서를 검토
에이전트는 의미론적 단계를 처리합니다:
- 이해 -- 다양한 통합 문서에서 각 열이 무엇을 의미하는지 읽기
- 구조 계획 -- 문서에 필요한 섹션과 행 수 결정
- 분석 -- 주문 데이터를 요약 및 우수 고객 플래그로 변환
- 구성 -- 요구사항으로부터 개인화된 Word 문서 조립
결정론적 배관(plumbing)은 테스트 및 감사가 가능한 코드에 유지하고, 의미론적 생성은 에이전트에게 맡기십시오. 각 측면은 자신이 잘하는 일을 수행합니다.
9. 자주 묻는 질문(FAQ)
이것이 Word 메일 머지를 대체하나요?
완벽한 대체제라기보다는 동일한 작업을 더 발전시킨 것입니다. 메일 머지는 Excel 열을 고정된 Word 필드에 매핑하며, 이는 안정적인 형태의 편지에 충분합니다. AI 에이전트는 그 기능은 물론, 콘텐츠별로 통합 문서를 읽고, 레코드별로 구조를 형성하며, 분석을 추가하고, 산문을 구성할 수 있습니다. 단순한 고정 형태 출력에는 메일 머지가 여전히 좋은 도구이며, 문서가 데이터에 따라 달라져야 할 때 에이전트가 더 많은 역할을 수행합니다.
Excel 데이터에서 여러 개의 Word 문서를 어떻게 생성하나요?
통합 문서를 첨부 파일로 전달하고, 저장 경로를 null로 설정한 뒤 AIOptions.WorkDir을 출력 폴더로 지정하십시오. 행별 지시사항이 포함된 ExecuteInstruction 하나로 에이전트가 레코드당 독립적인 문서를 생성하여 해당 폴더에 저장합니다. 레코드별 배치를 위해 행에 대한 C# 루프를 작성할 필요가 없습니다.
메일 머지를 사용하지 않고 Excel에서 Word 문서를 생성할 수 있나요?
네. C#에서 SDK로 템플릿을 직접 바인딩하거나, 자연어 지시사항으로 통합 문서를 읽는 AI 에이전트에 전달하여 .docx 또는 PDF를 받을 수 있습니다. 메일 머지는 하나의 경로일 뿐이며, 문서에 분석이나 조건부 섹션이 필요할 때 가장 유연성이 떨어집니다.
메일 머지와 AI 문서 생성의 차이점은 무엇인가요?
메일 머지는 정의된 필드를 정의된 열에 바인딩합니다(Excel 열 입력 -> Word 필드 출력). AI 문서 생성은 요청과 데이터를 함께 해석하므로 각 열의 의미를 파악하고 그에 따라 문서 구조를 형성하며, 조건부 또는 분석적 콘텐츠를 생성하고, 하나의 지시사항으로 여러 문서를 조립할 수 있습니다. 전자는 매핑 단계이고, 후자는 생성 작업입니다.
C#에서 Excel 파일로 개인화된 Word 문서를 생성할 수 있나요?
네. Word 템플릿이나 빈 문서를 Spire.Doc에 로드하고, Excel 통합 문서를 첨부한 뒤 개인화된 출력물에 대한 설명과 함께 ExecuteInstruction을 호출하십시오. 에이전트가 각 레코드를 읽고 그에 맞게 조정된 문서를 구성하여 레코드별로 저장하거나 하나의 결합된 파일로 저장합니다.
AI 에이전트가 Excel 데이터를 사용하여 Word 문서를 생성할 수 있나요?
네. Spire.Agent.Office는 언어 모델과 결정론적인 Word 및 Excel 레이어를 결합하므로, 지시사항이 이해되고 결과물은 팀이 열고 형식화하고 배포할 수 있는 실제 Word 파일이 됩니다. 에이전트는 고정된 열 매핑에 의존하는 대신 스프레드시트의 콘텐츠를 해석하므로 이기종 입력도 처리할 수 있습니다.
Word 생성 자동화를 시작할 준비가 되셨나요?
워크플로우가 "Excel 데이터가 개인화된 Word 문서로 변환"되는 것이라면, 가장 빠른 경로는 출력물을 설명하고 에이전트가 나머지를 처리하게 하는 것입니다. 시작하기(Getting Started) 튜토리얼을 따라 .NET에서 첫 번째 지시사항 기반 Word 워크플로우를 실행해 보십시오.
추가 읽기
- Spire.Agent.Office로 다양한 Word 템플릿 생성하기 -- 다양한 Word 템플릿에 적용된 동일한 생성 패턴
- Spire.Agent.Office로 학생 성적 분석 및 순위 자동화하기 -- 이 기사에서 생성하는 문서에 데이터를 공급하는 Excel 측 워크플로우
- Spire.Agent.Office 제품 개요 -- 모든 Office 문서 형식을 위한 AI 에이전트 SDK
Generare documenti Word da dati Excel in C#
Indice
Generare documenti Word da dati Excel significa utilizzare le righe di un foglio di calcolo come origine per uno o più file Word strutturati, solitamente seguendo un modello o un flusso di lavoro di generazione documentale. Tradizionalmente, questo compito viene gestito con la Stampa unione di Word: si mappano le colonne di Excel ai campi in un modello .docx e si lascia che Word generi un documento per ogni riga. Lo stesso compito può essere automatizzato in C# con un SDK per documenti, o spinto oltre con un agente IA per documenti che interpreta il requisito come un'istruzione in linguaggio naturale. Questo articolo confronta i vari percorsi, mostra dove la stampa unione incontra i suoi limiti e illustra un esempio pratico in C# basato su Spire.Agent.Office, un SDK di agenti IA per documenti Office.
Navigazione rapida
- Cosa significa generare documenti Word da dati Excel?
- Stampa unione da Excel a Word
- Tre modi per automatizzare la generazione di Word da Excel in .NET
- Generare documenti Word personalizzati da Excel in C#
- FAQ
1. Cosa significa generare documenti Word da dati Excel?
La frase suona simile a "convertire Excel in Word", ma l'intento è diverso. Convertire un file .xlsx in .docx modifica il formato mantenendo il contenuto pressoché invariato. Generare documenti Word da dati Excel significa creare nuovi documenti il cui contenuto deriva dalle celle di un foglio di calcolo: un foglio d'ordine per cliente, un report mensile per regione, un lotto di lettere o etichette da una lista di indirizzi, una serie di fatture da un foglio ordini.
La struttura ricorrente del requisito è quasi sempre la stessa:
Espresso come frase reale suona così: "Ho una lista di clienti e i loro ordini in Excel; ho bisogno di un documento Word per ciascuno con le loro informazioni, i loro articoli e un totale". La parola chiave è derivato: il contenuto del documento proviene dai dati, quindi si tratta di una generazione da dati a documento, non di un semplice cambio di formato.
Questa è la richiesta a cui si rivolge questo articolo. Tutto ciò che segue riguarda i diversi modi per soddisfarla e il punto in cui dovresti smettere di collegare i campi manualmente.
2. Il metodo tradizionale: Stampa unione da Excel a Word
A livello di interfaccia utente, la risposta predefinita alla domanda "trasforma questa lista Excel in molti documenti Word" è la Stampa unione di Word. È la funzionalità a cui la maggior parte delle persone pensa quando cerca una soluzione, e Microsoft fornisce una guida passo-passo. Il meccanismo è semplice e ben noto:
Inserisci un campo come «NomeCliente» all'interno di un modello di lettera, lo colleghi alla colonna Cliente della sorgente Excel, avvii l'unione e Word scrive un documento per riga con quel valore sostituito. Poiché il numero di righe può essere di migliaia, trasforma l'operazione "apri un file, copia il testo, cambia il nome" in un'operazione batch senza scrivere codice.
La stampa unione è ottima per un unico tipo di lavoro: inserire questa colonna in quel campo, molte volte. Lettere, buste, etichette e avvisi con un layout fisso sono il suo campo d'azione. Funziona all'interno di Office, non richiede programmazione e, per quei documenti stabili basati solo su campi, è davvero lo strumento giusto.
3. Quando la stampa unione raggiunge i suoi limiti
Il limite arriva nel momento in cui il documento smette di essere un modulo fisso con spazi vuoti e diventa qualcosa che deve dipendere dai dati. La stampa unione sostituisce i valori; non decide la struttura, non ragiona sul contenuto e non compone nulla di nuovo.
Confrontiamo due richieste. La prima è ciò che la stampa unione gestisce:
"Inserisci il nome del cliente nello spazio del nome, l'indirizzo nello spazio dell'indirizzo e l'ordine nei dettagli dell'ordine."
La seconda è la richiesta che la maggior parte dei report reali finisce per essere:
"Leggi questa cartella di lavoro Excel, analizza i dati di ogni cliente, crea un report personalizzato con i loro articoli e totali, aggiungi un riepilogo del loro modello di acquisto e salva ogni risultato come un documento Word separato."
La seconda richiesta fallisce su tutti e tre i presupposti della stampa unione:
- La struttura varia. Un cliente con tre articoli ha bisogno di un corpo del documento diverso da uno con trenta. I campi di unione presuppongono un layout fisso con spazi vuoti fissi; non espandono una tabella per tante righe quante ne richiedono i dati.
- Il contenuto deve essere calcolato, non copiato. "Riassumi il modello di acquisto" e "segnala i clienti ad alto valore" producono testo e decisioni che nessuna colonna contiene. Non c'è un campo sorgente a cui collegarli.
- L'output è un lotto di file reali. Ogni record dovrebbe essere il proprio documento Word con il proprio nome, e il flusso di lavoro dovrebbe essere eseguito in modo non presidiato all'interno di un'applicazione, non da una procedura guidata di Office.
Questa è l'onesta posizione della stampa unione: è eccellente nella mappatura dei campi, ma diventa meno adatta quando la struttura del documento, il contenuto o la logica di output devono variare con i dati. Il requisito più profondo — trasformare i dati in documenti — è un problema di generazione, ed è qui che iniziano i percorsi di automazione seguenti.
4. Trasformare il requisito in un'istruzione: l'approccio basato su agenti
L'alternativa che si adatta alla versione corretta del problema è un agente IA per documenti: un livello di linguaggio naturale sopra un motore documentale deterministico. Invece di enumerare i campi del modello e scrivere codice per ogni campo, descrivi l'output e l'agente può gestire requisiti difficili da esprimere con la tradizionale stampa unione — leggere i dati, modellare la struttura, scrivere l'analisi — mentre il motore documentale garantisce che ne esca un .docx (o PDF) reale e ben formato.
Il valore è più facile da vedere come una catena:
I passaggi difficili da esprimere con la stampa unione tradizionale — specialmente i tre centrali — sono esattamente dove un agente può dimostrare il suo valore. Può interpretare cosa significa una colonna ("Importo Totale", "Vendite" e "Netto" possono indicare lo stesso concetto sotto tre intestazioni diverse), modellare la struttura del documento per ogni record e comporre i paragrafi di riepilogo. Ciò che fornisci è una frase, non una mappatura di campi.
Il messaggio da portare nel resto di questo articolo: la stampa unione mappa le colonne Excel ai campi Word; un agente IA genera documenti da un requisito. Il primo è un passaggio di sostituzione valori, il secondo è ciò che la richiesta era in realtà.
5. Tre modi per automatizzare la generazione di Word da Excel in .NET
Scegliere il percorso giusto conta più del codice, perché ogni percorso ha una curva di costo diversa. Per un'applicazione .NET che necessita di questo flusso di lavoro, le scelte realistiche sono:
| Approccio | Cosa richiede | Flessibilità | Ideale per |
|---|---|---|---|
| Stampa unione Word | Un modello .docx con campi di unione + una sorgente Excel; esegui l'unione (o scriptala) | Mappa una colonna a un campo; si blocca su strutture variabili, contenuti condizionali, analisi | Lettere, etichette, buste, avvisi con forma fissa |
| Binding dei campi SDK | Carica il modello nel codice, apri la cartella di lavoro, cicla le righe, associa/trova-sostituisci per record, salva ogni file | Deterministico e testabile; mantieni manualmente la mappa delle colonne e il layout, ogni modifica richiede ricompilazione | Ripetere una forma di documento stabile su larga scala |
| Agente IA in linguaggio naturale | Passa la cartella di lavoro come allegato, descrivi l'output, leggi il risultato | Gestisce struttura variabile, analisi per record, sezioni condizionali, riepiloghi | Documenti che variano con i dati o flussi di lavoro che cambiano di mese in mese |
Una scorciatoia che risolve la maggior parte dei casi:
- La forma non cambia mai, un campo per colonna, lettere in blocco — la stampa unione è difficile da battere.
- La forma non cambia mai ma serve nel codice, deterministico e testabile — usa un ciclo di binding dei campi SDK.
- Il documento deve variare con i dati, includere analisi o cambiare spesso — è qui che un agente IA si ripaga, perché il costo di una modifica può spesso essere ridotto all'aggiornamento dell'istruzione piuttosto che alla modifica della logica di mappatura e layout nel codice.
6. Generare documenti Word personalizzati da Excel in C#
Una versione concreta e funzionante del requisito "un documento Word per record" è un riepilogo degli ordini cliente. Gli input sono una cartella di lavoro di ordini cliente e un leggero modello Word; l'output è un documento personalizzato per cliente. La configurazione completa — token, pacchetto e cablaggio del progetto — è documentata nel tutorial Getting Started; qui ci concentriamo sulla chiamata di generazione stessa.
using Spire.Doc;
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;

AIOptions options = new AIOptions
{
    SpireToken = spireToken,
    WorkDir = @"C:\order-ops\output",   // cartella in cui vengono scritti i documenti generati
    TimeoutMs = 300000
};

using (Document doc = new Document())
{
    // Il modello fornisce ancoraggi per record; la cartella di lavoro è la sorgente dati.
    doc.LoadFromFile(@"C:\order-ops\templates\order-summary-template.docx");

    // savePath = null: un'istruzione produce un documento per record,
    // scritto nella cartella di output WorkDir. Nessun ciclo C# sulle righe.
    AIResult result = doc.AI(options).ExecuteInstruction(
        doc,
        "Leggi i dati degli ordini cliente in Q3-orders.xlsx. Genera un riepilogo " +
        "ordine Word indipendente per cliente, riga per riga. Includi le loro informazioni " +
        "di contatto, ogni articolo con quantità e importo, i totali dell'ordine, " +
        "e un riepilogo di un paragrafo del loro modello di acquisto. Segnala i clienti " +
        "il cui totale supera 50.000 come alto valore. Salva ogni documento come un file " +
        "proprio chiamato output_ seguito dal nome del cliente (ad esempio " +
        "output_acme-order-summary.docx).",
        null,
        new[] { @"C:\order-ops\input\Q3-orders.xlsx" });

    if (result == null || !result.Success)
        throw new InvalidOperationException($"Generazione fallita: {result?.ErrorMessage}");
}
Tre dettagli contano quando lo esegui tu stesso. Primo, l'istruzione è dove risiede la logica di generazione: l'analisi ("riepilogo del loro modello di acquisto"), la logica condizionale ("segnala i clienti sopra 50.000") e la struttura per record ("ogni articolo"). Secondo, la cartella di lavoro dovrebbe essere ordinata: la prima riga è l'intestazione, un record per riga, nessuna riga vuota o celle di intestazione unite — le stesse regole che si aspetta la sorgente dati di Word. Terzo, il documento base ancora il layout di output; uno leggermente strutturato può dare all'agente un punto di partenza utile per la struttura di ogni record. Con un documento base completamente vuoto, la stessa istruzione produce un singolo documento composto.
Una regola di denominazione conta qui: i documenti che l'agente scrive in WorkDir devono iniziare con il prefisso output_, altrimenti l'SDK non li conta come file generati. Ecco perché l'istruzione sopra richiede file come output_acme-order-summary.docx invece dei soli nomi dei clienti.
L'estensione .docx sul tuo target di salvataggio o pattern di file sceglie il formato di output; punta la stessa istruzione a .pdf e l'agente esporta gli identici documenti per la distribuzione, senza alcun passaggio di rendering separato.
Chiamate API chiave
Document.AI(options)-- collega il processore di documenti IA a un oggetto documento WordExecuteInstruction(doc, instruction, savePath, attachments)-- esegue la generazione;savePathnullo significa "scrivi inWorkDir", e la cartella di lavoro viaggia inattachmentPathsAIResult.Success/AIResult.ErrorMessage-- verifica l'esecuzione e fa emergere i fallimenti
7. Cosa scriveresti senza un agente
Per contrasto, il percorso di binding dei campi SDK per lo stesso lavoro fa tutto esplicitamente. Il seguente esempio è intenzionalmente semplificato per mostrare la quantità di logica applicativa coinvolta; un'implementazione di produzione dovrebbe anche caricare e raggruppare i dati della cartella di lavoro:
using Spire.Doc;
using Spire.Xls;

// Una forma fissa va bene; ogni variazione è più cablaggio.
foreach (DataRow row in customersTable.Rows)
{
    using (Document doc = new Document())
    {
        doc.LoadFromFile(@"templates\order-summary-template.docx");

        // Trova-e-sostituisci per ancoraggio...
        doc.Replace("{{CustomerName}}", row["Customer"].ToString(), true, true);
        doc.Replace("{{TotalAmount}}", row["Amount"].ToString("C"), true, true);

        // Gli articoli vivono in un secondo foglio: li unisci manualmente per cliente,
        // costruisci una tabella e la inserisci in un segnalibro...
        // La regola "segnala clienti ad alto valore" è un if/else che mantieni,
        // e il paragrafo di riepilogo per cliente è un modello che scrivi a mano.
        doc.SaveToFile($@"out\{row["Customer"]}-order-summary.docx");
    }
    // ... e ogni nuova regola, colonna o modifica di layout significa modificare questo e ricompilare.
}
L'agente non rimuove la necessità di codice — rimuove la necessità di codice di mappatura e layout. La differenza è dove risiede la logica: in un indice di colonna e un trova-e-sostituisci, o in una frase che l'azienda può leggere e modificare. Quando le regole aziendali o le strutture dei documenti cambiano frequentemente, l'approccio in linguaggio naturale può ridurre la quantità di codice di mappatura e layout che deve essere mantenuto. Il pattern modello-più-dati si scala oltre i riepiloghi d'ordine: Generazione di contratti in batch con Spire.Agent.Office percorre lo stesso flusso di un'istruzione, un documento per record applicato ai contratti.
8. Dove finisce l'IA e inizia la logica applicativa
Un confine utile non è "cosa l'IA può e non può fare" ma cosa l'applicazione dovrebbe continuare a possedere. Un agente di generazione documentale si trova sopra il codice deterministico; non lo sostituisce.
La tua applicazione possiede ancora le parti che non hanno nulla a che fare con la comprensione del foglio di calcolo:
- Scoperta e accesso ai file — trovare la cartella di lavoro, controllare i permessi, preparare gli input
- Pianificazione del flusso di lavoro — quando il lavoro viene eseguito, su quale trigger, in quale ordine
- Controllo della sorgente dati — quale cartella di lavoro è un input autorizzato e da dove proviene
- Gestione degli errori e tentativi — cosa succede quando un file manca o un'esecuzione fallisce
- Approvazione finale — un umano rivede i documenti generati prima che vengano spediti
L'agente gestisce i passaggi semantici:
- Comprensione — leggere cosa significa ogni colonna da diverse cartelle di lavoro
- Pianificazione della struttura — determinare di quante sezioni e righe ha bisogno il documento
- Analisi — trasformare i dati dell'ordine in un riepilogo e un flag di alto valore
- Composizione — assemblare documenti Word personalizzati dal requisito
Mantieni l'idraulica deterministica nel codice, dove è testabile e verificabile, e consegna la generazione semantica all'agente. Ogni parte fa ciò in cui è brava. Revisione contratti IA in C# mostra la stessa divisione dall'altro lato: l'agente gestisce il passaggio semantico di revisione del contenuto di un documento mentre l'applicazione mantiene la gestione deterministica dei file attorno ad esso.
9. FAQ
È un sostituto per la stampa unione di Word?
Non un sostituto diretto; è lo stesso lavoro portato oltre. La stampa unione mappa le colonne Excel in campi Word fissi, il che è sufficiente per una lettera con una forma stabile. Un agente IA può fare anche quello, e può anche leggere la cartella di lavoro per contenuto, modellare la struttura per record, aggiungere analisi e comporre prosa. Per semplici output a forma fissa, la stampa unione rimane uno strumento valido; quando il documento deve variare con i dati, l'agente svolge gran parte del lavoro.
Come genero più documenti Word da dati Excel?
Passa la cartella di lavoro come allegato, imposta il percorso di salvataggio su nullo e punta AIOptions.WorkDir a una cartella di output. Un ExecuteInstruction con un'istruzione riga per riga fa sì che l'agente produca un documento indipendente per record, ciascuno salvato in quella cartella. Non è necessario alcun ciclo C# sulle righe per il batch per record.
Posso generare documenti Word da Excel senza usare la Stampa unione?
Sì. In C# puoi collegare un modello con l'SDK direttamente, o consegnare la cartella di lavoro a un agente IA che la legge da un'istruzione in linguaggio naturale, e ricevere un .docx o PDF reale in cambio. La stampa unione è un percorso, non l'unico, ed è il meno flessibile una volta che il documento necessita di analisi o sezioni condizionali.
Qual è la differenza tra Stampa unione e generazione documentale IA?
La stampa unione collega campi definiti a colonne definite: colonna Excel in entrata, campo Word in uscita. La generazione documentale IA interpreta la richiesta e i dati insieme, quindi può interpretare cosa significa ogni colonna e modellare la struttura del documento di conseguenza, produrre contenuti condizionali o analitici e assemblare diversi documenti da un'unica istruzione. Il primo è un passaggio di mappatura; il secondo è un compito di generazione.
Posso generare documenti Word personalizzati da un file Excel in C#?
Sì. Carica un modello Word o un documento vuoto in Spire.Doc, allega la cartella di lavoro Excel e chiama ExecuteInstruction con una descrizione dell'output personalizzato. L'agente legge ogni record e compone un documento sintonizzato su di esso, salvato per record o come un unico file combinato, tutto all'interno della tua applicazione .NET.
Un agente IA può usare dati Excel per generare documenti Word?
Sì. Spire.Agent.Office abbina un modello linguistico a un livello deterministico Word ed Excel, quindi l'istruzione viene compresa e il risultato è comunque un file Word reale che il tuo team può aprire, formattare e distribuire. L'agente interpreta il contenuto del foglio di calcolo piuttosto che fare affidamento su una mappatura di colonne fissa, il che è ciò che fa funzionare gli input eterogenei.
Pronto ad automatizzare la tua generazione di Word?
Se il tuo flusso di lavoro è "i dati Excel diventano documenti Word personalizzati", il percorso più veloce è descrivere l'output e lasciare che l'agente gestisca il resto. Segui il tutorial Getting Started per eseguire il tuo primo flusso di lavoro Word guidato da istruzioni in .NET.
Ulteriori letture
- Genera vari modelli Word con Spire.Agent.Office -- lo stesso pattern di generazione applicato a diversi modelli Word
- Automatizzare l'analisi e la classificazione dei punteggi degli studenti con Spire.Agent.Office -- un flusso di lavoro lato Excel che alimenta i documenti che questo articolo genera
- Panoramica del prodotto Spire.Agent.Office -- SDK di agenti IA per ogni formato di documento Office
Générer des documents Word à partir de données Excel en C#
Table des matières
Générer des documents Word à partir de données Excel signifie utiliser les lignes d'un tableur comme source pour un ou plusieurs fichiers Word structurés, généralement en suivant un modèle ou un flux de travail de génération de documents. Traditionnellement, cette tâche est gérée par le publipostage Word : vous mappez les colonnes Excel vers des champs dans un modèle .docx et laissez Word générer un document par ligne. La même tâche peut être automatisée en C# avec un SDK de document, ou poussée plus loin avec un agent documentaire IA qui traite la demande comme une instruction en langage naturel. Cet article compare les approches, montre où le publipostage atteint ses limites et présente un exemple C# fonctionnel basé sur Spire.Agent.Office, un SDK d'agent IA pour les documents Office.
Navigation rapide
- Que signifie générer des documents Word à partir d'Excel ?
- Le publipostage d'Excel vers Word
- Trois méthodes d'automatisation de la génération Word depuis Excel en .NET
- Générer des documents Word personnalisés depuis Excel en C#
- FAQ
1. Que signifie générer des documents Word à partir de données Excel ?
L'expression ressemble à « convertir Excel en Word », mais l'intention est différente. Convertir un fichier .xlsx en .docx modifie le format du fichier tout en conservant son contenu globalement identique. Générer des documents Word à partir de données Excel consiste à créer de nouveaux documents dont le contenu est dérivé de cellules d'un tableur : une fiche de commande par client, un rapport mensuel par région, un lot de lettres ou d'étiquettes à partir d'une liste d'adresses, ou un ensemble de factures à partir d'une feuille de commandes.
La structure récurrente du besoin est presque toujours la même :
Exprimé en langage courant, cela donne : « J'ai une liste de clients et leurs commandes dans Excel ; j'ai besoin d'un document Word pour chacun d'eux avec leurs informations, leurs articles et un total. » Le mot important est dérivé : le contenu du document provient des données, il s'agit donc d'une génération de données vers document, et non d'un simple changement de format.
C'est la demande que cet article traite. Tout ce qui suit concerne les différentes manières d'y répondre et le moment où vous devriez cesser de configurer les champs manuellement.
2. La méthode traditionnelle : le publipostage d'Excel vers Word
Au niveau de l'interface utilisateur, la réponse par défaut à « transformer cette liste Excel en plusieurs documents Word » est le publipostage Word. C'est la fonctionnalité à laquelle la plupart des gens pensent lorsqu'ils recherchent cette tâche, et Microsoft propose un guide étape par étape. Le mécanisme est simple et bien connu :
Vous placez un champ comme «NomClient» dans un modèle de lettre, vous le liez à la colonne Client de la source Excel, vous lancez la fusion, et Word écrit un document par ligne avec la valeur substituée. Comme le nombre de lignes peut se compter par milliers, cela transforme une tâche de « ouvrir un fichier, copier le texte, changer le nom » en une opération par lots sans aucun code.
Le publipostage est efficace pour un seul type de travail : insérer cette colonne dans ce champ, à plusieurs reprises. Les lettres, enveloppes, étiquettes et avis avec une mise en page fixe sont son domaine de prédilection. Il s'exécute dans Office, ne nécessite aucune programmation, et pour ces documents stables et basés uniquement sur des champs, c'est réellement l'outil approprié.
3. Les limites du publipostage
La limite est atteinte dès que le document cesse d'être un formulaire fixe avec des espaces vides pour devenir quelque chose qui doit dépendre des données. Le publipostage substitue des valeurs ; il ne décide pas de la structure, ne raisonne pas sur le contenu et ne compose rien de nouveau.
Comparez deux demandes. La première est ce que le publipostage gère :
« Mettez le nom du client à l'endroit prévu, l'adresse à l'endroit prévu, et la commande dans les détails de la commande. »
La seconde est la demande correspondant à la plupart des rapports réels :
« Lisez ce classeur Excel, analysez les données de chaque client, créez un rapport personnalisé avec leurs articles et totaux, ajoutez un résumé de leur comportement d'achat, et enregistrez chaque résultat sous forme de document Word distinct. »
La seconde demande échoue sur les trois hypothèses du publipostage :
- La structure varie. Un client avec trois articles a besoin d'un corps de document différent de celui d'un client avec trente articles. Les champs de fusion supposent une mise en page fixe avec des espaces vides fixes ; ils ne peuvent pas agrandir un tableau en fonction du nombre de lignes de données.
- Le contenu doit être calculé, pas copié. « Résumer le comportement d'achat » et « signaler les clients à forte valeur » produisent du texte et des décisions qu'aucune colonne ne contient. Il n'y a pas de champ source auquel les lier.
- La sortie est un lot de fichiers réels. Chaque enregistrement doit être son propre document Word avec son propre nom, et le flux de travail doit s'exécuter sans surveillance dans une application, et non depuis un assistant Office.
C'est la position honnête du publipostage, énoncée clairement : il est excellent pour le mappage de champs, mais devient moins adapté lorsque la structure du document, le contenu ou la logique de sortie doivent varier en fonction des données. Le besoin plus profond — transformer des données en documents — est un problème de génération, et c'est là que les méthodes d'automatisation ci-dessous entrent en jeu.
4. Transformer le besoin en instruction : l'approche par agent
L'alternative qui correspond à la vraie version du problème est un agent documentaire IA : une couche de langage naturel au-dessus d'un moteur de document déterministe. Au lieu d'énumérer des champs de modèle et du code par champ, vous décrivez la sortie, et l'agent peut gérer des exigences difficiles à exprimer avec un publipostage traditionnel — lire les données, façonner la structure, rédiger l'analyse — tandis que le moteur de document garantit qu'un fichier .docx (ou PDF) réel et bien formé est produit.
La valeur est plus facile à visualiser sous forme de chaîne :
Les étapes difficiles à exprimer avec un publipostage traditionnel — surtout les trois étapes intermédiaires — sont précisément là où un agent peut faire ses preuves. Il peut interpréter ce qu'une colonne signifie (« Montant total », « Ventes » et « Net » peuvent désigner le même concept sous trois en-têtes différents), adapter la structure du document à chaque enregistrement et composer les paragraphes de résumé. Ce que vous fournissez est une phrase, pas un mappage de champs.
Le message à retenir pour le reste de cet article : le publipostage mappe des colonnes Excel vers des champs Word ; un agent IA génère des documents à partir d'une exigence. Le premier est une étape de substitution de valeur, le second est ce que la demande était réellement.
5. Trois méthodes d'automatisation de la génération Word depuis Excel en .NET
Choisir la bonne approche compte plus que le code, car chaque approche a une courbe de coût différente. Pour une application .NET nécessitant ce flux de travail, les choix réalistes sont :
| Approche | Ce que cela implique | Flexibilité | Idéal pour |
|---|---|---|---|
| Publipostage Word | Un modèle .docx avec des champs de fusion + une source Excel ; exécuter la fusion (ou la scripter) | Mappe une colonne vers un champ ; bloque sur les structures variables, le contenu conditionnel, l'analyse | Lettres, étiquettes, enveloppes, avis avec une forme fixe |
| Liaison de champs par SDK | Charger le modèle en code, ouvrir le classeur, boucler sur les lignes, lier/remplacer par enregistrement, enregistrer chaque fichier | Déterministe et testable ; vous maintenez manuellement le mappage des colonnes et la mise en page, chaque changement nécessite une recompilation | Répéter une forme de document stable à grande échelle |
| Agent IA en langage naturel | Passer le classeur en pièce jointe, décrire la sortie, lire le résultat | Gère les structures variables, l'analyse par enregistrement, les sections conditionnelles, les résumés | Documents qui varient selon les données, ou flux de travail qui changent d'un mois à l'autre |
Un raccourci pour décider dans la plupart des cas :
- La forme ne change jamais, un champ par colonne, lettres en masse — le publipostage est difficile à battre.
- La forme ne change jamais mais vous avez besoin de code, déterministe et testable — utilisez une boucle de liaison de champs par SDK.
- Le document doit varier selon les données, inclure une analyse ou changer souvent — c'est là qu'un agent IA est rentable, car le coût d'un changement peut souvent être réduit à la mise à jour de l'instruction plutôt qu'à la modification de la logique de mappage et de mise en page dans le code.
6. Générer des documents Word personnalisés depuis Excel en C#
Une version concrète et fonctionnelle du besoin « un document Word par enregistrement » est un résumé de commande client. Les entrées sont un classeur de commandes clients et un modèle Word léger ; la sortie est un document personnalisé par client. La configuration complète — jeton, package et câblage du projet — est documentée dans le tutoriel Démarrage ; ici, nous nous concentrons sur l'appel de génération lui-même.
using Spire.Doc;
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;

AIOptions options = new AIOptions
{
    SpireToken = spireToken,
    WorkDir = @"C:\order-ops\output",   // dossier où les documents générés sont écrits
    TimeoutMs = 300000
};

using (Document doc = new Document())
{
    // Le modèle fournit des ancres par enregistrement ; le classeur est la source de données.
    doc.LoadFromFile(@"C:\order-ops\templates\order-summary-template.docx");

    // savePath = null : une instruction produit un document par enregistrement,
    // écrit dans le dossier de sortie WorkDir. Pas de boucle C# sur les lignes.
    AIResult result = doc.AI(options).ExecuteInstruction(
        doc,
        "Lisez les données de commande client dans Q3-orders.xlsx. Générez un résumé " +
        "de commande Word indépendant par client, ligne par ligne. Incluez leurs informations " +
        "de contact, chaque article avec quantité et montant, les totaux de commande, " +
        "et un résumé d'un paragraphe sur leur comportement d'achat. Signalez les clients " +
        "dont le total dépasse 50 000 comme étant à haute valeur. Enregistrez chaque document " +
        "sous forme de fichier nommé output_ suivi du nom du client (par exemple " +
        "output_acme-order-summary.docx).",
        null,
        new[] { @"C:\order-ops\input\Q3-orders.xlsx" });

    if (result == null || !result.Success)
        throw new InvalidOperationException($"La génération a échoué : {result?.ErrorMessage}");
}
Trois détails comptent lorsque vous exécutez cela vous-même. Premièrement, l'instruction est l'endroit où réside la logique de génération : l'analyse (« résumé de leur comportement d'achat »), la logique conditionnelle (« signaler les clients au-dessus de 50 000 ») et la structure par enregistrement (« chaque article »). Deuxièmement, le classeur doit être propre : la première ligne est l'en-tête, un enregistrement par ligne, pas de lignes vides ou de cellules d'en-tête fusionnées — les mêmes règles que celles attendues par la source de données de Word. Troisièmement, le document de base ancre la mise en page de sortie ; un document légèrement structuré peut donner à l'agent un point de départ utile pour la structure de chaque enregistrement. Avec un document de base totalement vide, la même instruction produit un seul document composé.
Une règle de nommage est importante ici : les documents que l'agent écrit dans WorkDir doivent commencer par le préfixe output_, sinon le SDK ne les compte pas comme des fichiers générés. C'est pourquoi l'instruction ci-dessus demande des fichiers comme output_acme-order-summary.docx au lieu de simples noms de clients.
L'extension .docx sur votre cible d'enregistrement ou modèle de fichier choisit le format de sortie ; pointez la même instruction vers .pdf et l'agent exporte les documents identiques pour distribution, sans étape de rendu séparée.
Appels API clés
Document.AI(options)— attache le processeur de document IA à un objet document WordExecuteInstruction(doc, instruction, savePath, attachments)— exécute la génération ; unsavePathànullsignifie « écrire dansWorkDir», et le classeur est transmis dansattachmentPathsAIResult.Success/AIResult.ErrorMessage— vérifie l'exécution et fait remonter les erreurs
7. Ce que vous écririez sans agent
Par contraste, l'approche de liaison de champs par SDK pour le même travail fait tout explicitement. Ce qui suit est intentionnellement simplifié pour montrer la quantité de logique applicative impliquée ; une implémentation en production nécessiterait également de charger et de regrouper les données du classeur :
using Spire.Doc;
using Spire.Xls;

// Une forme fixe est correcte ; chaque variation demande plus de câblage.
foreach (DataRow row in customersTable.Rows)
{
    using (Document doc = new Document())
    {
        doc.LoadFromFile(@"templates\order-summary-template.docx");

        // Rechercher-remplacer par ancre...
        doc.Replace("{{CustomerName}}", row["Customer"].ToString(), true, true);
        doc.Replace("{{TotalAmount}}", row["Amount"].ToString("C"), true, true);

        // Les articles vivent dans une seconde feuille : vous les joignez manuellement par client,
        // construisez un tableau et l'insérez à un signet...
        // La règle « signaler les clients à haute valeur » est un if/else que vous maintenez,
        // et le paragraphe de résumé par client est un modèle que vous écrivez à la main.
        doc.SaveToFile($@"out\{row["Customer"]}-order-summary.docx");
    }
    // ... et chaque nouvelle règle, colonne ou changement de mise en page signifie modifier ceci et recompiler.
}
L'agent ne supprime pas le besoin de code — il supprime le besoin de code de mappage et de mise en page. La différence réside dans l'endroit où se trouve la logique : dans un index de colonne et un rechercher-remplacer, ou dans une phrase que l'entreprise peut lire et modifier. Lorsque les règles métier ou les structures de documents changent fréquemment, l'approche en langage naturel peut réduire la quantité de code de mappage et de mise en page à maintenir. Le modèle « modèle + données » s'étend au-delà des résumés de commande : Génération de contrats par lots avec Spire.Agent.Office parcourt le même flux « une instruction, un document par enregistrement » appliqué aux contrats.
8. Où l'IA s'arrête et où commence la logique applicative
Une frontière utile n'est pas « ce que l'IA peut ou ne peut pas faire » mais ce que l'application doit continuer à posséder. Un agent de génération de documents repose sur du code déterministe ; il ne le remplace pas.
Votre application possède toujours les parties qui n'ont rien à voir avec la compréhension du tableur :
- Découverte et accès aux fichiers — trouver le classeur, vérifier les autorisations, préparer les entrées
- Planification du flux de travail — quand le travail s'exécute, sur quel déclencheur, dans quel ordre
- Contrôle de la source de données — quel classeur est une entrée autorisée et d'où il provient
- Gestion des erreurs et tentatives — ce qui se passe lorsqu'un fichier est manquant ou qu'une exécution échoue
- Approbation finale — un humain examine les documents générés avant leur envoi
L'agent gère les étapes sémantiques :
- Compréhension — lire ce que chaque colonne signifie à partir de différents classeurs
- Planification de la structure — déterminer combien de sections et de lignes le document nécessite
- Analyse — transformer les données de commande en un résumé et un indicateur de haute valeur
- Composition — assembler des documents Word personnalisés à partir de l'exigence
Gardez la plomberie déterministe dans le code, où elle est testable et auditable, et confiez la génération sémantique à l'agent. Chaque côté fait ce pour quoi il est doué. Revue de contrat IA en C# montre la même séparation de l'autre côté : l'agent gère l'étape sémantique de la revue du contenu d'un document tandis que l'application conserve la gestion déterministe des fichiers autour.
9. FAQ
Est-ce un remplacement pour le publipostage Word ?
Pas un remplacement direct ; c'est le même travail poussé plus loin. Le publipostage mappe des colonnes Excel dans des champs Word fixes, ce qui suffit pour une lettre avec une forme stable. Un agent IA peut faire cela aussi, et peut également lire le classeur par contenu, façonner la structure par enregistrement, ajouter une analyse et composer de la prose. Pour des sorties simples à forme fixe, le publipostage reste un excellent outil ; lorsque le document doit varier selon les données, l'agent prend en charge une plus grande partie du travail.
Comment générer plusieurs documents Word à partir de données Excel ?
Passez le classeur en pièce jointe, définissez le chemin d'enregistrement sur null et pointez AIOptions.WorkDir vers un dossier de sortie. Une seule ExecuteInstruction avec une instruction ligne par ligne permet à l'agent de produire un document indépendant par enregistrement, chacun enregistré dans ce dossier. Aucune boucle C# sur les lignes n'est nécessaire pour le lot par enregistrement.
Puis-je générer des documents Word à partir d'Excel sans utiliser le publipostage ?
Oui. En C# vous pouvez lier un modèle avec le SDK directement, ou confier le classeur à un agent IA qui le lit à partir d'une instruction en langage naturel, et recevoir un vrai .docx ou PDF en retour. Le publipostage est une voie, pas la seule, et c'est la moins flexible une fois que le document nécessite une analyse ou des sections conditionnelles.
Quelle est la différence entre le publipostage et la génération de documents par IA ?
Le publipostage lie des champs définis à des colonnes définies : colonne Excel entrante, champ Word sortant. La génération de documents par IA interprète la demande et les données ensemble, elle peut donc interpréter ce que chaque colonne signifie et façonner la structure du document en conséquence, produire du contenu conditionnel ou analytique, et assembler plusieurs documents à partir d'une seule instruction. Le premier est une étape de mappage ; le second est une tâche de génération.
Puis-je générer des documents Word personnalisés à partir d'un fichier Excel en C# ?
Oui. Chargez un modèle Word ou un document vide dans Spire.Doc, attachez le classeur Excel et appelez ExecuteInstruction avec une description de la sortie personnalisée. L'agent lit chaque enregistrement et compose un document adapté, enregistré par enregistrement ou sous forme de fichier combiné, le tout dans votre propre application .NET.
Un agent IA peut-il utiliser des données Excel pour générer des documents Word ?
Oui. Spire.Agent.Office associe un modèle de langage à une couche Word et Excel déterministe, de sorte que l'instruction est comprise et que le résultat reste un vrai fichier Word que votre équipe peut ouvrir, formater et distribuer. L'agent interprète le contenu du tableur plutôt que de s'appuyer sur un mappage de colonnes fixe, ce qui permet de travailler avec des entrées hétérogènes.
Prêt à automatiser votre génération Word ?
Si votre flux de travail est « les données Excel deviennent des documents Word personnalisés », le chemin le plus rapide est de décrire la sortie et de laisser l'agent gérer le reste. Suivez le tutoriel Démarrage pour exécuter votre premier flux de travail Word piloté par instruction en .NET.
Lectures complémentaires
- Générer divers modèles Word avec Spire.Agent.Office — le même modèle de génération appliqué à différents modèles Word
- Automatisation de l'analyse et du classement des scores des étudiants avec Spire.Agent.Office — un flux de travail côté Excel qui alimente les documents que cet article génère
- Présentation du produit Spire.Agent.Office — SDK d'agent IA pour tous les formats de document Office
Generar documentos de Word a partir de datos de Excel en C#
Tabla de contenidos
Generar documentos de Word a partir de datos de Excel significa utilizar filas de una hoja de cálculo como fuente para uno o más archivos de Word estructurados, generalmente siguiendo una plantilla o un flujo de trabajo de generación de documentos. Tradicionalmente, este trabajo se maneja con la Combinar correspondencia de Word: usted asigna columnas de Excel a campos en una plantilla .docx y permite que Word emita un documento por fila. La misma tarea se puede automatizar en C# con un SDK de documentos, o llevarse más allá con un agente de documentos de IA que procesa el requisito como una instrucción en lenguaje natural. Este artículo compara las rutas, muestra dónde la combinación de correspondencia deja de ser suficiente y recorre un ejemplo práctico en C# basado en Spire.Agent.Office, un SDK de agente de IA para documentos de Office.
Navegación rápida
- ¿Qué significa generar documentos de Word a partir de Excel?
- Combinar correspondencia de Excel a Word
- Tres formas de automatizar la generación de Word desde Excel en .NET
- Generar documentos de Word personalizados desde Excel en C#
- Preguntas frecuentes
1. ¿Qué significa generar documentos de Word a partir de datos de Excel?
La frase suena parecida a "convertir Excel a Word", pero la intención es diferente. Convertir .xlsx a .docx cambia el formato de un archivo y mantiene su contenido prácticamente igual. Generar documentos de Word a partir de datos de Excel construye nuevos documentos cuyo contenido se deriva de las celdas de una hoja de cálculo: una hoja de pedido por cliente, un informe mensual por región, un lote de cartas o etiquetas a partir de una lista de direcciones, un conjunto de facturas desde una hoja de pedidos.
La forma recurrente del requisito es casi siempre la misma:
En una oración real suena así: "Tengo una lista de clientes y sus pedidos en Excel; necesito un documento de Word para cada uno con su información, sus artículos y un total". La palabra que importa es derivado: el contenido del documento proviene de los datos, por lo que se trata de una generación de datos a documento, no de un cambio de formato.
Esa es la demanda a la que apunta este artículo. Todo lo que sigue trata sobre las diferentes formas de satisfacerla y el punto en el que debería dejar de conectar campos manualmente.
2. La forma tradicional: Combinar correspondencia de Excel a Word
A nivel de interfaz de usuario, la respuesta predeterminada a "¿cómo convertir esta lista de Excel en muchos documentos de Word?" es Combinar correspondencia de Word. Es la función en la que la mayoría de la gente piensa cuando busca realizar esta tarea, y Microsoft ofrece una guía paso a paso para ello. El mecanismo es simple y bien conocido:
Coloca un campo como «NombreCliente» dentro de una plantilla de carta, lo vincula a la columna Cliente de la fuente de Excel, ejecuta la combinación y Word escribe un documento por fila con ese valor sustituido. Debido a que el número de filas puede ser de miles, convierte la tarea de "abrir un archivo, copiar el texto, cambiar el nombre" en una operación por lotes sin código.
La combinación de correspondencia es buena para exactamente un tipo de trabajo: poner esta columna en ese campo, muchas veces. Cartas, sobres, etiquetas y avisos con un diseño fijo son su terreno natural. Se ejecuta dentro de Office, no necesita programación y, para esos documentos estables y basados solo en campos, es realmente la herramienta adecuada.
3. Límites de la combinación de correspondencia
El límite llega en el momento en que el documento deja de ser un formulario fijo con espacios en blanco y se convierte en algo que debe depender de los datos. La combinación de correspondencia sustituye valores; no decide la estructura, no razona sobre el contenido ni compone nada nuevo.
Compare dos solicitudes. La primera es lo que maneja la combinación de correspondencia:
"Ponga el nombre del cliente en el lugar del nombre, la dirección en el lugar de la dirección y el pedido en los detalles del pedido".
La segunda es la solicitud en la que terminan convirtiéndose la mayoría de los informes reales:
"Lea este libro de Excel, analice los datos de cada cliente, cree un informe personalizado con sus artículos y totales, añada un resumen de su patrón de compra y guarde cada resultado como un documento de Word independiente".
La segunda solicitud falla en las tres suposiciones de la combinación de correspondencia:
- La estructura varía. Un cliente con tres artículos necesita un cuerpo de documento diferente al de uno con treinta. Los campos de combinación asumen un diseño fijo con espacios en blanco fijos; no hacen crecer una tabla con tantas filas como requieran los datos.
- El contenido debe ser calculado, no copiado. "Resumir el patrón de compra" y "marcar clientes de alto valor" producen texto y decisiones que ninguna columna contiene. No hay un campo de origen al que vincularlos.
- La salida es un lote de archivos reales. Cada registro debe ser su propio documento de Word con su propio nombre, y el flujo de trabajo debe ejecutarse sin supervisión dentro de una aplicación, no desde un asistente de Office.
Esa es la posición honesta de la combinación de correspondencia, expresada con justicia: es excelente en el mapeo de campos, pero se vuelve menos adecuada cuando la estructura del documento, el contenido o la lógica de salida deben variar con los datos. El requisito más profundo —convertir datos en documentos— es un problema de generación, y es donde comienzan las rutas de automatización a continuación.
4. Convertir el requisito en una instrucción: el método del agente
La alternativa que se ajusta a la versión correcta del problema es un agente de documentos de IA: una capa de lenguaje natural sobre un motor de documentos determinista. En lugar de enumerar campos de plantilla y código por campo, usted describe la salida, y el agente puede manejar requisitos que son difíciles de expresar con la combinación de correspondencia tradicional —leer los datos, dar forma a la estructura, escribir el análisis— mientras que el motor de documentos garantiza que se obtenga un .docx (o PDF) real y bien formado.
El valor es más fácil de ver como una cadena:
Los pasos que son difíciles de expresar con la combinación de correspondencia tradicional —especialmente los tres del medio— son exactamente donde un agente puede demostrar su valor. Puede interpretar lo que significa una columna ("Importe total", "Ventas" y "Neto" pueden nombrar el mismo concepto bajo tres encabezados), dar forma a la estructura de un documento para cada registro y componer los párrafos de resumen. Lo que usted proporciona es una oración, no un mapa de campos.
El mensaje para llevar al resto de este artículo: la combinación de correspondencia asigna columnas de Excel a campos de Word; un agente de IA genera documentos a partir de un requisito. Lo primero es un paso de sustitución de valores, lo segundo es lo que realmente era la solicitud.
5. Tres formas de automatizar la generación de Word desde Excel en .NET
Decidir la ruta correcta importa más que el código, porque cada ruta tiene una curva de costos diferente. Para una aplicación .NET que necesita este flujo de trabajo, las opciones realistas son:
| Enfoque | Lo que requiere | Flexibilidad | Mejor para |
|---|---|---|---|
| Combinar correspondencia de Word | Una plantilla .docx con campos de combinación + una fuente de Excel; ejecutar la combinación (o programarla) | Asigna una columna a un campo; se estanca con estructuras variables, contenido condicional, análisis | Cartas, etiquetas, sobres, avisos con una forma fija |
| Vinculación de campos mediante SDK | Cargar la plantilla en el código, abrir el libro, recorrer filas, vincular/buscar-reemplazar por registro, guardar cada archivo | Determinista y comprobable; usted mantiene manualmente el mapa de columnas y el diseño, cada cambio requiere recompilar | Repetir una forma de documento estable a escala |
| Agente de IA de lenguaje natural | Pasar el libro como archivo adjunto, describir la salida, leer el resultado | Maneja estructura variable, análisis por registro, secciones condicionales, resúmenes | Documentos que varían con los datos o flujos de trabajo que cambian mes a mes |
Un atajo que decide la mayoría de los casos:
- La forma nunca cambia, un campo por columna, cartas masivas: la combinación de correspondencia es difícil de superar.
- La forma nunca cambia pero lo necesita en código, determinista y comprobable: use un bucle de vinculación de campos mediante SDK.
- El documento debe variar con los datos, incluir análisis o cambiar a menudo: ahí es donde un agente de IA se paga solo, porque el costo de un cambio a menudo puede reducirse a actualizar la instrucción en lugar de cambiar la lógica de mapeo y diseño en el código.
6. Generar documentos de Word personalizados desde Excel en C#
Una versión concreta y funcional del requisito de "un documento de Word por registro" es un resumen de pedido de cliente. Las entradas son un libro de pedidos de clientes y una plantilla de Word ligera; la salida es un documento personalizado por cliente. La configuración completa —token, paquete y cableado del proyecto— está documentada en el tutorial de Introducción; aquí nos centramos en la llamada de generación en sí.
using Spire.Doc;
using Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;

AIOptions options = new AIOptions
{
    SpireToken = spireToken,
    WorkDir = @"C:\order-ops\output",   // carpeta donde se escriben los documentos generados
    TimeoutMs = 300000
};

using (Document doc = new Document())
{
    // La plantilla proporciona anclajes por registro; el libro es la fuente de datos.
    doc.LoadFromFile(@"C:\order-ops\templates\order-summary-template.docx");

    // savePath = null: una instrucción produce un documento por registro,
    // escrito en la carpeta de salida WorkDir. No hay bucle C# sobre las filas.
    AIResult result = doc.AI(options).ExecuteInstruction(
        doc,
        "Lea los datos de pedidos de clientes en Q3-orders.xlsx. Genere un resumen de pedido " +
        "de Word independiente por cliente, fila por fila. Incluya su información de contacto, " +
        "cada artículo con cantidad e importe, los totales del pedido y un resumen de un párrafo " +
        "de su patrón de compra. Marque a los clientes cuyo total supere los 50,000 como de alto valor. " +
        "Guarde cada documento como su propio archivo llamado output_ seguido del nombre del cliente " +
        "(por ejemplo, output_acme-order-summary.docx).",
        null,
        new[] { @"C:\order-ops\input\Q3-orders.xlsx" });

    if (result == null || !result.Success)
        throw new InvalidOperationException($"La generación falló: {result?.ErrorMessage}");
}
Tres detalles importan cuando lo ejecute usted mismo. Primero, la instrucción es donde reside la lógica de generación: el análisis ("resumen de su patrón de compra"), la lógica condicional ("marcar clientes por encima de 50,000") y la estructura por registro ("cada artículo"). Segundo, el libro debe estar ordenado: la primera fila es el encabezado, un registro por fila, sin filas vacías ni celdas de encabezado combinadas —las mismas reglas que espera la propia fuente de datos de Word. Tercero, el documento base ancla el diseño de salida; uno ligeramente estructurado puede darle al agente un punto de partida útil para la estructura de cada registro. Con un documento base totalmente vacío, la misma instrucción produce un único documento compuesto en su lugar.
Una regla de nomenclatura importa aquí: los documentos que el agente escribe en WorkDir deben comenzar con el prefijo output_, o el SDK no los cuenta como archivos generados. Es por eso que la instrucción anterior solicita archivos como output_acme-order-summary.docx en lugar de solo los nombres de los clientes.
La extensión .docx en su destino de guardado o patrón de archivo elige el formato de salida; apunte la misma instrucción a .pdf y el agente exportará los documentos idénticos para su distribución, sin un paso de renderizado separado.
Llamadas clave de la API
Document.AI(options)-- adjunta el procesador de documentos de IA a un objeto de documento de WordExecuteInstruction(doc, instruction, savePath, attachments)-- ejecuta la generación;nullen savePath significa "escribir enWorkDir", y el libro viaja enattachmentPathsAIResult.Success/AIResult.ErrorMessage-- verifica la ejecución y muestra los errores
7. Lo que escribiría sin un agente
Para contrastar, la ruta de vinculación de campos mediante SDK para el mismo trabajo hace todo explícitamente. Lo siguiente está simplificado intencionalmente para mostrar la cantidad de lógica de aplicación involucrada; una implementación de producción también necesitaría cargar y agrupar los datos del libro:
using Spire.Doc;
using Spire.Xls;

// Una forma fija está bien; cada variación es más cableado.
foreach (DataRow row in customersTable.Rows)
{
    using (Document doc = new Document())
    {
        doc.LoadFromFile(@"templates\order-summary-template.docx");

        // Buscar y reemplazar por anclaje...
        doc.Replace("{{CustomerName}}", row["Customer"].ToString(), true, true);
        doc.Replace("{{TotalAmount}}", row["Amount"].ToString("C"), true, true);

        // Los artículos viven en una segunda hoja: usted los une manualmente por cliente,
        // construye una tabla e insértela en un marcador...
        // La regla "marcar clientes de alto valor" es un if/else que usted mantiene,
        // y el párrafo de resumen por cliente es una plantilla que escribe a mano.
        doc.SaveToFile($@"out\{row["Customer"]}-order-summary.docx");
    }
    // ... y cada nueva regla, columna o cambio de diseño significa editar esto y recompilar.
}
El agente no elimina la necesidad de código; elimina la necesidad de código de mapeo y diseño. La diferencia es dónde reside la lógica: en un índice de columna y un buscar-reemplazar, o en una oración que el negocio puede leer y editar. Cuando las reglas de negocio o las estructuras de documentos cambian con frecuencia, el enfoque de lenguaje natural puede reducir la cantidad de código de mapeo y diseño que debe mantenerse. El patrón de plantilla más datos se escala más allá de los resúmenes de pedidos: Generación de contratos por lotes con Spire.Agent.Office recorre el mismo flujo de una instrucción y un documento por registro aplicado a contratos.
8. Donde termina la IA y comienza la lógica de la aplicación
Un límite útil no es "lo que la IA puede y no puede hacer", sino lo que la aplicación debe seguir poseyendo. Un agente de generación de documentos se asienta sobre código determinista; no lo reemplaza.
Su aplicación aún posee las partes que no tienen nada que ver con la comprensión de la hoja de cálculo:
- Descubrimiento y acceso a archivos -- encontrar el libro, verificar permisos, preparar entradas
- Programación del flujo de trabajo -- cuándo se ejecuta el trabajo, en qué disparador, en qué orden
- Control de la fuente de datos -- qué libro es una entrada autorizada y de dónde vino
- Manejo de errores y reintentos -- qué sucede cuando falta un archivo o falla una ejecución
- Aprobación final -- un humano revisa los documentos generados antes de que se envíen
El agente maneja los pasos semánticos:
- Comprensión -- leer lo que significa cada columna de diferentes libros
- Planificación de la estructura -- determinar cuántas secciones y filas necesita el documento
- Análisis -- convertir los datos del pedido en un resumen y una marca de alto valor
- Composición -- ensamblar documentos de Word personalizados a partir del requisito
Mantenga la plomería determinista en el código, donde es comprobable y auditable, y entregue la generación semántica al agente. Cada lado hace lo que sabe hacer. Revisión de contratos con IA en C# muestra la misma división desde el otro lado: el agente maneja el paso semántico de revisar el contenido de un documento mientras la aplicación mantiene el manejo determinista de archivos a su alrededor.
9. Preguntas frecuentes
¿Es esto un reemplazo para la combinación de correspondencia de Word?
No es un reemplazo directo; es el mismo trabajo llevado más lejos. La combinación de correspondencia asigna columnas de Excel a campos de Word fijos, lo cual es suficiente para una carta con una forma estable. Un agente de IA también puede hacer eso, y además puede leer el libro por contenido, dar forma a la estructura por registro, añadir análisis y componer prosa. Para salidas simples de forma fija, la combinación de correspondencia sigue siendo una buena herramienta; cuando el documento debe variar con los datos, el agente realiza gran parte del trabajo.
¿Cómo genero múltiples documentos de Word a partir de datos de Excel?
Pase el libro como archivo adjunto, establezca la ruta de guardado en null y apunte AIOptions.WorkDir a una carpeta de salida. Una ExecuteInstruction con una instrucción fila por fila hace que el agente produzca un documento independiente por registro, cada uno guardado en esa carpeta. No se necesita un bucle C# sobre las filas para el lote por registro.
¿Puedo generar documentos de Word a partir de Excel sin usar la combinación de correspondencia?
Sí. En C# puede vincular una plantilla con el SDK directamente, o entregar el libro a un agente de IA que lo lea a partir de una instrucción de lenguaje natural, y recibir un .docx o PDF real a cambio. La combinación de correspondencia es una ruta, no la única, y es la menos flexible una vez que el documento necesita análisis o secciones condicionales.
¿Cuál es la diferencia entre la combinación de correspondencia y la generación de documentos por IA?
La combinación de correspondencia vincula campos definidos a columnas definidas: columna de Excel entra, campo de Word sale. La generación de documentos por IA interpreta la solicitud y los datos juntos, por lo que puede interpretar lo que significa cada columna y dar forma a la estructura del documento en consecuencia, producir contenido condicional o analítico y ensamblar varios documentos a partir de una instrucción. Lo primero es un paso de mapeo; lo segundo es una tarea de generación.
¿Puedo generar documentos de Word personalizados a partir de un archivo de Excel en C#?
Sí. Cargue una plantilla de Word o un documento en blanco en Spire.Doc, adjunte el libro de Excel y llame a ExecuteInstruction con una descripción de la salida personalizada. El agente lee cada registro y compone un documento ajustado a él, guardado por registro o como un archivo combinado, todo dentro de su propia aplicación .NET.
¿Puede un agente de IA usar datos de Excel para generar documentos de Word?
Sí. Spire.Agent.Office combina un modelo de lenguaje con una capa determinista de Word y Excel, por lo que la instrucción se entiende y el resultado sigue siendo un archivo de Word real que su equipo puede abrir, formatear y distribuir. El agente interpreta el contenido de la hoja de cálculo en lugar de depender de un mapeo de columnas fijo, que es lo que hace que funcionen las entradas heterogéneas.
¿Listo para automatizar su generación de Word?
Si su flujo de trabajo es "los datos de Excel se convierten en documentos de Word personalizados", el camino más rápido es describir la salida y dejar que el agente se encargue del resto. Siga el tutorial de Introducción para ejecutar su primer flujo de trabajo de Word basado en instrucciones en .NET.
Lecturas adicionales
- Generar varias plantillas de Word con Spire.Agent.Office -- el mismo patrón de generación aplicado a diferentes plantillas de Word
- Automatización del análisis y clasificación de puntuaciones de estudiantes con Spire.Agent.Office -- un flujo de trabajo del lado de Excel que alimenta los documentos que genera este artículo
- Descripción general del producto Spire.Agent.Office -- SDKs de agentes de IA para cada formato de documento de Office